

A korábbi cikkemben az DATA VAULT alapjairól beszéltem, bemutattam a DATA VAULT fő elemeit és azok célját. Azonban a DATA VAULT témája nem merült ki, szükséges beszélni a DATA VAULT evolúciójának következő lépéseiről.
Ebben a cikkben az DATA VAULT fejlődésére és a BUSINESS DATA VAULT-ra, vagy egyszerűen a BUSINESS VAULT-ra fogok összpontosítani.
A BUSINESS DATA VAULT megjelenésének okai
Meg kell jegyezni, hogy a DATA VAULT bizonyos erősségekkel rendelkezik, de hátrányoktól sem mentes. Az egyik ilyen hátrány a bonyolultság az analitikai lekérdezések írásában. A lekérdezések jelentős számú JOIN-t tartalmaznak, a kód hosszú és nehézkes lesz. Emellett a DATA VAULT-ba bekerülő adatok semmiféle átalakításnak nincsenek alávetve, tehát üzleti szempontból a DATA VAULT önmagában nem rendelkezik feltétlen értékkel.
Éppen ezen hátrányok kiküszöbölésére a DATA VAULT módszertan egyes elemekkel bővült, mint például:
- PIT (point in time) táblák;
- BRIDGE táblák;
- PREDEFINED DERIVATIONS.
Nézzük meg részletesebben e elemek célját.
PIT táblák
Általában egy üzleti objektum (HUB) különböző frissítési gyakoriságú adatokkal rendelkezhet, például, ha az emberi jellemzőkről beszélünk, akkor elmondhatjuk, hogy a telefonszám, cím vagy e-mail információk frissítési gyakorisága magasabb, mint mondjuk a név, a személyi igazolvány adatai, a családi állapot vagy a nem.
Ezért a szateliták meghatározásakor figyelembe kell venni a frissítési gyakoriságukat. Miért fontos ez?
Ha egy táblázatban eltérő frissítési gyakoriságú attribútumokat tárolunk, akkor minden egyes, leggyakrabban változó attribútum frissítésekor sort kell hozzáadni a táblázathoz. Ennek következménye – a lemezterület növekedése, a lekérdezések végrehajtási idejének növekedése.
Most, hogy a szatelitákat a frissítési gyakoriság szerint elkülönítettük, és tudjuk, hogy az adatokat függetlenül tölthetjük be, biztosítani kell a naprakész adatok elérhetőségét. Jobb, ha nem használunk felesleges JOIN-ok.
Magyarázom, például aktuális (az utolsó frissítés dátuma szerint) információt kell kapni a különböző frissítési gyakorisággal rendelkező satellitektől. Ehhez nemcsak JOIN-t kell végezni, hanem több belső lekérdezést is létre kell hozni (minden satellite-re, amely információt tartalmaz) a maximális frissítési dátum kiválasztásával MAX(Frissítési dátum). Minden új JOIN-nal a kód növekszik, és nagyon gyorsan nehezen érthetővé válik.
A PIT táblák célja az ilyen lekérdezések egyszerűsítése, a PIT táblák egyidejűleg töltődnek fel az új adatok rögzítésekor a DATA VAULT-ban. PIT tábla:
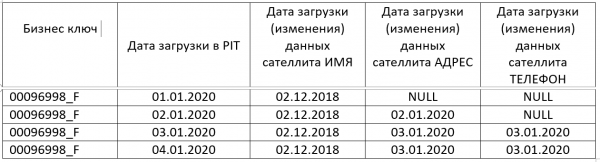
Így van információnk az adatok aktuális állapotáról az összes satellite esetében bármely adott időpontban. A PIT táblához való JOIN-ok használatával teljesen ki tudjuk zárni a belső lekérdezéseket, természetesen azzal a feltétellel, hogy a PIT minden nap ki van töltve és nincsenek kihagyások. Még ha kihagyások is vannak a PIT-ben, az aktuális adatokhoz csak egy belső lekérdezés használatával lehet hozzáférni a PIT-hez. Egy belső lekérdezés gyorsabban fut le, mint a minden satellite-hez tartozó belső lekérdezések.
BRIDGE
A BRIDGE típusú táblák szintén az analitikai lekérdezések egyszerűsítésére használatosak. Azonban a PIT-től eltérően a különböző hubok, linkek és satellite-ek közötti lekérdezések egyszerűsítésének és felgyorsításának eszközeként szolgálnak.
A táblázat tartalmazza az összes szükséges kulcsot az összes satellite-hez, amelyeket gyakran használnak a lekérdezésekben. Továbbá, ha szükséges, a titkosított üzleti kulcsok kiegészíthetők szöveges kulcsokkal, ha a kulcsok elnevezésére szükség van az analízishez.
A helyzet az, hogy a BRIDGE használata nélkül, az eltérő hubokhoz tartozó satellite-ekből származó adatok lekérése során nemcsak a satellite-eket, hanem a hubokat összekötő linkeket is JOIN-olni kell.
A BRIDGE megléte vagy hiánya a tároló konfigurációjától, valamint a lekérdezések végrehajtási sebességének optimalizálásának szükségességétől függ. Nehéz univerzális BRIDGE példát találni.
PREDEFINED DERIVATIONS
Egy másik típusú objektum, amely közelebb hoz minket az ÜZLETI DATA VAULT-hoz, a korábban kiszámított mutatókat tartalmazó táblák. Ezek a táblák valóban fontosak az üzlet számára, tartalmazzák az adott szabályok szerint aggregált információt, és viszonylag egyszerű hozzáférést biztosítanak ehhez.
Az előre definiált eltérések (PREDEFINED DERIVATIONS) másik szatelitje egy adott hubnak. Mint a hagyományos szatelit, tartalmaz egy üzleti kulcsot és a szatelit bejegyzésének létrehozási dátumát. Itt azonban véget ér a hasonlóság. Az ilyen 'szpecializált' szatelit attribútumainak további összetétele az üzleti felhasználók által a legkeresettebb, előre kiszámított mutatók alapján határozható meg.
Például, egy olyan hub, amely információkat tartalmaz egy alkalmazottról, magába foglalhat egy szatelitet a következő mutatókkal:
- Minimális bér;
- Maximális bér;
- Átlagbér;
- Felhalmozott összeg a kifizetett bérből stb.
Logikus lenne az előre definiált eltérések (PREDEFINED DERIVATIONS) beillesztése ennek a hubnak a PIT táblájába, így könnyen kaphatunk adatmintákat az alkalmazottról egy adott dátumra.
KÖVETKEZTETÉSEK
A gyakorlat azt mutatja, hogy az üzleti felhasználóknak a DATA VAULT használata több okból is nehézkes:
- A lekérdezések kódja bonyolult és terjedelmes;
- A JOIN-ok száma befolyásolja a lekérdezések sebességét;
- Az analitikai lekérdezések írásához kiemelkedő ismeretek szükségesek a tároló struktúrájáról.
Az adatokhoz való hozzáférés egyszerűsítése érdekében a DATA VAULT további objektumokkal bővül:
- PIT (point in time) táblák;
- BRIDGE táblák;
- PREDEFINED DERIVATIONS.
A következő Azt tervezem, hogy bemutatom a legérdekesebb módszereket azoknak, akik BI-vel dolgoznak. Kifejtem, hogyan lehet tény- és dimenziós táblákat létrehozni a DATA VAULT alapján.
A cikk anyagai alapján:
- Ezen Kenta Graziano, amely részletes leíráson kívül modellek ábráit is tartalmazza;
- Könyv: „Building a Scalable Data Warehouse with DATA VAULT 2.0”;
- Cikk .
Forrás: habr.com
