

A nevem Szergej, az ITSumma cégtől jövök, és szeretném elmondani, hogyan közelítünk a Kubernetes-ben történő biztosításhoz. Az utóbbi időben sokat foglalkozom tanácsadással különböző devops megoldások bevezetésében különböző csapatok számára, különös figyelmet fordítva a K8s alapon működő projektekre. Az Uptime Day 4 konferencián, amely a bonyolult architektúrák biztosításának volt szentelve, előadást tartottam a „kocka” biztosításáról, és itt van a szabad átirata. Előre szeretném jelezni, hogy ez nem egy közvetlen cselekvési útmutató, hanem inkább a témával kapcsolatos gondolatok összegzése.
Alapvetően a monitorozás és a biztosítás a két fő eszköz, amely biztosítja bármely projekt megbízhatóságát. De hiszen a kuber mindent automatikusan egyensúlyoz, mondhatod, minden automatikusan skálázódik, és ha valami történik - akkor az önmaga felszínre kerül… Vagyis az első felületes kutatás alapján a kérdésre, hogy hogyan közelítenek mások a K8s biztosításához, az internet azt válaszolt, hogy „miért?” Sokan úgy gondolják, hogy a kuber egy mágikus dolog, amely megszabadít minden infrastrukturális problémától, és biztosítja, hogy a projekt soha ne omoljon össze. De… a világ nem az, aminek látszik.
Hogyan közelítettünk korábban a biztosítási folyamathoz? Azonos elhelyezési helyszíneink voltak - vagy virtuális gépek, vagy fizikai szerverek, szerverek, amelyeken három alapvető gyakorlatot alkalmaztunk:
- a kód és a statika szinkronizálása
- a konfigurációk szinkronizálása
- az adatbázis replikációja
És íme: bármikor átkapcsolhatunk a tartalék helyszínre, mindenki boldog, felállunk és szétszéledünk.
Mit ajánlanak a Kubernetes-alkalmazásunk állandó rendelkezésre állásának növelésére? Elsőként, amit az unofficial dokumentáció mond — sok gépet kell telepíteni, sok master-t kell létrehozni — a számuknak meg kell felelnie a quorum eléréséhez szükséges feltételeknek a klaszter belsejében, és minden master-en el kell indítani az etcd-t, api-t, MC-t, ütemezőt... És ezt úgy tűnik, hogy tökéletesen működik: amikor több munkanód vagy master megsérül, a klaszter újra kiegyensúlyozódik, és az alkalmazás továbbra is működik. Úgy tűnik, mint a varázslat! De gyakran a klaszterünk egy adatközpont keretein belül található, ami bizonyos kérdéseket vet fel. Mi történik, ha egy rakodógép megérkezik és megás egy kábelt, ha villámcsapás történik, vagy ha világméretű árvíz történik? Minden elment, a klaszterünk többé nem létezik. Hogyan közelítsünk a biztonsági mentéshez, figyelembe véve ezt a problémát?
Elsősorban szüksége van egy másik klaszterre meleg tartalékban, ami azt jelenti, hogy egy klaszterre, amelyre bármikor átválthat. Ezenkívül a kubernetes szempontjából az infrastruktúráknak teljesen azonosnak kell lennie. Tehát, ha vannak olyan szokatlan pluginek a fájlrendszer kezelésére, vagy egyedi megoldások az ingress számára, azoknak teljesen azonosnak kell lenniük a két (vagy három, vagy tíz, attól függ, mennyi pénz és adminisztrátorok ereje van) klaszterben. Két csoport alkalmazást (deployments, statefulsets, daemonsets, cronjobs stb.) kell világosan meghatározni: melyek működhetnek állandóan a tartalékban, és melyeket nem érdemes elindítani, amíg a váltás nem történik meg.
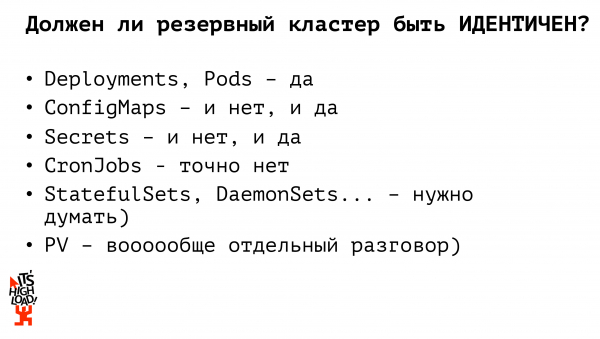
Tehát a tartalék klaszterünknek teljesen azonosnak kell lennie a produktív klaszterünkkel? Nem. Korábban, monolitikus projektek és hardverinfrastruktúra keretein belül, gyakorlatilag teljesen azonos környezetet tartottunk fenn, de a Kubernetes esetében ezt nem tartom szükségesnek. Nézzük meg, miért.
Például kezdjük a Kubernetes alapvető entitásaival — a deployments tehát azonosnak kell lennie. Futó alkalmazásoknak kell lenniük, amelyek bármikor át tudják venni a forgalom kezelését, és lehetővé teszik, hogy a projektünk tovább éljen. Ha a konfigurációs fájlokról beszélünk, akkor figyelembe kell venni, hogy azoknak azonosnak kell-e lenniük vagy sem. Tehát ha mi, okos emberek, nem használunk semmilyen tiltott anyagot, és nem tartjuk az adatbázist K8s-ben, akkor a configmapokban az éles adatbázis eléréséhez szükséges beállításoknak kell lenniük (az adatbázis mentési folyamata külön van felépítve). Ennek megfelelően ahhoz, hogy hozzáférjünk a tartalék adatbázis példányhoz, külön konfigurációs fájlra (configmap) van szükségünk. Ugyanezt tesszük a titkos információkkal is: az adatbázishoz való hozzáférés jelszavaival, API kulcsokkal; bármikor lehet éles titkunk, vagy tartalék. Így már két Kubernetes entitásunk van, amelyek tartalék változatai nem lehetnek azonosak az éles verziókkal. A következő entitás, amelyre érdemes fektetni a figyelmet — a cronjob. A tartalék cronjobok egyáltalán nem lehetnek azonosak a termelési klaszter cronjobjaival! Ha felállítunk egy tartalék klasztert, és azt teljesen felállítjuk az összes bekapcsolt cronjob-bal — például az emberek két e-mailt fognak kapni egyszerre az egy helyett. Vagy valamilyen adat szinkronizálása külső forrásokkal kétszer fog zajlani, ennek megfelelően elkezdünk szenvedni, sírni, kiabálni és veszekedni.
De hogyan javasolják az emberek az interneten a tartalék klaszter megszervezését? A második legnépszerűbb válasz a "miért?" után — a Kubernetes Federation használata.
Mi ez? Mondhatjuk, hogy ez egy nagy meta-klaszter. Ha elképzeljük a Kubernetes architektúráját — ahol van egy mester és több node — akkor a federáció szempontjából is van egy mesterünk és több node, csak minden node egy külön klaszter. Tehát ugyanazokkal az entitásokkal, ugyanazokkal az primitívekkel dolgozunk, mint egy egyedi Kubernetes esetén, csak nem a fizikai gépeinket mozgathatjuk, hanem egész klasztereket. A federáción belül teljes szinkronizáció zajlik a federációs erőforrások között a szülőktől a gyermekekig. Például, ha elindítunk egy eltávolítást a federáción keresztül — az minden gyermek klasztereinkben telepítve lesz. Ha veszünk egy configmap-et vagy titkot, és azt telepítjük a federáción — az eljut minden gyermek klaszterünkhöz; emellett a federáció lehetővé teszi, hogy testre szabjuk erőforrásainkat a gyermekeknél. Tehát fogtunk egy configmap-et, amelyet a federáción keresztül telepítettünk, és ha szükségünk van valamire, amit meg kell változtatnunk a konkrét klasztereken, akkor elmegyünk módosítani egy külön klaszteren, és ez a változás már nem lesz szinkronizálva.
A Kubernetes Federation — nemrégiben létező eszköz, és nem támogatja a K8s által biztosított erőforrások egész sorát: a dokumentáció egyik első verziójának közzétételekor még csak a config mapok, a replikációs halmazhoz tartozó telepítések és az ingress támogatásáról volt szó. A titkok nem voltak támogatva, a volume kezelését sem támogatták. Túl korlátozott készlet. Különösen, ha szeretünk szórakozni — például egyedi erőforrás-definíciók révén saját erőforrásainkat átadni a Kubernetesnek —, a federációba már nem tudjuk őket belenyomni. Tehát… nagyon hasonlít az igazságra, de időnként a saját lábunkba lőhetünk. Másrészt a federáció lehetővé teszi a replikációs halmazunk rugalmas kezelését. Például szeretnénk, ha az alkalmazásunkból 10 repliká lenne futva; alapértelmezés szerint a federáció arányosan elosztja ezt a számot a klaszterek között. Ráadásul ezt még konfigurálni is tudjuk! Tehát megadhatjuk, hogy a produkciós klaszteren 6 replikát kell tartanunk az alkalmazásunkból, míg a tartalék klaszteren, erőforrások megtakarítása céljából vagy saját szórakozásaink miatt — csak 4 replikát. Ez is nagyon kényelmes. De a federáció használatához új megoldásokra van szükség, valamit folyamatosan át kell telepítenünk, kicsit többet kell gondolkodnunk…
Lehet-e egyszerűbben hozzáállni a Kubernetes biztonsági mentéséhez? Milyen eszközeink vannak egyáltalán?
Először is, mindig van egy CI/CD rendszerünk, tehát nem megyünk manuálisan, nem írunk a szervereken create/apply parancsokat. A rendszer YAML fájlokat generál a konténereinkhez.
Másodszor, több klaszterünk is lehet, van egy vagy több (ha okosak vagyunk) registry, amit szintén lefoglaltunk. És van egy csodás eszköz, a kubectl, ami egyszerre több klaszterrel is képes dolgozni.
Tehát: véleményem szerint a legegyszerűbb és legmegbízhatóbb megoldás a tartalék klaszter felépítésére az primitív párhuzamos telepítés. Van valamilyen pipeline a CI/CD rendszerben; először felépítjük a konténereinket, teszteljük és telepítjük az alkalmazásokat kubectl-en keresztül több független klaszterre. Meg tudjuk valósítani az egyidejű telepítéseket több klaszterre. Ennek megfelelően a konfigurációk átadását is ezen a szakaszon oldjuk meg. Előre meghatározhatjuk a harci klaszterünkhöz szükséges konfigurációkat, a tartalék klaszterhez szükséges konfigurációkat, és a CI/CD rendszer szintjén az éles környezetet a produkciós klaszterre, a tartalék környezetet pedig a tartalék klaszterre telepíthetjük. A föderációval ellentétben nem szükséges, hogy minden egyes leány klaszteren átmenjünk, és valamit felülbíráljunk a föderált erőforrás meghatározása után. Ezt előre elvégeztük. Micsoda ügyesek vagyunk.
De… van… korábban írtam, hogy van egy „minden baj gyökere”, de valójában kettő van. Először is a fájlrendszer. Van valamilyen PV, vagy használunk külső tárolót. Ha a fájlokat a klaszteren belül tároljuk, akkor az régi gyakorlatok szerint kell eljárnunk, amelyek az acélinfrastruktúrákból maradtak: például szinkronizáljuk lsync-el. Vagy bármilyen más, általad kedvelt megoldással. Telepítjük mindent más gépekre, és élünk.
Másodszor, és valójában ez egy még fontosabb akadály — az adatbázis. Ha okos emberek vagyunk, és nem tartjuk az adatbázist kubernetesben, akkor az adatok tartalékba helyezése a régi rendszer szerint történik - master-slave replikáció, majd átkapcsolás, követjük a replikát, és jól élünk. De ha az adatbázisunkat a klaszteren belül tartjuk, akkor alapvetően sok kész megoldás létezik a master-slave replikák megszervezésére, sok megoldás a DB kubernetes-en belüli létrehozására.
Az adatbázisok tartalékba helyezéséről már milliárdnyi előadás és milliárd cikk íródott, itt igazán semmi új nincs. Igazából kövessétek az álmaitokat, éljetek úgy, ahogy akartok, találjatok ki bonyolult megoldásokat is, de mindenképp gondoljátok át, hogyan fogjátok ezeket tartalékba helyezni.
Most importantly, let's discuss how we will transition to a backup site in the event of a fire. Firstly, we deploy stateless applications in parallel. They do not affect the business logic of our applications or our project; we can continually maintain two sets of running applications that can begin to receive traffic. It is crucial during the transition to a backup site to check whether any configurations need to be redefined. For example, we have a production Kubernetes cluster, a backup Kubernetes cluster, an external master database, and a backup master database. There are four scenarios in which these applications in production may start to interact with each other. The database can switch, and it turns out that we need to redirect traffic in the production cluster to the new database, or the cluster may fail — and we move to the backup but continue working with the production database. Then there's the third scenario where both have failed, and we switch both applications, redefining our configurations so that the new applications work with the new database.
So, what conclusions can we draw from all this?
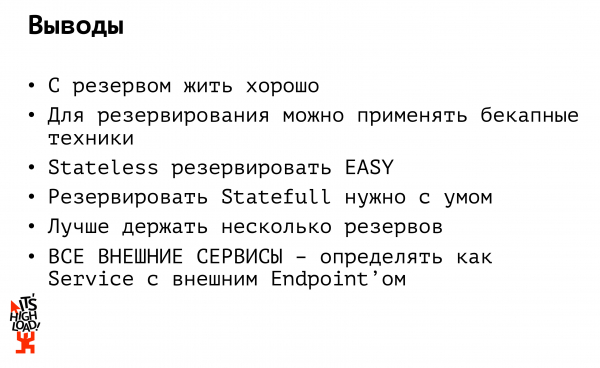
Conclusion one: Having a backup is good. But it's expensive. Ideally, you should not rely on just one backup. Ideally, you should have multiple backups. Firstly, the backup should be located in at least one different data center, and secondly, preferably with a different host. This has often happened in my experience. Unfortunately, I cannot name the projects, just when there was a fire in the data center... I thought, let's switch to the backup! And the backup servers were in the same rack...
Or imagine if Amazon was banned in Russia (which has happened). Then what good is it that our backup is in another Amazon? It is also unavailable. So I repeat: we must keep a backup at least in another data center, and preferably with a different host.
Második kiadás: Ha az alkalmazásod a Kubernetes alatt külső forrásokkal kommunikál (ez lehet adatbázis vagy egy külső API), mindenképp szolgáltatásként kell definiálnod külső végponttal, hogy ne kelljen átdéplózni 15 alkalmazásodat, amelyek ugyanabba az adatbázisba kapcsolódnak. Határozd meg az adatbázist külön szolgáltatásként, és hivatkozz rá, mintha a klasztered része lenne: ha az adatbázisod megsérül, csak egy helyen kell megváltoztatnod az IP-t és továbbra is boldogan élhetsz.
És végül: én imádom a "kockát", ahogy azzal való kísérletezést is. És szeretem megosztani e kísérletek eredményeit, valamint a saját tapasztalataimat. Ezért felvettem egy sor webináriumot a K8s-ről, üdvözöllek a további részletekért.
Forrás: habr.com
