

Ezzel a varázslatos Cisco ACI szkripttel gyorsan beállíthatja a hálózatot.
A Cisco ACI adatközponti hálózati gyár már öt éve létezik, de a Habr-on róla szinte semmit nem írtak, így úgy döntöttem, hogy ezt egy kicsit kijavítom. Elmondom a saját tapasztalataim alapján, mi ez, milyen előnye van, és hol vannak a buktatói.
Mi ez, és honnan jött?
Amikor 2013-ban bejelentették az ACI-t (Application Centric Infrastructure), a hagyományos adatközponti hálózati megközelítésekre három oldalról is versenytársak léptek.
Egyrészt az SDN első generációs OpenFlow alapú megoldások azt ígérték, hogy a hálózatok rugalmassá és olcsóvá válnak. Az ötlet az volt, hogy a hagyományosan a saját szoftvereik által kezelt döntéshozatalt egy központi vezérlőre helyezzük.
Ez a vezérlő egységes képet alkotott volna minden eseményről, és ennek megfelelően programozta volna a kapcsolók hardverét a konkrét áramlások feldolgozásának szabályai szerint.
Másrészt az overlay hálózati megoldások lehetővé tették a szükséges kapcsolódások és biztonsági politikák megvalósítását anélkül, hogy változtatni kellett volna a fizikai hálózaton, szoftveres alagutakat építve a virtualizált hosztok között. A legismertebb példa erre a Nicira megoldása volt, amelyet ekkor már 1,26 milliárd dollárért vásárolt meg a VMWare, és amely elindította a mai VMWare NSX-t. A helyzet pikantériáját az adta, hogy a Nicira társalapítói azok az emberek voltak, akik korábban az OpenFlow alapjait tették le, most pedig azt hangoztatták, hogy az adatközponti gyár megépítéséhez az OpenFlow nem alkalmas. .
Végül a piacon elérhető kapcsolási chipek (amit merchant silicon-nak hívnak) elérték azt a fejlettségi szintet, amely valós fenyegetést jelentett a hagyományos kapcsolók gyártóira. Míg korábban minden gyártó saját chipeket fejlesztett ki a kapcsolóihoz, az idő múlásával a harmadik féltől származó chipek, elsősorban a Broadcom-tól, kezdték csökkenteni a távolságot a gyártói chipekhez képest funkcióikban, és ár/ teljesítmény arányban felülmúlták azokat. Ezért sokan úgy vélték, hogy a saját fejlesztésű chipekkel rendelkező kapcsolók napjai meg vannak számlálva.
Az ACI a Cisco (pontosabban az őt birtokló Insieme cég, amelyet korábbi alkalmazottai alapítottak) „aszimmetrikus válasza” lett mindezekre.
Mi a különbség az OpenFlow-hoz képest?
A funkciók elosztása szempontjából az ACI gyakorlatilag az OpenFlow ellentéte.
Az OpenFlow-architektúrában a vezérlő felelős a részletes szabályok (folyamok) megírásáért
minden egyes switch hardverében, tehát egy nagy hálózatban az ő feladata lehet a tizek millió rekord fenntartása és, ami a legfontosabb, megváltoztatása is több száz ponton a hálózaton, ezért a teljesítménye és megbízhatósága egy nagyobb bevezetésnél szűk keresztmetszetet jelenthet.
Az ACI visszafelé irányuló megközelítést alkalmaz: a vezérlő természetesen létezik, de a switchek magasan végrehajtható deklaratív politikákat kapnak tőle, és a konkrét beállítások hardverben való végrehajtását maga a switch végzi. A vezérlőt újraindíthatjuk vagy akár ki is kapcsolhatjuk, és a hálózattal nem történik semmi rossz, kivéve, természetesen, a kezelhetőség hiányát abban a pillanatban. Érdekes, hogy az ACI-ban vannak olyan helyzetek, amikor az OpenFlow mégis használatban van, de helyben, a hoszton belül az Open vSwitch programozásához.
Az ACI teljes mértékben VXLAN alapú overlay közlekedésre épül, de egyetlen megoldáson belül magában foglalja az alsóbb IP-közlekedést is. A Cisco ezt az "integrált overlay" kifejezéssel illette. Az overlay-k terminálási pontjaként az ACI-ban a legtöbb esetben a gyár switch-eit használják (ezek a csatorna sebességén működnek). A hosztoknak nem kell semmit tudniuk a gyárról, az enkapszulációról stb., ám bizonyos esetekben (mondjuk, OpenStack hosztok csatlakoztatásánál) a VXLAN forgalmat hozzájuk is el lehet juttatni.
Az overlay-k az ACI-ban nemcsak a rugalmas kapcsolódás biztosítására szolgálnak a szállítóhálózaton, hanem meta-információk továbbítására is (ez például a biztonsági politikák alkalmazásához szükséges).
A Broadcom chipeket korábban is használták a Cisco Nexus 3000-as sorozatú switch-eiben. A kifejezetten az ACI támogatására kiadott Nexus 9000 családban kezdetben egy hibrid modellt valósítottak meg, amelyet Merchant+-nak neveztek el. A switch egyidejűleg használta az új Broadcom Trident 2 chippet, valamint egy Cisco által kifejlesztett kiegészítő chippet, amely megvalósította az ACI összes varázslatát. A jelek szerint ez lehetővé tette a termék gyorsabb piacra kerülését és a switch árának csökkentését a Trident 2-őt is használó modellek közelébe. Ez a megközelítés elegendőnek bizonyult az ACI első két-három évében. Ez idő alatt a Cisco kifejlesztette és piacra dobta a következő generációs Nexus 9000-t, amely már saját chipein alapult, nagyobb teljesítménnyel és funkciókészlettel, de azonos áron. A külső specifikációk szempontjából a gyárban való együttműködés teljes mértékben megmaradt. Eközben a belső tartalom teljesen megváltozott: valami hasonló a refaktoráláshoz, de a hardver esetében.
Hogyan működik a Cisco ACI architektúrája
A legegyszerűbb esetben az ACI a Clos hálózati topológiát követi, vagy ahogy gyakran nevezik, Spine-Leaf. A Spine szintű switch-ek száma lehet kettő (vagy egy, ha nem érdekel a hibatűrő képesség) és hat között. Ennek megfelelően, minél több van belőlük, annál magasabb a hibatűrő képesség (a sávszélesség és a megbízhatóság csökkenése kisebb egy Spine hiba vagy karbantartás esetén), valamint a teljesítmény. Minden külső kapcsolat a Leaf szintű switch-ekbe megy: ezek a szerverek, valamint az L2- vagy L3 alapú kapcsolódás a külső hálózatokhoz, valamint az APIC vezérlők csatlakozása. Az ACI-val kapcsolatban nemcsak a beállítás, hanem a statisztika gyűjtése, hibamonitorozás és egyéb feladatok is — mindez a vezérlők interfészén keresztül történik, amelyek a normál nagyságú telepítésekben három példányban találhatók.
A switch-ekhez soha nem szükséges csatlakozni konzollal, még a hálózat indításához sem: a vezérlő automatikusan felfedezi a switch-eket és összeállítja belőlük a gyárat, beleértve az összes szolgáltató protokoll beállításait, ezért egyébként nagyon fontos, hogy a telepítéskor feljegyezzük az adott készülék sorozatszámait, hogy később ne kelljen találgatni, melyik switch melyik rackben található. Hibaelhárításhoz a switch-ekhez SSH-n keresztül is csatlakozhatunk szükség esetén: alaposan reprodukálták az általános Cisco show parancsokat.
A gyárban IP-transportot használnak, így nincsenek Spanning Tree és egyéb borzalmak a múltból: minden kapcsolat aktív, és a hibaelhárítási idő nagyon gyors. A forgalom a gyárban VXLAN alapú alagutakon keresztül halad. Pontosabban, maga a Cisco iVXLAN-nak nevezi az encapsulációt, és ez abban különbözik a hagyományos VXLAN-tól, hogy a hálózati fejléc fenntartott mezőit a forgalom mal kapcsolatban információk átadására használják, elsősorban az EPG-csoporttal való összefüggésről. Ez lehetővé teszi a csoportok közötti interakciós szabályok megvalósítását a hardverben, a számok használatával, akárcsak a hagyományos hozzáférési listák esetében, ahol az IP-címeket használják.
Az alagutak lehetővé teszik a belső IP-transport és L2-szegmensek, valamint L3 (vagyis VRF) kiterjesztését. A default gateway elosztott. Ez azt jelenti, hogy a gyárba beérkező forgalom irányítását minden switch végzi. A forgalom továbbításának logikájában az ACI hasonlít a VXLAN/EVPN alapú gyárra.
Ha így van, akkor miben különbözik? Az összes többi dologban!
Az első különbség, amellyel az ACI-ban találkozunk, az, hogyan csatlakoznak a szerverek a hálózathoz. A hagyományos hálózatokban mind a fizikai, mind a virtuális szerverek a VLAN-okba csatlakoznak, és minden további dolog, mint a kapcsolódás és a biztonság, ebből indul ki. Az ACI viszont olyan struktúrát használ, amelyet a Cisco EPG-nek (End-point Group) nevez, amelyről nem lehet elmenekülni. Fel lehet-e equálni a VLAN-nal? Igen, de ebben az esetben nagy része veszik el annak, amit az ACI nyújt.
Az EPG-hez kapcsolódóan fogalmazzák meg a hozzáférési szabályokat, és az ACI alapértelmezés szerint a „fehér lista” elvet alkalmazza, vagyis csak az engedélyezett forgalom áthaladása megengedett. Tehát létrehozhatunk EPG-csoportokat, például „Web” és „MySQL”, és meghatározhatunk egy szabályt, amely lehetővé teszi számukra a kölcsönhatást csak a 3306-os porton. Ez az IP-címektől függetlenül fog működni, még egy alhálózaton belül is!
Vannak olyan ügyfeleink, akik az ACI-t éppen ezért a funkcióért választották, mivel lehetővé teszi a hozzáférések korlátozását a szerverek (virtuális vagy fizikai – nem számít) között anélkül, hogy őket áthelyeznénk az alhálózatok között, és ezzel nem nyúlnánk az adreszáláshoz. Igen, tudjuk, hogy senki sem írja be kézzel a konfigurációkba, igaz? IP address a alkalmazás-konfigurációkban, igaz?
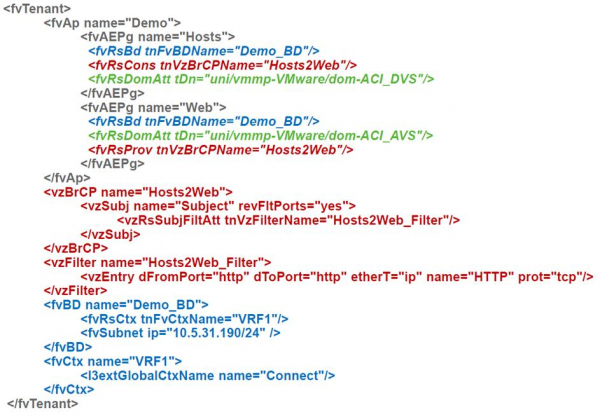
A forgalomkezelési szabályok az ACI-ban szerződéses megállapodásoknak nevezhetők. Egy ilyen szerződésben egy vagy több csoport vagy szint egy többcélú alkalmazásban szolgáltatásnyújtóvá válik (például egy adatbázis-szolgáltatás), míg mások fogyasztóként működnek. A szerződés egyszerűen átbocsáthatja a forgalmat, vagy valami bonyolultabbat is tehet, például átirányíthatja a forgalmat egy tűzfalhoz vagy terheléselosztóhoz, illetve megváltoztathatja a QoS értékét.
Hogyan kerülnek a szerverek ezekbe a csoportokba? Ha ezek fizikai szerverek vagy valami, ami egy meglévő hálózat része, amelyhez VLAN trunkot hoztunk létre, akkor ahhoz, hogy az EPG-be kerüljenek, meg kell adni a kapcsoló portját és az azon használt VLAN-t. Ahogy látjuk, a VLAN-ok ott jelennek meg, ahol nélkülük nem tudunk boldogulni.
Ha viszont a szerverek virtuális gépek, akkor elegendő hivatkozni a csatlakoztatott virtualizációs környezetre, és a többi magától fog megtörténni: létrejön egy portcsoport (ha a VMWare terminológiájával beszélünk) a VM csatlakoztatásához, hozzárendelésre kerülnek a szükséges VLAN-ok vagy VXLAN-ok, és bejegyzésre kerülnek a szükséges kapcsolóportokon, stb. Tehát bár az ACI a fizikai hálózat köré épül, a virtuális szerverek csatlakoztatása sokkal egyszerűbbnek tűnik, mint a fizikai szervereké. Az ACI már beépített integrációval rendelkezik a VMWare-rel és a MS Hyper-V-vel, valamint támogatja az OpenStack-et és a RedHat Virtualization-t. Ráadásul egy idő óta beépített támogatással bír a konténerplatformokhoz: Kubernetes, OpenShift, Cloud Foundry, és ez kiterjed a politikák alkalmazására és a monitorozásra is, tehát a hálózati adminisztrátor azonnal láthatja, hogy mely hosztokon mely podok futnak, és milyen csoportokba kerültek.
A virtuális szerverek egy adott portcsoportba való belefoglalásán kívül további tulajdonságokkal is rendelkeznek: név, attribútumok, stb., amelyeket használhatunk kritériumként, hogy áthelyezzük őket egy másik csoportba, például a VM átnevezésekor vagy egy új címke megjelenésekor. A Cisco ezt mikro-szegmentációs csoportoknak nevezi, bár lényegében a biztonsági szegmensek sokaságának létrehozására alkalmas EPG konstrukció is teljes mértékben mikro-szegmentációnak számít. Nos, ezt a gyártó tudja a legjobban.
Az EPG-k tisztán logikai konstrukciók, amelyeket nem kötnek konkrét switchekhez, szerverekhez stb., így velük és az ezekre épülő konstrukciókkal (alkalmazásokkal és tenantokkal) olyan dolgokat lehet csinálni, amelyeket nehéz megvalósítani a hagyományos hálózatokban, például klónozni. Ennek eredményeként mondjuk, nagyon könnyű létrehozni egy produktív környezet klónját, hogy tesztelési környezetet kapjunk, amely garantáltan azonos a produkcióval. Ezt meg lehet csinálni kézzel, de jobb (és egyszerűbb) API-n keresztül.
Általában az ACI kezelési logikája egyáltalán nem hasonlít arra, amivel általában találkozni szoktál
a Cisco hagyományos hálózataiban: a programozási interfész az elsődleges, míg a GUI vagy CLI másodlagos, mivel ugyanazon az API-n keresztül működnek. Ezért szinte mindenki, aki ACI-val foglalkozik, egy idő után elkezdi megérteni az objektummodellt, amelyet a kezeléshez használnak, és valamit automatizálni a saját igényei szerint. Ezt a legkönnyebben Python-ból lehet megtenni: jól használható eszközök állnak rendelkezésre.
Az ígért buktatók
A fő probléma az, hogy sok dolog az ACI-ban másképp készült. Ahhoz, hogy normálisan tudj vele dolgozni, újra kell tanulnod. Különösen a nagy ügyfelek hálózati üzemeltetési csapataira vonatkozik ez, ahol az mérnökök évek óta a VLAN-ok "beírásával" foglalkoznak a kérések alapján. Ami most VLAN, már nem VLAN, és új hálózatok létrehozásához a virtualizált hosztokban a VLAN-ok manuális létrehozása egyáltalán nem szükséges, teljesen „megőrjíti” a hagyományos hálózati szakembereket, és arra kényszeríti őket, hogy ragaszkodjanak a megszokott megközelítésekhez. Meg kell említeni, hogy a Cisco próbálta egy kissé édesebbé tenni a pirulát, és hozzáadta a vezérlőhöz az „NXOS-szerű” CLI-t, amely lehetővé teszi a beállításokat egy hagyományos switchekre hasonlító felületen. De mégis ahhoz, hogy normálisan tudj használni ACI-t, meg kell érteni, hogyan működik.
Ár szempontjából a nagy és közepes méretű ACI hálózatok ára gyakorlatilag nem különbözik a hagyományos Cisco berendezéseken alapuló hálózatokétól, mivel építésükhöz ugyanazokat a kapcsolókat használják (a Nexus 9000 kapcsolók ACI és hagyományos módban is üzemelhetnek, és mostanra az új adatközponti projektek fő "munkahorse-jává" váltak). Azonban a két kapcsolós adatközpontok esetén a vezérlők és Spine-Leaf architektúra jelenléte természetesen érezhető. Nemrégiben megjelent a Mini ACI gyár, amelyben a három vezérlőből kettőt virtuális gépekkel helyettesítettek. Ez csökkenti a költségbeli különbséget, de az továbbra is megmarad. Így az ügyfél számára a választás az biztonsági funkciók, a virtualizációval való integráció, az egységes vezérlési pont és hasonlók iránti érdeklődéstől függ.
Forrás: habr.com
