

A cikk második részében a számítógépes rendszerek szimulátorairól szóló egyszerű tájékoztató formában folytatom a beszélgetést a számítógépes szimulátorokról, nevezetesen a teljes platform szimulációról, amellyel a legtöbbször az átlagos felhasználó találkozik, valamint a ciklikus modellekről és a pályákról, amelyek inkább a fejlesztők körében elterjedtek.
A Elmondtam, hogy mik is azok a szimulátorok, és a modellezés szintjeiről is beszéltem. Most, a fentiek alapján, azt javaslom, merüljünk kicsit mélyebbre, és beszéljünk a teljes platform szimulációról, arról, hogyan készítsük el a pályákat, mit tegyünk velük később, és a ciklikus mikroarchitektúra emulációjáról.
A teljes platform szimulátor (full platform simulator), vagyis a "Egyedül a mezőn - nem harcos"
Ha egy konkrét eszköz, például egy hálózati kártya működését kell megvizsgálni, vagy ehhez az eszközhöz firmware-t vagy drivert kell írni, akkor ez az eszköz különböző formában modellezhető. Ugyanakkor kényelmetlen ezt a többi infrastruktúrától elszigetelten használni. A megfelelő driver indításához központi procesorra, memóriára, adatátviteli buszhoz és egyebekre van szükség. Ezen kívül a driver működéséhez szükséges az operációs rendszer (OS) és a hálózati verem. Ezen kívül szükség lehet egy külön csomaggenerálóra és egy válaszfogadó szerverre is.
A teljes platform szimulátor egy környezetet teremt a teljes szoftveres verem futtatásához, amely magában foglal mindent a BIOS-tól és a betöltőprogramtól kezdve egészen az operációs rendszeren (OS) és annak különböző alrendszerein, például a hálózati verem, driverek és felhasználói szintű alkalmazásokig. Ehhez a számítógép legtöbb eszközének szoftveres modelljeit valósították meg benne: processzor és memória, lemez, bemeneti-kimeneti eszközök (billentyűzet, egér, kijelző), valamint a hálózati kártya.
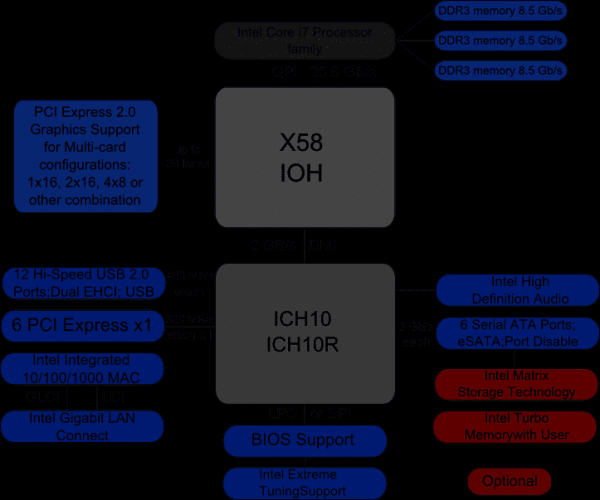
Az alábbiakban az Intel x58 chipkészletének blokkdiagramja látható. A teljes platformot szimuláló számítógéphez ezen a chipkészleten a felsorolt eszközök többségét, beleértve az IOH (Input/Output Hub) és ICH (Input/Output Controller Hub) belsejében találhatóakat is, meg kell valósítani, amelyeket a blokkdiagramon nem részleteztek. Bár a gyakorlat azt mutatja, hogy nem túl sok olyan eszköz létezik, amelyet az általunk futtatni kívánt szoftver nem használ. Az ilyen eszközök modelljeit nem szükséges létrehozni.
A leggyakrabban a teljes platformos szimulátorok a processzor utasításkészletének (ISA) szintjén valósulnak meg, lásd: ). Ez viszonylag gyorsan és olcsón lehetővé teszi a szimulátor létrehozását. Az ISA szintje azért is jó, mert többé-kevésbé állandó, ellentétben például az API/ABI szinttel, amely gyakrabban változik. Ráadásul az utasítások szintjén való megvalósítás lehetővé teszi az úgynevezett módosítatlan bináris szoftverek futtatását, vagyis a már lefordított kód módosítás nélkül történő futtatását, pontosan úgy, ahogyan az a valódi hardveren használatban van. Más szavakkal, készíthetünk egy másolatot („dumps”) a merevlemezről, megadhatjuk azt lemezként a teljes platformos szimulátor modelljének, és – voilá! – az operációs rendszer és a többi program azonnal betöltődik a szimulátorba mindenféle további lépés nélkül.
A szimulátorok teljesítménye
Ahogy korábban említésre került, a rendszer egészének, vagyis minden eszközének szimulálása meglehetősen lassú folyamat. Ha mindezt nagyon részletes szinten, például mikroarchitektúrás vagy logikai szinten valósítjuk meg, akkor a végrehajtás rendkívül lassúvá válik. Ezzel szemben az utasítások szintje megfelelő választás, és lehetővé teszi, hogy az operációs rendszer és a programok olyan sebességgel fussanak, ami elegendő a felhasználó számára a kényelmes interakcióhoz.
Itt érdemes érinteni a szimulátorok teljesítményének témáját. Általában IPS (utasítás másodpercenként) mértékegységben mérik, pontosabban MIPS (millió IPS), vagyis a szimulátor által egy másodperc alatt végrehajtott processzorutasítások számát. Ugyanakkor a szimuláció sebessége a rendszertől is függ, amelyen a szimuláció fut. Ezért talán helyesebb a szimulátor „lassulásáról” (slowdown) beszélni az eredeti rendszerhez képest.
A piacon a legelterjedtebb, teljes körű platformszimulátorok, mint a QEMU, a VirtualBox vagy a VmWare Workstation, megfelelő teljesítménnyel rendelkeznek. A felhasználó számára észrevétlen lehet, hogy a munka szimulátorban zajlik. Ez annak köszönhető, hogy a processzorokban megvalósult a virtualizációs lehetőség, a bináris fordítás algoritmusai és más érdekes dolgok. Ezek mind külön cikk témáját képezik, de ha nagyon röviden összefoglaljuk, a virtualizáció – ez a modern processzorok hardveres képessége, amely lehetővé teszi a szimulátorok számára, hogy ne szimulálják az utasításokat, hanem közvetlenül a valódi processzorhoz juttassák azokat végrehajtásra, ha természetesen a szimulátor és a processzor architektúrája hasonló. A bináris fordítás – ez a vendég gépi kód átkonvertálása gazdagépi kódra és annak végrehajtása a valódi processzoron. Ennek eredményeként a szimuláció csak minimálisan lassabb, 5-10-szer, és gyakran egyenesen azonos sebességgel működik, mint a valódi rendszer. Bár erre sok tényező hatással van. Például, ha több tucat processzorral rendelkező rendszert szeretnénk szimulálni, akkor a sebesség azonnal csökkenni fog ezekkel a pár tucat darabbal. Másrészt a Simics típusú szimulátorok legújabb verziói támogatják a többprocesszoros gazdagép „hardvert”, és hatékonyan párhuzamosítják a szimulált magokat a valódi processzor magjaira.
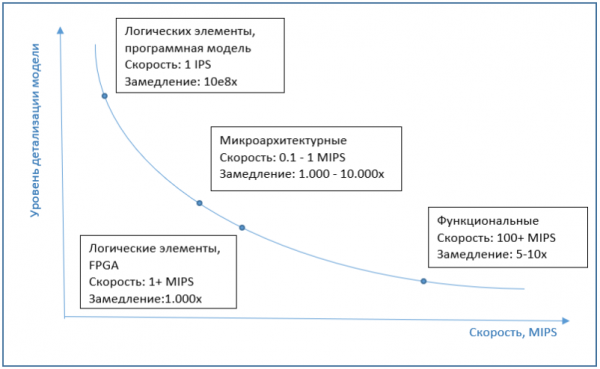
Ha a mikroarchitektúrák szimulálási sebességéről beszélünk, akkor ez általában néhány nagyságrenddel, körülbelül 1000-10000-szer lassabb, mint a szokásos számítógépen végzett végrehajtás szimuláció nélkül. A logikai elemek szintjén történő megvalósítás még további nagyságrenddel lassabb. Ezért ezen a szinten FPGA-t használnak emulátorként, ami jelentősen növeli a teljesítményt.
Az alábbi grafikon például a szimulálási sebesség és a modell részletesség közötti összefüggést mutatja.
Ütemezett szimuláció
Bár a végrehajtási sebesség nem túl magas, a mikroarchitektúrás szimulátorok meglehetősen elterjedtek. A processzor belső blokkjainak modellezése szükséges ahhoz, hogy pontosan szimulálni lehessen az egyes utasítások végrehajtási idejét. Itt félreértés adódhat – hiszen úgy tűnik, miért ne programoznánk egyszerűen az egyes utasítások végrehajtási idejét? De egy ilyen szimulátor nagyon pontatlanul működne, mivel ugyanazon utasítás végrehajtási ideje eltérhet minden egyes hívás során.
A legegyszerűbb példa a memóriahozzáférési utasítás. Ha a kért memóriacella elérhető a gyorsítótárban, a végrehajtási idő minimális lesz. Ha a gyorsítótárban nincs ilyen információ („gyorsítótár hiba”, cache miss), az jelentősen megnöveli az utasítás végrehajtási idejét. Így egy pontos szimulációhoz szükséges a gyorsítótár modellje. Azonban a gyorsítótár modellje nem az egyetlen. A processzor nem fog egyszerűen várni az adatok megszerzésére a memóriából, ha azok nem találhatók a gyorsítótárban. Ehelyett elkezdi végrehajtani a következő utasításokat, olyanokat választva, amelyek nem függenek a memóriaolvasás eredményétől. Ez az úgynevezett „rendellenes végrehajtás” (OOO, out of order execution), amely szükséges a processzor állásidejének minimalizálásához. Mindezek figyelembevételével az utasítások végrehajtási idejének kiszámításában segíthet a megfelelő processzorblokkok modellezése. Azok között az utasítások között, amelyeket végrehajtanak, amíg várják a memóriaolvasás eredményét, lehet egy feltételes ugrási művelet is. Ha a feltétel végrehajtásának eredménye jelenleg nem ismert, akkor a processzor ismét nem állítja meg a végrehajtást, hanem „megtippel”, végrehajtja a megfelelő ugrást és folytatja az utasítások megelőző végrehajtását az ugrás helyéről. Ezt a blokkot, amelyet branch predictor-nak hívnak, szintén meg kell valósítani a mikroarchitektúrás szimulátorban.
Az alábbi kép a processzor fő blokkjait mutatja, amelynek ismerete nem kötelező, csupán azért van a kép, hogy bemutassa a mikroarchitektúrás megvalósítás bonyolultságát.
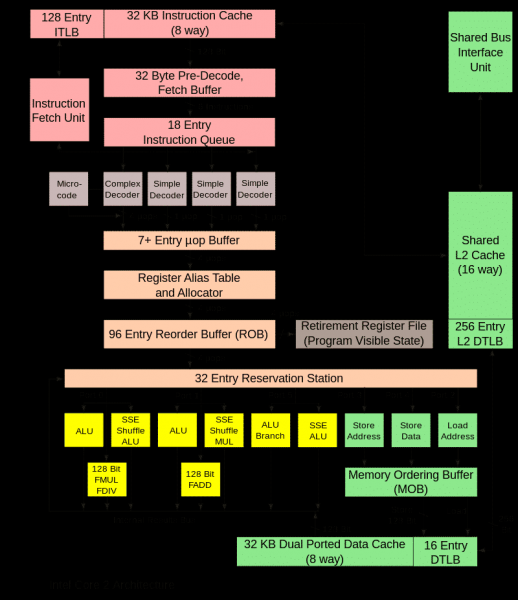
Ezeknek a blokkoknak a működése a valódi processzorban speciális órajelekkel van szinkronizálva, hasonlóan történik ez a modell esetében is. Az ilyen mikroarchitektúrájú szimulátort ciklushű (cycle accurate) szimulátornak nevezik. Fő célja a tervezett processzor teljesítményének pontos előrejelzése és/vagy egy adott program, például egy benchmark futási idejének kiszámítása. Ha az értékek az elvártak alatt vannak, akkor a processzor algoritmusait és blokkjait szükséges finomítani, vagy a programot optimalizálni.
Ahogy fentebb említettük, a ciklushű szimuláció nagyon lassú, ezért csak bizonyos programmunkafázisok vizsgálatára használják, ahol meg kell ismerni a programok valódi futási sebességét és értékelni a modellezett eszköz jövőbeli teljesítményét.
Eközben a program többi működési ideje a funkcionális szimulátorral van szimulálva. Hogyan történik ez a kombinált használat a valóságban? Először a funkcionális szimulátor elindításra kerül, amelyen betöltődik az operációs rendszer és minden szükséges a vizsgált program futtatásához. Minket nem érdekel sem az operációs rendszer, sem a program indításának kezdeti szakasza, a konfigurálás és más hasonló folyamatok. Azonban ezeket a részeket sem hagyhatjuk ki, és nem ugorhatunk egyből a program végrehajtásának közepébe sem. Ezért az összes előzetes lépést a funkcionális szimulátorban futtatják. Miután a program elérte a minket érdeklő pillanatot, két lehetőségünk van. A modellt ciklushűre cserélhetjük, és folytathatjuk a végrehajtást. Az a szimulációs mód, amely a végrehajtható kódot (azaz a szokásos lefordított programfájlokat) használja, a végrehajtásvezérelt szimulációnak (execution driven simulation) nevezzük. Ez a legelterjedtebb szimulációs variáns. Lehetséges egy másik megközelítés is – a nyomvonal alapú szimuláció (trace driven simulation).
Nyomvonal alapú szimuláció
Két lépésből áll. A funkcionális szimulátor vagy a valódi rendszer segítségével a program cselekedeteinek naplózása és fájlba történő rögzítése történik. Ezt a naplót nyomvonalnak (trace) nevezik. Attól függően, hogy mit vizsgálunk, a nyomvonal tartalmazhat végrehajtható utasításokat, memória címeket, portszámokat, megszakítási információkat.
A következő lépés a "nyomvonal" lejátszása, amikor a ciklusszimulátor olvassa a nyomvonalat és végrehajtja az abban rögzített utasításokat. A végén megkapjuk az adott programrész futási idejét, valamint különböző jellemzőket, például a cache-elé érkezés százalékát.
A nyomvonalakkal való munka fontos jellemzője a determináltság, azaz, ha a fenti módon indítjuk a szimulációt, ismételten ugyanazt a cselekvéssorozatot reprodukáljuk. Ez lehetővé teszi, hogy a modell paramétereinek (cache, pufferek és sorok méretei) megváltoztatásával, valamint különböző belső algoritmusok alkalmazásával vagy azok konfigurálásával kutassuk, hogy egy-egy paraméter hogyan befolyásolja a rendszer teljesítményét és melyik változat adja a legjobb eredményeket. Mindezt elvégezhetjük a készülék prototípusának modellezésével a valós hardver prototípusának létrehozása előtt.
A megközelítés bonyolultsága abban rejlik, hogy előzetesen le kell futtatni az alkalmazást és összegyűjteni a nyomvonalat, valamint a nyomvonal fájlja hatalmas méretű. Az előnyök közé tartozik, hogy elegendő modellezni csupán a készülék vagy platform érdekes részét, míg a tényleges végrehajtás szimulációja általában teljes modellt igényel.
Tehát ebben a cikkben a teljes platform szimuláció jellemzőit tárgyaltuk, beszéltünk a végrehajtás sebességéről különböző szinteken, a ciklusos szimulációról és a nyomvonalakról. A következő cikkben azokat a főbb szcenáriókat írom le, amelyek a szimulátorok használatára vonatkoznak, akár személyes célokra, akár nagyvállalati fejlesztési szempontból.
Forrás: habr.com
