

Ez a cikk a gyors adatkompresszióról szóló téma második része. Az első cikkben egy tíz gigabyte/másodperces sebességgel működő tömörítőről volt szó, amely egy processzor magra van optimalizálva (minimális tömörítés, RTT-Min).
Ez a tömörítő már beépítésre került a kriminális másoló berendezésekbe az adathordozók gyors tömörítésére és a kriptográfia ellenállásának fokozására; emellett virtuális gépek képeinek és a RAM swap fájlok tömörítésére is alkalmazható, amikor gyors SSD tárolókra kerülnek.
Az első cikkben egy HDD és SSD háttértárolók biztonsági mentéseinek tömörítésére szolgáló algoritmus fejlesztésének bejelentésére is sor került (átlagos tömörítés, RTT-Mid), jelentős adatkompressziós paraméterekkel. Jelenleg ez a tömörítő teljesen kész, és ez a cikk kifejezetten róla szól.
A RTT-Mid algoritmust megvalósító tömörítő tömörítési arányt biztosít, amely összehasonlítható a hagyományos tömörítő programokkal, mint például a WinRar és a 7-Zip, amelyek gyors üzemmódba működnek. Eközben a sebessége legalább egy nagyságrenddel magasabb.
Az adatok tömörítési/dekompressziós sebessége kritikus paraméter, amely meghatározza a tömörítési technológiák alkalmazási területét. Aligha jutna bárkinek eszébe, hogy egy terabyte adatot 10-15 megabyte/másodperc sebességgel tömörítsen (ez a sebesség a hagyományos tömörítési üzemmódban), hiszen ez majdnem húsz órát venne igénybe teljes CPU terhelés mellett…
Másrészt ugyanazt a terabyte-ot 2-3 gigabyte/másodperc sebességgel körülbelül tíz perc alatt le lehet másolni.
Ezért a nagy volumenű adatok tömörítése aktuális, ha azt valós idejű bemeneti/kimeneti sebességgel végezzük. A modern rendszerek esetében ez legalább 100 megabyte/másodperc.
Ilyen sebességeket a modern tömörítők csak 'gyors' üzemmódban tudnak produkálni. Ebben az aktuális üzemmódban fogjuk összehasonlítani az RTT-Mid algoritmust a hagyományos tömörítőkkel.
Összehasonlító tesztelés a új tömörítési algoritmus
Az RTT-Mid tömörítő a tesztprogram részeként működött. Valós "munka" alkalmazásban jelentősen gyorsabban működik, ott hatékonyan használják a több szálas feldolgozást, és 'normális' fordítót alkalmaznak, nem C#-t.
Mivel a használt összehasonlító tesztben a tömörítők különböző elveken alapulnak és különböző típusú adatokat más módon tömörítenek, a teszt objektivitása érdekében az "átlaghőmérséklet a kórházban" módszert alkalmazták...
Készült egy szektoros dump fájl a Windows 10 operációs rendszerhez, ez a legtermészetesebb keveréke a különböző adatszerkezeteknek, amelyek valójában minden számítógépen megtalálhatók. Ennek a fájlnak a tömörítése lehetővé teszi az új algoritmus sebességének és tömörítési mértékének összehasonlítását a piacon lévő legkorszerűbb tömörítőkkel.
Íme ez a dump fájl:
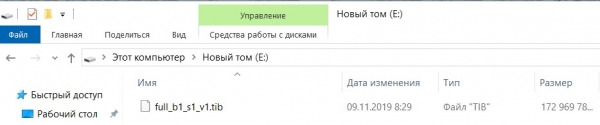
A dump fájlt az RTT-Mid, 7-zip, WinRar tömörítők tömörítették. A WinRar és 7-zip tömörítők maximális teljesítményre voltak állítva.
Tömörítő működik 7-zip:
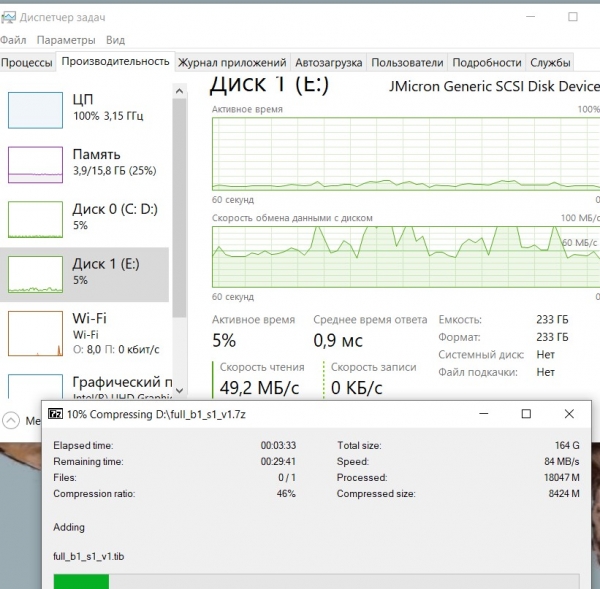
Teljes mértékben terheli a processzort, miközben a forrás dump átlagos olvasási sebessége körülbelül 60 MegaByte/sec.
Tömörítő működik WinRar:
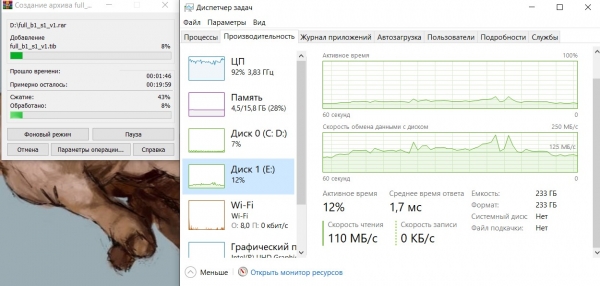
Hasonló a helyzet, a processzor terheltsége gyakorlatilag 100%, a dump átlagos olvasási sebessége körülbelül 125 MegaByte/sec.
Ahogy az előző esetben is, az archiver sebességét a processzor határozza meg.
Most a tömörítő tesztprogram működik RTT-Mid:
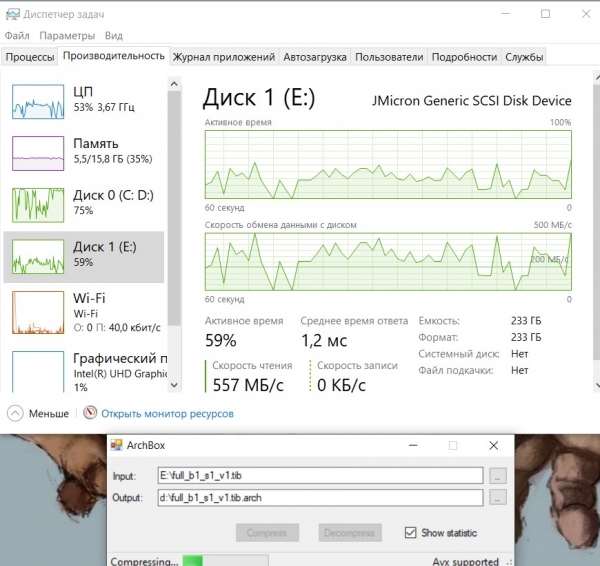
A képernyőkép megmutatja, hogy a processzor 50%-os terheltséggel működik, és a többi időt tétlenül tölti, mert nincs hová kiadni a tömörített adatokat. Az adatok kiadási lemeze (0. lemez) gyakorlatilag teljesen betöltött. Az adatok olvasási sebessége (1. lemez) nagyon ingadozik, de átlagosan meghaladja a 200 MegaByte/sec.
A tömörítő munkájának sebességét ebben az esetben a tömörített adatok írásának lehetősége határozza meg a 0. lemezre.
Most a kapott archívumok tömörítési mértéke:
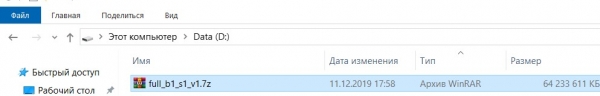
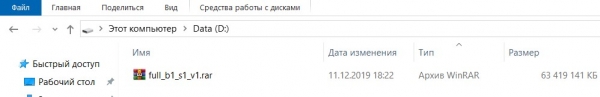
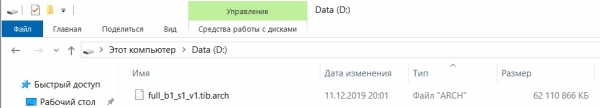
Látható, hogy az RTT-Mid tömörítő a legjobban teljesített, általa létrehozott archívum 1,3 Gigabyte-tal kisebb, mint a WinRar archívuma, és 2,1 Gigabyte-tal kisebb, mint a 7z archívuma.
Az archívum létrehozására fordított idő:
- 7-zip – 26 perc 10 másodperc;
- WinRar – 17 perc 40 másodperc;
- RTT-Mid – 7 perc 30 másodperc.
Így még a tesztprogram, amely nem volt optimalizálva, az RTT-Mid algoritmus használatával több mint két és fél szer gyorsabban tudta létrehozni az archívumot, amely jelentősen kisebb lett, mint a versenytársaké...
Akik nem hisznek a képernyőképeknek, maguk is ellenőrizhetik a hitelességüket. A tesztprogram elérhető itt: , töltse le és ellenőrizze.
De csak az AVX-2 támogatott processzorain, ezek az utasítások nélkül a tömörítő nem működik, ezért ne tesztelje az algoritmust régi AMD processzorokon, mert azok lassúak az AVX utasítások végrehajtásában...
A használt tömörítési módszer
Az algoritmus a szöveg ismétlődő fragmentumainak bájtos granulatúrában történő indexelési módszerét alkalmazza. Ez a tömörítési módszer régóta ismert, de nem használták, mivel a megfelelő találatok keresése nagyon erőforrás-igényes volt, és sokkal több időt igényelt, mint egy szótár létrehozása. Így az RTT-Mid algoritmus a „vissza a jövőbe” klasszikus példája...
Az RTT tömörítőben egy egyedi, gyors találatkereső használt, amely lehetővé tette a tömörítési folyamat felgyorsítását. A saját gyártású kereső, ez a 'szépségem...', 'nem olcsó, mert teljesen kézzel készült' (assembler nyelven írták).
A találatkereső kétlépcsős valószínűségi sémán alapul, először a „megemlés” jelét keresi, és csak azután, hogy ezt a jelet felfedezi, elindítja a valódi találat felfedezésének eljárását.
A találatkereső ablaka kiszámíthatatlan méretű, amely a feldolgozott adathalmaz entrópiájának mértékétől függ. Teljesen véletlenszerű (nem tömöríthető) adatok esetén mérete megabájt, míg a visszatérően előforduló adatok esetén mindig egy megabájt felett van.
De sok modern adatforma nem tömöríthető, ezért a rájuk erőforrás-igényes keresőt futtatni haszontalan és pazarló, ezért a kereső két üzemmódban működik. Először megpróbálja megtalálni a kiindulási szöveg azon részeit, ahol lehetséges ismétlődések vannak, ezt a műveletet szintén valószínűségi módszerrel végzi, és nagyon gyorsan (4-6 GB/s sebességgel) hajtja végre. Ezután a potenciális találattal rendelkező részeket a fő kereső dolgozza fel.
Az index alapú tömörítés nem túl hatékony, mivel az ismétlődő fragmentumokat indexekkel kell helyettesíteni, és az indextömb jelentősen csökkenti a tömörítési arányt.
A tömörítési fok növelése érdekében nemcsak a teljesen egybeeső bájtsorok kerülnek indexelésre, hanem a részlegesek is, amikor a sorban vannak egybeeső és nem egybeeső bájtok. Ehhez az indexformátumban szerepel egy egyezési maszk mező, amely jelzi a két blokk egybeeső bájtjait. Még nagyobb tömörítés érdekében több részben egybeeső blokk együttes indexelését is alkalmazzuk az aktuális blokkra.
Mindez lehetővé tette, hogy a RTT-Mid tömörítő a szótári módszer alkalmazásával készült tömörítőkhoz hasonló tömörítési fokot érjen el, de sokkal gyorsabban működjön.
Az új tömörítési algoritmus működési sebessége
Ha a tömörítő monopolizált memória cache használattal működik (egy szálhoz 4 Megabájt szükséges), akkor a működési sebesség 700-2000 Megabájt/sec között ingadozik egy processzormag esetében, attól függően, hogy milyen típusú adatokat tömörítenek, és kevéssé függ a processzor órajelétől.
Többszálas tömörítő megvalósítás esetén a hatékony skálázás a harmadik szintű memória cache mennyiségétől függ. Például, ha 9 Megabájt cache memóriával rendelkezik, nincs értelme több mint két tömörítési szálat indítani, mivel a sebesség ettől nem fog nőni. De 20 Megabájt cache-nél már lehet indítani öt tömörítési szálat.
A tömörítési sebesség szempontjából jelentős tényező a RAM késleltetése is. Az algoritmus véletlenszerű hozzáféréseket használ a RAM-hoz, ezek közül egy része nem kerül be a cache memóriába (körülbelül 10%), ami lassítást okoz, mivel az algoritmusnak várnia kell az RAM-ból származó adatokra.
A tömörítő sebességére a bemeneti/kimeneti rendszer működése is jelentős hatással bír. A bemenet/kimenet által kezdeményezett RAM-kérések blokkolják a CPU-ból érkező adatigényléseket, ami szintén csökkenti a tömörítési sebességet. Ez a probléma jelentős a laptopok és asztali számítógépek esetében, szerverek de ebből a szempontból kevésbé lényeges a fejlettebb rendszerbusz-hozzáférési vezérlő és a többsávos RAM miatt.
A szövegben a tömörítéssel foglalkozunk, a dekompresszió viszont nem része ennek a cikknek, mivel ott „minden rendben van”. A dekompresszió jelentősen gyorsabb, és az I/O sebessége korlátozza. Egy fizikai mag egy szálban nyugodtan biztosítja a kicsomagolás sebességét 3-4 Gigabájt/másodperc.
Ez a kicsomagolási folyamatban a megfelelés keresésének hiányával függ össze, amely „elfogyasztja” a processzor és a gyorsítótár fő erőforrásait a tömörítés során.
A tömörített adatok megbízható tárolása
Ahogyan a tömörítést használó szoftverek (archiválók) neve is mutatja, ezek célja az információk hosszú távú tárolása, nem évekre, hanem évszázadokra és akár évezredekig...
Az információtároló eszközök tárolásának során az adatok egy része elveszik, itt egy példa:
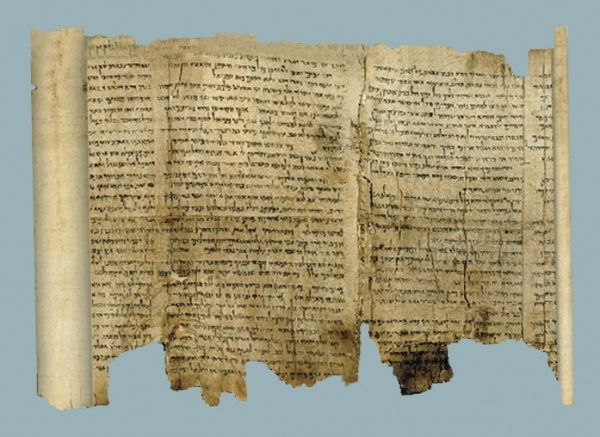
Ennek az „analóg” információtárolónak ezer éve, néhány részlet elveszett, de összességében az információ „olvasható”...
A modern digitális adattároló rendszerek és az ezekhez tartozó digitális eszközök gyártói egyike sem ad garanciát a teljes adatmegőrzésre 75 évnél hosszabb időre.
És ez probléma, de elhalasztott probléma, a megoldása a leszármazottaink feladata lesz...
A digitális adatok tároló rendszerei nemcsak 75 év elteltével veszthetnek adatokat, az adatokban hibák bármikor megjelenhetnek, még az írás során is, ezeket a torzulásokat próbálják minimalizálni redundanciával és hibajavító rendszerek alkalmazásával. A redundancia és a hibajavító rendszerek nem mindig képesek helyreállítani az elveszett információt, ha pedig sikerül, akkor sincs garancia arra, hogy a helyreállítási művelet helyesen zajlott le.
És ez is nagy probléma, de nem elhalasztott, hanem aktuális.
A modern tömörítők, amelyeket digitális adatok archiválására használnak, különféle szótári módszerek módosításain alapulnak, és az ilyen archívumok esetében az információ egy részének elvesztése végzetes esemény lehet, van egy bevett kifejezés is az ilyen helyzetre — „törött” archívum...
Az információ tárolásának alacsony megbízhatósága szótáras tömörítéssel rendelkező archívumokban a tömörített adatok struktúrájával függ össze. Az ilyen archívumban az információ nem tartalmazza az eredeti szöveget, csak a szótárban szereplő rekordok számait tárolja, a szótár pedig dinamikusan módosul a jelenlegi tömörítendő szöveggel. Ha az archívum egy részét elveszítjük vagy torzítjuk, akkor a következő rekordok az archívumban sem a tartalmuk, sem a szótárban lévő rekord hosszúságát figyelembe véve nem azonosíthatók, mivel nem egyértelmű, hogy a szótári rekord száma mit képvisel.
Az ilyen «megsérült» archívumból származó információt lehetetlen helyreállítani.
Az RTT algoritmus egy megbízhatóbb módszeren alapul, amely a tömörített adatok tárolására szolgál. Az indexszel ellátott módszert alkalmaz a megismétlődő fragmentumok nyomon követésére. Ez a tömörítési megközelítés minimalizálja az információk torzulásának következményeit a tárolón, és sok esetben automatikusan korrigálja a tárolási folyamat során felmerült torzulásokat.
Ez abból fakad, hogy az archív fájl indexszel tömörítve két mezőt tartalmaz:
- az eredeti szöveg mezője, amelyből eltávolították a megismételt részeket;
- az indexek mezője.
Az információ helyreállítása szempontjából kritikus fontosságú indexmező mérete nem nagy, és biztonsági okokból meg lehet duplikálni. Ezért még ha az eredeti szöveg vagy index tömb egy része elveszik is, a többi információ problémamentesen helyreállítható, mint a képen az «analóg» információs tárolóban.
Az algoritmus hátrányai
A hátrányok nélküli előnyök nem léteznek. Az index módszer nem tömöríti a kis hosszúságú megismétlődő sorozatokat. Ez az index módszer korlátaival magyarázható. Az indexek mérete legalább 3 bájt, és akár 12 bájt is lehet. Ha a megismétlődés kisebb méretű, mint az azt leíró index, akkor azt nem veszik figyelembe, bármennyire is gyakran forduljanak elő az ilyen megismétlődések a tömörített fájlban.
A hagyományos, szótári alapú tömörítési módszer hatékonyan csökkenti a kis hosszúságú többszöröződéseket, így nagyobb tömörítési arányt ér el, mint az index alapú tömörítés. Ez azonban a központi feldolgozóegység magas terhelésének árán történik, mivel a szótári módszernek ahhoz, hogy hatékonyabban tömörítse az adatokat, mint az index módszer, a feldolgozási sebességét 10-20 megabájtra kell csökkentenie másodpercenként a valós számítási környezetekben a CPU teljes terhelése mellett.
Az ilyen alacsony sebességek elfogadhatatlanok a modern adatkezelő rendszerek számára, és inkább 'akadémiai' érdeklődésre tartanak számot, mint gyakorlati haszonra.
Az információ tömörítési mértéke lényegesen növekedni fog a következő RTT (RТT-Max) algoritmus módosításával, amely már fejlesztés alatt áll.
Tehát, mint mindig, a folytatás következik...
Forrás: habr.com
