

A Badoo-nál folyamatosan figyeljük az új technológiákat és értékeljük, hogy érdemes-e azokat alkalmazni a rendszerünkben. Ezen kutatások egyike, amelyről szeretnénk megosztani a közösséggel, a Loki nevű logaggregáló rendszerre vonatkozik.
A Loki egy megoldás a logok tárolására és megtekintésére, ez a stack rugalmas rendszert biztosít azok elemzésére és az adatok Prometheusba történő küldésére is. Májusban újabb frissítés jelent meg, amelyet a fejlesztők aktívan népszerűsítenek. Minket az érdekelt, mit tud a Loki, milyen lehetőségeket kínál és mennyire szolgálhat alternatívaként az ELK stack számára, amelyet jelenleg használunk.
Mi az a Loki
A Grafana Loki egy összetevőkészlet a logokkal való teljes körű munka rendszeréhez. Más hasonló rendszerekkel ellentétben a Loki az ötlet alapján épül fel, hogy csak a logok metaadatait indexeljük – címkéket (labels), akárcsak a Prometheusban, míg magukat a logokat különböző chunkokba tömörítjük.
,
Mielőtt rátérnénk arra, hogy mit lehet csinálni a Loki segítségével, szeretném tisztázni, mit jelent az, hogy "csak a metaadatokat indexeljük". Hasonlítsuk össze a Loki megközelítését és a hagyományos megoldások, például az Elasticsearch indexelési megközelítését, egy nginx log sor példáján keresztül:
172.19.0.4 - - [01/Jun/2020:12:05:03 +0000] "GET /purchase?user_id=75146478&item_id=34234 HTTP/1.1" 500 8102 "-" "Stub_Bot/3.0" "0.001"A hagyományos rendszerek teljesen elemzik a sort, beleértve a rengeteg egyedi értéket tartalmazó user_id és item_id mezőket, és mindent nagy indexekbe tárolnak. Ennek a megközelítésnek az előnye, hogy összetett lekérdezéseket lehet gyorsan végrehajtani, mivel szinte az összes adat az indexben van. Azonban ennek az az ára, hogy az index nagyra nő, ami memóriaigényeket von maga után. Végül a logok teljes szövegindexe méretben összehasonlítható a logokkal magukkal. Ahhoz, hogy gyorsan kereshessünk rajta, az indexnek a memóriában kell lennie. Minél több log van, annál gyorsabban nő az index és annál több memóriát igényel.
A Loki megkövetelése, hogy a szövegből csak a szükséges adatokat vonjuk ki, amelyek száma csekély. Így egy kis indexet kapunk, és tudunk keresni az adatok között, idő és indexelt mezők szerint szűrve, majd a maradékot reguláris kifejezésekkel vagy részszöveg kereséssel átkutatva. A folyamat nem tűnik a leggyorsabbnak, de a Loki több részre bontja a lekérdezést, és párhuzamosan hajtja végre őket, nagy mennyiségű adatot feldolgozva rövid idő alatt. A shardok száma és a párhuzamos lekérdezések konfigurálhatók; így az időegység alatt feldolgozható adatok mennyisége lineárisan függ a rendelkezésre álló erőforrások számától.
Ez a kompromisszum a nagy gyors index és a kis index között, amely párhuzamos teljes keresést tesz lehetővé, a Loki számára lehetővé teszi az rendszer költségeinek ellenőrzését. Rugalmassága segít a szükségletekhez való alkalmazkodásban és bővítésben.
A Loki-stack három összetevőből áll: Promtail, Loki, Grafana. A Promtail összegyűjti a naplókat, feldolgozza azokat és elküldi a Loki-nak. A Loki tárolja őket. A Grafana pedig képes lekérdezni az adatokat a Lokiból és megjeleníteni azokat. A Loki nemcsak naplók tárolására és azok keresésére használható. Az egész stack hatalmas lehetőségeket biztosít a beérkező adatok feldolgozására és elemzésére, a Prometheus módszertani megközelítést alkalmazva.
A telepítési folyamat leírását itt találja .
Naplókeresés
Naplókat kereshet a Grafana különböző felületén — Explorer. A lekérdezésekhez LogQL nyelvet használnak, amely nagyon hasonlít a PromQL-re, amelyet a Prometheus-ban használnak. Gyakorlatilag elmondható, hogy egy elosztott grep-ként is értékelhető.
A keresési felület így néz ki:
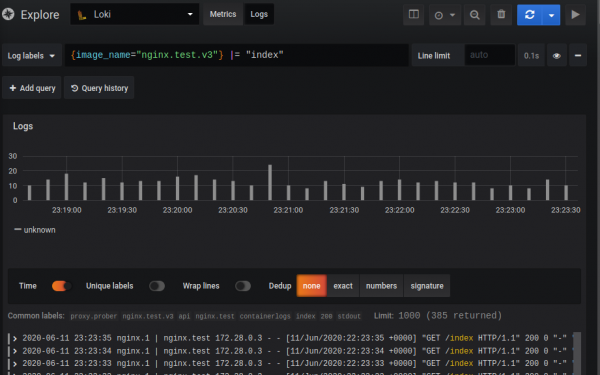
A lekérdezés két részből áll: selector és filter. A selector az indexelt metaadatokon (címkéken) való keresést jelenti, amelyek a naplókhoz vannak hozzárendelve, míg a filter a keresési szöveget vagy reguláris kifejezést határoz meg, amellyel a selector által definiált bejegyzések szűrhetők. A megadott példában: A kapcsos zárójelek között van a selector, minden ami utána következik — a filter.
{image_name="nginx.promtail.test"} |= "index"A Loki működési elvének köszönhetően nem lehet lekérdéseket végezni selector nélkül, de a címkék tetszőleges mértékben általánosíthatók.
A selector kulcs-érték párok a kapcsos zárójelek között. Lekérdezési feltételek kombinálására és különböző keresési feltételek megadására van lehetőség az =, != vagy reguláris kifejezések használatával:
{instance=~"kafka-[23]",name!="kafka-dev"}
// Keresni fog a labelekkel rendelkező naplókat, amelyek értéke kafka-2, kafka-3, és kizárja a dev-et.
A szűrő egy szöveg vagy reguláris kifejezés, amely kiszűri az összes adatot, amelyet a kiválasztó kapott.
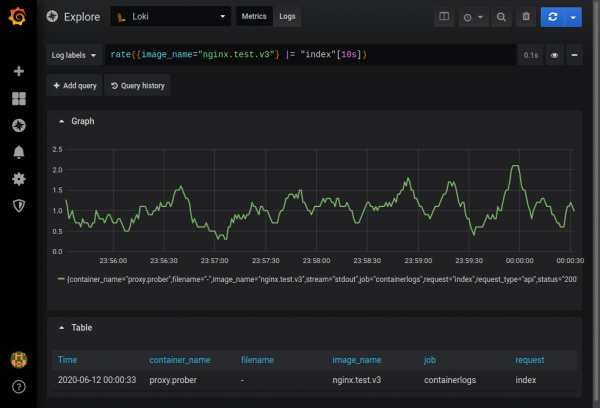
Lehetőség van ad-hoc grafikonok készítésére a kapott adatok alapján a metrics módban. Például meg lehet tudni, milyen gyakorisággal jelenik meg a naplókban az nginx bejegyzés, amely tartalmazza az index szót:
A lehetőségek teljes leírását a dokumentációban találhatja meg. .
Naplók parsolása
Többféle módon lehet begyűjteni a naplókat:
- Promtail segítségével, a naplók összegyűjtésére szolgáló standard összetevő segítségével.
- Közvetlenül a Docker konténerből a
- Fluentd vagy Fluent Bit használatával, amelyek képesek adatokat küldeni a Lokiba. A Promtail-tól eltérően, ezek előre definiált parsolókkal rendelkeznek szinte bármilyen naplófajta esetén, és kezelik a multiline naplókat is.
Általában a Promtail-t használják a parsolásra. Három dolgot csinál:
- Megkeresi az adatforrásokat.
- Címkéket társít hozzájuk.
- Adatokat küld a Lokiba.
Jelenleg a Promtail képes olvasni a naplókat helyi fájlokból és a systemd naplóból. Minden gépen telepítve kell lennie, ahonnan a naplókat gyűjtik.
Kubernetes-integráció is van: a Promtail automatikusan a Kubernetes REST API-n keresztül tudomást szerez a klaszter állapotáról, és naplókat gyűjt a nodról, szolgáltatásról vagy podról, azonnal címkéket helyezve el a Kubernetes metadatok (pod neve, fájl neve stb.) alapján.
Címkéket is elhelyezhetünk a naplókból származó adatok alapján Pipeline segítségével. A Promtail pipeline négyféle szakaszból állhat. Részletek a , említem meg néhány részletet.
- Parsing szakaszok. Ez a RegEx és JSON szakasz. Ezen a ponton olyan adatokat vonunk ki a naplókból, amelyeket extracted map-nak nevezünk. JSON-ból közvetlenül másolhatunk mezőket az extracted map-ba, vagy reguláris kifejezésekkel (RegEx) vonhatunk ki adatokat, ahol az extracted map „címkéi” a named groups. Az extracted map egy kulcs-érték tár, ahol a key a mező neve, az value pedig annak értéke a naplókban.
- Transform szakaszok. Ennek a szakasznak két lehetősége van: transform, ahol a transzformációs szabályokat határozzuk meg, és source – az adatok forrása a transzformációhoz az extracted map-ból. Ha az extracted map-ban nincs ilyen mező, akkor az létrejön. Így olyan címkéket hozhatunk létre, amelyek nem az extracted map-re alapoznak. Ezen a ponton manipulálhatjuk az extracted map adatokat, elegendően erős . Ezenkívül fontos megjegyezni, hogy az extracted map teljes egészében betöltődik a parszolás során, ami lehetővé teszi például annak ellenőrzését, hogy létezik-e egy érték benne: “{{if .tag}tag value exists{end}}”. A sablon támogatja a feltételeket, ciklusokat és néhány karakterlánc-funkciót, mint a Replace és a Trim.
- Akciós lépések. Ezen a lépésen valamit lehet csinálni az extracted-al:
- Hozzon létre egy címkét az extracted data-ból, amelyet indexelni fog a Loki.
- Módosítsa vagy állítsa be az esemény időpontját a naplóból.
- Módosítsa a (napló szöveg) adatokat, amelyek a Loki-ba kerülnek.
- Hozzon létre metrikákat.
- Szűrési lépések. A match lépés, ahol vagy a /dev/null-ba küldheti azokat a feljegyzéseket, amelyeket nem akarunk, vagy további feldolgozásra irányíthatja őket.
Megmutatom egy példa által bemutatott szokványos nginx naplók feldolgozásán, hogy hogyan lehet naplókat parse-olni a Promtail segítségével.
Teszteléshez egy módosított nginx jwilder/nginx-proxy:alpine képet fogunk használni nginx-proxyként, és egy kis démon, amely képes kérdezni önmagát HTTP-n. A démonhoz néhány végpont van megadva, amelyek különböző méretű válaszokat adhatnak különböző HTTP státuszokkal és eltérésekkel.
Napokat gyűjtünk a docker konténerekből, amelyeket a /var/lib/docker/containers//-json.log úton találhatók.
A docker-compose.yml fájlban beállítjuk a Promtail-t, és megadjuk a konfigurációs fájl útvonalát:
promtail:
  image: grafana/promtail:1.4.1
 // ...
 volumes:
   - /var/lib/docker/containers:/var/lib/docker/containers:ro
   - promtail-data:/var/lib/promtail/positions
   - ${PWD}/promtail/docker.yml:/etc/promtail/promtail.yml
 command:
   - '-config.file=/etc/promtail/promtail.yml'
 // ...
Hozzáadjuk a promtail.yml-hez a naplók útvonalát (a konfigurációban van egy 'docker' opció, ami egy sorban elvégzi ugyanezt, de ez nem lenne annyira szemléletes):
scrape_configs:
 - job_name: containers

   static_configs:
       labels:
         job: containerlogs
         __path__: /var/lib/docker/containers/*/*log  # csak Linux számára
Ha ilyen konfigurációt aktiválunk, a Loki-ba az összes konténer naplói kerülnek. Ennek elkerülése érdekében módosítjuk a teszt nginx beállításait a docker-compose.yml -ben — hozzáadjuk a tagging naplózást:
proxy:
 image: nginx.test.v3
//…
 logging:
   driver: "json-file"
   options:
     tag: "{{.ImageName}}|{{.Name}}"
Módosítjuk a promtail.yml-t, és beállítjuk a Pipeline-t. A bemeneten a következő típusú naplók érkeznek:
{"log":"u001b[0;33;1mnginx.1    | u001b[0mnginx.test 172.28.0.3 - - [13/Jun/2020:23:25:50 +0000] "GET /api/index HTTP/1.1" 200 0 "-" "Stub_Bot/0.1" "0.096"n","stream":"stdout","attrs":{"tag":"nginx.promtail.test|proxy.prober"},"time":"2020-06-13T23:25:50.66740443Z"}
{"log":"u001b[0;33;1mnginx.1    | u001b[0mnginx.test 172.28.0.3 - - [13/Jun/2020:23:25:50 +0000] "GET /200 HTTP/1.1" 200 0 "-" "Stub_Bot/0.1" "0.000"n","stream":"stdout","attrs":{"tag":"nginx.promtail.test|proxy.prober"},"time":"2020-06-13T23:25:50.702925272Z"}
Pipeline fázis:
 - json:
     expressions:
       stream: stream
       attrs: attrs
       tag: attrs.tag
Kivesszük a beérkező JSON-ból a stream, attrs, attrs.tag mezőket (ha léteznek), és elhelyezzük őket az extracted map-ben.
 - regex:
     kifejezés: ^(?P([^|]+))|(?P([^|]+))$
     forrás: "tag"
Ha sikerült a tag mezőt az extracted map-be helyezni, akkor reguláris kifejezéssel kinyerjük a kép és a tartály neveket.
 - címkék:
     image_name:
     container_name:
Címkéket rendelünk. Ha az extracted data-ban megtalálhatóak az image_name és container_name kulcsszavak, akkor azok értékei a megfelelő címkékhez lesznek rendelve.
 - egyezés:
     kiválasztó: '{job="docker",container_name="",image_name=""}'
     művelet: drop
Elvetjük az összes logot, ahol nem találhatóak az image_name és container_name címkék.
  - egyezés:
     kiválasztó: '{image_name="nginx.promtail.test"}'
     szakaszok:
       - json:
           kifejezések:
             sor: log
Minden log esetében, ahol az image_name értéke nginx.promtail.test, kinyerjük a sor mezőt a forrás logból és elhelyezzük az extracted map-ben row kulccsal.
  - regex:
         # elnyomni a forego színeket
         kifejezés: .+nginx.+|.+[0m(?P[a-z_.-]+) +(?P.+)
         forrás: logrow
Tisztítjuk a bemeneti sort reguláris kifejezésekkel és kivesszük az nginx virtuális host-ot és az nginx log sorát.
     - regex:
         forrás: nginxlog
         kifejezés: ^(?P[w.]+) - (?P[^ ]*) [(?P[^ ]+).*] "(?P[^ ]*) (?P[^ ]*) (?P[^ ]*)" (?P[d]+) (?P[d]+) "(?P[^"]*)" "(?P[^"]*)"( "(?P[d.]+)")?
Feldolgozzuk az nginx logot reguláris kifejezésekkel.
    - regex:
           forrás: request_url
           kifejezés: ^.+.(?Pjpg|jpeg|gif|png|ico|css|zip|tgz|gz|rar|bz2|pdf|txt|tar|wav|bmp|rtf|js|flv|swf|html|htm)$
     - regex:
           forrás: request_url
           kifejezés: ^/photo/(?P[^/?]+).*$
       - regex:
           forrás: request_url
           kifejezés: ^/api/(?P[^/?]+).*$
Feldolgozzuk a request_url-t. Reguláris kifejezésekkel meghatározzuk a kérés célját: statikus tartalom, fotók, API, és a megfelelő kulcsot felvesszük az extracted map-be.
       - sablon:
           forrás: request_type
           sablon: "{{if .photo}}photo{{else if .static_type}}static{{else if .api_request}}api{{else}}other{{end}}"
A sablonban feltételes operátorok segítségével ellenőrizzük az extracted map-ben beállított mezőket, és a request_type mezőnek megfelelő értékeket rendelünk: photo, static, API. Ha nem sikerül, other értéket adunk meg. Most a request_type tartalmazza a kérés típusát.
       - címkék:
           api_request:
           virtual_host:
           request_type:
           státusz:
Beállítjuk az api_request, virtual_host, request_type és státusz (HTTP státusz) címkéket a megfelelő értékek alapján, amelyek belekerültek az extracted map-be.
       - output:
           forrás: nginx_log_row
Megváltoztatjuk az output-ot. Most a tisztított nginx log az extracted map-ből kerül a Loki-ba.
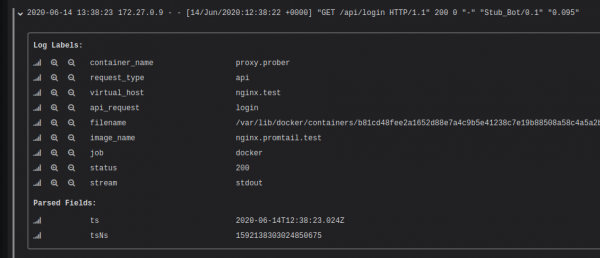
A friss konfiguráció elindítása után látható, hogy minden bejegyzéshez címkék lettek rendelve a log adatai alapján.
Fontos figyelembe venni, hogy a sok érték (cardinality) kinyerése a Loki-ból jelentősen lelassíthatja annak működését. Azaz nem érdemes például user_id-t indexbe helyezni. További részletek erről a „”. De ez nem jelenti azt, hogy nem lehet user_id alapján keresni indexek nélkül. A keresés során szűrőket kell használni („grep”-elni az adatok között), az index pedig az adatfolyam azonosítójaként szolgál.
Naplók vizualizálása
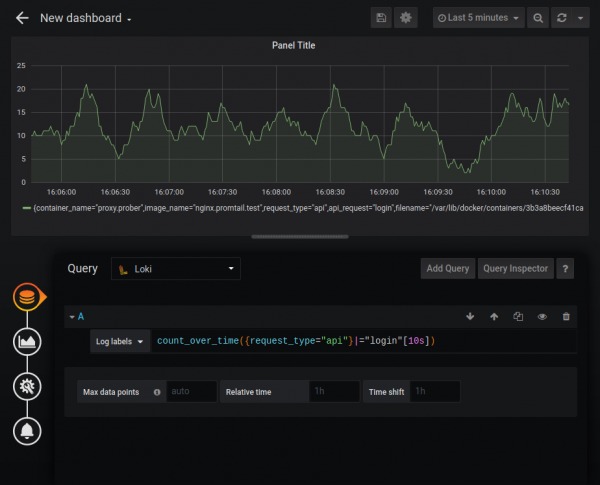
A Loki adatforrásként szolgálhat a Grafana grafikonjainak, használva a LogQL-t. Az alábbi funkciók támogatottak:
- rate — a másodpercenkénti bejegyzések száma;
- count over time — a megadott időtartomány alatt bejegyzések száma.
További aggregáló funkciók is elérhetők, mint például Sum, Avg és mások. Elég bonyolult grafikonokat lehet készíteni, például a HTTP hibák számát ábrázoló grafikon:
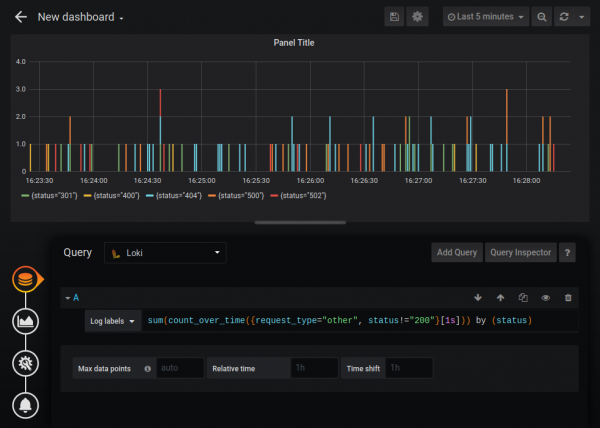
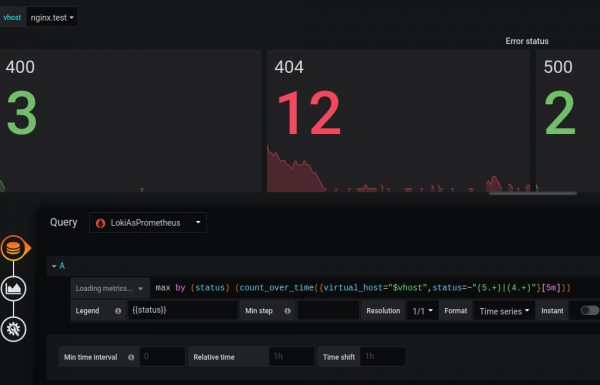
A standard Loki adatforrás funkciókban kissé korlátozott a Prometheus adatforrással összehasonlítva (például nem lehet megváltoztatni a jelmagyarázatot), de a Loki-t Prometheus típusú forrásként is csatlakoztathatjuk. Nem vagyok benne biztos, hogy ez dokumentált viselkedés, de a fejlesztők válasza alapján „”, például ez teljesen megengedett, és a Loki teljes mértékben kompatibilis a PromQL-lel.
Hozzáadjuk a Loki-t Prometheus típusú adatforrásként, és hozzáfűzzük az URL-t /loki:

Aztán grafikonokat készíthetünk, mintha a Prometheus-ból származó metrikákkal dolgoznánk:
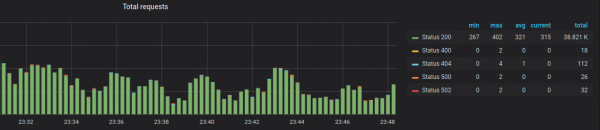
Azt hiszem, hogy a funkciók közötti eltérés ideiglenes, és a fejlesztők a jövőben ezt javítani fogják.
Metrikák
A Loki lehetőséget biztosít numerikus metrikák kinyerésére a naplókból és ezek Prometheus-ba történő küldésére. Például az nginx naplóban megtalálhatók a választ kísérő bájtok száma, valamint a napló formátumának bizonyos módosítása mellett a válaszidő másodpercekben. Ezek az adatok kinyerhetők és elküldhetők Prometheus-nak.
Továbbá hozzáadunk egy új szakaszt a promtail.yml-hez:
- match:
   selector: '{request_type="api"}'
   stages:
     - metrics:
         http_nginx_response_time:
           type: Histogram
           description: "válaszidő ms"
           source: response_time
           config:
             buckets: [0.010,0.050,0.100,0.200,0.500,1.0]
- match:
   selector: '{request_type=~"static|photo"}'
   stages:
     - metrics:
         http_nginx_response_bytes_sum:
           type: Counter
           description: "válasz bájtok összege"
           source: bytes_out
           config:
             action: add
         http_nginx_response_bytes_count:
           type: Counter
           description: "válasz bájtok száma"
           source: bytes_out
           config:
             action: inc
Ez a lehetőség lehetővé teszi a metrikák meghatározását és frissítését az extracted map-ből származó adatok alapján. Ezek a metrikák nem kerülnek elküldésre Loki-nak - a Promtail /metrics végpontján jelennek meg. A Prometheus-t úgy kell konfigurálni, hogy az ezen a szakaszon kapott adatokat megszerezze. A megadott példában, a request_type=“api” esetén, egy histogram metrikát gyűjtünk. Ezzel a metrikatípussal kényelmesen kaphatók a percentilisek. Statikus és képi adatok esetén a byte-ok összegét és a sorok számát gyűjtjük, ahol byte-okat kaptunk, hogy kiszámítsuk az átlagos értéket.
További információk a metrikákról itt olvashatók .
Nyissuk meg a portot a Promtail számára:
promtail:
     image: grafana/promtail:1.4.1
     container_name: monitoring.promtail
     expose:
       - 9080
     ports:
       - "9080:9080"
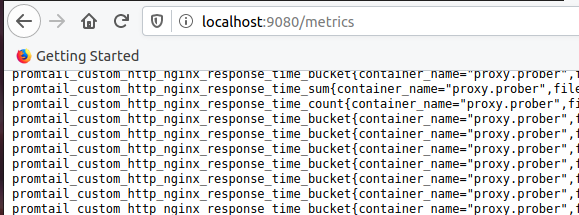
Győződjünk meg róla, hogy a promtail_custom előtaggal rendelkező metrikák megjelentek:
Konfiguráljuk a Prometheust. Adjunk hozzá egy promtail állást:
- job_name: 'promtail'
 scrape_interval: 10s
 static_configs:
   - targets: ['promtail:9080']
És készítsünk el egy grafikon:
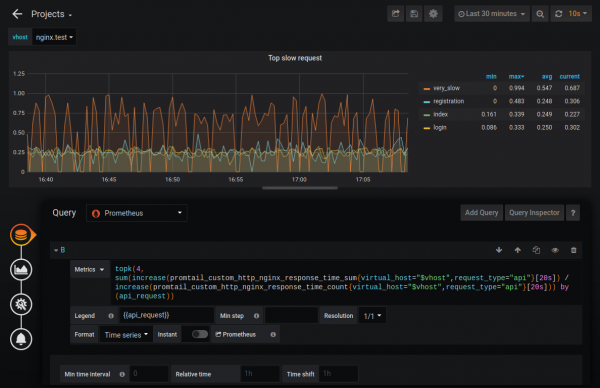
Így például megtudhatjuk a leglassabb négy lekérdezést. Ezen metrikákra figyelést is beállíthatunk.
Skálázhatóság
A Loki működhet egyetlen üzemmódban (single binary mode) vagy shardolható (horizontally-scalable mode) módban. Az utóbbi esetben az adatokat felhőben tárolhatja, miközben a chipek és indexek külön tárolódnak. Az 1.5-ös verzióban megvalósították a helyben történő tárolás lehetőségét, de ennek éles környezetben történő használata jelenleg nem ajánlott.
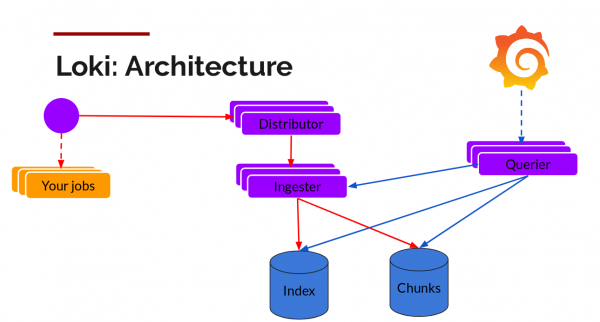
A chipek S3-kompatibilis tárolókban tárolhatók, az indexek tárolásához pedig horizontálisan skálázható adatbázisokat használhatunk: Cassandra, BigTable vagy DynamoDB. A Loki más részei - Distributors (írásra) és Querier (lekérdezésekhez) - állapotmentesek és szintén vízszintesen skálázhatók.
A DevOpsDays Vancouver 2019 konferencián egyik résztvevő, Callum Styan elmondta, hogy a Loki-nál a projektje petabájtokban méri a naplókat, az indexek pedig a teljes méret kevesebb mint 1%-át teszik ki: “”.
Loki és ELK összehasonlítása
Az index mérete
Az általam tesztelt index mérete érdekében a fenti Pipeline-nal konfigurált nginx konténer naplóit vettem. A naplófájl 406 624 sort tartalmazott, összesen 109 Mb méretben. A naplók egy órán keresztül generálódtak, körülbelül 100 bejegyzéssel másodpercenként.
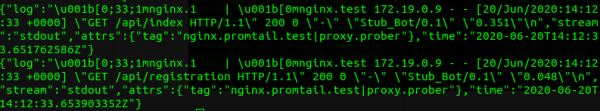
Két példa a naplóból:
Az ELK indexelés során ez 30,3 Mb indexméretet eredményezett:
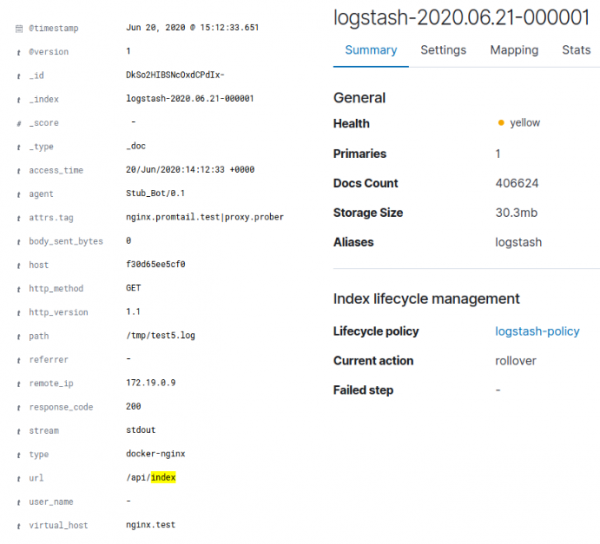
Loki esetében ez körülbelül 128 Kb indexet és körülbelül 3,8 Mb adatot eredményezett a darabokban. Meg kell jegyezni, hogy a napló mesterségesen lett generálva, és nem különbözött nagy adatváltozatosságtól. Az alap gzip tömörítés a forrás Docker JSON naplóval 95,4%-os tömörítést eredményezett, és figyelembe véve, hogy csak a tisztított nginx-naplót küldték a Loki-ba, a 4 Mb-ra való tömörítés érthető. Az egyedi Loki címkék számára összesen 35 érték volt, ami magyarázza az index kis méretét. Az ELK naplója szintén tisztításra került. Így Loki az eredeti adatokat 96%-kal, míg az ELK 70%-kal tömörítette.
Memóriaként
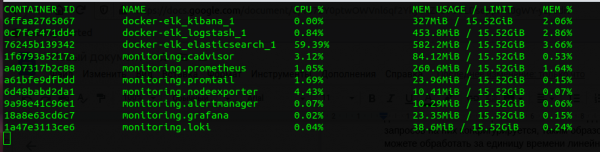
Ha az egész Prometheus és ELK stack-et összehasonlítjuk, akkor Loki "több" alkalommal kevesebbet fogyaszt. Nyilvánvaló, hogy a Go-alapú szolgáltatás kevesebb memóriát használ, mint a Java, és a JVM Heap Elasticsearch és a Loki számára fenntartott memória összehasonlítása nem helytálló, de meg kell jegyezni, hogy Loki sokkal kevesebb memóriát fogyaszt. A CPU kapacitásának előnye nem olyan nyilvánvaló, de szintén megtalálható.
Sebesség
Loki gyorsabban "megesszi" a naplókat. A sebesség számos tényezőtől függ – mivel rendelkező naplók, milyen kifinomultan elemzzük őket, a hálózat, a lemez stb. – de egyértelműen magasabb, mint az ELK (az én tesztemben körülbelül kétszeres sebességgel). Ez azzal magyarázható, hogy Loki sokkal kevesebb adatot helyez el az indexbe, ezért kevesebb időt tölt az indexelésre. A keresési sebességnél viszont fordítva van a helyzet: Loki jelentősen lelassul, ha az adatok mérete több gigabyte-ra nő, míg az ELK keresési sebessége független az adatok méretétől.
Naplókeresés
Loki lényegesen lemarad az ELK-tól a naplók keresési lehetőségeiben. A grep reguláris kifejezésekkel erős eszköz, de nem tud versenyezni egy érett adatbázissal. A range-keresések hiánya, az aggregálás csak címkék szerint, a címkék nélküli keresés lehetetlensége – mindezek korlátozzák a keresési lehetőségeinket a Loki-nál. Ez nem jelenti azt, hogy Loki segítségével ne lehetne semmit megtalálni, de meghatározza a naplókkal való munkafolyamatot, amikor először megtalálja a problémát a Prometheus grafikonokon, majd ezen címkék alapján kutatja, mi történt a naplókban.
Felület
Egyrészt ez szép (bocsánat, nem tudtam visszatartani magam). A Grafana kellemes megjelenésű felülettel rendelkezik, de a Kibana sokkal funkcionálisabb.
Loki előnyei és hátrányai
A pozitívumok közül megemelhető, hogy a Loki integrálódik a Prometheusszal, így a metrikákat és az értesítéseket dobozból kapjuk. Különösen kényelmes a naplógyűjtés és azok tárolása a Kubernetes Pods esetében, mivel örökölt szolgáltatáskereséssel rendelkezik a Prometheusból, és automatikusan címkéket rendel hozzá.
A hátrányok közé tartozik a gyenge dokumentáció. Néhány dolgot, mint például a Promtail különböző jellemzőit és lehetőségeit, csak a kód tanulmányozása során fedeztem fel, ami szerencsére nyílt forráskódú. További hátrány a gyenge elemzési lehetőségek. Például a Loki nem tudja elemezni a több soros naplókat. Emellett a hátrányok közé sorolható, hogy a Loki egy viszonylag fiatal technológia (az 1.0-ás kiadás 2019 novemberében történt).
Zárás
A Loki egy 100%-ban érdekes technológia, amely kicsi és közepes projektek számára alkalmas, lehetővé téve a naplók aggregálására, keresésére, figyelésére és elemzésére szolgáló számos feladat megoldását.
A Badoo-ban nem használunk Lokit, mivel van egy ELK-stackünk, amely nekünk megfelel és az évek során számos egyedi megoldást alakítottunk ki. Számunkra a naplókeresés a kulcskérdés. Naponta közel 100 GB naplóval fontos számunkra, hogy mindent és még annál is többet gyorsan megtalálhassunk. Grafikonok készítésére és figyelésre más megoldásokat használunk, amelyeket az igényeinknek megfelelően alakítottunk ki és integráltunk. A Loki stack számos előnnyel bír, de nem kínál többet, mint amink van, és az előnyei biztosan nem indokolják a migráció költségeit.
Bár a kutatás után világossá vált, hogy a Lokit nem használhatjuk, reméljük, hogy ez a bejegyzés segít Önnek a választásban.
A cikkben felhasznált kód tárolója itt található: .
Forrás: habr.com
