

Üdvözlet mindenkinek. Barátok, megosztjuk veletek a cikk fordítását, amelyet kifejezetten a kurzus hallgatói számára készítettünk. Tovább a lényegre!
Apache Beam és DataFlow valós idejű adatfolyamokhoz
A mai bejegyzés egy feladaton alapul, amellyel nemrégiben foglalkoztam a munkahelyemen. Nagyon örültem, hogy megvalósíthattam, és blogbejegyzés formájában leírhattam a végzett munkát, mivel ez lehetővé tette számomra, hogy foglalkozzam az adat-injeneringgel, valamint olyan dolgot készítsek, ami rendkívül hasznos lenne a csapatom számára. Nemrégiben fedeztem fel, hogy az egyik adatkezelésre szolgáló termékünk felhasználói naplója elég nagy mennyiségben tárolódik a rendszerünkben. Kiderült, hogy senki sem használta ezeket az adatokat, ezért azonnal érdekelt, mit tudnánk megtudni, ha elkezdenénk rendszeresen elemezni őket. Azonban volt több probléma is ezen az úton. Az első probléma az volt, hogy az adatok sok különféle szöveges fájlban tárolódtak, amelyek nem voltak elérhetők az azonnali elemzéshez. A második probléma pedig az volt, hogy egy zárt rendszerben tárolódtak, így nem tudtam használni egyik kedvenc adat-elemző eszközömet sem.
El kellett döntenem, hogyan tehetnénk a hozzáférést egyszerűbbé, és hogyan hozhatnánk valamilyen értéket azáltal, hogy ezt az adatforrást beépítjük néhány felhasználói interakciós megoldásunkba. Miután egy ideig gondolkodtam, úgy döntöttem, hogy egy csővezeték tervezek, amelyen keresztül ezeket az adatokat egy felhőalapú adatbázisba juttatom, hogy én és a csapat hozzáférhessünk, és elkezdhessünk valamilyen következtetést levonni. Miután nemrégiben befejeztem a Data Engineering specializációt a Courserán, izgatottan vártam, hogy felhasználhassam a kurzusból származó eszközöket a projektben.
Ezért az adatok felhőalapú adatbázisban való elhelyezése értelmes módnak tűnt az első problémám megoldására, de mit tehettem a második problémával? Szerencsére volt egy mód, hogy ezeket az adatokat egy olyan környezetbe helyezzem, ahol hozzáférhetek olyan eszközökhöz, mint a Python és a Google Cloud Platform (GCP). Azonban ez egy hosszú folyamat volt, így tennem kellett valamit, ami lehetővé tette, hogy folytassam a fejlesztést, amíg vártam az adatok átvitelének befejezésére. Az a megoldás, amit találtam, hamis adatok létrehozása volt a Faker Pythonban. Még sosem használtam ezt a könyvtárat, de gyorsan megértettem, mennyire hasznos. Ennek a megközelítésnek a használata lehetővé tette számomra, hogy elkezdjem írni a kódot és teszteljem a folyamatot valós adatok nélkül.
Mindezeket figyelembe véve ebben a bejegyzésben elmondom, hogyan építettem fel a fent említett folyamatot, néhány olyan technológia felhasználásával, amelyek elérhetők a GCP-n. Különösen használni fogom Apache Beam (Python verzió), Dataflow, Pub/Sub és BigQuery a felhasználói naplók gyűjtésére, az adatok átalakítására és az adatbázisba való továbbítására további elemzés céljából. Az én esetemben csak a Beam batch funkcionalitására volt szükségem, mivel az adataim nem valós időben érkeztek, így a Pub/Sub nem volt szükséges. Azonban megemlítem a streaming verziót, mivel ezzel a gyakorlatban is találkozhatsz.
Bevezetés a GCP-hez és az Apache Beamhez
A Google Cloud Platform valóban hasznos eszközöket biztosít a nagy adatok feldolgozásához. Íme néhány az eszközök közül, amelyeket használni fogok:
- — ez egy üzenetküldő szolgáltatás, amely a Kiadó-Ügyfél (Publisher-Subscriber) modellt használja, amely lehetővé teszi számunkra, hogy valós időben kapjuk meg az adatokat.
- — ez a szolgáltatás megkönnyíti az adatfolyamatok létrehozását, és automatikusan kezeli az olyan feladatokat, mint az infrastruktúra méretezése, ami azt jelenti, hogy csak a folyamatunk kódolására kell összpontosítanunk.
- — ez egy felhőalapú adattároló. Ha ismered a többi SQL alapú adatbázist, a BigQuery-vel nem lesz nehéz dolgozni.
- Végül az Apache Beam-et fogjuk használni, nevezetesen a Python verzióját, hogy létrehozzuk a cs pipeline-jánkat. Ez az eszköz lehetővé teszi számunkra, hogy egy pipeline-t készítsünk valós idejű vagy batch feldolgozáshoz, amely integrálódik a GCP-vel. Különösen hasznos a párhuzamos feldolgozásra és az ETL (előállítás, átalakítás, betöltés) típusú feladatokhoz, ezért ha adatokat kell mozgatnunk egyik helyről a másikra átalakítások vagy számítások végrehajtásával, a Beam jó választás.
A GCP-n széles választékban érhetők el eszközök, így nehéz lehet nyomon követni az összes eszközt és azok célját, de itt van egy összefoglaló róluk referenciaként.
A GCP-n rengeteg eszköz érhető el, ezért nehéz lehet mindet figyelembe venni, beleértve azok rendeltetését is, de mindazonáltal itt egy rövid összefoglaló referenciaként.
A pipeline vizualizációja
Vizualizáljuk a pipeline-nk komponenseit a 1. ábra. Magas szinten a felhasználói adatokat valós időben szeretnénk gyűjteni, feldolgozni és továbbítani a BigQuery-be. Naplózás történik, amikor a felhasználók interakcióba lépnek a termékkel, és kérdéseket küldenek a szerverre, amelyeket aztán naplóznak. Ezek az adatok különösen hasznosak lehetnek annak megértésében, hogyan lépnek kapcsolatba a felhasználók a termékünkkel, és hogy megfelelően működik-e. Összességében a pipeline a következő lépéseket fogja tartalmazni:
A Beam nagyon egyszerűvé teszi ezt a folyamatot, függetlenül attól, hogy van-e streamelt adatforrásunk, vagy egy CSV fájl, és batch feldolgozást szeretnénk végezni. Később látni fogja, hogy a kódban csak minimális változtatások szükségesek a kettő közötti váltáshoz. Ez az egyik előnye a Beam használatának.
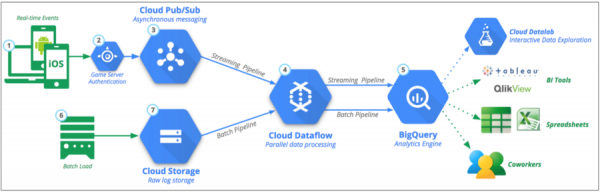
1. ábra: Alapvető adat pipeline: Forrás:
Álhét adatok létrehozása a Faker segítségével
Ahogy már korábban említettem, a korlátozott adat-hozzáférés miatt úgy döntöttem, hogy álhét adatokat hozok létre ugyanabban a formátumban, mint a valós adatok. Ez valóban hasznos gyakorlat volt, mivel írni tudtam a kódot, és tesztelni tudtam a pipelinet, amíg vártam az adatokat. Javaslom, hogy nézzük meg a Faker, ha szeretné tudni, mit kínál még ez a könyvtár. A felhasználói adataink nagyban hasonlítanak az alábbi példához. Ezen formátum alapján soronként generálhatunk adatokat a valós idejű adatok szimulálásához. Ezek a naplók olyan információkat adnak, mint a dátum, a kérés típusa, a válasz a szervertől, az IP-cím stb.
192.52.197.161 - - [30/Apr/2019:21:11:42] "PUT /tag/category/tag HTTP/1.1" [401] 155 "https://harris-lopez.com/categories/about/" "Mozilla/5.0 (Macintosh; PPC Mac OS X 10_11_2) AppleWebKit/5312 (KHTML, like Gecko) Chrome/34.0.855.0 Safari/5312"
A fenti sor alapján létre szeretnénk hozni a változónkat LINE, a következő 7 változót használva, amelyek zárójelben szerepelnek. Ezeket változónevekként fogjuk használni a táblázatunkban később.
LINE = """
 {remote_addr} - - [{time_local}] "{request_type} {request_path} HTTP/1.1" [{status}] {body_bytes_sent} "{http_referer}" "{http_user_agent}"
 """
Ha kötegelt feldolgozást végeznénk, a kód nagyon hasonló lenne, bár mintákat kellene létrehoznunk egy időintervallumban. A Faker használatához egyszerűen létrehozunk egy objektumot, és meghívjuk a szükséges módszereket. Különösen a Faker hasznos volt IP-címek, valamint weboldalak létrehozásához. Az alábbi módszereket használtam:
fake.ipv4()
 fake.uri_path()
 fake.uri()
 fake.user_agent()
from faker import Faker
import time
import random
import os
import numpy as np
from datetime import datetime, timedelta


LINE = """
{remote_addr} - - [{time_local}] "{request_type} {request_path} HTTP/1.1" [{status}] {body_bytes_sent} "{http_referer}" "{http_user_agent}"
"""


def generate_log_line():
    fake = Faker()
    now = datetime.now()
    remote_addr = fake.ipv4()
    time_local = now.strftime('%d/%b/%Y:%H:%M:%S')
    request_type = random.choice(["GET", "POST", "PUT"])
    request_path = "\/" + fake.uri_path()

    status = np.random.choice([200, 401, 404], p = [0.9, 0.05, 0.05])
    body_bytes_sent = random.choice(range(5, 1000, 1))
    http_referer = fake.uri()
    http_user_agent = fake.user_agent()

    log_line = LINE.format(
        remote_addr=remote_addr,
        time_local=time_local,
        request_type=request_type,
        request_path=request_path,
        status=status,
        body_bytes_sent=body_bytes_sent,
        http_referer=http_referer,
        http_user_agent=http_user_agent
    )

    return log_line
Az első rész vége.
A közeljövőben megosztjuk veletek a cikk folytatását, most pedig szokás szerint várjuk a kommentjeiteket ;-).
Forrás: habr.com
