

A kube-scheduler elengedhetetlen eleme a Kubernetesnek, amely felelős a podok node-okra való ütemezéséért a megadott politikák alapján. Gyakran, a Kubernetes klaszterének használata során nem kell azon gondolkodnunk, hogy pontosan milyen politikák alapján történik a podok ütemezése, mivel az alapértelmezett kube-scheduler politikák többségét a hétköznapi feladatokhoz alkalmazni lehet. Azonban vannak helyzetek, amikor fontos, hogy finoman irányítsuk a podok elosztásának folyamatát, és erre a feladatra két lehetőség van:
- Készítsünk egy kube-schedulert egy egyedi szabálykészlettel
- Írjunk egy saját schedulert, és tanítsuk meg dolgozni az API-szerverrel
A cikk keretein belül a fenti lehetőség megvalósítását írom le, hogy megoldást kínáljak a podok egyenlőtlen ütemezési problémájára az egyik projektünkben.
Rövid bevezetés a kube-scheduler működésébe
Érdemes hangsúlyozni, hogy a kube-scheduler nem felelős a podok közvetlen ütemezéséért — ő csupán annak a node-nak a meghatározásáért felel, ahová a podot elhelyezni kell. Más szavakkal, a kube-scheduler munkájának eredménye egy node neve, amelyet visszaad az API-szervernek az ütemezési kérésre, és ezzel be is fejeződik a munkája.
Először a kube-scheduler összeállít egy listát azokról a node-okról, ahová a pod ütemezhető a predikátum politikák szerint. Ezután a lista minden node-ja megkap egy bizonyos pontszámot a prioritások politikáinak megfelelően. Ennek eredményeképpen az a node kerül kiválasztásra, amely a legtöbb pontot szerezte. Ha több node azonos maximális pontszámot ér el, véletlenszerűen választanak közülük. A predikátum politikák (szűrés) és prioritások (pontozás) listájával és leírásával megismerkedhetünk a .
A probléma leírása
Bár a Nixys ügyfelei között számos különböző Kubernetes klaszter található, a podok ütemezésével kapcsolatos problémával először mostanában szembesültünk, amikor egy projektünkben szükségessé vált nagy mennyiségű időszakos feladat (~100 CronJob entitás) futtatása. A probléma leírásának leegyszerűsítése érdekében vegyünk egy példát egy mikroszolgáltatásról, amelynek keretein belül percenként fut egy cron-feladat, ami bizonyos terhelést generál a CPU-n. A cron-feladat futtatásához három teljesen azonos jellemzőkkel rendelkező node-ot (mindenik 24 vCPU-val) jelöltünk ki.
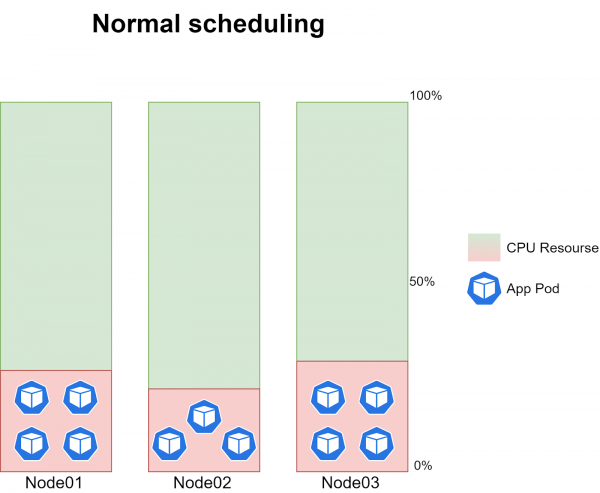
Ezekkel együtt nem lehet pontosan megmondani, mennyi időt vesz igénybe a CronJob végrehajtása, mivel a bemeneti adatok mennyisége folyamatosan változik. Átlagosan, normál kube-scheduler működés mellett, minden csomóponton 3-4 feladatpéldány fut, amelyek körülbelül 20-30%-os CPU terhelést generálnak minden csomóponton.
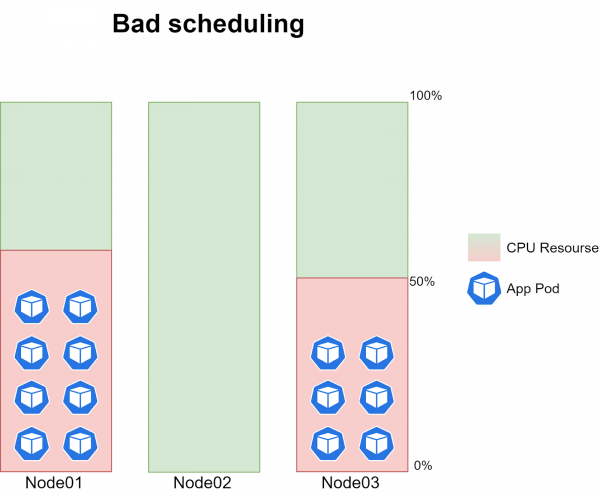
A probléma abban rejlik, hogy néha a cron-feladatok podjai nem kerültek ütemezésre az egyik három csomóponton. Vagyis egy adott időpontban az egyik csomóponton nem ütemeztek egyetlen podot sem, míg a másik két csomóponton 6-8 feladatpéldány futott, 40-60%-os CPU terhelést generálva.
A probléma teljesen véletlenszerű periódusokban ismétlődött, és ritkán volt összefüggésben a kód új verziójának kiadásának időpontjával.
A kube-scheduler naplózási szintjének 10-es szintre emelésével (-v=10) elkezdtük rögzíteni, hogy minden csomópont mennyi pontot kap a folyamat értékelése során. Normál ütemezési működés mellett a naplókban a következő információkat láthattuk:
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node03: BalancedResourceAllocation, kapacitás 23900 millicores 67167186944 memória byte, összes kérés 1387 millicores 4161694720 memória byte, eredmény 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node02: BalancedResourceAllocation, kapacitás 23900 millicores 67167186944 memória byte, összes kérés 1347 millicores 4444810240 memória byte, eredmény 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node03: LeastResourceAllocation, kapacitás 23900 millicores 67167186944 memória byte, összes kérés 1387 millicores 4161694720 memória byte, eredmény 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node01: BalancedResourceAllocation, kapacitás 23900 millicores 67167186944 memória byte, összes kérés 1687 millicores 4790840320 memória byte, eredmény 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node02: LeastResourceAllocation, kapacitás 23900 millicores 67167186944 memória byte, összes kérés 1347 millicores 4444810240 memória byte, eredmény 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node01: LeastResourceAllocation, kapacitás 23900 millicores 67167186944 memória byte, összes kérés 1687 millicores 4790840320 memória byte, eredmény 9
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node01: NodeAffinityPriority, Pont: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node02: NodeAffinityPriority, Pont: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node03: NodeAffinityPriority, Pont: (0)
interpod_affinity.go:237] cronjob-1574828880-mn7m4 -> Node01: InterPodAffinityPriority, Pont: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node01: TaintTolerationPriority, Pont: (10)
interpod_affinity.go:237] cronjob-1574828880-mn7m4 -> Node02: InterPodAffinityPriority, Pont: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node02: TaintTolerationPriority, Pont: (10)
selector_spreading.go:146] cronjob-1574828880-mn7m4 -> Node01: SelectorSpreadPriority, Pont: (10)
interpod_affinity.go:237] cronjob-1574828880-mn7m4 -> Node03: InterPodAffinityPriority, Pont: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node03: TaintTolerationPriority, Pont: (10)
selector_spreading.go:146] cronjob-1574828880-mn7m4 -> Node02: SelectorSpreadPriority, Pont: (10)
selector_spreading.go:146] cronjob-1574828880-mn7m4 -> Node03: SelectorSpreadPriority, Pont: (10)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node01: SelectorSpreadPriority, Pont: (10)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node02: SelectorSpreadPriority, Pont: (10)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node03: SelectorSpreadPriority, Pont: (10)
generic_scheduler.go:781] Host Node01 -> Pont 100043
generic_scheduler.go:781] Host Node02 -> Pont 100043
generic_scheduler.go:781] Host Node03 -> Pont 100043
Tehát, a naplókból származó információk alapján minden egyes csomópont azonos számú végső pontszámot gyűjtött, és a tervezés szempontjából egy véletlenszerűen kiválasztott csomópont került választásra. A problémás tervezés pillanatában a naplók a következőképpen néztek ki:
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node02: BalancedResourceAllocation, kapacitás 23900 millicore 67167186944 memória bájt, összes kérés 1587 millicore 4581125120 memória bájt, pontszám 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node03: BalancedResourceAllocation, kapacitás 23900 millicore 67167186944 memória bájt, összes kérés 1087 millicore 3532549120 memória bájt, pontszám 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node02: LeastResourceAllocation, kapacitás 23900 millicore 67167186944 memória bájt, összes kérés 1587 millicore 4581125120 memória bájt, pontszám 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node01: BalancedResourceAllocation, kapacitás 23900 millicore 67167186944 memória bájt, összes kérés 987 millicore 3322833920 memória bájt, pontszám 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node01: LeastResourceAllocation, kapacitás 23900 millicore 67167186944 memória bájt, összes kérés 987 millicore 3322833920 memória bájt, pontszám 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node03: LeastResourceAllocation, kapacitás 23900 millicore 67167186944 memória bájt, összes kérés 1087 millicore 3532549120 memória bájt, pontszám 9
interpod_affinity.go:237] cronjob-1574211360-bzfkr -> Node03: InterPodAffinityPriority, Pontszám: (0)
interpod_affinity.go:237] cronjob-1574211360-bzfkr -> Node02: InterPodAffinityPriority, Pontszám: (0)
interpod_affinity.go:237] cronjob-1574211360-bzfkr -> Node01: InterPodAffinityPriority, Pontszám: (0)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node03: TaintTolerationPriority, Pontszám: (10)
selector_spreading.go:146] cronjob-1574211360-bzfkr -> Node03: SelectorSpreadPriority, Pontszám: (10)
selector_spreading.go:146] cronjob-1574211360-bzfkr -> Node02: SelectorSpreadPriority, Pontszám: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node02: TaintTolerationPriority, Pontszám: (10)
selector_spreading.go:146] cronjob-1574211360-bzfkr -> Node01: SelectorSpreadPriority, Pontszám: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node03: NodeAffinityPriority, Pontszám: (0)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node03: SelectorSpreadPriority, Pontszám: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node02: SelectorSpreadPriority, Pontszám: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node01: TaintTolerationPriority, Pontszám: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node02: NodeAffinityPriority, Pontszám: (0)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node01: NodeAffinityPriority, Pontszám: (0)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node01: SelectorSpreadPriority, Pontszám: (10)
generic_scheduler.go:781] Host Node03 -> Pontszám 100041
generic_scheduler.go:781] Host Node02 -> Pontszám 100041
generic_scheduler.go:781] Host Node01 -> Pontszám 100038
Amiből látható, hogy az egyik csomópont kevesebb összpontot gyűjtött össze, mint a többi, ezért a tervezés csak a két legmagasabb pontszámot elérő csomóponton zajlott. Így biztosak lehetünk benne, hogy a probléma a podok tervezésével kapcsolatos.
A probléma megoldásának következő algoritmusánál nyilvánvalóvá vált számunkra, hogy elemeznünk kell a naplókat, meg kell értenünk, hogy pontosan mely prioritás alapján nem gyűjtött össze pontokat a csomópont, és szükség esetén ki kell javítanunk a kube-scheduler alapértelmezett szabályait. Azonban itt két jelentős nehézséggel találkoztunk:
- A maximális naplózási szinten (10) csak egyes prioritások alapján tükröződik a pontszámok halmaza. A fenti naplóbejegyzésben látható, hogy minden naplóbeli prioritás esetén a csomópontok ugyanannyi pontot gyűjtenek normál és problémás tervezés mellett, azonban a problémás tervezés esetén a végső eredmény eltér. Így arra a következtetésre juthatunk, hogy egyes prioritásoknál a pontszámok számítása „a háttérben” történik, és nincs lehetőségünk megérteni, hogy pontosan mely prioritás alapján nem gyűjtött pontokat a csomópont. Ezt a problémát részletesen leírtuk a Kubernetes Github-repojában. A cikk írásának időpontjában választ kaptunk a fejlesztőktől, hogy a naplózás támogatását a Kubernetes v1.15, 1.16 és 1.17 frissítéseiben fogják hozzáadni.
- Nincs egyszerű mód annak megértésére, hogy a kube-scheduler éppen milyen konkrét politikával működik. Igen, ez a lista felsorolásra kerül, de nem tartalmaz információt arról, hogy a prioritáspolitikai súlyok pontosan milyen mértékben vannak beállítva. A súlyokat látni vagy a kube-scheduler alapértelmezett politikáit módosítani csak a valószínűség-alapú érvényesítési központban lehet. .
Érdemes megjegyezni, hogy egyszer sikerült rögzítenünk, hogy a csomópont nem gyűjtött pontokat az ImageLocalityPriority politikánál, amely pontokat ad a csomópontnak, ha már rendelkezik a szükséges képpel az alkalmazás indításához. Azaz, amikor az új alkalmazásverziót kiadták, a cron-feladat sikeresen elindult két csomóponton, új képet letöltve a docker registry-ből, és így a két csomópont magasabb végső pontszámot kapott a harmadikhoz képest.
Ahogyan korábban említettem, a naplókban nem látjuk az ImageLocalityPriority politika értékeléséről szóló információt, ezért feltételezésem ellenőrzésére egy új verziójú alkalmazás képet töltöttünk le a harmadik node-ra, miután a ütemezés helyesen működött. Az ImageLocalityPriority politikának köszönhetően a tervezési probléma viszonylag ritkán fordult elő, gyakrabban valami más okozta. Mivel nem tudtuk teljes mértékben debuggolni a default kube-scheduler listájában szereplő politikák mindegyikét, szükségünk volt a podok ütemezési politikáinak rugalmas kezelésére.
Lépjünk át a kitűzött feladatra: írjunk egy XDP mechanizmust SYN cookie-kkal.
A célunk az volt, hogy a probléma megoldása pontosan célozhasson, azaz a Kubernetes főbb entitásai (itt a default kube-scheduler-re gondolunk) megváltozatlanok maradjanak. Nem akartuk egy helyen megoldani a problémát, majd máshol újra előidézni. Így két lehetőséget találtunk a probléma megoldására, amelyeket a cikk bevezetésében említettek — egy további ütemező létrehozása vagy saját maga írása. A cron-feladatok ütemezésének fő követelménye a terhelés egyenletes elosztása a három node között. Ezt a követelményt az már meglévő kube-scheduler politikák is teljesíteni tudják, ezért a feladatunk megoldásához nincs értelme saját ütemezőt írni.
A további kube-scheduler létrehozásának és Deployment-jének útmutatása az cikken található. Ugyanakkor úgy gondoltuk, hogy a Deployment entitások nem elegendőek ahhoz, hogy biztosítsák a leállásbiztos működést egy olyan kritikus szolgáltatás esetében, mint a kube-scheduler, ezért úgy határoztunk, hogy egy új kube-schedulert Static Pod-ként indítunk el, amelyet közvetlenül a Kubelet fog figyelni. Így a következő követelményeket állítottuk fel az új kube-schedulerra vonatkozóan:
- A szolgáltatásnak Static Pod-ként kell megvalósulnia a klaszter minden master node-ján
- El kell biztosítani a leállásbiztos működést az aktív kube-schedulert tartalmazó pod elérhetetlensége esetén
- Az ütemezés fő prioritásának a node-on rendelkezésre álló erőforrások mennyiségének (LeastRequestedPriority) kell lennie
A megoldás megvalósítása
Érdemes azonnal megjegyezni, hogy minden munkát a Kubernetes v1.14.7-en fogunk végezni, mivel ez a verzió került felhasználásra a projektben. Kezdjük a manifest írásával az új kube-scheduler-unkhoz. Az alapot a default manifest (\/etc\/kubernetes\/manifests\/kube-scheduler.yaml) képezi, amelyet a következő formára alakítunk:
kind: Pod
metadata:
  labels:
    component: scheduler
    tier: control-plane
  name: kube-scheduler-cron
  namespace: kube-system
spec:
      containers:
      - command:
        - /usr/local/bin/kube-scheduler
        - --address=0.0.0.0
        - --port=10151
        - --secure-port=10159
        - --config=/etc/kubernetes/scheduler-custom.conf
        - --authentication-kubeconfig=/etc/kubernetes/scheduler.conf
        - --authorization-kubeconfig=/etc/kubernetes/scheduler.conf
        - --v=2
        image: gcr.io/google-containers/kube-scheduler:v1.14.7
        imagePullPolicy: IfNotPresent
        livenessProbe:
          failureThreshold: 8
          httpGet:
            host: 127.0.0.1
            path: /healthz
            port: 10151
            scheme: HTTP
          initialDelaySeconds: 15
          timeoutSeconds: 15
        name: kube-scheduler-cron-container
        resources:
          requests:
            cpu: '0.1'
        volumeMounts:
        - mountPath: /etc/kubernetes/scheduler.conf
          name: kube-config
          readOnly: true
        - mountPath: /etc/localtime
          name: localtime
          readOnly: true
        - mountPath: /etc/kubernetes/scheduler-custom.conf
          name: scheduler-config
          readOnly: true
        - mountPath: /etc/kubernetes/scheduler-custom-policy-config.json
          name: policy-config
          readOnly: true
      hostNetwork: true
      priorityClassName: system-cluster-critical
      volumes:
      - hostPath:
          path: /etc/kubernetes/scheduler.conf
          type: FileOrCreate
        name: kube-config
      - hostPath:
          path: /etc/localtime
        name: localtime
      - hostPath:
          path: /etc/kubernetes/scheduler-custom.conf
          type: FileOrCreate
        name: scheduler-config
      - hostPath:
          path: /etc/kubernetes/scheduler-custom-policy-config.json
          type: FileOrCreate
        name: policy-config
Röviden a főbb változásokról:
- Megváltoztattuk a pod és a konténer nevét kube-scheduler-cron-ra.
- Megadtuk a 10151 és 10159 portok használatát, mivel definiáltuk az opciót.
hostNetwork: trueés nem használhatjuk ugyanazokat a portokat, mint az alapértelmezett kube-scheduler (10251 és 10259). - A —config paraméter segítségével megadtuk a konfigurációs fájlt, amelyről a szolgáltatásnak el kell indulnia.
- Beállítottuk a konfigurációs fájl (scheduler-custom.conf) és a tervezési politikák fájl (scheduler-custom-policy-config.json) hostról való csatolását.
Ne felejtsük el, hogy a kube-scheduler-nek olyan jogosultságokra lesz szüksége, mint a default. Módosítjuk a klaszter szerepkörét:
kubectl edit clusterrole system:kube-scheduler...
resourceNames:
- kube-scheduler
- kube-scheduler-cron
...Most beszéljünk arról, hogy mit kellene tartalmaznia a konfigurációs fájlnak és a tervezési politikák fájljának:
- Konfigurációs fájl (scheduler-custom.conf)
Az alapértelmezett kube-scheduler konfigurációjának megszerzéséhez a következő paramétert kell használnunk:--write-config-toa . A kapott konfigurációt a /etc/kubernetes/scheduler-custom.conf fájlba helyezzük és a következő formátumban állítjuk be:
apiVersion: kubescheduler.config.k8s.io/v1alpha1
kind: KubeSchedulerConfiguration
schedulerName: kube-scheduler-cron
bindTimeoutSeconds: 600
clientConnection:
  acceptContentTypes: ""
  burst: 100
  contentType: application/vnd.kubernetes.protobuf
  kubeconfig: /etc/kubernetes/scheduler.conf
  qps: 50
disablePreemption: false
enableContentionProfiling: false
enableProfiling: false
failureDomains: kubernetes.io/hostname,failure-domain.beta.kubernetes.io/zone,failure-domain.beta.kubernetes.io/region
hardPodAffinitySymmetricWeight: 1
healthzBindAddress: 0.0.0.0:10151
leaderElection:
  leaderElect: true
  leaseDuration: 15s
  lockObjectName: kube-scheduler-cron
  lockObjectNamespace: kube-system
  renewDeadline: 10s
  resourceLock: endpoints
  retryPeriod: 2s
metricsBindAddress: 0.0.0.0:10151
percentageOfNodesToScore: 0
algorithmSource:
   policy:
     file:
       path: "/etc/kubernetes/scheduler-custom-policy-config.json"
Röviden a főbb változásokról:
- Megadtuk a schedulerName paraméterben szolgáltatásunk nevét, kube-scheduler-cron.
- A paraméterben
lockObjectNameszintén meg kell határozni szolgáltatásunk nevét, és biztosítani kell, hogy a paraméterleaderElectértéke true-ra legyen állítva (ha egy master node-ja van, akkor az értéke lehet false). - Megadtuk a fájl elérési útját a tervezési politikák leírásához a
algorithmSource.
paraméterben. Érdemes részletesebben foglalkozni a második ponttal, ahol a leaderElectionkulcs paramétereit szerkesztjük. A hibatűrés biztosítása érdekében aktiváltuk (leaderElect) a vezető (master) választásának folyamatát a kube-scheduler podjai között, egy közös endpoint (resourceLock) használatával, amelynek neve kube-scheduler-cron (lockObjectName) a kube-system névtérben (lockObjectNamespace). Az, hogy a Kubernetes hogyan biztosítja az alapvető komponensek (ideértve a kube-schedulert is) magas rendelkezésre állását, a .
- A tervezési politikák fájl (scheduler-custom-policy-config.json)
Ahogy korábban írtam — megtudni, hogy a default kube-scheduler pontosan milyen politikákkal működik, csak a kódjának elemzésével tudjuk. Tehát nem tudunk a default kube-scheduler politikáiról szóló fájlt szerezni a konfigurációs fájl analógiájára. A minket érdeklő tervezési politikákat a /etc/kubernetes/scheduler-custom-policy-config.json fájlban a következőképpen írjuk le:
{
  "kind": "Policy",
  "apiVersion": "v1",
  "predicates": [
    {
      "name": "GeneralPredicates"
    }
  ],
  "priorities": [
    {
      "name": "ServiceSpreadingPriority",
      "weight": 1
    },
    {
      "name": "EqualPriority",
      "weight": 1
    },
    {
      "name": "LeastRequestedPriority",
      "weight": 1
    },
    {
      "name": "NodePreferAvoidPodsPriority",
      "weight": 10000
    },
    {
      "name": "NodeAffinityPriority",
      "weight": 1
    }
  ],
  "hardPodAffinitySymmetricWeight" : 10,
  "alwaysCheckAllPredicates" : false
}
Így tehát a kube-scheduler először létrehozza azoknak a csomópontoknak a listáját, ahová a pod ütemezhető a GeneralPredicates politika alapján (amely tartalmazza a PodFitsResources, PodFitsHostPorts, HostName és MatchNodeSelector politikák készletét). Ezt követően a csomópontok értékelése történik a prioritások tömbjében található politikák halmaza szerint. A feladatunkhoz úgy értékeltük, hogy ez a politikák halmaza optimális megoldást jelent. Emlékeztetlek, hogy a politikák halmaza részletes leírása elérhető itt: . A feladatának végrehajtásához egyszerűen módosíthatja a használt politikák halmazát, és hozzárendelheti a megfelelő súlyokat.
Az új kube-scheduler manifestját, amelyet a fejezet elején létrehoztunk, kube-scheduler-custom.yaml néven nevezzük el, és a következő úton helyezzük el /etc/kubernetes/manifests a három mester csomóponton. Ha minden jól van elvégezve, a Kubelet minden csomóponton elindítja a podot, és az új kube-schedulerünk naplójában láthatjuk, hogy a politikáinkkal kapcsolatos fájlunk sikeresen alkalmazásra került:
Scheduler létrehozása a konfigurációból: {{ } [{GeneralPredicates }] [{ServiceSpreadingPriority 1 } {EqualPriority 1 } {LeastRequestedPriority 1 } {NodePreferAvoidPodsPriority 10000 } {NodeAffinityPriority 1 } ] [] 10 false}
Predicate regisztrálása: GeneralPredicates
A GeneralPredicates predikátum típus már regisztrálva van, újra felhasználásra kerül.
Prioritás regisztrálása: ServiceSpreadingPriority
A ServiceSpreadingPriority prioritás típus már regisztrálva van, újra felhasználásra kerül.
Prioritás regisztrálása: EqualPriority
Az EqualPriority prioritás típus már regisztrálva van, újra felhasználásra kerül.
Prioritás regisztrálása: LeastRequestedPriority
A LeastRequestedPriority prioritás típus már regisztrálva van, újra felhasználásra kerül.
Prioritás regisztrálása: NodePreferAvoidPodsPriority
A NodePreferAvoidPodsPriority prioritás típus már regisztrálva van, újra felhasználásra kerül.
Prioritás regisztrálása: NodeAffinityPriority
A NodeAffinityPriority prioritás típus már regisztrálva van, újra felhasználásra kerül.
Scheduler létrehozása a fit predikátumokkal 'map[GeneralPredicates:{}]' és prioritás funkciók 'map[EqualPriority:{} LeastRequestedPriority:{} NodeAffinityPriority:{} NodePreferAvoidPodsPriority:{} ServiceSpreadingPriority:{}]'
Most már csak annyit kell megadni a CronJob spec-jénél, hogy minden kérés a podok ütemezésére a mi új kube-schedulerünket kezelje:
...
 jobTemplate:
    spec:
      template:
        spec:
          schedulerName: kube-scheduler-cron
...
Zárás
Végül egy kiegészítő kube-scheduler-t kaptunk egyedi ütemezési politikák készletével, amelynek munkáját közvetlenül a kubelet figyeli. Ezen kívül beállítottuk az új vezető választását a kube-scheduler podjaink között, ha a régi vezető valamilyen oknál fogva elérhetetlenné válik.
A szokásos alkalmazások és szolgáltatások továbbra is az alapértelmezett kube-scheduler segítségével vannak ütemezve, míg az összes cron-feladatot teljesen átállították az újra. A cron-feladatok által generált terhelés most egyenletesen oszlik el az összes csomóponton. Figyelembe véve, hogy a cron-feladatok nagy része ugyanazokon a csomópontokon fut, mint a projekt fő alkalmazásai, ez jelentősen csökkentette a podok áthelyezésének kockázatát erőforrás-hiány miatt. Az extra kube-scheduler bevezetése után a cron-feladatok egyenlőtlen ütemezésével kapcsolatos problémák már nem jelentkeztek.
Olvasd el többi cikkünket a blogunkban:
Forrás: habr.com
