

A teljesítmény-elemzés és konfigurálás egy erőteljes eszköz az ügyfelek teljesítményének ellenőrzésére.
A teljesítmény-elemzés alkalmazható a programok szűk keresztmetszeteinek azonosítására, tudományos megközelítést alkalmazva a konfigurálási kísérletek vizsgálatakor. Ez a cikk a teljesítmény-elemzés és konfigurálás általános megközelítését határozza meg, egy Go alapú webszerver példáján keresztül.
A Go különösen jól alkalmazható, mivel rendelkezik profilozási eszközökkel pprof a standard könyvtárban.
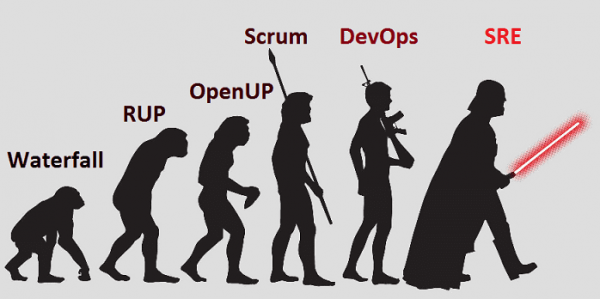
Stratégia
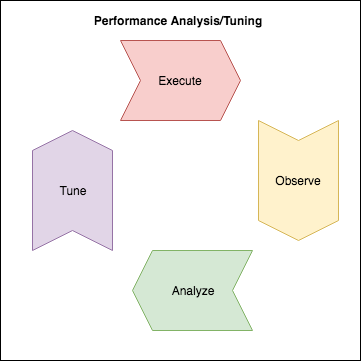
Hozzunk létre egy összefoglaló listát a strukturált elemzésünkhöz. Megpróbálunk adatokat felhasználni a döntéshozatalhoz, ahelyett, hogy intuitív vagy találgatásokon alapuló változtatásokat végeznénk. Ezt a következőképpen fogjuk csinálni:
- Határozzuk meg az optimalizálás határait (követelmények);
- Számítsuk ki a rendszer tranzakciós terhelését;
- Futtassunk tesztet (adatokat generálunk);
- Megfigyelünk;
- Elemzünk — minden követelmény teljesül?
- Tudományos módon konfigurálunk, hipotézist alkotunk;
- Kísérletet végzünk ennek a hipotézisnek az ellenőrzésére.
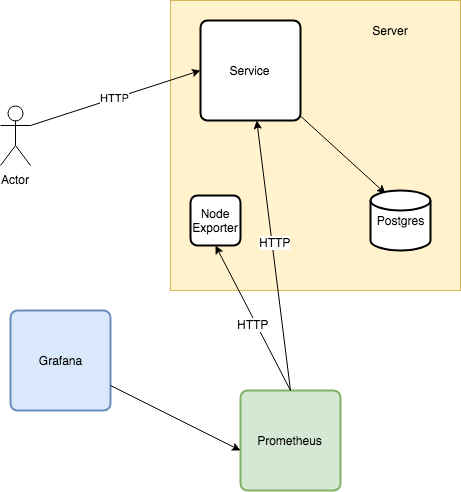
Egyszerű HTTP-szerver architektúra
Ebben a cikkben egy kis HTTP-szervert fogunk használni Golangon. Az összes kódot, amelyet ebben a cikkben bemutatunk, megtalálhatók .
Az elemzés alatt lévő alkalmazás egy HTTP-szerver, amely minden kéréskor a Postgresql adatbázist kérdezi le. Továbbá van Prometheus, node_exporter és Grafana az alkalmazás és a rendszer metrikáinak gyűjtésére és megjelenítésére.
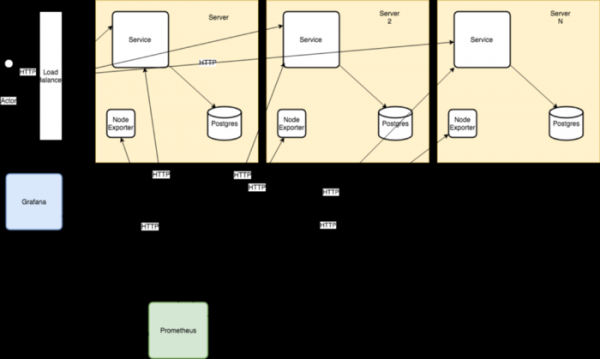
Egyszerűsítés céljából tekinthessük úgy, hogy a horizontális skálázás (és a számítások egyszerűsítése) érdekében minden szolgáltatás és adatbázis együtt kerül telepítésre:
Célok meghatározása
Ebben a lépésben meghatározzuk a célt. Mit próbálunk elemezni? Hogyan tudjuk, mikor kell befejezni? Ebben a cikkben azt fogjuk feltételezni, hogy ügyfeleink vannak, és szolgáltatásunk 10 000 kérést fog feldolgozni másodpercenként.
A részletesen bemutatja a választás és a modellezés módszereit. Hasonló módon járunk el, modelleket építünk:
- Késleltetés: a kérések 99%-ának 60 ms-nál kevesebb időn belül kell végrehajtódnia;
- Költség: a szolgáltatásnak a lehető legkevesebb pénzt kell fogyasztania, ami számunkra ésszerűnek tűnik. Ennek érdekében maximalizáljuk a sávszélességet;
- Kapacitás-tervezés: meg kell érteni és dokumentálni, hogy hány példányt kell elindítani az alkalmazásból, beleértve az általános skálázási funkciót, valamint hány példányra van szükség az induló terhelési követelmények kielégítésére és a redundancia biztosítására. .
A késlekedés optimalizálása szükséges lehet az elemzés mellett, de a sávszélességet mindenképpen ki kell elemezni. Az SRE SLO folyamat használatakor a késleltetés követelménye az ügyfelet és/vagy az üzletet képviselő terméktulajdonostól származik. Szolgáltatásunk ezt az elkötelezettséget már a kezdetektől betartja, bármiféle beállítás nélkül!
Tesztkörnyezet beállítása
A tesztkörnyezet segítségével mennyiségi terhelést tudunk kiadni a rendszerünkre. Az elemzéshez teljesítményadatok jönnek létre a webszolgáltatásról.
Tranzakciós terhelés
Ez a környezet a következőket használja a testreszabott HTTP-kérdések frekvenciájának létrehozására, amíg meg nem állítják:
$ make load-test LOAD_TEST_RATE=50
echo "POST http://localhost:8080" | vegeta attack -body tests/fixtures/age_no_match.json -rate=50 -duration=0 | tee results.bin | vegeta report
Megfigyelés
A tranzakciós terhelés alkalmazásra kerül végrehajtás közben. Az alkalmazás metrikái (kérések száma, válaszidők) és az operációs rendszer (memória, CPU, IOPS) mellett alkalmazásprofilozás fog futni, hogy megértsük, hol vannak a problémák, és hogyan használják a CPU-időt.
Profilozás
A profilozás egyfajta mérés, amely lehetővé teszi, hogy lássuk, hová megy a CPU-idő az alkalmazás futása alatt. Megtudhatjuk, hogy pontosan hol és mennyi CPU-idő megy el:
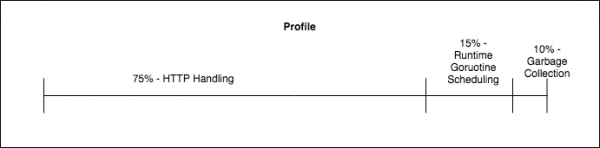
Ezeket az adatokat az elemzés során fel lehet használni, hogy betekintést nyerjünk a haszontalanul elköltött CPU-időbe és a végzett szükségtelen munkába. A Go (pprof) képes profilokat generálni és azokat lánggrafikonná vizualizálni a szabványos eszközkészlettel. Kicsit később a cikkben beszélek az ezek használatáról és a beállítási útmutatóról.
Végrehajtás, megfigyelés, elemzés.
Kísérletet végzünk. Fognak végrehajtani, figyelni és elemezni, amíg a teljesítményünk meg nem felel. Véletlenszerűen alacsony terhelést választunk, hogy azzal első megfigyeléseket végezzünk. Minden egyes lépésnél növelni fogjuk a terhelést egy skálázási tényezővel, amelyet egy bizonyos szórással választunk. Minden egyes terheléses tesztet a kérés száma beállításával hajtunk végre: make load-test LOAD_TEST_RATE=X.
50 kérés másodpercenként
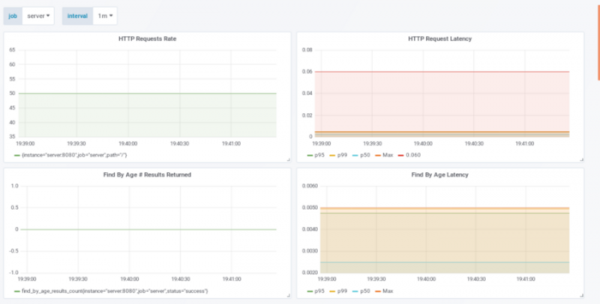
Figyeljük meg a két felső grafikon. A bal felső azt mutatja, hogy az alkalmazásunk másodpercenként 50 kérést dolgoz fel (szerinte), a jobb felső pedig a kérések időtartamát. Mindkét paraméter segít nekünk abban, hogy elemezzük: beleférünk-e a teljesítményhatárainkba vagy sem. A grafikon piros vonala HTTP Kérés Késleltetés az SLO-t 60 ms-ra mutatja. A vonalon látszik, hogy jóval a maximális válaszidőnk alatt vagyunk.
Nézzük a költségeket:
10000 kérés másodpercenként / 50 kérés szerveren = 200 szerver + 1
Még mindig lehet javítani ezen a mutatón.
500 kérés másodpercenként
Érdekesebb dolgok történnek, amikor a terhelés 500 kérés másodpercenként:
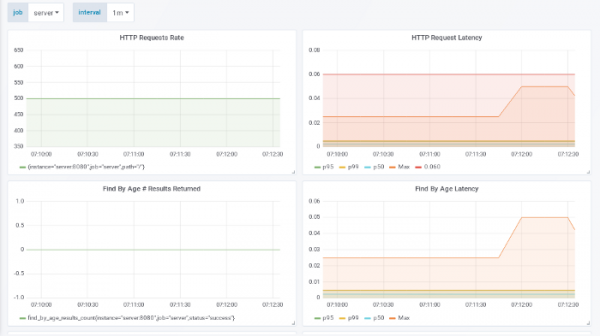
Ismét a bal felső grafikonon látható, hogy az alkalmazás normál terhelést rögzít. Ha nem így van, akkor probléma van a szerveren, ahol az alkalmazás fut. A válaszidő késleltetés grafikonja a jobb felső oldalon található, amely azt mutatja, hogy a 500 kérés másodpercenként 25-40 ms késleltetést okozott. A 99. percentilis még mindig szépen belefér az előzőleg választott 60 ms SLO-ba.
Költségek szempontjából:
10000 kérés másodpercenként / 500 kérés szerveren = 20 szerver + 1
Még mindig lehet javítani.
1000 kérés másodpercenként
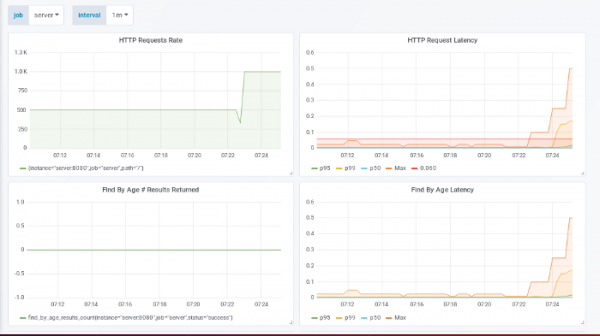
Nagyszerű indítás! Az alkalmazás 1000 kérés másodpercenkénti feldolgozást mutat, azonban a késleltetési határ megsértésre került az SLO oldaláról. Ezt a p99 vonal mutatja a jobb felső grafikonon. Bár a p100 vonal magasabb, a valós késleltetések meghaladták a 60 ms maximális értéket. Merüljünk el a profilozásba, hogy megtudjuk, valójában mi történik az alkalmazással.
Profilozás
A profilozáshoz 1000 kérés másodpercenkénti terhelést állítunk be, majd használjuk pprof az adatok rögzítésére, hogy megtudjuk, hol tölti az alkalmazás a processzoridőt. Ezt az HTTP végpont aktiválásával lehet megtenni. pprof, majd a terhelés alatt a curl segítségével mentse el az eredményeket:
$ curl http://localhost:8080/debug/pprof/profile?seconds=29 > cpu.1000_reqs_sec_no_optimizations.profAz eredmények a következőképpen jeleníthetők meg:
$ go tool pprof -http=:12345 cpu.1000_reqs_sec_no_optimizations.prof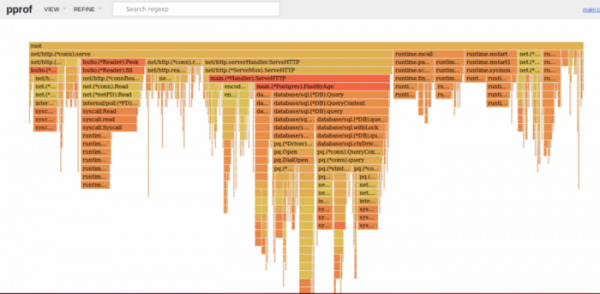
A grafikon megmutatja, hol és mennyi CPU időt töltenek a programmal. A leírás szerint :
Az X tengelyen a stack profil kitöltése, ábécé sorrendben (ez nem idő), az Y tengely a stack mélységét mutatja, nullától kezdve a [top]-ig. Minden téglalap egy stack keretet jelent. Minél szélesebb a keret, annál gyakrabban szerepel a stackekben. A felső rész a CPU-t használja, az alsó rész pedig a gyerekelemeket mutatja. A színek általában nem jelentenek semmit, egyszerűen véletlenszerűen választják ki a keretek megkülönböztetésére.
Elemzés — hipotézis
A beállítás során arra fogunk összpontosítani, hogy megpróbáljuk megtalálni a haszontalan CPU időtöltéseket. Keressük a legnagyobb haszontalan időtöltési forrásokat, és távolítsuk el őket. Nos, mivel a profilozás meglehetősen pontosan feltárja, hol költi a program a CPU idejét, lehet, hogy ezt többször is meg kell tenni, valamint szükséges lesz a program forráskódját módosítani, a teszteket újraindítani és figyelni, hogy a teljesítmény közelít a kitűzött célhoz.
Brendan Gregg ajánlásait követve a grafikonon fentről lefelé fogunk olvasni. Minden sor egy stack keretet (függvényhívást) jelenít meg. Az első sor a program belépési pontja, a szülője az összes többi hívásnak (más szavakkal, minden más hívásnak szerepelni fog a stackjében). A következő sor már eltér:

Ha az egérmutatót a grafikonon a függvény neve fölé helyezi, megjelenik a teljes idő, amennyit a stackben töltött a hibakeresés során. A HTTPServe függvény az idő 65%-ában ott volt, a többi futásidő függvény, runtime.mcall, mstart és gc, vette el a maradék időt. Érdekes tény: az összes eltöltött idő 5%-át a DNS lekérdezésekre fordították:
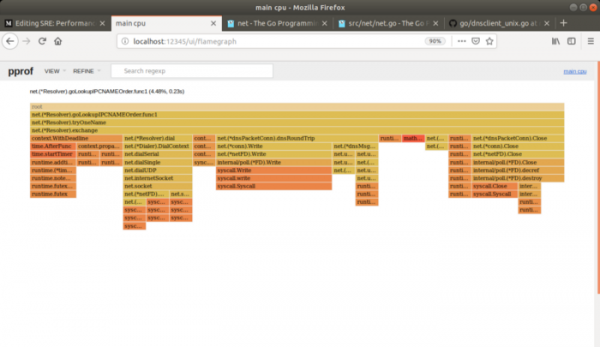
A program által keresett címek a Postgresql birtokába tartoznak. Kattintsunk a FindByAge:
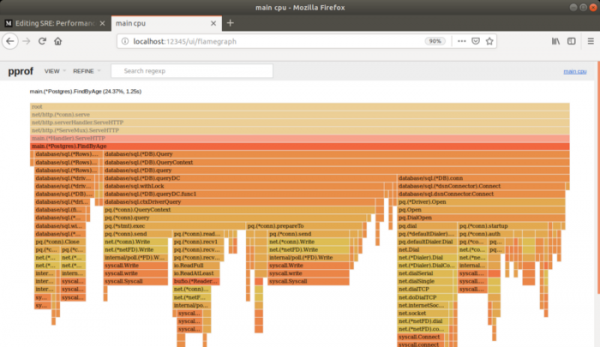
Érdekes, hogy a program azt mutatja, hogy három fő forrása van a késleltetésnek: kapcsolatok megnyitása és zárása, adatok lekérdezése és az adatbázishoz való csatlakozás. A grafikonon látható, hogy a DNS lekérdezések, a kapcsolatok megnyitása és zárása a teljes futási idő körülbelül 13%-át teszik ki.
Hipotézis: A kapcsolatok újrahasznosítása a kapcsolópultra támaszkodva csökkenti a HTTP kérések idejét, lehetővé téve a magasabb átviteli sebességet és alacsonyabb késleltetést..
Alkalmazás beállítása - kísérlet.
Frissítjük a forráskódot, próbáljuk meg eltüntetni a PostgreSQL-hez való kapcsolódást minden egyes kérésnél. Az első lehetőség - a az alkalmazás szintjén. Ebben a kísérletben mi a kapcsolópultot SQL meghajtóval Go-hoz:
db, err := sql.Open("postgres", dbConnectionString)
db.SetMaxOpenConns(8)

if err != nil {
   return nil, err
}
Végrehajtás, megfigyelés, elemzés.
A 1000 kérés/másodperc teszt újraindítása után látható, hogy a p99 késések normális szintre álltak a SLO 60ms-vel!
Mi a költség?
10000 kérés/másodperc / 1000 kérés/szerver = 10 szerver + 1
Tegyük még jobban!
2000 kérés/másodperc
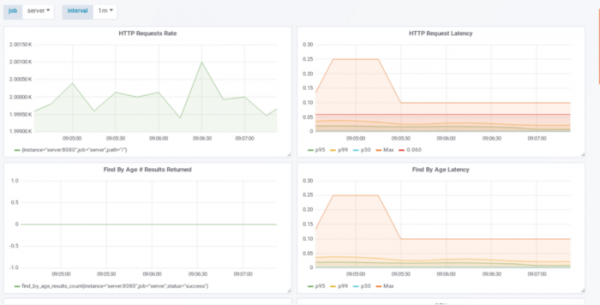
A terhelés megduplázása ugyanazt mutatja, a bal felső grafikonon látható, hogy az alkalmazás 2000 kérést dolgoz fel másodpercenként, a p100 kevesebb mint 60ms, p99 megfelel a SLO-nak.
Költségek szempontjából:
10000 kérés/másodperc / 2000 kérés/szerver = 5 szerver + 1
3000 kérés/másodperc
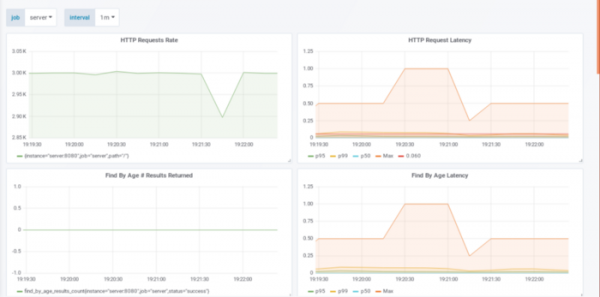
Itt az alkalmazás képes 3000 kérést kezelni, a p99 késleltetés kevesebb, mint 60ms. Az SLO nem sérül, a költséget így fogadták el:
10000 kérés/másodperc / 3000 kérés/szerver = 4 szerver + 1 (a szerző kerekítette felfelé, jegyzet: fordító)
Próbáljunk ki egy újabb elemzést.
Elemzés — hipotézis
Összegyűjtjük és megjelenítjük az alkalmazás hibakeresési eredményeit 3000 kérés/másodperc sebességen:
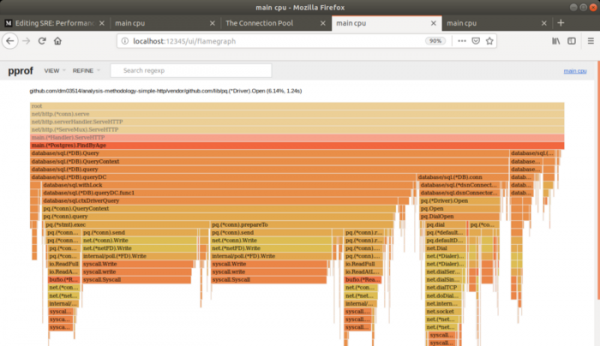
Még mindig 6% időt töltünk a kapcsolatok létrehozásával. A kapcsolópult beállítása javította a teljesítményt, de még mindig látszik, hogy az alkalmazás folytatja az új kapcsolatok létrehozását az adatbázissal.
Hipotézis: A kapcsolatok, a kapcsolatpult ellenére, még mindig elutasításra és tisztításra kerülnek, ezért az alkalmazásnak újra kell telepítenie őket. A várakozó kapcsolatok számának beállítása a pult méretéhez kell, hogy segítsen a késleltetés csökkentésében, minimalizálva az időt, amelyet az alkalmazás a kapcsolat létrehozására fordít..
Alkalmazás beállítása - kísérlet.
Próbáljuk meg beállítani a értéket a pult méretének megfelelően (szintén leírták ):
db, err := sql.Open("postgres", dbConnectionString)
db.SetMaxOpenConns(8)
db.SetMaxIdleConns(8)
if err != nil {
   return nil, err
}
Végrehajtás, megfigyelés, elemzés.
3000 kérés/másodperc
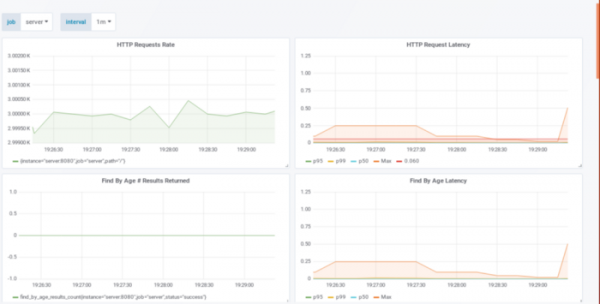
p99 kevesebb mint 60ms, jelentősen alacsonyabb p100-zal!
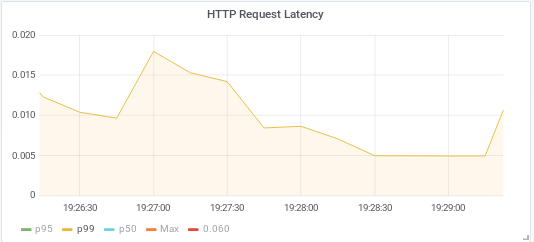
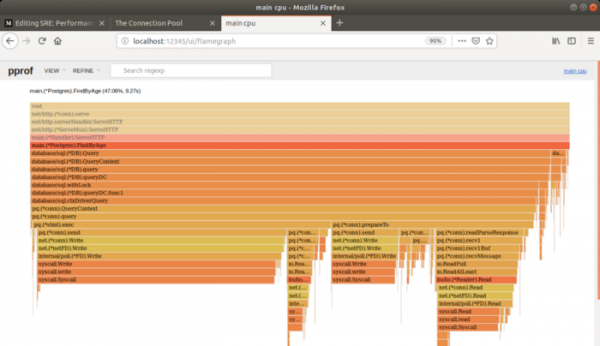
A flame graph ellenőrzése azt mutatja, hogy a kapcsolat létrehozása már nem észlelhető! Nézzük meg részletesebben. pg(*conn).query — itt sem észleljük a kapcsolat létrehozását.
Zárás
A teljesítményelemzés alapvető fontosságú az ügyfélvárakozások és a nem funkcionális követelmények teljesülésének megértéséhez. Az elemzés, amely az ügyfélvárakozásokkal való összehasonlításon alapul, segíthet meghatározni, mi számít elfogadhatónak és mi nem. A Go hatékony eszközöket biztosít, amelyeket a szabványos könyvtárban találunk, így az elemzés egyszerűvé és hozzáférhetővé válik.
Forrás: habr.com
