

Helló! Szeretnék egyszerű nyelven mesélni a steal fogalmáról a virtuális gépekben, és néhány nyilvánvalóan nem észlelhető jelenségről, amelyet kutatásunk során sikerült felfedeznünk technikai igazgatóként a felhőplatformon. . A platform KVM-en működik.
A CPU steal time az az idő, amikor a virtuális gép nem kap processzori erőforrásokat a futásához. Ezt az időt csak a vendég operációs rendszerekben számítják virtuális környezetekben. Az okok, hogy hova tűnnek ezek az erőforrások, akárcsak az életben, meglehetősen ködösek. De elhatároztuk, hogy utánajárunk, és egy sor kísérletet is végeztünk. Nem mondhatom, hogy mindent tudunk a stealról, de most elmondunk néhány érdekes dolgot.
1. Mi az a steal
Tehát a steal egy olyan mutató, amely arra utal, hogy hiányzik a processzori idő a folyamatok számára a virtuális gépben. Ahogy azt leírták , a steal az az idő, amikor a hypervisor más folyamatokat hajt végre a host operációs rendszeren, miközben a virtuális gép folyamatát végrehajtási sorba állította. Tehát a steal a folyamat készenlétben állásának ideje és a folyamat számára biztosított processzori idő közötti különbségként számít.
A virtuális gép a hypervisortól kapja meg a steal mutatót. A hypervisor azonban nem részletezi, hogy pontosan mely más folyamatokat hajt végre, csak annyit mond: "míg elfoglalt vagyok, nem tudok rád figyelni". A KVM-en a steal számításának támogatását a vezették be. Itt két kulcsfontosságú elem van:
- A virtuális gép a hypervisortól értesül a stealról. Tehát a veszteségek szempontjából a virtuális gépen belüli folyamatok esetében ez egy közvetett mérés, amely különféle torzulásokra hajlamos.
- A hypervisor nem osztja meg a virtuális géppel, hogy mivel foglalkozik – a lényeg, hogy nem szentel neki időt. Emiatt a virtuális gép nem képes észlelni a steal mutató torzulásait, amelyeket a versengő folyamatok jellege alapján lehetne értékelni.
2. Mi befolyásolja a steal-t
2.1. A steal számítása
Alapvetően a steal körülbelül úgy számítódik, mint a hagyományos processzorhasználati idő. Az információ arról, hogy hogyan számítják a kihasználtságot, nem túl sok. Talán azért, mert a legtöbben ezt a kérdést nyilvánvalónak tartják. De itt is előfordulhatnak csapdák. E folyamat megismeréséhez olvasson el : megtudhatja a kihasználtság számításának számos részletét és azokat a helyzeteket, amikor ez a számítás hibás lehet az alábbi okok miatt:
- A processzor túlmelegedése, amikor a ciklusok kiolvadnak.
- A turbo boost be- és kikapcsolása, aminek következtében megváltozik a processzor órajel frekvenciája.
- A kvantumidő hosszának megváltozása, ami a processzor energiahatékony technológiáinak, például a SpeedStep használatakor történik.
- Az átlagos számítás problémája: ha egy perc alatt 80%-os kihasználtságot értékelünk, az elrejtheti a 100%-os rövidtávú csúcsot.
- A ciklikus blokkolás (spin lock) miatt a processzor kihasználtnak tűnik, de a felhasználói folyamat nem látja az előrehaladást a végrehajtásában. Ennek következtében a folyamat által kiszámított processzorkihasználtság 100%-os lesz, míg fizikailag a processzor időt nem fog felhasználni.
Nem találtam olyan cikket, amely hasonló steal számítással foglalkozik (ha tud valamit, oszthatná meg a megjegyzésekben). De a forráskód alapján a számítás mechanizmusa ugyanaz, mint a kihasználtságnál. Csak a kernelben hozzáadnak egy új számlálót, kifejezetten a KVM folyamathoz (a virtuális gép folyamata), amely nyomon követi, mennyi ideig vár a KVM folyamat a processzoridőre. A számláló a processzor specifikációjából szerzi az információt, és megnézi, hogy minden tickjét kihasználta-e a virtuális gép. Ha igen, akkor azt számítjuk, hogy a processzor csak a virtuális gép folyamataival foglalkozott. Ellenkező esetben azt jelezzük, hogy a processzor valami mással is foglalkozott, és elképzelhető a steal megjelenése.
A steal számítás folyamata ugyanazokkal a problémákkal terhelt, mint a szokásos kihasználtság számítása. Nem mondható, hogy ezek a problémák gyakran előfordulnak, de elriasztónak tűnnek.
2.2. A KVM virtualizáció típusai
Általánosságban három típusú virtualizáció létezik, és mindhárom támogatott a KVM által. A virtualizáció típusa befolyásolhatja a steal megjelenésének mechanizmusát.
Transzláció. Ebben az esetben a virtuális gép operációs rendszere a hypervisor fizikai eszközeivel körülbelül így működik:
- A vendég operációs rendszer parancsot küld a vendég eszközének.
- A vendég eszközmeghajtó elfogadja a parancsot, létrehoz egy kérést az eszköz BIOS-ának, és elküldi azt a hypervisorhoz.
- A hipervizor folyamata parancsokat fordít át a fizikai eszköz számára, ezzel köztük biztonságosabbá is téve azt.
- A fizikai eszköz meghajtója a módosított parancsot fogadja, és azt már magának a fizikai eszköznek küldi el.
- A parancsok végrehajtásának eredménye ugyanazon az úton tér vissza.
A fordítás előnye, hogy lehetővé teszi bármilyen eszköz emulálását, és nem igényel a műveleti rendszer magjának külön felkészítését. De ezért elsődlegesen a teljesítmény rovására megy.
Hardveres virtualizáció. Ebben az esetben a hardver szintjén az eszköz érti a műveleti rendszerből érkező parancsokat. Ez a leggyorsabb és legjobb módja. De sajnos, nem minden fizikai eszköz, hipervizor és vendég operációs rendszer támogatja. Jelenleg a hardveres virtualizációt támogató fő eszközök a processzorok.
Paravirtualizáció (paravirtualization). A legelterjedtebb eszközvirtualizációs mód a KVM-en, és általában a vendég operációs rendszerek számára a legelterjedtebb virtualizálási mód is. Jellemzője, hogy bizonyos hipervizor alrendszerek (például a hálózati vagy lemezköteg) kezelésére vagy memóriaoldalak kiosztására a hipervizor API-ját használja, alacsony szintű parancsok fordítása nélkül. E módszer hátránya, hogy a vendég operációs rendszer magját módosítani kell, hogy az interakcióba léphessen a hipervizorral ezen API segítségével. De ez általában különleges meghajtók telepítésével oldható meg a vendég operációs rendszeren. A KVM-nél ezt az API-t hívják .
A paravirtualizáció során a fordításhoz képest a fizikai eszköz felé vezető út jelentősen lerövidül, mivel a paranccsok közvetlenül a virtuális gépből a hipervizor processzorához kerülnek a gazdagépen. Ez lehetővé teszi a virtuális gépen belüli összes utasítás végrehajtásának felgyorsítását. A KVM-nél ezért a virtio API felelős, amely csak bizonyos eszközökkel működik, mint például a hálózati vagy lemezes adapterek. Ezért a virtuális gépekbe virtio-meghajtókat telepítenek.
Ennek a felgyorsításnak a hátulütője, hogy nem minden folyamat, amely a virtuális gépen fut, marad bent. Ez néhány speciális hatást eredményez, amelyek a stolen való megjelenéshez vezethetnek. Javaslom, hogy a téma részletes tanulmányozását kezdje el itt: .
2.3. „Tisztességes” ütemezés
A hypervisor alatt futó virtuális gép valójában egy szokványos folyamat, amely a Linux kernel ütemezési törvényeinek (erőforrások elosztása a folyamatok között) alávetett, ezért részletesebben megvizsgáljuk.
A Linuxban az úgynevezett CFS-t, azaz Completely Fair Scheduler-t használják, amely a 2.6.23-as kerneltől kezdve az alapértelmezett ütemezővé vált. Az algoritmus megértéséhez érdemes elolvasni a Linux Kernel Architecture könyvet vagy a forráskódokat. A CFS lényegében a processzorminőségi idő elosztásáról szól, attól függően, hogy a folyamatok mennyi ideig futnak. Minél több processzoridőt igényel egy folyamat, annál kevesebb időt kap. Ez garantálja, hogy minden folyamat „tisztességesen” hajtódik végre — hogy egyetlen folyamat ne foglalja el folyamatosan az összes processzort, és a többi folyamat is futhasson.
Néha ez a paradigma érdekes artefaktumokhoz vezet. A régi Linux felhasználók bizonyára emlékeznek az asztali szövegszerkesztő megfagyására, amikor erőforrás-igényes alkalmazásokat, például fordítókat indítottunk. Ez azért történt, mert az erőforrás-kímélő feladatok versenyeztek az aktívan erőforrást fogyasztó feladatokkal, mint például a fordító. A CFS ezt tisztességtelenségnek tartja, ezért időnként megállítja a szövegszerkesztőt, és lehetőséget ad a processzornak a fordítók feladatainak feldolgozására. Ezt korrekcióra került a , azonban még mindig sok más, a processzoridő felosztásának sajátossága fennáll. Valójában nem arról van szó, hogy mennyire rossz a CFS, hanem arról, hogy a processzoridő „tisztességes” elosztása nem egy triviális feladat.
Egy másik fontos tényező a schedulerben a preemption (megszakítás). Erre szükség van ahhoz, hogy eltávolítsuk a túlhevült folyamatot a processzorról, és lehetőséget adjunk másoknak a munkára. A folyamat eltávolítását context switching-nek nevezik, azaz a processzor kontextusának váltásának. Eközben a feladat teljes kontextusa megmarad: a verem állapota, regiszterek és egyebek, majd a folyamatot várakozó állapotba helyezik, és a helyére egy másik folyamat lép. Ez egy drága művelet az operációs rendszer számára, ezért ritkán használják, de lényegében semmi rossz nincs benne. A gyakori kontextusváltás problémát jelezhet az operációs rendszerben, de általában folyamatosan zajlik, és nem mutat különösebb problémára.
Ez a hosszú történet azért szükséges, hogy egy tényt megmagyarázzak: minél több erőforrást próbál felhasználni egy folyamat a Linux tisztességes schedulerében, annál gyorsabban fognak leállítani, hogy más folyamatok is dolgozhassanak. Helyes-e ez vagy sem – bonyolult kérdés, amire a különböző terhelések esetében különböző válaszok születnek. A Windowsban nemrégiben a scheduler a desktop alkalmazások prioritásos feldolgozására összpontosított, ami miatt a háttérfolyamatok lefagytak. A Sun Solarisnak öt különböző scheduler osztálya volt. Amikor elindították a virtualizációt, hozzáadták a hatodikat, , mivel az előző öt nem kezelt megfelelően a Solaris Zones virtualizációval. E téma részletes tanulmányozását ajánlom olyan könyvekkel kezdeni, mint vagy .
2.4. Hogyan monitorozzuk a steal-t?
A steal monitorozása a virtuális gépben, akárcsak bármely más processzormetrika, egyszerű: bármilyen processzor-metricák gyűjtésére szolgáló eszközt használhatunk. A lényeg, hogy a virtuális gép Linuxon fusson. A Windows valamiért nem biztosít ilyen információt a felhasználók számára. 🙁
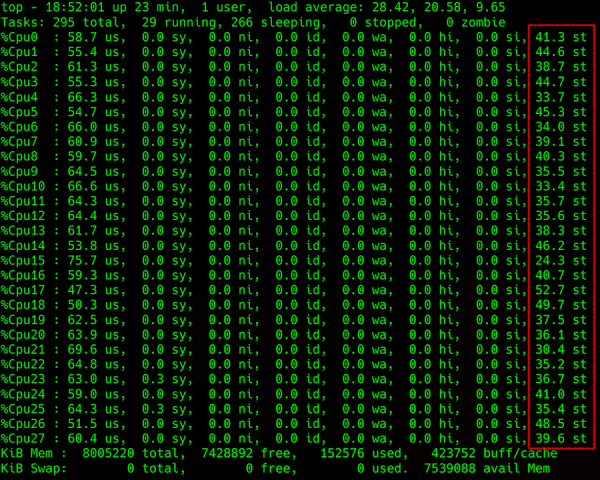
A top parancs kimenete: a processzorra nehezedő terhelés részletes elemzése, a legjobb oszlopban – steal
A nehézség akkor merül fel, amikor ezt az információt a hypervisorból szeretnénk megszerezni. Megpróbálhatjuk előre jelezni a steal-t a hostgépen, például a Load Average (LA) paraméter alapján – a várakozó folyamatok átlagos számának mondta. E paraméter kiszámításának módszere nem egyszerű, de általánosságban, ha a processzortömeghez normált LA érték 1 felett van, akkor az azt jelzi, hogy a Linux szerver valamilyen módon túlterhelt.
Mit várnak ezek a folyamatok? A nyilvánvaló válasz a processzor. De a válasz nem teljesen helyes, mert néha a processzor szabad, míg a LA a plafonon van. Emlékezzünk arra, . Hasonló lehet a helyzet a lemezzel és más bemeneti/kimeneti eszközökkel is. De valójában a folyamatok bármilyen blokkolás befejezésére várhatnak, legyen az fizikai, bemeneti/kimeneti eszközhöz kapcsolódó, vagy logikai, például mutexek. Ide tartoznak a hardver szintű blokkolások (a lemez válasza) vagy logikai blokkolások (úgynevezett blokkolási primitívek, beleértve a mutex adaptive és spin, szinkronizáló változók, rw locks, ipc locks stb.).
A LA egyik másik sajátossága, hogy az operációs rendszeren belül átlagos értékként számítják. Például 100 folyamat versenyez egy fájl felett, és akkor a LA=50. Ez a magas érték nyilvánvalónak tűnik, hogy az operációs rendszer rosszul teljesít. De egy hibásan írt kód esetében ez normális állapot lehet, miközben más folyamatok az operációs rendszerben nem szenvednek.
A fent említett átlagolás miatt (legalább egy perc alatt), a LA mutató alapján valami meghatározása nem a legkellemesebb feladat, és a konkrét esetekben meglehetősen bizonytalan eredményeket ad. Ha próbálkozik, észre fogja venni, hogy a Wikipédián és egyéb elérhető forrásokban csupán a legegyszerűbb esetek vannak leírva, mélyebb folyamatmagyarázat nélkül. Minden érdeklődőt újra ide küldök, — további linkeken. Akinek nincs kedve angolul, — .
3. Speciális hatások
Most áttérünk arra, hogy mik a steal megjelenésének fő esetei, amelyekkel találkoztunk. Elmondom, hogyan következnek az összes korábban elmondottból, és hogyan kapcsolódnak a hypervisor méréseihez.
Újrahasználás. A legegyszerűbb és leggyakoribb eset: a hypervisor újrahasználva. Valóban, sok virtuális gép fut, nagy CPU-felhasználás bennük, nagy verseny, LA nagyobb mint 1 (a processzortálcákra normalizálva). Minden belső virtuális gép lelassul. A hypervisortól átadott steal is nő, a terhelést újra kell osztani vagy valakit ki kell kapcsolni. Összességében minden logikus és világos.
Paravirtualizáció az egyedi példányokkal szemben. A hypervisor has a single virtual machine that consumes a small part of it but imposes a significant load in terms of I/O, such as disk usage. And from somewhere, a small amount of steal appears in it, up to 10% (as shown by several experiments conducted).
This is an interesting case. Steal occurs here precisely because of locks at the level of paravirtualized drivers. An interrupt is created inside the virtual machine, which is processed by the driver and sent to the hypervisor. Due to the processing of the interrupt in the hypervisor, it appears to the virtual machine as a sent request; it is ready for execution and waits for the processor, but is not allocated processor time. The virtual machine thinks this time has been stolen.
This happens at the moment the buffer is sent; it goes to the kernel space of the hypervisor, and we begin to wait for it. However, from the virtual machine's perspective, it should return immediately. Therefore, according to the steal calculation algorithm, this time is considered stolen. Most likely, in this situation, there could be other mechanisms (for example, handling some other sys calls), but they should not differ significantly.
Scheduler vs. high-load virtual machines. When one virtual machine suffers more from steal than others, it is directly related to the scheduler. The more a process loads the processor, the sooner the scheduler will evict it, so that others can work too. If a virtual machine is consuming little, it will hardly notice steal: its process waited patiently, and it needs more time. If a virtual machine generates maximum load across all its cores, it is evicted from the processor more frequently and is not given much time.
It is even worse when processes inside the virtual machine try to gain more processor time because they cannot handle data processing. Then the operating system on the hypervisor, due to proper optimization, will allocate less and less processor time. This process becomes avalanche-like, and steal skyrockets, although other virtual machines may hardly notice it. And the more cores there are, the worse it is for the machine caught in this situation. In short, high-load virtual machines with many cores suffer the most.
Low LA, but there is steal. If LA is around 0.7 (meaning the hypervisor seems underloaded), but steal is observed inside individual virtual machines:
- A fent említett paravirtualizációs módszer. A virtuális gép olyan mutatókat kaphat, amelyek a steal-re mutatnak, bár a hypervisor számára minden rendben van. Kísérleteink alapján ez a steal nem haladja meg a 10%-ot, és nem kellene jelentős hatással lennie a virtuális gépben futó alkalmazások teljesítményére.
- Hibásan számolják a LA paramétert. Pontosabban, minden egyes pillanatban helyesen számolják, de egy perc átlaga alatt alulbecsült értéket ad. Például, ha egy virtuális gép a hypervisor processzorainak egyharmadát pontosan fél percen keresztül használja, akkor a hypervisor LA-ja egy perc alatt 0,15 lesz; négy ilyen virtuális gép, amelyek egyszerre futnak, 0,6-ot adnak. Az, hogy minden virtuális gépen fél percen keresztül 25%-os steal volt a LA mutató szerint, már nem hozható vissza.
- Ismét csak a scheduler miatt, aki úgy döntött, hogy valaki túl sokat használ, és ennek a valakinek várnia kell. Közben én átváltok más kontextusra, feldolgozom a megszakításokat és foglalkozom más fontos rendszerbeli ügyekkel. Ennek eredményeként egyes virtuális gépek nem tapasztalnak problémákat, míg mások súlyos teljesítményromlást szenvednek el.
4. Egyéb torzulások
Számos más oka is lehet a virtuális gépen végzett processzoridő torzulásának. Például, a hyper-threading és a NUMA zavaró hatásai bonyolítják a folyamatok végrehajtásához szükséges magválasztást, mivel a scheduler súlyozókat használ, amelyek a kontextusváltás során még nehezebbé teszik a számítást.
Torzulások léphetnek fel turbóboost vagy éppen ellenkezőleg, energiatakarékos üzemmód technológiák miatt is, amelyek a kihasználtság számítása során mesterségesen növelhetik vagy csökkentheti a frekvenciát vagy akár a kvantumidőt a szerveren. A turbóboost bekapcsolása csökkenti az egyik processzor szál teljesítményét a másik teljesítményének növelése miatt. Ekkor a virtuális gép számára nem kerül átadásra a tényleges processzorfrekvencia információja, és azt hiszi, hogy az időt ellopják tőle (például ő 2 GHz-t kért, de fele annyit kapott).
Összességében sokféle oka lehet a torzulásoknak. Egy adott rendszerben felfedezhet valami mást is. Érdemes a fent említett könyvekkel kezdeni, és statisztikai adatokat gyűjteni a hypervisorról olyan eszközökkel, mint a perf, sysdig, systemtap, amelyekből .
5. Következtetések
- Valamely mennyiségű steal előfordulhat a paravirtualizáció miatt, és ezt normálisnak lehet tekinteni. Az interneten azt írják, hogy ez az érték 5-10% között mozoghat. Ez függ a virtuális gépben lévő alkalmazásoktól és attól, hogy mekkora terhelést adnak a fizikai berendezésekre. Itt fontos figyelni arra, hogy az alkalmazások hogyan teljesítenek a virtuális gépekben.
- A hipervizor terhelése és a steal aránya a virtuális gépben nem mindig egyértelműen kölcsönhatásban állnak, mindkét steal érték téves lehet konkrét helyzetekben, eltérő terhelések esetén.
- A scheduler nem kedveli azokat a folyamatokat, amelyek sokat kérnek. Igyekszik kevesebbet adni azoknak, akik többet kérnek. A nagy virtuális gépek ártalmasak.
- Kis steal normának számíthat anélkül is, hogy paravirtualizáció lenne (figyelembe véve a virtuális gép belső terhelését, a szomszédok terhelésének sajátosságait, a terhelés szálak közötti elosztását és egyéb tényezőket).
- Ha meg szeretné tudni a steal értékét egy adott rendszeren, különböző lehetőségeket kell kutatnia, metríkákat kell gyűjtenie, alaposan elemeznie kell azokat, és meg kell fontolnia, hogyan lehet egyenletesen elosztani a terhelést. Bármely esetnél lehetséges eltérések merülhetnek fel, amelyeket kísérleti úton kell megerősíteni vagy a kernel debuggere segítségével megvizsgálni.
Forrás: habr.com
