

Bejelentés
Kollégák, nyár közepén tervezem, hogy kiadok egy új ciklust a tömegszolgáltatási rendszerek tervezéséről: "VTrade Kísérlet" — kísérlet egy kereskedési rendszerekhez készült keretrendszer megírására. A ciklusban a tőzsde, aukció és bolt felépítésének elméletét és gyakorlatát fogjuk elemezni. A cikk végén javaslom, hogy szavazzunk a legérdekesebb témákra.
Ez a cikk zárja le a ciklust az Erlang/Elixir alapú elosztott reaktív alkalmazásokról. Az elméleti alapokat a reaktív architektúrához találhatjuk. Megmutatja az ilyen rendszerek felépítésének alapvető mintáit és mechanizmusait.
Ma a kód alapjának és a projektek fejlődésének kérdéseit fogjuk megvitatni.
Szolgáltatások szervezése
A valós életben, amikor egy szolgáltatást fejlesztünk, gyakran több interakciós mintát kell egyesítenünk egyetlen vezérlőben. Például a felhasználói profilok kezelésére szolgáló users szolgáltatásnak válaszolnia kell a req-resp kérésekre, és értesítéseket kell küldenie a profilok frissítésekor a pub-sub rendszeren keresztül. Ez az eset viszonylag egyszerű: az üzenetküldésért egy vezérlő felel, amely megvalósítja a szolgáltatás logikáját és közzéteszi a frissítéseket.
A helyzet bonyolultabbá válik, amikor egy hibatűrő elosztott szolgáltatást kell megvalósítanunk. Tegyük fel, hogy a users követelményei megváltoztak:
- most a szolgáltatásnak öt csomóponton kell kezelnie a kéréseket,
- lehetőséggel kell rendelkeznie háttérfeldolgozási feladatok végrehajtására,
- valamint képesnek kell lennie dinamikusan kezelni a profilfrissítésekre való feliratkozási listákat.
Megjegyzés: A konzisztens adatok tárolásának és replikálásának kérdésével nem foglalkozunk. Tegyük fel, hogy ezeket a kérdéseket korábban megoldották, és a rendszerben már létezik egy megbízható és skálázható tárolási réteg, amelynek kezelői rendelkeznek a szükséges együttműködési mechanizmusokkal.
A users szolgáltatás formális leírása bonyolultabbá vált. A programozó szempontjából az üzenetküldés használatával változások minimálisak. Az első követelménynek való megfeleléshez be kell állítanunk a terheléselosztást a req-resp cserepontján.
A háttérfeladatok feldolgozásának igénye gyakran felmerül. A felhasználóknál ez lehet a felhasználói dokumentumok ellenőrzése, a feltöltött multimédia feldolgozása, vagy az adatok szinkronizálása a közösségi médiával. Ezeket a feladatokat valahogy el kell osztani a klaszteren belül, és nyomon kell követni a végrehajtás menetét. Ezért két megoldási lehetőségünk van: vagy használjunk egy feladatelosztási sablont a korábbi cikkből, vagy ha ez nem megfelelő, írjunk egy testreszabott feladatütemezőt, amely a szükséges módon kezeli a feldolgozók medencéjét.
A harmadik pont a pub-sub sablon kiterjesztését igényli. A megvalósításhoz, a pub-sub cserép létrehozása után, további lépésként el kell indítanunk e pont vezérlőt a szolgáltatásunk keretein belül. Így mintegy kiemeljük a feliratkozás és leiratkozás feldolgozásának logikáját a messaging rétegből a felhasználók megvalósításába.
Végül a feladat dekompozíciója azt mutatta, hogy a követelmények kielégítéséhez 5 példányt kell futtatnunk különböző csomópontokon és létre kell hoznunk egy további entitást - a pub-sub vezérlőt, amely felelős a feliratkozásért.
Az 5 feldolgozó elindításához nem szükséges megváltoztatni a szolgáltatás kódját. Az egyetlen további lépés a kiegyensúlyozási szabályok beállítása a cserép pontján, amiről később fogunk beszélni.
További bonyodalmak is felmerültek: a pub-sub vezérlőnek és a testreszabott feladatütemezőnek egyetlen példányban kell működnie. Ismételten, a messaging, mint alapvető szolgáltatás, biztosítania kell a vezető kiválasztásának mechanizmusát.
Vezető kiválasztása
Elosztott rendszerekben a vezető kiválasztása – az egyetlen folyamat kijelölésének eljárása, amely a terhelt elosztott feldolgozásért felelős.
A centralizálásra nem hajlamos rendszerekben általában univerzális algoritmusok és konszenzus-alapú algoritmusok, például paxos vagy raft találhatóak.
Mivel a messaging egy broker és központi elem, tudomással bír minden szolgáltatási vezérlőről – a vezetőjelöltekről. A messaging vezetőt tud kijelölni szavazás nélkül.
Minden szolgáltatás a kezdés után és a cseréphez való csatlakozáskor rendszerüzenetet kap #'$leader'{exchange = ?EXCHANGE, pid = LeaderPid, servers = Servers}. Amennyiben LeaderPid megegyezik a — a démon pid fájljának elérési útja aktuális folyamattal, őt nevezik ki vezetőnek, és a lista Servers tartalmazza az összes csomópontot és paramétereiket.
Amikor egy új csomópont megjelenik vagy egy működő csomópont lekapcsolódik a klaszterben, minden szolgáltatásvezérlő értesítést kap. #'$slave_up'{exchange = ?EXCHANGE, pid = SlavePid, options = SlaveOpts} és #'$slave_down'{exchange = ?EXCHANGE, pid = SlavePid, options = SlaveOpts} vagy.
Ezért minden komponens tud minden változásról, és a klaszterben bármikor garantáltan egy vezető van.
Közvetítők
Bonyolult elosztott feldolgozási folyamatok megvalósítása, valamint a már meglévő architektúra optimalizálási feladataihoz közvetítők alkalmazása kényelmes.
Annak érdekében, hogy ne kelljen módosítani a szolgáltatások kódját, és például további feldolgozási, irányítási vagy üzenetnaplózási feladatokat végezni, egy proxy feldolgozót helyezhetünk a szolgáltatás elé, amely elvégzi az összes kiegészítő munkát.
A pub-sub optimalizálás klasszikus példája egy elosztott alkalmazás, amelynek üzleti magja frissítési eseményeket generál, például piaci árváltozást, és a hozzáférési réteg — N kiszolgáló, amelyek websocket API-t biztosítanak a webes kliensek számára.
Ha „közvetlenül” akarjuk megoldani, a kliens kiszolgálása a következőképpen történik:
- a kliens kapcsolódik a platformhoz. A kiszolgáló oldalán, ahol a forgalom terhelése történik, elindul egy folyamat, amely kezeli ezt a kapcsolatot.
- A kiszolgáló fájlok következő lépése a hitelesítés és az eseményekre való feliratkozás. A folyamat meghívja a subscribe metódust a témákra.
- Az esemény generálása után a magban azt a folyamatokhoz juttatják, amelyek a kapcsolatokat kezelik.
Tegyük fel, hogy 50000 feliratkozónk van a "news" témára. A feliratkozók egyenletesen van elosztva 5 kiszolgálón. Ennek eredményeként minden frissítés, amely a cserepontra érkezik, 50000-szer kerül reprodukálásra: 10000-szer minden kiszolgálón, a feliratkozók számának megfelelően. Ez nem éppen hatékony séma, igaz?
A helyzet javítása érdekében bevezetjük a proxyt, amelynek ugyanaz a neve, mint a cserepontról. A globális név regisztrátornak képesnek kell lennie arra, hogy a legközelebbi folyamatot visszaadja név alapján, ez fontos.
Futtassuk ezt a proxyt a hozzáférési réteg kiszolgálóin, és minden folyamatunk, amely websocket API-t kezel, rá fog iratkozni, nem a magbeli eredeti pub-sub cserepontra. A proxy csak akkor iratkozik rá a magra, ha egyedi feliratkozás található, és minden beérkező üzenetet reprodukál a saját feliratkozóin.
Végül a mag és a hozzáférési kiszolgálók között 5 üzenet fog átkelni, nem pedig 50000.
Irányítás és terheléselosztás
Req-Resp
A jelenlegi üzenetkezelési megvalósításban 7 kérésterjesztési stratégia létezik:
alapértelmezett. A kéréseket minden vezérlőnek továbbítják.körforgásos. A kérések vezérlők közötti ciklikus elosztásra kerülnek.együttható. A szolgáltatást ellátó vezérlők vezetőre és követőkre oszlanak. A kérések csak a vezetőhöz kerülnek.együttható & körforgásos. A csoportnak van vezetője, de a kérések minden tag között oszlanak meg.ragadós. Hash függvényt számítunk ki, amely meghatároz egy adott kezelőhöz. A következő kérések ezzel a jelzéssel ugyanahhoz a kezelőhöz kerülnek.ragadós-fun. A cserepont inicializálásakor további hash számítási függvény adható meg aragadósterheléselosztáshoz.. Új. Hasonló a ragadós-funhoz, de itt lehetőség van további átirányításra, elutasításra vagy előfeldolgozásra.
Az elosztási stratégia a cserepont inicializálásakor van megadva.
A terheléselosztáson túl a messaging lehetővé teszi az entitások címkézését. Tekintsük át a rendszer címketípusait:
- Csatlakozási címke. Lehetővé teszi, hogy megértsük, milyen csatlakozáson keresztül érkeztek az események. Akkor használatos, amikor a vezérlő folyamata ugyanahhoz a csereponthoz csatlakozik, de különböző útválasztási kulcsokkal.
- Szolgáltatási címke. Lehetővé teszi, hogy egy szolgáltatást kezelőket csoportosítsunk, és bővítsük az útválasztás és terheléselosztás lehetőségeit. A req-resp mintázatnál az útválasztás lineáris. A kéréseket a cserepontra küldjük, onnan továbbítja a szolgáltatásnak. De ha a kezelőket logikai csoportokba kell bontani, akkor ezt címkékkel tesszük. Ha megadjuk a címkét, a kérés egy adott vezérlőcsoporthoz kerül.
- Kérés címke. Lehetővé teszi a válaszok megkülönböztetését. Mivel a rendszerünk aszinkron, a szolgáltatás válaszainak kezeléséhez meg kell adni a RequestTag-et a kérés küldésekor. Ezzel megérthetjük, hogy melyik kérés válasza érkezett hozzánk.
Pub-sub
A pub-sub esetén minden egyszerűbb. Van egy cserepontunk, ahová üzeneteket publikálnak. A cserepont az üzeneteket az előfizetők között osztja el, akik a számukra szükséges útválasztási kulcsokra feliratkoztak (mondhatjuk, hogy ez a témák analógiája).
Skálázhatóság és hibamentesség
A rendszer skálázhatósága összességében a rendszeren belüli rétegek és komponensek skálázhatóságának mértékétől függ:
- A szolgáltatások skálázódnak azáltal, hogy további csomópontokat adunk a klaszterhez, amelyek kezelik ezt a szolgáltatást. A tapasztalt üzemeltetés során optimalizált kiegyenlítési politika választható.
- A messaging szolgáltatás maga egy külön klaszteren belül általában vagy azáltal skálázódik, hogy a különösen terhelt cserepontokat külön klasztercsomópontokra helyezzük, vagy proxy folyamatok hozzáadásával a különösen terhelt klaszterzónákhoz.
- A rendszer skálázhatósága, mint jellemző, függ az architektúra rugalmasságától és attól, hogy az egyes klaszterek összevonhatók-e egy közös logikai egységgé.
A skálázás egyszerűsége és gyorsasága gyakran befolyásolja a projekt sikerét. A messaging jelenlegi megvalósítása együtt növekszik a alkalmazással. Még ha 50-60 gépes klaszterből is hiányunk van, lehetőség van a federációra. Sajnos a federálás témája túllép ezen cikk keretein.
Kölcsönzés
A terheléselosztás elemzése során már tárgyaltuk a szolgáltatáskoncepciók redundanciáját. Azonban a messaging-et is rezerválni kell. Ha egy csomópont vagy gép leáll, a messaging-nek automatikusan helyre kell állnia, mégpedig a lehető legrövidebb időn belül.
A projektjeimben kiegészítő csomópontokat használok, amelyek átveszik a terhelést a leállások esetén. Az Erlangban van egy standard megvalósítás a disztribúciós állapothoz az OTP alkalmazások számára. A disztribúciós mód pontosan ezt a helyreállítást végzi a hiba esetén, a leállt alkalmazás egy másik előre aktivált csomóponton való újraindításával. A folyamat átlátható, a hiba után az alkalmazás automatikusan átkonfigurálódik a failover csomóra. Erről a funkcióról bővebben itt olvashat. .
Teljesítmény
Próbáljuk meg legalább körülbelül összehasonlítani a rabbitmq teljesítményét a saját testreszabott messaging-ünkkel.
Megtaláltam a rabbitmq teszteléséről az openstack csapatától.
A 6.14.1.2.1.2.2 pontban az eredeti dokumentumból az RPC CAST eredménye található:
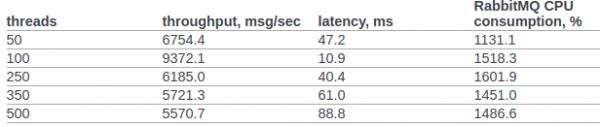
Előre nem fogunk semmilyen kiegészítő beállítást végezni az operációs rendszer kernelében vagy az erlang VM-en. A tesztelési feltételek:
- erl opts: +A1 +sbtu.
- A teszt egyetlen erlang csomóponton fut egy régi i7 mobil gépen.
- A klaszteres tesztek 10 Gbps hálózatos szervereken zajlanak.
- A kód docker konténerekben fut. A hálózat NAT módban üzemel.
A teszt kódja:
req_resp_bench(_) ->
  W = perftest:comprehensive(10000,
    fun() ->
      messaging:request(?EXCHANGE, default, ping, self()),
      receive
        #'$msg'{message = pong} -> ok
      after 5000 ->
        throw(timeout)
      end
    end
  ),
  true = lists:any(fun(E) -> E >= 30000 end, W),
  ok.
1. Szenárió: A teszt egy régi i7 mobiltelefonos gépen fut. A teszt, a messaging és a szolgáltatás ugyanazon a csomóponton, egy docker-konténerben fut:
Szekvenciális 10000 ciklus ~0 másodperc alatt (26987 ciklus/s)
Szekvenciális 20000 ciklus ~1 másodperc alatt (26915 ciklus/s)
Szekvenciális 100000 ciklus ~4 másodperc alatt (26957 ciklus/s)
Párhuzamos 2 100000 ciklus ~2 másodperc alatt (44240 ciklus/s)
Párhuzamos 4 100000 ciklus ~2 másodperc alatt (53459 ciklus/s)
Párhuzamos 10 100000 ciklus ~2 másodperc alatt (52283 ciklus/s)
Párhuzamos 100 100000 ciklus ~3 másodperc alatt (49317 ciklus/s)
2. forgatókönyv: 3 csomópont különböző gépeken, docker alatt (NAT).
Szekvenciális 10000 ciklus ~1 másodperc alatt (8684 ciklus/s)
Szekvenciális 20000 ciklus ~2 másodperc alatt (8424 ciklus/s)
Szekvenciális 100000 ciklus ~12 másodperc alatt (8655 ciklus/s)
Párhuzamos 2 100000 ciklus ~7 másodperc alatt (15160 ciklus/s)
Párhuzamos 4 100000 ciklus ~5 másodperc alatt (19133 ciklus/s)
Párhuzamos 10 100000 ciklus ~4 másodperc alatt (24399 ciklus/s)
Párhuzamos 100 100000 ciklus ~3 másodperc alatt (34517 ciklus/s)
Minden esetben a CPU kihasználtsága nem haladta meg a 250%-ot
Összegzés
Remélem, ez a ciklus nem tűnik tudat-dömpingnek, és tapasztalataim valódi hasznot nyújtanak a elosztott rendszerek kutatóinak és azoknak a gyakorlati szakembereknek, akik az elosztott architektúrák építése alatt állnak, és érdeklődéssel tekintenek az Erlang/Elixir irányába, de kételkednek benne...
Fénykép
Csak a regisztrált felhasználók vehetnek részt a szavazáson. , kérem.
Milyen témákat érdemes a legrészletesebben feldolgozni az "Experiment VTrade" ciklus keretein belül?
Elmélet: Piacok, megrendelések és azok érvényességi ideje: DAY, GTD, GTC, IOC, FOK, MOO, MOC, LOO, LOC
Megrendelési könyv. Elmélet és megvalósítás gyakorlata csoportosítással
Kereskedési vizualizáció: Tickek, sávok, felbontások. Hogyan tároljuk és hogyan fűzük össze
Háttérvezeték. Tervezés és fejlesztés. Munkavállalók ellenőrzése és incidensek kivizsgálása
API. Megvizsgáljuk, mely interfészekre van szükség és hogyan valósítsuk meg őket
Információ tárolása: PostgreSQL, Timescale, Tarantool kereskedési rendszerekben
Reaktivitás a kereskedési rendszerekben
Egyéb. Írok a megjegyzésekben
6 felhasználó szavazott. 4 felhasználó tartózkodott.
Forrás: habr.com
