

 Nagy adatmennyiségek kezelése során gyakran felmerül a lemezhely hiányának problémája. Az egyik megoldás a tömörítés, amely lehetővé teszi, hogy ugyanazon a hardveren megnöveljük a tárolási kapacitást. Ebben a cikkben megvizsgáljuk, hogyan működik az adat tömörítése az Apache Ignite-ban. Csak a termékben megvalósított lemezes tömörítési módszereket tárgyaljuk. Más, például hálózaton vagy memóriában végzett tömörítési módszerek, akár megvalósított, akár nem, kívül maradnak.
Tehát, a perzisztensek üzemmódjának bekapcsolásakor, az adatok cache-be történő megváltoztatásának eredményeként az Ignite elkezdi a lemezre írást:
- A cache-ek tartalma
- Előzetes írási napló (Write Ahead Log, a továbbiakban csak WAL)
A WAL tömörítésére már régóta létezik egy mechanizmus, amelyet WAL compaction-nak hívnak. A nemrégiben megjelent Apache Ignite 2.8-ban további két mechanizmus is megjelent, amelyek lehetővé teszik a lemezen lévő adatok tömörítését: ez a disk page compression a cache-ek tartalmának tömörítésére és a WAL page snapshot compression a WAL néhány bejegyzésének tömörítésére. Részletesebben az alábbiakban mindhárom mechanizmust bemutatjuk.
Disk page compression
Hogyan működik ez
Először is, röviden nézzük meg, hogyan tárolja az Ignite az adatokat. Az adatok lapozott memóriában kerülnek tárolásra. A lap mérete a csomópont indításakor van megadva, és nem változtatható meg későbbi szakaszokban; a lap méretének kettő hatványának kell lennie, és meg kell egyeznie a fájlrendszer blokk méretével. A lapok szükség szerint, lemezről kerülnek betöltésre a RAM-ba, és a lemezen lévő adatmennyiség meghaladhatja a lefoglalt RAM mennyiségét. Ha a RAM-ban nem áll rendelkezésre elegendő hely egy lap betöltéséhez, a régi, már nem használt lapok kerülnek ki a RAM-ból.
A lemezen az adatok a következő formátumban tárolódnak: minden cache-csoporthoz külön fájl készül, ebben a fájlban, a növekvő index sorrendjében egybeesnek a lapok. A teljes lapazonosító tartalmazza a cache-csoport azonosítóját, a partíció számát és a lap indexét a fájlban. Így a teljes lapazonosító alapján egyértelműen azonosíthatjuk a fájlt és a fájlban lévő offsetet minden lap számára. A lapozott memória felépítéséről bővebben olvashat a Apache Ignite Wiki-ban: .
A lemez oldalméretű tömörítési mechanizmusa, ahogy az a nevéből is kiderül, az oldal szintjén működik. Ennek a mechanizmusnak a bekapcsolásával a RAM-ban végzett adatkezelés úgy történik, ahogy van, bármiféle tömörítés nélkül, de amikor az oldalakat a RAM-ból a lemezre mentjük, végbemegy a tömörítés.
De minden egyes oldal külön-külön történő tömörítése még nem oldja meg a problémát, valahogy csökkenteni kell a végső adatfájlok méretét. Ha az oldal mérete nem fixált, akkor már nem tudjuk az oldalakat egyesével a fájlba írni, mert ez egy sor problémát okozhat:
- Nem tudjuk az oldal indexével kiszámítani az offsetet, ahol az a fájlban található.
- Nem világos, hogy mit tegyünk azokkal az oldalakkal, amelyek nem a fájl végén helyezkednek el, és amelyek mérete változik. Ha az oldal mérete csökken, akkor a felszabadított hely eltűnik. Ha az oldal mérete növekszik, akkor már új helyet kell keresni a fájlban.
- Ha az oldal a fájlrendszer blokk méretéhez nem többszörös számítással elmozdul, akkor annak olvasásához vagy írásához egy blokk fájlrendszert is érinteni kell, ami teljesítménycsökkenéshez vezethet.
Annak érdekében, hogy ezeket a problémákat ne kelljen önállóan megoldani, a disk page compression az Apache Ignite-ban a fájlrendszer egy mechanizmusát használja, amelyet sparse fájloknak nevezünk. A sparse (ritka) fájl olyan fájl, amelyben a nullákkal kitöltött területek „lyukként” jelölhetők. Ezzel a fájlrendszer blokkjai nem kerülnek tárolásra ezekhez a lyukakhoz, ezzel helyet takarítva meg a lemezen.
Logikus, hogy ahhoz, hogy egy fájlrendszer blokkot felszabadítsunk, a lyuk méretének nagyobbnak vagy egyenlőnek kell lennie a fájlrendszer blokk méretével, ami további korlátozást jelent az Apache Ignite oldalméretére: ahhoz, hogy a tömörítés valamilyen hatást gyakoroljon, az oldal méretének mindenképpen nagyobbnak kell lennie a fájlrendszer blokk méreténél. Ha az oldalméret megegyezik a blokk méretével, soha nem tudunk felszabadítani egyetlen blokkot sem, mivel ahhoz, hogy egyetlen blokkot felszabadítsunk, a tömörített oldalnak 0 bájtnak kell lennie. Ha az oldal mérete 2 vagy 4 blokk méretével egyezik meg, akkor már legalább egy blokkot felszabadíthatunk, ha az oldalunk legalább 50%-kal vagy 75%-kal tömörül.
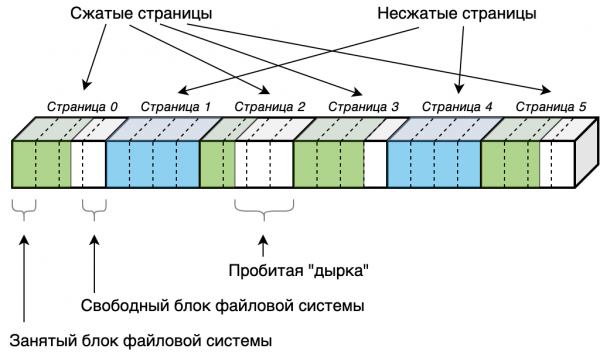
Tehát a mechanizmus működésének végső leírása a következő: Amikor egy oldalt leírunk a lemezre, megpróbáljuk tömöríteni az oldalt. Ha a tömörített oldal mérete lehetővé teszi, hogy egy vagy több fájlrendszer blokk szabaduljon fel, az oldal tömörített formában kerül rögzítésre, a felszabadított blokkok helyén pedig „lyuk” keletkezik (rendszervhívás történik a "punch hole" címkével). fallocate() Ha a tömörített oldal mérete nem teszi lehetővé a blokkok felszabadítását, az oldal változatlan formában, tömörítetlenül kerül mentésre. Minden oldal offsetjei ugyanúgy számítódnak, mint tömörítés nélkül, az oldal indexének és az oldal méretének szorzataként. Oldalak relokációjára nincs szükség. Az oldalak offsetjei, még tömörítés nélkül, a fájlrendszer blokkjainak határain érkeznek.
A jelenlegi Ignite implementáció csak Linux operációs rendszer alatt képes sparse fájlokkal dolgozni, így a disk page compression csak ezen operációs rendszer használatával kapcsolható be.
A disk page compressionhoz használható tömörítési algoritmusok: ZSTD, LZ4, Snappy. Ezen kívül létezik egy üzemmód (SKIP_GARBAGE), amelyben csak a lapban nem használt helyet dobjuk el anélkül, hogy a fennmaradó adatokon tömörítést alkalmaznánk, ami csökkenti a CPU terhelését a fent említett algoritmusokhoz képest.
Hatás a teljesítményre
Sajnos a tényleges teljesítményméréseket valós környezetben nem végeztem, mivel nem tervezzük, hogy ezt a mechanizmust a termelésben használjuk, de teoretikusan el lehet gondolkodni, hogy hol veszítünk és hol nyerünk.
Ehhez emlékeznünk kell arra, hogyan történik az oldalak olvasása és írása a hozzáférés során:
- Olvasási művelet végrehajtásakor először a RAM-ban keresik az oldalt, ha a keresés nem sikeres, az oldal a lemezről betöltődik a RAM-ba abban a folyamatban, amelyik az olvasást végzi.
- Írási művelet végrehajtásakor az oldal a RAM-ban piszkosként van megjelölve, ám az oldal fizikailag nem kerül azonnal mentésre a lemezre abban a folyamatban, amelyik az írást végzi. Minden piszkos oldal később, egy checkpoint során külön folyamatok által kerül a lemezre mentésre.
Tehát a hatás az olvasási műveletekre:
- Pozitív (disk IO), a fájlrendszer blokkjainak olvasott számának csökkentése révén.
- Negatív hatás (CPU), a sparse fájlokkal való munka során a működéshez szükséges további terhelés miatt. Lehetséges, hogy itt implicit módon további IO műveletek is megjelennek a sparse fájlok bonyolultabb struktúrájának mentéséhez (sajnálom, de nem ismerem részletesen a sparse fájlok működését).
- Negatív hatás (CPU), a lapok dekompressziójának szükségessége miatt.
- Nincs hatás a írási műveletekre.
- Hatás a checkpoint folyamatra (itt minden hasonló a beolvasási műveletekhez):
- Pozitív hatás (disk IO), a fájlrendszerre írt blokkok számának csökkentése miatt.
- Negatív hatás (CPU, esetleg disk IO), a sparse fájlokkal való munka miatt.
- Negatív hatás (CPU), a lapok tömörítésének szükségessége miatt.
Melyik serpenyő fog dominálni? Ez nagyon az környezettől függ, de hajlok arra, hogy a disk page compression a legtöbb rendszeren inkább teljesítményromláshoz vezet. Ráadásul más adatbázis-kezelők tesztjei, amelyek hasonló megközelítést használnak sparse fájlokkal, teljesítménycsökkenést mutatnak a tömörítés bekapcsolásakor.
Hogyan lehet bekapcsolni és beállítani.
Ahogy fentebb már említettük, az Apache Ignite minimális verziója, amely támogatja a disk page compression-t: 2.8 és csak Linux operációs rendszeren támogatott. A bekapcsolás és beállítás a következőképpen történik:
- A class-path-ban kell, hogy legyen az ignite-compression modul. Alapértelmezés szerint az Apache Ignite disztribúciójában a libs/optional könyvtárban található és nincs включен a class-path-ba. Egyszerűen áthelyezheti a könyvtárat egy szinttel feljebb a libs-be, és akkor az ignite.sh futtatásakor automatikusan be fog kapcsolódni.
- A Persistenciának be kell kapcsolva lennie (Bekapcsolva a
DataRegionConfiguration.setPersistenceEnabled(true)). - Az oldal méretének nagyobbnak kell lennie, mint a fájlrendszer blokkmérete (beállítható a
DataStorageConfiguration.setPageSize()). - Minden cache esetében, amelynek adatait tömöríteni kell, a konfigurációban be kell állítani a tömörítési módszert és (opcionálisan) a tömörítési szintet (módszerek
CacheConfiguration.setDiskPageCompression(), CacheConfiguration.setDiskPageCompressionLevel()).
WAL tömörítés
Hogyan működik ez
Mi az a WAL és mire jó? Nagyon röviden: ez egy napló, amelybe minden olyan esemény bekerül, ami végül megváltoztatja az oldal alapú tárolót. Elsősorban a visszaállítás lehetősége miatt szükséges, ha bekövetkezik egy hiba. Mielőtt bármely művelet átadná a vezérlést a felhasználónak, először fel kell jegyeznie az eseményt a WAL-ban, hogy a hiba esetén képes legyen visszajátszani a napló alapján, és helyreállítani a sikeres válaszokat, még akkor is, ha ezek a műveletek még nem tükröződtek az oldal alapú tárolón a lemezen (feljebb már említésre került, hogy az oldal alapú tárolóra történő tényleges írás a „csomópont” nevű folyamat során történik, mely késleltetve történik külön folyamatok által).
A WAL-ban lévő bejegyzések logikai és fizikai kategóriákra oszthatók. A logikai bejegyzések maguk a kulcsok és értékek. A fizikai bejegyzések az oldal alapú tároló változásait tükrözik. Míg a logikai bejegyzések más esetekben is hasznosak lehetnek, a fizikai bejegyzések kizárólag a hiba esetén történt helyreállításra szolgálnak, és csak az utolsó sikeres csomópont óta szükségesek. Itt nem merülünk el a részletekben, és nem magyarázzuk el, hogy miért működik így, de aki érdeklődik, az hivatkozhat az Apache Ignite Wiki már említett cikkére: .
Egy logikai bejegyzéshez gyakran több fizikai bejegyzés tartozik. Azaz például egy put művelet a gyorsítótárban több oldalra vonatkozik az oldal alapú memóriában (az adatokhoz tartozó oldal, az index oldalai, a free-list oldalak). Néhány szintetikus teszt során megállapítottam, hogy a fizikai bejegyzések a WAL fájl méretének akár 90%-át is kitehetik. Eközben nagyon rövid ideig szükségesek (alapértelmezetten a csomópontok közötti intervallum 3 perc). Logikus lenne, hogy ezektől az adatoktól, miután elveszítik aktualitásukat, megszabaduljunk. Ezt végzi a WAL tömörítési mechanizmus, amely eltávolítja a fizikai bejegyzéseket, és a zip segítségével tömöríti a megmaradt logikai bejegyzéseket, ezáltal a fájl mérete jelentősen csökken (néha akár tízszeresére).
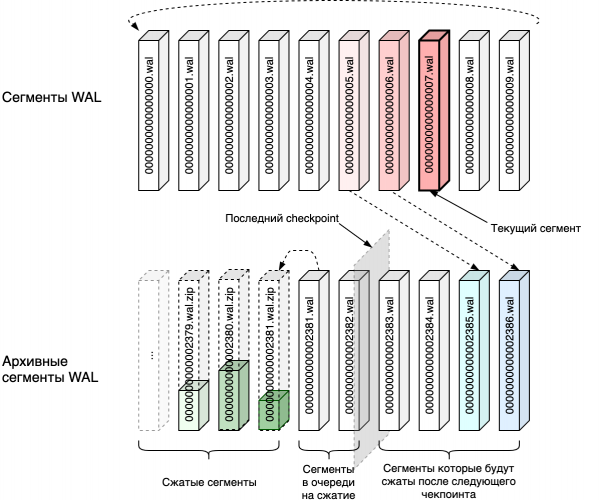
A WAL fizikailag több, állandó méretű (alapértelmezett 64MB) szegmenst tartalmaz (alapértelmezett 10), amelyek körkörösen felülíródnak. Amint a jelenlegi szegmens megtelik, a következő szegmens kerül kijelölésre, míg a megtelt szegmens egy külön szálon archíválásra kerül. A WAL tömörítése már működik az archív szegmensekkel. Egy külön szál a checkpoint végrehajtását is nyomon követi, és megkezdi a tömörítést az archív szegmensek esetében, amelyekre már nincs szükség fizikailag.
Hatás a teljesítményre
Mivel a WAL tömörítése külön szálon működik, közvetlen hatással nem szabadna, hogy legyen a végrehajtott műveletekre. Ugyanakkor további háttérterhelést ad a CPU-ra (tömörítés) és a lemezre (minden WAL szegmens archiválásból való olvasása és a tömörített szegmensek írása), így ha a rendszer a kapacitás határán működik, teljesítményromlást is okozhat.
Hogyan lehet bekapcsolni és beállítani.
A WAL tömörítést a következő tulajdonság használatával lehet engedélyezni: WalCompactionEnabled be. DataStorageConfiguration (DataStorageConfiguration.setWalCompactionEnabled(true)). Ezenkívül a DataStorageConfiguration.setWalCompactionLevel() metódussal beállítható a tömörítés mértéke, ha az alapértelmezett érték (BEST_SPEED) nem megfelelő.
WAL oldal pillanatkép tömörítés
Hogyan működik ez
Korábban már megállapítottuk, hogy a WAL bejegyzések logikai és fizikai típusokra oszlanak. Minden egyes változásnál az oldal memóriájában fizikai WAL bejegyzés keletkezik. A fizikai bejegyzések viszont két alkategóriára is oszthatók: page snapshot record és delta record. Minden alkalommal, amikor változtatunk az oldalon, és tiszta állapotából piszkos állapotába fordítjuk, a WAL-ban egy teljes másolatot tárolunk erről az oldalról (page snapshot record — az oldal pillanatképe). Még ha csak egy bájtot is változtatunk, a WAL egy, az oldal méreténél kissé nagyobb bejegyzést tárol. Ha viszont már egy piszkos oldalon változtatunk, a WAL-ban delta record keletkezik, amely csak a korábbi állapothoz viszonyított változtatásokat tartalmazza, nem az egész oldalt. Mivel a piszkos állapotú oldalak tisztára történő visszaállítása a checkpoint folyamat során történik, a checkpoint kezdetén gyakorlatilag az összes fizikai bejegyzés csak az oldal pillanatképeiből áll (mivel az összes oldal a checkpoint kezdetén tiszta), majd a következő checkpoint felé haladva a delta recordok aránya növekedni kezd, és ismét visszaáll a következő checkpoint kezdetén. Néhány szintetikus teszt mérései azt mutatták, hogy az oldal pillanatképeinek aránya a teljes fizikai bejegyzések körében elérheti a 90%-ot.
A WAL page snapshot compression lényege, hogy az oldal pillanatképeit a már meglévő oldal tömörítési eszköz használatával tömörítjük (lásd disk page compression). Ebben az esetben a WAL bejegyzések sorban, append-only módban kerülnek tárolásra, és nincs szükség a bejegyzések fájlrendszer blokkjainak határaihoz történő kötésére, ezért itt, ellentétben a disk page compression mechanizmussal, egyáltalán nem szükségesek sparse fájlok, így ez a mechanizmus nem csupán Linux operációs rendszeren fog működni. Továbbá, már nem számít, hogy mennyire tudtuk tömöríteni az oldalt. Még ha csak 1 bájtot is felszabadítottunk, az már egy pozitív eredmény, és a WAL-ban eltárolhatjuk a tömörített adatokat, ellentétben a disk page compression-nel, ahol a tömörített oldalt csak akkor mentjük el, ha több mint 1 fájlrendszer blokkot szabadítottunk fel.
Az oldalak jól tömöríthető adatok, részarányuk a WAL összes mennyiségében nagyon magas, így a WAL fájl formátumának megváltoztatása nélkül jelentős méretcsökkentést érhetünk el. A logikai bejegyzések tömörítése formátumváltoztatást és kompatibilitás elvesztését igényelné, például a külső felhasználók számára, akiket a logikai bejegyzések érdekelhetnek, ugyanakkor nem hozna jelentős csökkenést a fájl méretében.
A WAL oldal pillanatfelvétel tömörítéshez, akárcsak a lemezoldal tömörítéshez, a ZSTD, LZ4, Snappy tömörítési algoritmusok, valamint a SKIP_GARBAGE mód használható.
Hatás a teljesítményre
Mint könnyen észlelhető, a WAL oldal pillanatfelvétel tömörítés közvetlen aktiválása csak azokra a szálakra hat, amelyek adatokat írnak a lapmemóriába, azaz azokra, amelyek módosítják az adatokat a gyorsítótárakban. A WAL fizikai bejegyzésekből való olvasás csak egyszeri alkalommal történik, a csomópont leállását követően (és csak ha a leállás a checkpoint folyamatában történt).
Ez a szálakra, amelyek adatokat módosítanak, a következő módon hat: negatív hatást (CPU) okoz, mivel minden alkalommal tömöríteni kell az oldalt, mielőtt az lemezre kerül, és pozitív hatást (diszk IO) a írandó adatok mennyiségének csökkentésével. Itt tehát minden egyszerű: ha a rendszer teljesítménye a CPU által kihívott, kis mértékű degradációt tapasztalunk, ha a lemez írás/olvashatósága, akkor növekedést.
Közvetetten a WAL méretének csökkentése szintén (pozitívan) hat azokra a szálakra, amelyek a WAL szegmenseit archiválják, és a WAL tömörítési szálakra.
Valós teljesítménytesztek a környezetünkben szintetikus adatokon kis növekedést mutattak (a throughput 10%-15%-kal nőtt, a latencia 10%-15%-kal csökkent).
Hogyan lehet bekapcsolni és beállítani.
Az Apache Ignite minimális verziója: 2.8. A bekapcsolás és beállítás a következő módon történik:
- A class-path-ban kell, hogy legyen az ignite-compression modul. Alapértelmezés szerint az Apache Ignite disztribúciójában a libs/optional könyvtárban található és nincs включен a class-path-ba. Egyszerűen áthelyezheti a könyvtárat egy szinttel feljebb a libs-be, és akkor az ignite.sh futtatásakor automatikusan be fog kapcsolódni.
- A Persistenciának be kell kapcsolva lennie (Bekapcsolva a
DataRegionConfiguration.setPersistenceEnabled(true)). - A tömörítési módot a következő metódussal kell megadni
DataStorageConfiguration.setWalPageCompression(), alapértelmezés szerint a tömörítés ki van kapcsolva (DISABLED mód). - Opcionálisan megadhatjuk a tömörítés mértékét a következő metódussal
DataStorageConfiguration.setWalPageCompression(), a megengedett értékek minden egyes módszerhez a metódus javadocjában találhatók.
Zárás
Az Apache Ignite-ban tárgyalt adattömörítési mechanizmusok függetlenül is használhatók, de bármilyen kombinációjuk is megengedett. Az elvük megértése lehetővé teszi, hogy meghatározzuk, mennyire felelnek meg a feladatainknak a környezetünkben, és mivel kell kompromisszumot kötnünk a használatuk során. A lemezoldali tömörítés a fő tárolónak a tömörítésére szolgál, és átlagos tömörítési fokot biztosíthat. A WAL oldal pillanatfelvételi tömörítés átlagos tömörítési fokot ad a WAL fájloknak, miközben valószínűleg még a teljesítményt is javítja. A WAL tömörítés nem befolyásolja pozitívan a teljesítményt, de maximálisan csökkenti a WAL fájlok méretét a fizikai rekordok eltávolításával.
Forrás: habr.com
