

Bár manapság szinte mindenhol sok adat található, az analitikai adatbázisok még mindig meglehetősen egzotikusak. Rosszul ismertek és még rosszabbul használják őket hatékonyan. Sokan továbbra is "kaktuszt esznek" MySQL vagy PostgreSQL segítségével, amelyek más forgatókönyvekre lettek tervezve, szenvednek a NoSQL-tól, vagy túlfizetnek a kereskedelmi megoldásokért. A ClickHouse megváltoztatja a játékszabályokat és jelentősen csökkenti a belépési küszöböt az analitikai DBMS világába.
A BackEnd Conf 2018. évi előadása, amelyet a beszélő engedélyével publikáltak.
Ki vagyok én és miért beszélek a ClickHouse-ról? Én vagyok a LifeStreet fejlesztési igazgatója, amely használja a ClickHouse-t. Ezen kívül én az Altinity alapítója is vagyok. Ez egy Yandex partner, amely népszerűsíti a ClickHouse-t és segíti a Yandexet a ClickHouse sikeresebbé tételében. Szívesen osztom meg tudásomat a ClickHouse-ról.
És igen, nem Peti Zaycev testvére vagyok. Gyakran kérdeznek erről. Nem, nem vagyunk testvérek.
"Mindenki tudja", hogy a ClickHouse:
- Nagyon gyors,
- Nagyon felhasználóbarát,
- A Yandexnél használják.
Kicsit kevésbé ismert, hogy mely vállalatokban és hogyan használják.
Elmondom, mire, hol és hogyan használják a ClickHouse-t a Yandexen kívül.
Elmondom, hogy a ClickHouse segítségével hogyan oldják meg a konkrét feladatokat különböző cégeknél, milyen eszközöket használhat a ClickHouse a saját feladataihoz, és hogyan használták őket különböző cégeknél.
Három példát állítottam össze, amelyek különböző szempontból mutatják be a ClickHouse-t. Azt hiszem, ez érdekes lesz.
Az első kérdés: "Miért van szükség a ClickHouse-ra?" Elvileg ez egy elég nyilvánvaló kérdés, de több válasz is van rá.
- Az első válasz - a teljesítményért. A ClickHouse nagyon gyors. Az analitika a ClickHouse-on szintén nagyon gyors. Gyakran olyan helyeken is használható, ahol valami más nagyon lassan vagy nagyon rosszul működik.
- A második válasz - a költség. És első sorban a skálázás költsége. Például a Vertica - teljesen más adatbázis. Nagyon jól működik, ha nem sok terabájt adat van. De amikor szó van több száz terabájtról vagy petabájtról, a licenc- és támogatási költségek elegendően magas összegre rúgnak. És ez drága. A ClickHouse viszont ingyenes.
- A harmadik válasz a működési költség. Ez egy megközelítés, amely kicsit más szemszögből nézi a dolgokat. A RedShift remek alternatíva. A RedShift-en nagyon gyorsan készíthetünk megoldásokat. Jól fog működni, de minden órában, minden nap és minden hónapban meglehetősen drágán kell fizetnie az Amazonnak, mert ez egy jelentősen költséges szolgáltatás. A Google BigQuery is ilyen. Aki már használta, tudja, hogy néhány lekérdezést futtathat, és hirtelen több száz dolláros számlát kaphat.
A ClickHouse-nál ezek a problémák nincsenek.
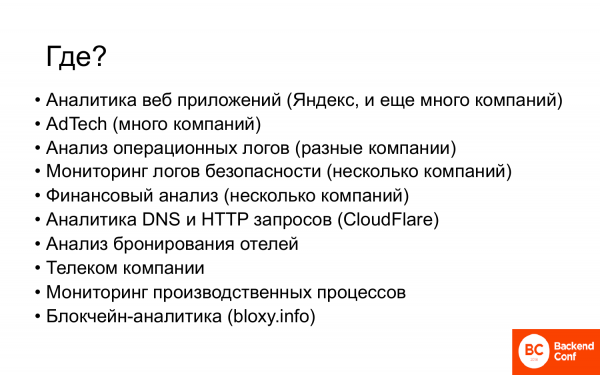
Hol használják most a ClickHouse-t? A Yandexen kívül a ClickHouse-t számos különböző vállalkozás és cég alkalmazza.
- Elsősorban webalkalmazások elemzésére, azaz ez egy használati eset, amely a Yandex-ból indult.
- Sok AdTech vállalat használja a ClickHouse-t.
- Számos olyan vállalat, amelyeknek szükségük van különböző forrásokból származó operatív naplók elemzésére.
- Néhány vállalat a ClickHouse-t használja biztonsági naplók monitorozására. Feltöltik őket a ClickHouse-ba, riportokat készítenek, és elérik a szükséges eredményeket.
- A vállalatok kezdenek pénzügyi elemzésnél is alkalmazni, azaz fokozatosan a nagyobb üzletágak is közelítenek a ClickHouse-hoz.
- CloudFlare. Aki figyelemmel kíséri a ClickHouse-t, biztosan hallott erről a cégről. Ez az egyik jelentős közösségi hozzájáruló. Nagyon komoly ClickHouse telepítésük van. Például készítettek egy Kafka Engine-t a ClickHouse-hoz.
- Távközlési cégek is elkezdték használni. Néhány vállalat a ClickHouse-t proof of conceptként vagy már produkcióban használja.
- Egy cég a ClickHouse-t a gyártási folyamatok monitorozására használja. Mikroschémákat tesztelnek, rengeteg paramétert rögzítenek, körülbelül 2000 jellemzőt. Aztán elemeznek – jó vagy rossz tétel.
- Blockchain-elemzés. Van egy orosz cég, a Bloxy.info. Ez az ethereum hálózat elemzése. Ezt is a ClickHouse-on valósították meg.
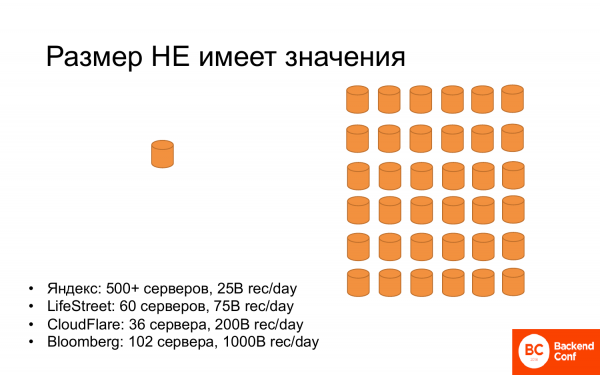
A méret nem számít. Sok cég használ egy kis szervert. Ez lehetővé teszi számukra a problémáik megoldását. És még több cég használ nagy klasztereket számos szerverek vagy tucatnyi szerverből.
És ha megnézzük a rekordokat, akkor:
- Yandex: 500+ szerver, napi 25 milliárd rekordot tárolnak.
- LifeStreet: 60 szerver, körülbelül 75 milliárd rekord naponta. Kevesebb szerver, több rekord, mint a Yandex esetében.
- CloudFlare: 36 szerver, napi 200 milliárd rekordot tárolnak. Még kevesebb szerverük van és még több adatot őriznek meg.
- Bloomberg: 102 a szerver, körülbelül egy trillió rekord naponta. Rekordert a rekordok számában.
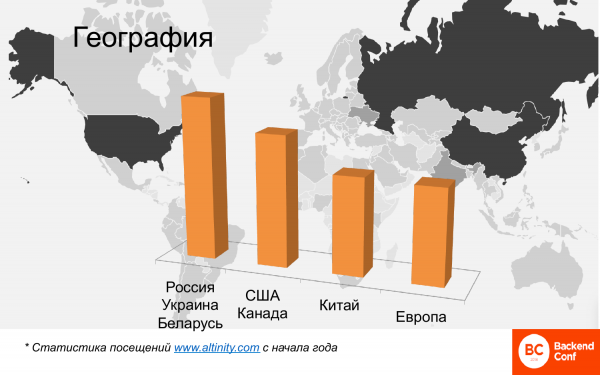
Földrajzilag ez is sok. Ez a térkép megmutatja a heatmapet, ahol a ClickHouse a világban használatban van. Itt Oroszország, Kína, Amerika kiemelkedik. Kevés európai ország van. Négy klasztert tudunk kiemelni.
Ez egy összehasonlító elemzés, itt nem kell abszolút számokat keresni. Ez az analízis olyan látogatókról készült, akik angol nyelvű anyagokat olvasnak az Altinity weboldalon, mert oroszul beszélők nincsenek ott. Oroszország, Ukrajna, Fehéroroszország, tehát az orosz nyelvű közösség a legnumerikusabb felhasználó. Utána az Egyesült Államok és Kanada következik. Kína nagyon gyorsan felzárkózik. Fél évvel ezelőtt Kínának szinte nyoma sem volt, most már Kína megelőzte Európát és tovább növekszik. Az öreg Európa sem marad le, és a ClickHouse használatának vezetője, meglepő módon, Franciaország.
Miért mesélek mindezt? Azért, hogy megmutassam, hogy a ClickHouse standard megoldássá válik a nagy adatok elemzésére, és már nagyon sok helyen használják. Ha Ön használja, akkor jó úton jár. Ha még nem használja, ne féljen attól, hogy egyedül marad, és senki nem segít, hiszen már sokan foglalkoznak ezzel.
Ezek a ClickHouse valós felhasználási példái több cégnél.
- Az első példa egy reklámhálózat: migráció a Vertica-ból ClickHouse-ra. Tudok néhány cégről, amelyek áttértek a Vertica-ról vagy a folyamatban vannak.
- A második példa egy tranzakcionális tároló ClickHouse-on. Ez egy példa, amely az antipatterns alapjain készült. Minden, amit a fejlesztők tanácsa szerint nem szabadna ClickHouse-on csinálni, itt megtalálható. Ennek ellenére annyira hatékonyan valósult meg, hogy működik. És sokkal jobban működik, mint a tipikus tranzakciós megoldás.
- A harmadik példa a ClickHouse-on történő elosztott számítások. Volt egy kérdés arról, hogyan lehet a ClickHouse-t integrálni a Hadoop ökoszisztémába. Megmutatom, hogy egy cég hogyan csinált ClickHouse-on valami hasonlót a map reduce konténerhez, figyelve az adatok lokalizációjára, hogy megoldhasson egy nagyon nem triviális feladatot.
- LifeStreet – Ez egy Ad Tech cég, amely mindennel rendelkezik, ami a reklámhálózat működéséhez szükséges.
- Reklámok optimalizálásával és programmatic bidding-gel foglalkozik.
- Sok adat: körülbelül 10 milliárd esemény naponta. Ezek az események több alsó eseményre is feloszthatók.
- Sok ügyfél használja ezeket az adatokat, nemcsak emberek, hanem sokkal több – különböző algoritmusok, amelyek programatikus ajánlattétellel foglalkoznak.
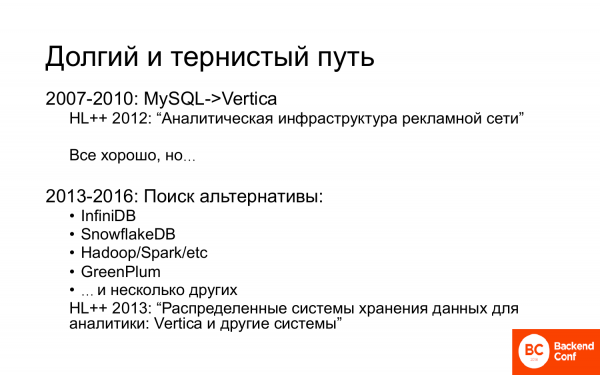
A cég hosszú és rögös utat járt be. Erről meséltem a HighLoad-on. Először a LifeStreet MySQL-ről (egy rövid megállással az Oracle-nál) Vertica-ra váltott. Erről beszámolót is találhatunk.
Minden nagyon jól ment, de elég gyorsan kiderült, hogy az adatok növekednek, és a Vertica drága. Ezért különböző alternatívákat kerestünk. Néhányat itt felsorolunk. Valójában a 13-as és 16-os év között a piacon elérhető adatbázisok gyakorlatilag mindegyikét teszteltük, amelyek nagyjából megfeleltek a funkcionális követelményeknek. és ezek egy részéről szintén beszéltem a HighLoad-on.
Az volt a feladatunk, hogy migráljunk a Vertica-ból, főleg, mert az adatok növekedtek. Évek óta exponenciálisan nőttek. Aztán egy idő után megálltak, de ez nem jelenti azt, hogy ne lett volna növekedés. A növekedés előrejelzésekor a vállalkozás igényei az adatmennyiségre, amellyel valamilyen elemzést kell végezni, jelezték, hogy hamarosan péterbyte-okról lesz szó. A péterbyte-okért már nagyon drágán kell fizetni, ezért kerestünk alternatívát, hová lehet áttérni.
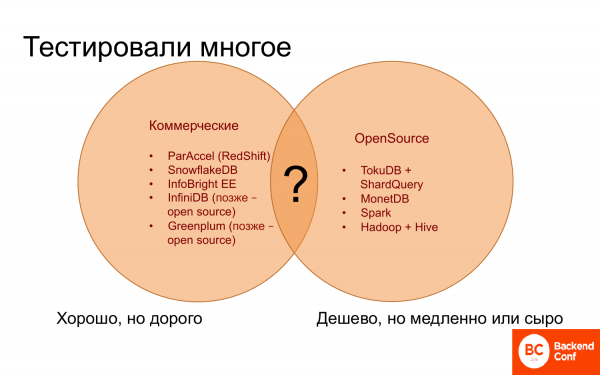
Hová lehet áttérni? Hosszú ideig teljesen nem volt világos, hogy hová lehet menni, mert egyrészt ott vannak a kereskedelmi adatbázisok, amelyek jónak tűnnek. Néhány szinte ugyanolyan jól működik, mint a Vertica, néhány rosszabbul. De mind drága, nem sikerült olcsóbb és jobbat találni.
Másrészt vannak nyílt forrású megoldások, de ezek nem túl sokan vannak, azaz az elemzéshez keveset lehet számolni. Ezek ingyenesek vagy olcsók, de lassan működnek. És gyakran hiányzik belőlük a szükséges és hasznos funkcionalitás.
Tehát, hogy ötvözze a kereskedelmi adatbázisokban lévő jó tulajdonságokat és mindazt, ami ingyenes a nyílt forrású megoldásokban – semmi sem volt.
Semmi sem volt, amíg váratlanul a Yandex elő nem rukkolt a ClickHouse-szal, mint a varázsló a kalapból húzott nyúllal. Ez meglepő megoldás volt, és azóta is kérdéseket tesznek fel: "Miért?", de mindenesetre.
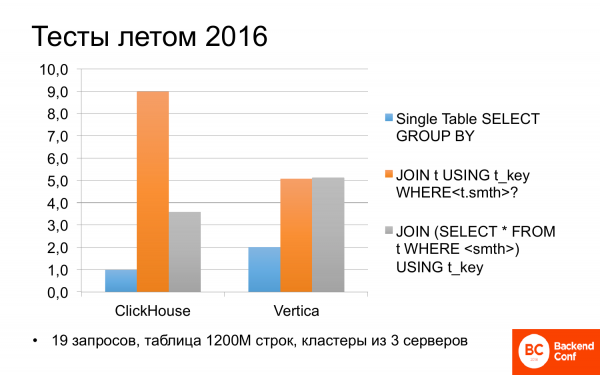
És 2016 nyarán elkezdtük nézni, mi is az a ClickHouse. Kiderült, hogy néha gyorsabb lehet, mint a Vertica. Különböző forgatókönyveket teszteltünk különböző lekérdezésekkel. Ha a lekérdezés csak egy táblát használt, azaz nem voltak csatlakozások (join), akkor a ClickHouse kétszer olyan gyors volt, mint a Vertica.
Nem sajnáltam az időt, és még egyszer megnéztem a Yandex teszteket. Ott is ugyanez van: a ClickHouse kétszer olyan gyors, mint a Vertica, ezért gyakran beszélnek róla.
De ha a lekérdezésekben vannak csatlakozások (join), akkor a helyzet nem annyira egyértelmű. A ClickHouse lehet, hogy lassabb a Vertica-nál kétszer. De ha egy kicsit átírjuk a lekérdezést, akkor nagyjából egyenlőek. Nem rossz. És ingyenes.
A teszteredmények megérkezése után, és mivel több szempontból is megnéztük ezt, a LifeStreet áttért a ClickHouse-ra.
Emlékeztetem, ez 2016. olyan volt, mint egy vicc a férgekről, akik sírtak és szúrták magukat, de folytatták a kaktusz evését. Ezt részletesen elmondták, van róla videó stb.
Ezért nem fogom részletesen elmondani, csak az eredményekről és néhány érdekes dologról beszélek, amiről akkor nem beszéltem.
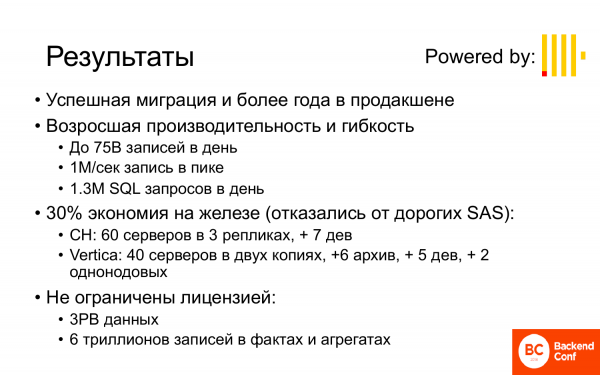
Az eredmények a következők:
- Sikeres migráció, és több mint egy éve működik a rendszer a termelési környezetben.
- A teljesítmény és rugalmasság nőt. A napi 10 milliárd bejegyzést, amit eddig meg tudtunk engedni, most a LifeStreet napi 75 milliárd bejegyzést tárol, és ezt 3 hónapig és tovább is meg tudja tenni. Ha a csúcsokat nézzük, az akár egymillió esemény másodpercenként is menthető. Több mint egymillió SQL-lekérdezés érkezik a rendszerbe naponta, főleg különböző robotoktól.
- Bár a ClickHouse-nál több szervert használtak, mint a Vertica esetében, a költségek megtakarítása is megvalósult, mert a Vertica meglehetősen drága SAS-lemezeket használt. A ClickHouse SATA-t használt. Miért? Mert a Vertica szinkron beszúrásokat használ. A szinkronizálás megköveteli, hogy a lemezek ne lassuljanak le túlságosan, és hogy a hálózat se lassuljon le, azaz ez egy elég költséges művelet. A ClickHouse viszont aszinkron beszúrásokat használ. Sőt, mindig lehet mindenféle helyi írás, további költségek nélkül, így az adatok a ClickHouse-ba sokkal gyorsabban betölthetőek, mint a Vertica-ba, még a nem leggyorsabb lemezek esetén is. Az olvasás pedig nagyjából ugyanolyan. Az olvasás SATA-n, ha RAID-ben vannak, akkor mindez elég gyors.
- Nincsenek licencianehézségek, tehát 3 petabájt adat 60 szerveren (20 szerver egy replikát jelent) és 6 trillió rekord az tényekben és aggregált adatokban. Ilyet a Vertica nem engedhetett meg magának.
Most áttérek a gyakorlati dolgokra ebben a példában.
- Először is, hatékony séma szükséges. A séma sok mindent befolyásol.
- A második a hatékony SQL-generálás.
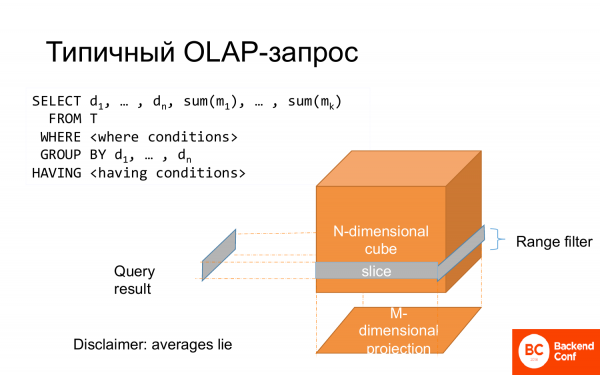
A tipikus OLAP-lekérdezés a select. Néhány oszlop group by-ba kerül, míg más oszlopok aggregáló funkciókba. Van egy where, amit a kocka szeletének tekinthetünk. Az egész group by bemutatja a projektet. Ezért nevezzük ezt többdimenziós adatelemzésnek.
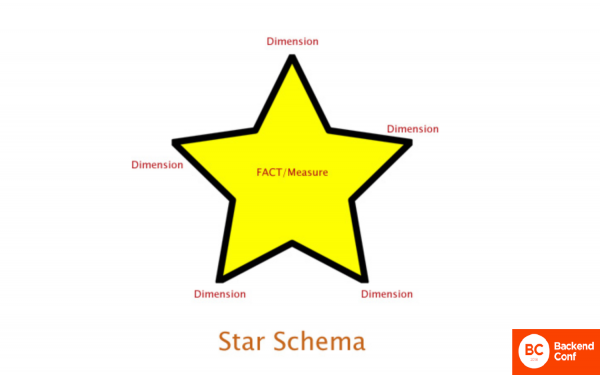
Gyakran ezt csillagsémaként modellezik, ahol van egy központi tény és a tény jellemzői körkörösen, mint sugárban helyezkednek el.
Fizikai dizájn szempontjából, ahogyan az táblázatra helyezkedik, általában normalizált megjelenítést végeznek. Lehet denormalizálni, de az költséges lemezterületen, és nem túl hatékony a lekérdezések szempontjából. Ezért általában normalizált megjelenítést alkalmaznak, tehát egy ténytáblát és sok-sok dimenziós táblát.
De a ClickHouse-ban ez rosszul működik. Két oka van:
- Az első, hogy a ClickHouse nem nagyon jó csatlakozásokkal (join) rendelkezik, tehát csatlakozások vannak, de gyengék. Jelenleg gyengék.
- A második pedig az, hogy a táblák nem frissülnek. Általában az ilyen táblák körül, amelyek a csillagsémák köré épülnek, változtatni kell valamin. Például az ügyfél neve, a cég neve és így tovább. És ez nem működik.
A ClickHouse-ban azonban van megoldás, sőt kettő is:
- Az első a szótárak használata. Az External Dictionaries közel 99%-ban segít megoldani a csillagsémával, az frissítésekkel és egyebekkel kapcsolatos problémát.
- A második a tömbök használata. A tömbök is segítenek megszabadulni a csatlakozásoktól (join) és a normalizálási problémáktól.
- Nincs szükség csatlakozásokra (join).
- Frissíthetők. 2018 márciusától egy nem dokumentált lehetőség jelent meg (a dokumentációban erről nem talál), ahol a szótárak részlegesen frissíthetők, tehát azok a bejegyzések, amelyek megváltoztak. Gyakorlatilag úgy működik, mint egy táblázat.
- Mindig a memóriában van, ezért a szótárral végzett csatlakozások (join) gyorsabban működnek, mint ha egy táblázat lenne, ami a lemezen van, és valószínűleg nincs is a cache-ben.
- Ez sem igényel csatlakozásokat (join).
- Ez egy kompakt 1 a sokhoz megjelenítés.
- Véleményem szerint a tömbök a geekek számára készültek. Ezek lambda-funkciók és hasonlók.
Ez nem csupán szavakban kifejezett dolog. Ez egy rendkívül erőteljes funkció, amely lehetővé teszi sok dolog nagyon egyszerű és elegáns végrehajtását.
Tipikus példák, amelyek segítenek az tömbök kezelésében. Ezek a példák egyszerűek és elég szemléletesek:
- Keresés címkék alapján. Ha ott vannak hashtagek, és szeretné találni azokat a bejegyzéseket, amelyek a hashtag alatt vannak.
- Keresés key-value párok alapján. Itt is vannak különböző attribútumok értékkel.
- Kulcslisták tárolása, amelyeket másra kell fordítani.
Mindezek a feladatok megoldhatók tömbök nélkül. A címkéket elhelyezheti egy kéziratba, és reguláris kifejezéssel kiválaszthatja, vagy külön táblázatba, de akkor csatlakoztatni kell (join).
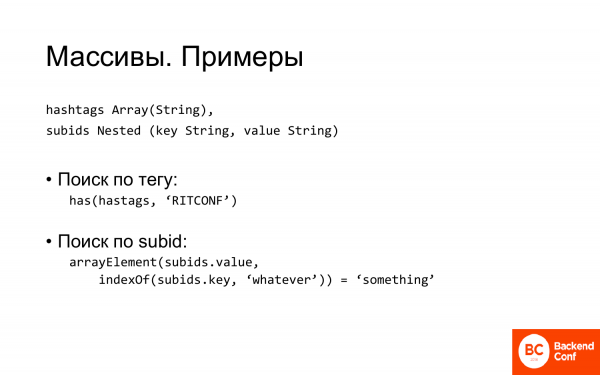
A ClickHouse-ban mindezt nem kell csinálni, elegendő, ha leírja a string tömböt a hashtagekhez, vagy egy beágyazott struktúrát készít key-value típusú rendszerekhez.
A beágyazott struktúra talán nem a legjobb név. Ez két tömb, amelyek közös részük van a nevükben és néhány kapcsolódó tulajdonságuk.
A címkék szerinti keresés nagyon egyszerű. Van egy funkció has, amely ellenőrzi, hogy a tömbben van-e elem. Ennyi, megtaláltuk az összes bejegyzést, amely a konferenciánkhoz tartozik.
A subid szerinti keresés kicsit bonyolultabb. Először meg kell találnunk a kulcs indexét, majd el kell vennünk az indexszel rendelkező elemet, és ellenőriznünk kell, hogy az érték az, amit keresünk. De ha röviden, nagyon egyszerű és tömör.
A reguláris kifejezés, amit írnának, ha mindezt egy sorban tárolták volna, egyrészt csúnya lenne. Másrészt pedig sokkal tovább tartana, mint két tömb.
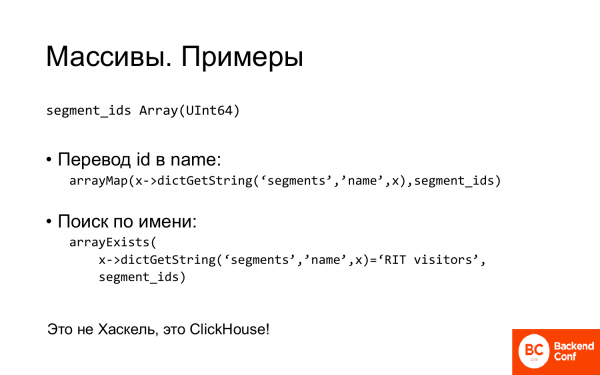
Egy másik példa. Van egy tömb, amelyben az ID-kat tárolja. És ezeket nevessé lehet alakítani. A funkció arrayMap. Ez egy tipikus lambda-funkció. Átadja a lambda-kifejezéseket. És ez minden ID-ra a szótárban kinyeri a nevet.
Hasonló módon lehet keresést is végezni. Egy predikátum-funkciót adunk át, amely ellenőrzi, hogy az elemek minek felelnek meg.
Ezek a dolgok jelentősen leegyszerűsítik a sémát és megoldanak egy csomó problémát.
De a következő probléma, amellyel szembesültünk, és amiről szeretnék beszélni, az hatékony lekérdezések.
- A ClickHouse-ban nincs lekérdezés ütemező. Egyáltalán nincs.
- De mindazonáltal a bonyolult lekérdezéseket mégis ütemezni kell. Milyen esetekben?
- Ha a kérésben több join található, amelyeket alsó lekérdezésekbe csomagol. A végrehajtásuk sorrendje számít.
- A második pedig – ha a kérés elosztott. Mert az elosztott kérésben csak a legbelső alsó lekérdezés hajtódik végre elosztottan, a többi egy szerverre kerül, amelyhez csatlakozott, és ott hajtják végre. Tehát ha elosztott lekérdezéseid vannak sok join-nal, akkor figyelemmel kell kísérni a sorrendet.
Még egyszerűbb esetekben is néha érdemes a tervezőt megdolgoztatni, és a lekérdezéseket egy kicsit átírni.
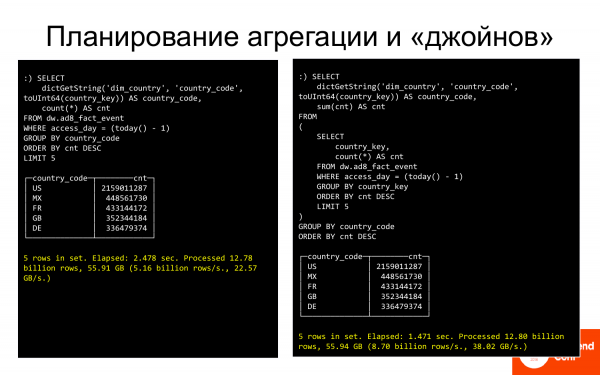
Itt egy példa. Az egyik oldalon a lekérdezés, amely megmutatja az öt legjobb országot. És ez 2,5 másodperc alatt fut le, ahogy gondolom. A másik oldalon ugyanez a lekérdezés, de kicsit átírtuk. Ahelyett, hogy soronként csoportosítanánk, kulcs (int) alapján csoportosítottunk. Ez gyorsabb. Majd az eredményhez csatlakoztattuk a szótárat. A 2,5 másodperc helyett 1,5 másodperc alatt fut le a lekérdezés. Ez jó.
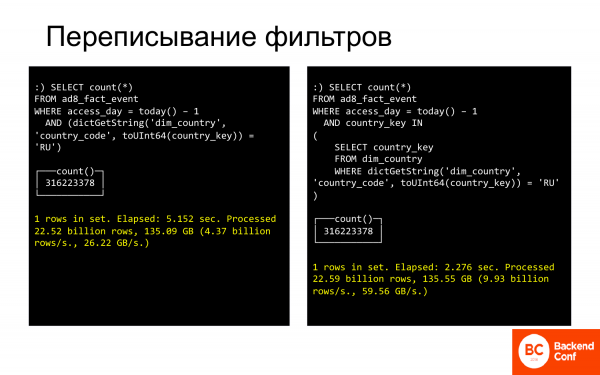
Hasonló példa a szűrők átírására. Itt a lekérdezés Oroszországra vonatkozik. 5 másodperc alatt fut le. Ha átírjuk úgy, hogy nem ismétlünk összehasonlítást, hanem számokat hasonlítunk össze egy olyan kulcskészlettel, amely Oroszországra vonatkozik, akkor ez sokkal gyorsabb lesz.
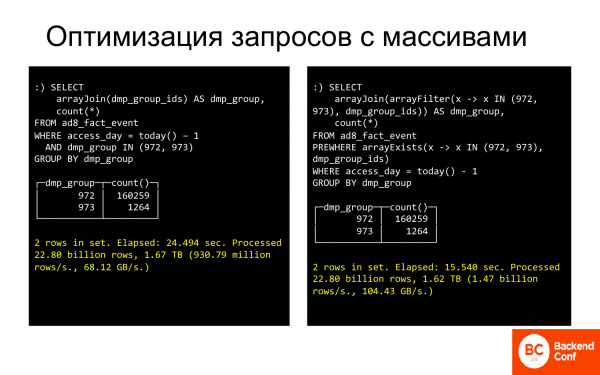
Sok ilyen trükk akad. Ezek lehetővé teszik, hogy jelentősen felgyorsítsuk a lekérdezéseket, amelyeket már gyorsnak tűnnek, vagy éppen ellenkezőleg, lassúak. Ezeket még gyorsabbá tehetjük.
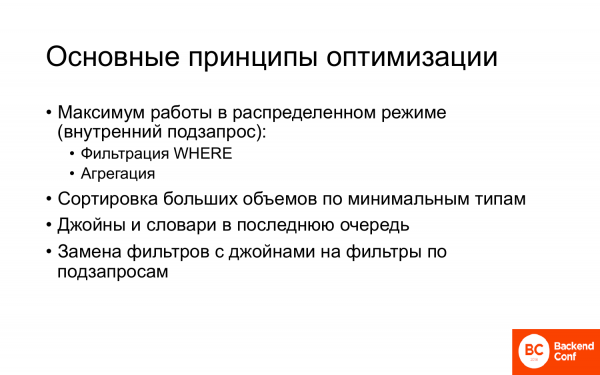
- A maximális munka elosztott módban.
- Rendezés a minimális típusok szerint, ahogy azt az intek esetében tettem.
- Ha vannak join-ok, szótárak, akkor azokat a legutolsó pillanatban érdemes végezni, amikor az adatok már legalább részben csoportosítva vannak, így a join vagy szótárhívás kevesebb alkalommal fog megtörténni, ami gyorsabbá teszi.
- Szűrők cseréje.
Vannak más technikák is, nem csak azok, amelyeket bemutattam. Mindegyik alkalmanként jelentősen felgyorsíthatja a lekérdezések végrehajtását.
Térjünk a következő példára. A X cég az Egyesült Államokból. Mit csinál?
Volt egy feladat:
- Offline hirdetési tranzakciók összekapcsolása.
- Különböző összekapcsolási modellek modellezése.
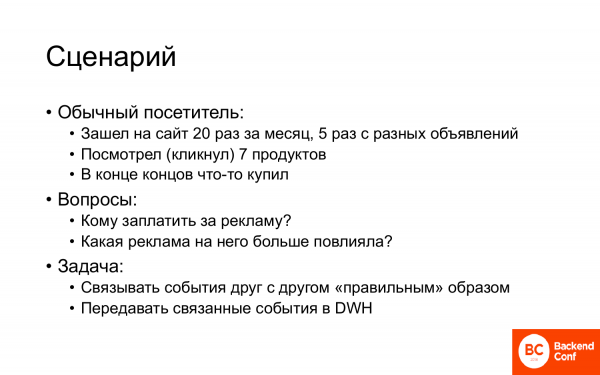
Mi a forgatókönyv lényege?
A typical visitor visits the site, for example, 20 times a month from different ads or just sometimes comes without any ads because they remember the site. They look at some products, add them to their cart, take them out of the cart. And in the end, they buy something.
Reasonable questions: 'Who needs to pay for advertising, if needed?' and 'Which advertisement influenced them, if any?'. That is, why did they buy and how to make people similar to this person also buy?
To solve this task, it's necessary to link events occurring on the website in the correct way, that is, to build a connection between them. Then, send them for analysis to the DWH. Based on this analysis, create models on whom and which advertisements to show.
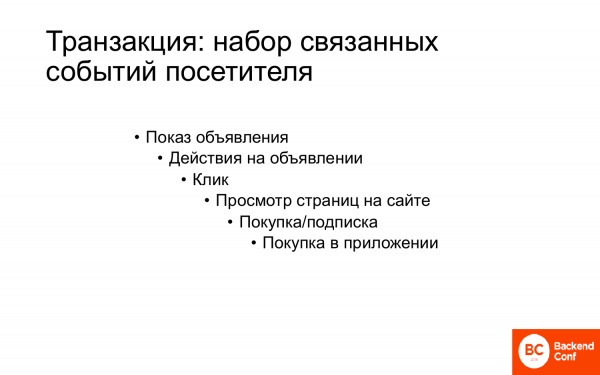
An advertising transaction is a set of related user events that start from an ad display, something happens next, then possibly a purchase, and there could be further purchases subsequently. For example, if it’s a mobile app or mobile game, the app installation usually happens for free, but if something else is done there, money might be required for that. The more a person spends in the app, the more valuable they are. But to make this work, everything needs to be linked.
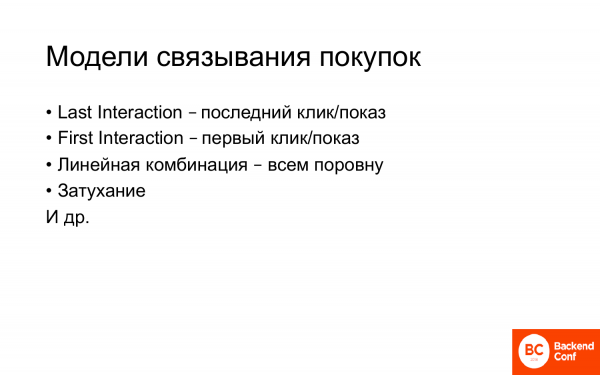
There are many models of linking.
The most popular ones are:
- Last Interaction, where interaction is either a click or a display.
- First Interaction, that is, the first thing that brought the person to the site.
- Linear combination – equal for everyone.
- Decay.
- And others.
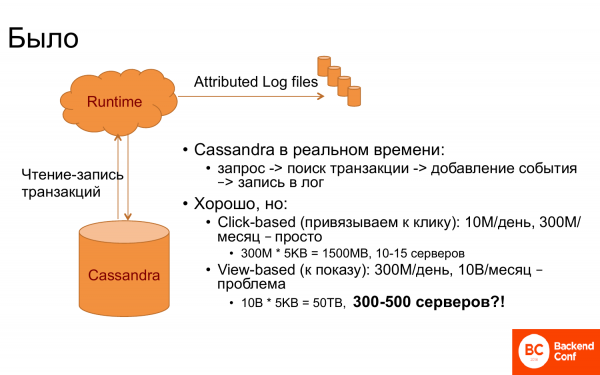
And how did all this work initially? There was Runtime and Cassandra. Cassandra was used as transaction storage, that is, it stored all related transactions. When an event comes to Runtime, for example, displaying a certain page or something else, a query was made to Cassandra – is there such a person or not. Then the transactions related to them were retrieved. And linking was performed.
And if it was lucky that the request has a transaction id, then it's easy. But usually, luck is not on our side. Therefore, it was necessary to find the last transaction or the transaction with the last click, etc.
Ez eddig nagyon jól működött, amíg a kapcsolódást az utolsó kattintásra alapoztuk. Mert mondjuk naponta 10 millió kattintás van, havonta 300 millió, ha havonta nézzük a dolgot. És mivel a Cassandrának ezt mind memóriában kell tartania, hogy gyorsan működjön, hiszen a Runtime-nak gyors válaszra van szüksége, körülbelül 10-15 szerverre volt szükség.
De amikor a tranzakciókat már a megjelenítéshez kötötték, akkor ez már nem volt annyira vidám. Miért? Nyilvánvaló, hogy 30-szor több eseményt kellett tárolni. És ennek megfelelően 30-szor több szerverre van szükség. És ez már egy olyan csillagászati szám, hogy 500 szervert kell fenntartani a kapcsolódáshoz, miközben a Runtime-ban sokkal kevesebb szerver van, ez már nem egy helyes szám. Elkezdtek gondolkodni, hogy mit tegyenek.
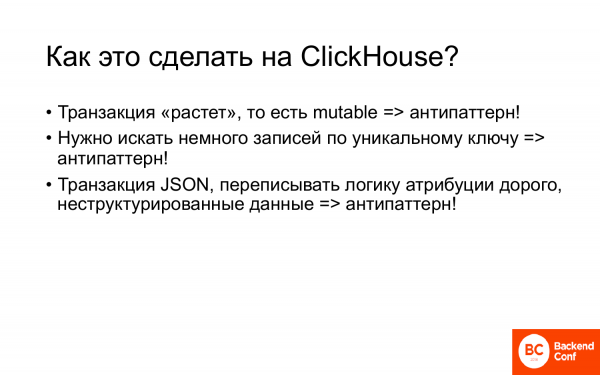
Így kerültünk a ClickHouse-hoz. De hogyan csináljuk ezt ClickHouse-szal? Első pillantásra úgy tűnik, hogy ez egy antipattern assemblage.
- A tranzakció nő, folyamatosan újabb és újabb eseményeket fűzünk hozzá, tehát változtatható, a ClickHouse pedig nem igazán működik jól a változtatható objektumokkal.
- Amikor hozzánk érkezik egy látogató, ki kell húznunk a tranzakcióit a kulcs alapján, a látogatási azonosítója szerint. Ez is egy point query, a ClickHouse-ban így nem csinálnak. Általában a ClickHouse nagy … skanálásokat végez, nekünk pedig néhány bejegyzést kellene elérnünk. Ez is antipattern.
- Ezen kívül a tranzakció json formátumban volt, de nem akarták átírni, ezért azt akarták, hogy a json ne legyen strukturálva, hanem ha szükséges, akkor abból valami kikerülhessen. Ez is antipattern.
Tehát ez egy antipattern set.
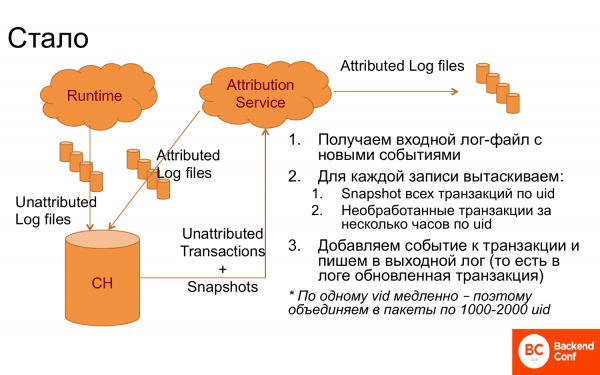
De ennek ellenére sikerült egy olyan rendszert létrehozni, amely nagyon jól működött.
Mi történt? Megjelent a ClickHouse, ahova a logok felkerültek, bejegyzésekre bontva. Megjelent egy attributed szolgáltatás, amely a ClickHouse-ból szedte ki a logokat. Ezután minden bejegyzés esetén a látogatási azonosító szerint kinyerte a tranzakciókat, amelyek esetleg még feldolgozatlanok voltak, plusz a snapshotokat, tehát már összekapcsolt tranzakciók, azaz a korábbi munka eredménye. Ezekből már készítette a logikát, kiválasztotta a megfelelő tranzakciót, csatlakoztatta az új eseményeket. Újra beleírta a logba. A log visszakerült a ClickHouse-ba, tehát ez egy folyamatos ciklikus rendszer. Ezen kívül bekerült a DWH-ba is, hogy ott elemezzék.
Ezen a módon nem működött túl jól. Ahhoz, hogy a ClickHouse könnyebben tudjon kezelni egy lekérdezést a látogatási azonosító alapján, a lekérdezéseket 1 000–2 000 látogatási azonosítóra csoportosították, és 1 000–2 000 ember tranzakcióját hozták elő. Így minden működni kezdett.
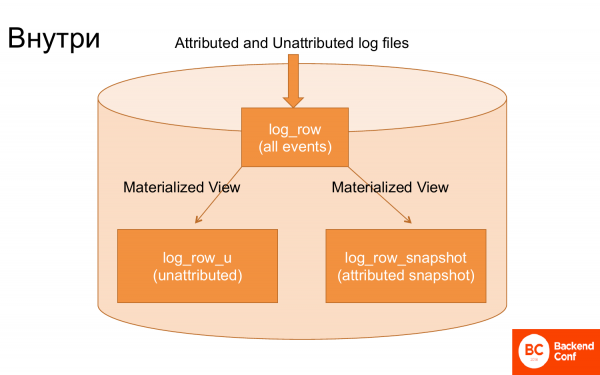
Ha belenézünk a ClickHouse belsejébe, három fő táblázat van, ami mindezt kezeli.
Az első táblázat, ahová a naplókat betöltik, ráadásul a naplók szinte feldolgozás nélkül töltődnek be.
A második táblázat. A naplókból egy materializált nézet révén kiemelték azokat az eseményeket, amelyek még nem lettek hozzárendelve, azaz nem kapcsolódnak semmihez. A naplók alapján egy materializált nézet segítségével a tranzakciókat is kiemelték a pillanatfelvétel létrehozásához. Tehát egy speciális materializált nézet építette fel a pillanatfelvételt, nevezetesen a legutolsó felhalmozott tranzakcióállapotot.
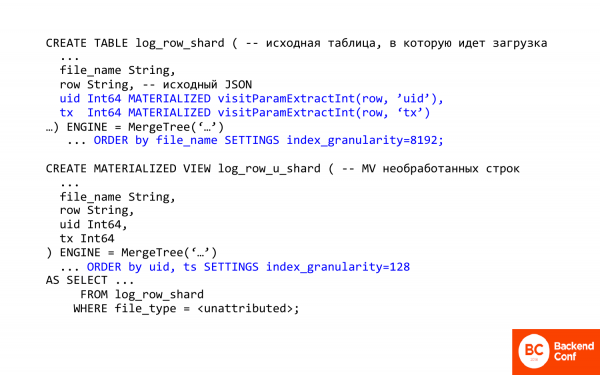
Itt van egy SQL-re írt szöveg. Szeretnék néhány fontos dolgot megjegyezni benne.
Az első fontos dolog – a ClickHouse lehetősége, hogy json-ból kiemeljen oszlopokat, mezőket. Tehát a ClickHouse-ban vannak bizonyos módszerek a json kezelésére. Ezek nagyon-nagyon primitívek.
A visitParamExtractInt lehetővé teszi az attribútumok kiemelését a json-ból, tehát az első találat azonnal működik. Így ki lehet emelni a tranzakció azonosítót vagy a látogatási azonosítót. Ez az egyik.
A második – itt egy ügyes materializált mező került felhasználásra. Mit is jelent ez? Azt jelenti, hogy nem lehet a táblázatba betenni, azaz nem a táblázatba kerül, hanem kiszámítják és a beszúrás során tárolják. A beszúráskor a ClickHouse elvégzi helyetted a munkát. És már a json-ból kiemeli azt, amire később szükséged lesz.
Ebben az esetben a materializált nézet a feldolgozandó sorokhoz készült. Éppen az első táblázatból használja a szinte nyers naplókat. És mit csinál? Először is megváltoztatja a rendezést, azaz a rendezés most a látogatási azonosító alapján történik, mert gyorsan szeretnénk kiemelni egy konkrét személy tranzakcióját.
A második fontos dolog – az index_granularity. Ha láttad a MergeTree-t, akkor általában alapértelmezés szerint 8 192-re van állítva az index_granularity. Mi ez tulajdonképpen? Ez az index sűrűségének paramétere. A ClickHouse esetében az index ritkás, soha nem indexeli az összes bejegyzést. Ezt 8 192-esenként végzi. Ez jónak számít, amikor sok adatot kell megszámolni, de rossz, amikor kicsit, mert nagy a túlfejlesztés. Ha csökkentjük az index sűrűséget, csökkentjük a túlfejlesztést. Egyesre csökkenteni nem lehet, mert nem lenne elég memória. Az index mindig a memóriában tárolódik.
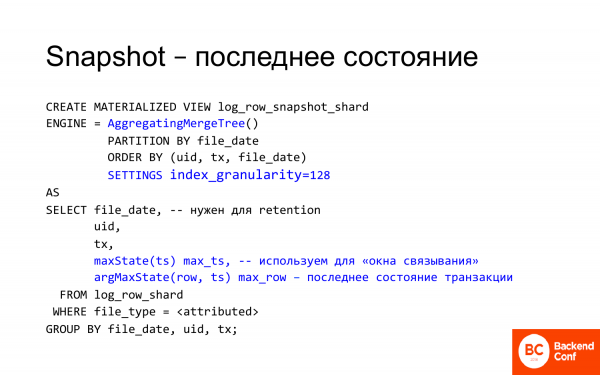
A snapshot még néhány érdekes funkciót használ a ClickHouse-ban.
Először is, ez az AggregatingMergeTree. Az AggregatingMergeTree tárolja az argMax-ot, azaz az aktuális tranzakció állapotát, ami a legutolsó timestamp-hez tartozik. A tranzakciók folyamatosan generálódnak az adott látogató számára. Az utolsó állapothoz hozzáadtunk egy eseményt, és új állapotunk lett. Ez újra bekerült a ClickHouse-ba. Az argMax segítségével ebben a materializált nézetben mindig meg tudjuk kapni a legfrissebb állapotot.
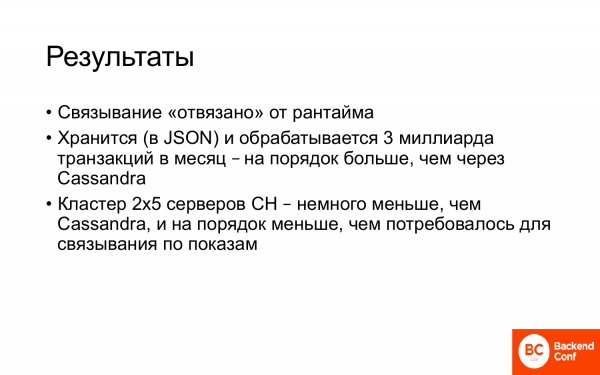
- A kapcsolódás „leválasztva” a Runtime-tól.
- Havonta legfeljebb 3 milliárd tranzakciót tárolunk és dolgozunk fel. Ez nagyságrendekkel több, mint ami a Cassandra-ban volt, azaz a tipikus tranzakciós rendszerhez képest.
- 2x5 szerverből álló ClickHouse klaszter. 5 szerver van, és minden szervernek van egy példánya. Ez még kevesebb, mint amit a Kassandraban használtunk, hogy kattintás alapú attribúciót végezzen, míg itt impresszió alapú. Azaz ahelyett, hogy 30-szorosára növelnénk a szerverek számát, sikerült csökkenteni.
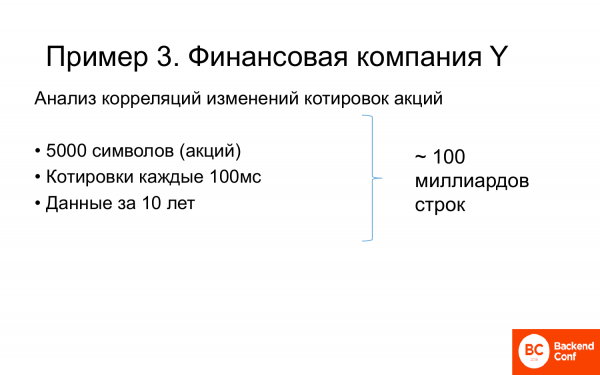
Az utolsó példa egy Y pénzügyi vállalat, amely a részvényárfolyamok változásainak korrelációit elemezte.
A feladat a következő volt:
- Körülbelül 5000 részvény van.
- Az árfolyamok 100 milliszekundumként ismertek.
- Az adatok 10 év alatt gyűltek össze. Nyilvánvalóan egyes cégek esetében több, másoknál kevesebb.
- Összesen körülbelül 100 milliárd sor.
A változások korrelációját kellett kiszámolni.
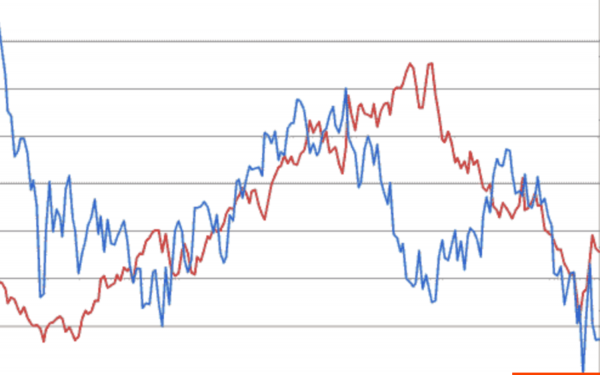
Itt két részvény és azok árfolyamai szerepelnek. Ha az egyik felfelé megy, és a másik is felfelé, az pozitív korrelációt jelent, azaz az egyik nő, a másik is nő. Ha az egyik felfelé megy, mint a grafikon végén, a másik pedig lefelé, az negatív korrelációt jelent, azaz amikor az egyik nő, a másik csökken.
Ezeknek a kölcsönös változásoknak az elemzésével előrejelzéseket lehet készíteni a pénzpiacon.
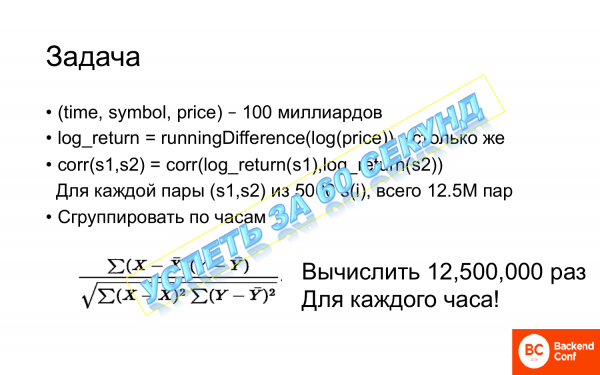
De a feladat összetett. Mit teszünk ezért? 100 milliárd rekordunk van, amelyekben: idő, részvény és ár szerepel. Először 100 milliárdszor kell kiszámolnunk a runningDifference-t az ár algoritmusából. A runningDifference egy olyan funkció a ClickHouse-ban, amely a két sor közötti különbséget folyamatosan számolja.
Ezután pedig a korrelációt kell kiszámolni, mégpedig minden párra. Az 5000 részvény esetében 12,5 millió pár van. Ez sok, azaz 12,5-ször kell kiszámítani ezt a korrelációs funkciót.
Ha valaki elfelejtette volna, ͞x és ͞y – ezek a mintára vonatkozó matematikai elvárások. Ezért nem csak a gyököket és az összegeket kell kiszámolni, hanem ezeken belül is újabb összegeket. Egy csomó-csomó számítást kell végezni 12,5 millió alkalommal, és még az órák szerint is kell csoportosítani. És órákból is van nem kevés. Az egésznek 60 másodperc alatt kellene befejeződnie. Ez vicc.
Valahogy be kellett fejezni, mert mindez nagyon-nagyon lassan működött, mielőtt megérkezett a ClickHouse.
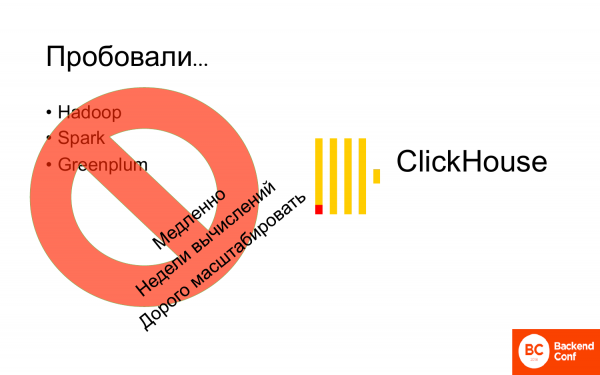
Megpróbálták Hadoop-on, Spark-on, Greenplum-on kiszámolni. És mindez nagyon lassú vagy drága volt. Tehát valahogy lehetett számolni, de az aztán drága lett.
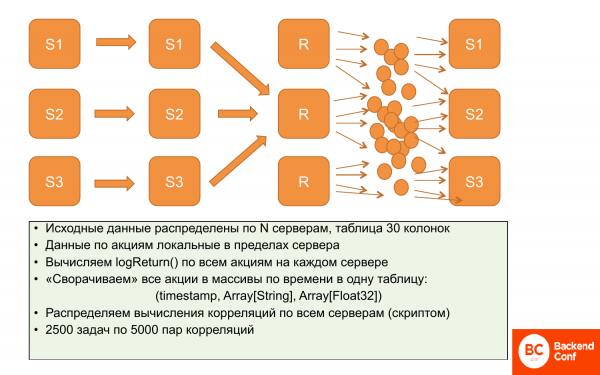
Aztán megérkezett a ClickHouse, és minden sokkal jobbra fordult.
Emlékeztetem, hogy a probléma a localitás a adatokkal, ezért a korrelációkat nem lehet lokalizálni. Nem tudjuk a részadatokat egy helyi szerverre helyezni, a másik helyi szerverre pedig a többit, mindenkinek minden adatnak rendelkezésre kell állnia.
Mit tettek? Kezdetben az adatok lokalizáltak voltak. Minden egyes szerveren a bizonyos készlet részvényének árképzése szerinti adatok tárolódnak. És ezek nem metszik egymást. Ezért a logReturn-t párhuzamosan és függetlenül lehetett számolni, mindez párhuzamosan és elosztva történik.
Később úgy döntöttek, hogy ezeket az adatokat csökkentik, anélkül hogy kifejezőképességet veszítenének. A csökkentés tömbök segítségével történik, azaz minden időintervallumra létrehoznak egy részvény- és árközéptömböt. Így az adatok jelentősen kevesebb helyet foglalnak el. Így valamivel kényelmesebben lehet velük dolgozni. Ezek szinte párhuzamos műveletek, azaz párhuzamosan részben számolunk és aztán rögzítjük a szerveren.
Ezután ez replikálható. Az 'r' betű azt jelenti, hogy ezeket az adatokat replikáltuk. Tehát mindhárom szerveren azonosak az adatok – ezeket a tömböket.
Ezután egy külön szkripttel a 12,5 millió korrelációs adatcsomagból, amit számolni kell, lehet csomagokat készíteni. Azaz 2 500 feladat 5 000 pár a korrelációkból. És ezt a feladatot egy adott ClickHouse szerveren lehet számolni. Minden adat a rendelkezésére áll, mert az adatok azonosak, és előre haladhat a számításokkal.
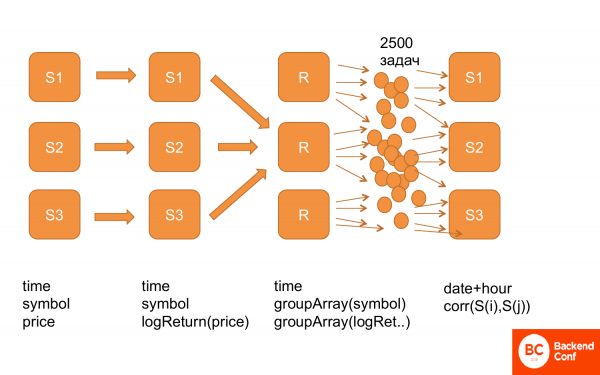
Újra, hogy néz ki ez. Először is, minden adatunk ilyen struktúrában van: idő, részvények, ár. Aztán kiszámítottuk a logReturn-t, azaz az adatok ugyanebben a struktúrában, csak a ár helyett már logReturn. Ezután átkonvertáltuk őket, így az idő és a groupArray a részvények és az árak alapján keletkezett. Összevontuk. És ezután létrehoztunk egy halom feladatot, és tápláltuk a ClickHouse-t, hogy számolja őket. Ez működik.
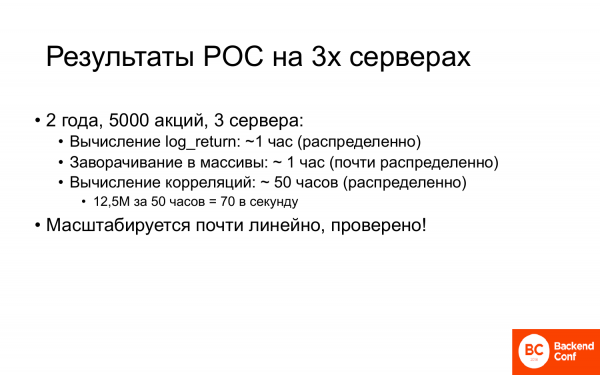
A proof of concept feladat – ez egy részfeladat volt, azaz kevesebb adatot vettünk. És mindössze három szerveren.
Az első két fázis: a log_return számítása és az átkonvertálás tömbökre körülbelül egy órát vett igénybe.
A korreláció számítása körülbelül 50 órát vett igénybe. De 50 óra – ez kevés, mert korábban ez heteken át tartott. Ez nagy siker volt. És ha megnézzük, a klaszterünkön másodpercenként 70-szer végezte a számítást.
De a legfontosabb, hogy ez a rendszer gyakorlatilag nem tartalmaz szűk keresztmetszeteket, azaz gyakorlatilag lineárisan skálázható. Ezt kipróbálták. Sikeresen skálázták.
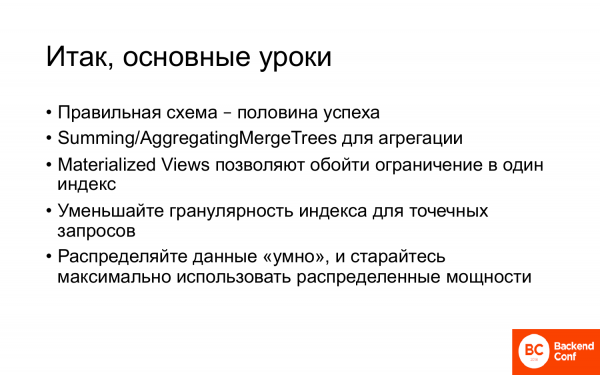
- A helyes séma a siker fele. A helyes séma pedig az összes szükséges ClickHouse technológia használatát jelenti.
- Summing/Aggregating MergeTrees – ezek olyan technológiák, amelyek lehetővé teszik az aggregálást vagy a snapshot állapot számítását mint külön eset. Ez lényegesen egyszerűsíti a dolgokat.
- A Materialized Views lehetővé teszik, hogy kikerüljük az egy indexre vonatkozó korlátozást. Lehet, hogy ezt nem mondtam el túl világosan, de amikor betöltöttük a naplókat, a nyers naplók egy egy indexes táblában voltak, míg az attributum naplók egy másik táblában voltak, azaz ugyanazok az adatok, csak szűrt formában, de a index teljesen más volt. Látszólag ugyanazok az adatok, de különböző rendezés. A Materialized Views lehetővé teszi, ha szüksége van rá, hogy megkerülje ezt a ClickHouse korlátozást.
- Csökkentse az index granularitását a pontszerű lekérdezésekhez.
- És intelligensen osztja el az adatokat, próbálja meg maximálisan lokalizálni az adatokat a szerveren belül. És igyekezzen, hogy a lekérdezések is a lehető legjobban használják a lokalizációt.
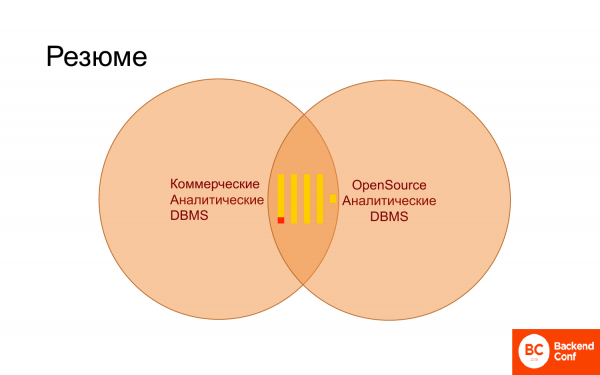
Összefoglalva ezt a rövid beszédet, elmondható, hogy a ClickHouse most már határozottan elfoglalta a kereskedelmi adatbázisok és az open source adatbázisok területét, azaz kifejezetten az analitika számára. Remekül illeszkedik ebbe a tájképe. Sőt, fokozatosan kezdi kiszorítani a másokat, mert ha van ClickHouse, akkor nincs szükség InfiniDB-re. A Vertica talán hamarosan feleslegessé válik, ha normális SQL-támogatást nyújtanak. Használjátok!
—Köszönöm az előadást! Nagyon érdekes! Volt valamilyen összehasonlítás az Apache Phoenix-szal?
-Nem, nem hallottam, hogy valaki összehasonlította volna. Mi, a Yandex, igyekszünk nyomon követni minden összehasonlítást a ClickHouse és különböző adatbázisok között. Mert ha esetleg valami gyorsabb lesz, mint a ClickHouse, akkor Lesha Milovidov nem tud aludni éjjel, és gyorsan elkezdi gyorsítani. Én nem hallottam ilyen összehasonlításról.
(Aleksey Milovidov) Az Apache Phoenix egy SQL-motor az Hbase-en. Az Hbase főleg kulcs-érték típusú munkafolyamatokhoz készült. Minden sorhoz tetszőleges számú oszlop rendelhető, tetszőleges nevekkel. Ezt elmondhatjuk az olyan rendszerekre, mint az Hbase vagy a Cassandra. És ezekkel a nehéz analitikai lekérdezésekkel normálisan nem fognak működni. Vagy azt gondolhatod, hogy jól működnek, ha nincs tapasztalatod a ClickHouse használatában.
Köszönöm
Jó napot! Már elég régóta érdeklődöm ez iránt a téma iránt, mert van egy analitikai alrendszerem. De amikor a ClickHouse-ra nézek, az az érzésem támad, hogy a ClickHouse nagyon jó az események, a módosítható adatok elemzésére. És ha sok üzleti adatot kell elemeznem rengeteg nagy táblával, akkor a ClickHouse, ahogy értem, nem nagyon nekem való? Különösen, ha ezek változnak. Igaz ez, vagy vannak olyan példák, amelyek ezt megcáfolhatják?
Ez helyes. És ez igaz a legtöbb specializált analitikai adatbázisra. Ezek arra vannak optimalizálva, hogy egy vagy több nagy táblával dolgozzanak, amelyek változtathatók, és sok kis táblával, amelyek lassan változnak. Azaz, a ClickHouse nem olyan, mint az Oracle, ahová mindent beletölthetünk és bonyolult lekérdezéseket építhetünk. Annak érdekében, hogy a ClickHouse-t hatékonyan használhassuk, a sémát úgy kell felépíteni, ahogyan az jól működik a ClickHouse-ban. Azaz, érdemes elkerülni a túlzott normalizálást, szótárakat használni, és igyekezni kevesebb hosszú kapcsolatot kialakítani. Ha a sémát így építjük fel, akkor a hasonló üzleti kihívásokat a ClickHouse-szal sokkal hatékonyabban lehet megoldani, mint a hagyományos relációs adatbázissal.
Köszönöm a beszámolót! Kérdésem van az utolsó pénzügyi esettel kapcsolatban. Volt analitikai adataik. Össze kellett hasonlítani, hogy hogyan változik felfelé-lefelé. Jól értem, hogy a rendszert kifejezetten erre az analitikára építették? Ha holnap például szükségük lenne egy másik jelentésre ezen adatok alapján, újra kell építeni a sémát és betölteni az adatokat? Azaz, szükség van valamilyen előfeldolgozásra az lekérdezéshez?
Természetesen, ez a ClickHouse használata egy konkrét feladathoz. Ezt hagyományosan a Hadoop keretein belül oldanák meg. A Hadoop számára ez egy ideális feladat. De a Hadoopon ez nagyon lassú. Az én célom az, hogy bemutassam, hogy a ClickHouse segítségével olyan feladatokat lehet megoldani, amelyeket általában teljesen más eszközökkel oldanak meg, de sokkal hatékonyabban. Ez egy specifikus feladatra van optimalizálva. Nyilvánvaló, hogy ha van egy hasonló feladat, akkor azt hasonló módon lehet megoldani.
Értem. Azt mondtad, hogy 50 órát dolgozott. Ez az elejétől kezdve, amikor az adatokat betöltötték, vagy amikor az eredményeket kapták?
Igen-igen.
Rendben, köszönöm szépen.
Ez egy 3 szerveres klaszteren van.
Üdvözlöm! Köszönöm a beszámolót! Minden nagyon érdekes. Egy kicsit nem a funkciókról kérdeznék, hanem a ClickHouse stabilitásának használata szempontjából. Volt-e bármilyen incidens, amely helyreállítást igényelt? Hogyan viselkedik a ClickHouse ilyenkor? Előfordult-e, hogy a replikája is kiesett? Például nekünk a ClickHouse-szal az a problémánk támadt, hogy végül túllépte a határértékét és leállt.
Természetesen nincsenek tökéletes rendszerek. A ClickHouse-nak is vannak problémái. De hallottál arról, hogy a Yandex.Metrica hosszú ideig nem működött? Valószínűleg nem. 2012-2013 óta megbízhatóan működik a ClickHouse-nal. A tapasztalataimról is beszélhetek. Soha nem volt teljes leállásunk. Apróbb problémák előfordulhattak, de soha nem voltak olyan kritikusak, hogy komolyan befolyásolják a vállalkozást. Ilyen még nem történt. A ClickHouse elég megbízható, és nem omlik össze véletlenszerűen. Ezen nem kell aggódni. Ez nem egy nyers dolog. Ezt sok cég bizonyította.
Üdvözlöm! Azt mondta, hogy alaposan meg kell gondolni az adatstruktúrát az elején. Mi van, ha ez megtörtént? Az adatok folyamatosan érkeznek. Fél év elteltével rájövök, hogy így nem lehet élni, újra kell töltenem az adatokat és valamit kezdeni velük.
Ez természetesen a rendszerétől függ. Van néhány módszer, amellyel ezt gyakorlatilag leállás nélkül meg lehet valósítani. Például létrehozhat egy Materialized View-t, amelyben egy másik adatstruktúrát alakít át, ha az egyértelműen leképezhető. Tehát ha lehetséges a ClickHouse eszközeivel történő leképzés, azaz bizonyos dolgok kinyerése, a primary key megváltoztatása, a particionálás módosítása, akkor létrehozhat egy Materialized View-t. Az előző adatait átmásolhatja, az új adatokat automatikusan fogják beírni. Aztán egyszerűen csak átállhat a Materialized View használatára, majd átkapcsolhatja az írást, és az régi táblát törölheti. Ez valójában leállás nélküli megoldás.
Köszönöm.
Forrás: habr.com
