

Helló mindenkinek, a nevem Sándor, és Adatminőség mérnök vagyok, aki az adatok minőségének ellenőrzésével foglalkozik. Ebben a cikkben arról lesz szó, hogy hogyan jutottam el idáig, és miért vált ez a tesztelési irány 2020-ban a hullám tetejére.
Globális trend
A mai világ újabb technológiai forradalmon megy keresztül, amelynek egyik aspektusa, hogy különböző cégek az összegyűjtött adatokat használják saját értékesítési, nyereségi és PR-motorjuk előmozdítására. Úgy tűnik, hogy a jó (minőségi) adatok rendelkezése, valamint azoknak a tehetséges elméknek a megléte, akik képesek ezeket pénzzé tenni (helyesen feldolgozni, visualizálni, gépi tanulási modelleket építeni stb.), ma a siker kulcsává vált sokak számára. Míg 15-20 évvel ezelőtt az adatok gyűjtésével és monetizálásával leginkább nagy cégek foglalkoztak, ma már ez minden ésszerű gondolkodású cég sajátja.
Ennek következtében néhány évvel ezelőtt a világ minden munkahelykeresési portálja tele lett Data Scientist álláshirdetésekkel, mivel mindenki biztos volt benne, hogy ha egy ilyen szakembert alkalmaznak, akkor supermodelleket építhetnek gépi tanulásra, előrejelezhetik a jövőt, és kvantumugrást tehetnek a cég számára. Idővel az emberek rájöttek, hogy ez a megközelítés szinte sehol sem működik, mivel a Data Scientist kezei közé kerülő adatok messze nem mind alkalmasak a modellek tanítására.
Kezdődtek a Data Scientist kérései: „Vásároljunk még adatokat ezektől és azoktól…”, „Nem elég az adat…”, „Még egy kis adatra van szükségünk, lehetőleg minőségire…”. Ezekre a kérésekre alapozva sokféle együttműködés alakult ki a különböző adathalmazon rendelkező cégek között. Nyilvánvalóan, ennek a folyamatnak a technikai szervezése is szükséges volt - csatlakozni az adatforráshoz, letölteni az adatokat, ellenőrizni, hogy azok teljes terjedelmükben feltöltődtek stb. Az ilyen folyamatok száma növekedett, és mára hatalmas kereslet alakult ki más típusú szakemberek iránt - Adatminőség mérnökök iránt - akik nyomon követték az adatok áramlását a rendszerben (data pipelines), az adatok minőségét a belépéskor és kilépéskor, következtetéseket vontak le elegendőségükről, épségükről és más jellemzőikről.
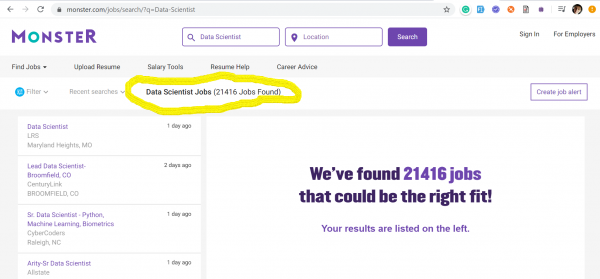
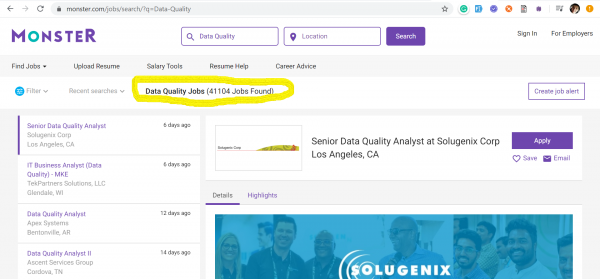
A Data Quality mérnökök iránti trend az Egyesült Államokból indult, ahol a virágzó kapitalizmus korában senki sem készül arra, hogy elveszítse a harcot az adatokért. Alább bemutatom a legnépszerűbb amerikai álláskereső oldalak képernyőképeit: és — amelyek 2020. március 17-i állapot szerint mutatják a Data Quality és Data Scientist kulcsszavakkal hirdetett állások számát.
Data Scientists – 21,416 állás
Data Quality – 41,104 állás
Data Scientists – 404 állás
Data Quality – 2,020 állás
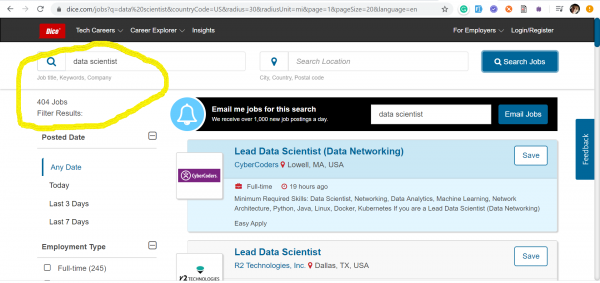
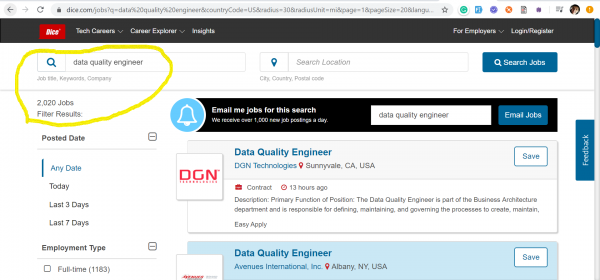
Nyilvánvaló, hogy ezek a szakmák semmilyen módon nem versenyeznek egymással. A képernyőképekkel csak szerettem volna illusztrálni a munkaerőpiac jelenlegi helyzetét a Data Quality mérnökök iránti keresletben, amely jelenleg sokkal nagyobb, mint a Data Scientists esetében.
2019 júniusában az EPAM reagálva a modern IT piac igényeire a Data Quality területét külön gyakorlattá alakította. A Data Quality mérnökök a mindennapi munkájuk során kezelik az adatokat, tesztelik azok viselkedését új körülmények között és rendszerekben, és ellenőrzik az adatok relevanciáját, elegendőségét és aktualitását. Ennek ellenére a Data Quality mérnökök valójában keveset szentelnek hagyományos funkcionális tesztelésre, DE ez erősen függ a projekttől (például később mutatok egy példát).
A Data Quality mérnök feladatköre nem korlátozódik pusztán a rutin manuális/automatizált ellenőrzésekre „nullák, számok és összegek” kategóriájában a DB táblákban, hanem mély megértést igényel a megrendelő üzleti igényeiről, és ennek megfelelően képesnek kell lennie az adott adatok üzleti információvá való átalakítására.
A Data Quality elmélete
Ahhoz, hogy a legteljesebb képet alkothassuk egy ilyen mérnök szerepéről, nézzük meg, mit is jelent a Data Quality elméletben.
Data Quality — a Data Management egyik szakasza (egy teljes világ, amelyet önállóan kell tanulmányoznia) és az adatok elemzéséért felelős a következő szempontok szerint:
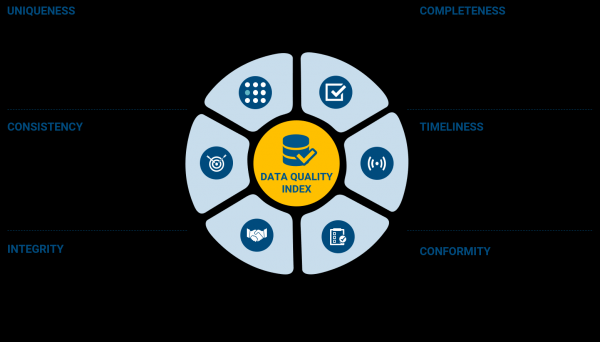
Nem hiszem, hogy minden egyes pontot szükséges kibővíteni (elméletileg azokat "adatdimenzióknak" hívják), ezek jól le vannak írva a képen. Azonban a tesztelési folyamat nem várt meg szigorú másolását ezen jellemzőknek a tesztelési esetekben és azok ellenőrzését. Az Adatminőség esetében, mint bármilyen más tesztelési formánál, először is a projekt résztvevőivel, a döntéshozókkal egyeztetett adatminőségi követelményekből kell kiindulni.
A Data Quality mérnök különböző funkciókat láthat el a projekttől függően: a felületes adatminőségi értékeléssel foglalkozó egyszerű automatizált tesztelőtől kezdve egészen addig, aki mély profilozást végez a fent említett jellemzők alapján.
Az Adatmenedzsment, Adatminőség és kapcsolódó folyamatok nagyon részletes leírása található a következő nevű könyvben „DAMA-DMBOK: Data Management Body of Knowledge: 2nd Edition”. Nagyon ajánlom ezt a könyvet bevezetésként a témába (a linket a cikk végén találja).
Az én történetem
Az IT iparban a Junior tesztelőtől a Lead Data Quality Engineerig vezettem az utat az EPAM cégnél. Körülbelül két évnyi tesztelői munka után biztos voltam abban, hogy mindenféle tesztelést elvégeztem: regressziós, funkcionális, stressz-, stabilitási, biztonsági, UI stb. — és kipróbáltam számos tesztelő eszközt, miközben három programozási nyelven dolgoztam: Java, Scala, Python.
Visszatekintve megértem, miért lett az én szakmai készségeim ilyen sokszínűek — olyan projektekben vettem részt, amelyek adatkezeléssel foglalkoztak, nagyokkal és kicsikkel. Ez vezetett a gyakorlatilag rengeteg eszközhöz és növekedési lehetőséghez.
Ahhoz, hogy értékelni tudjuk az eszközök sokféleségét és az új tudás és készségek megszerzésének lehetőségeit, elég, ha egyszerűen megnézzük az alábbi képet, amely a legnépszerűbbeket ábrázolja a „Data & AI” világában.
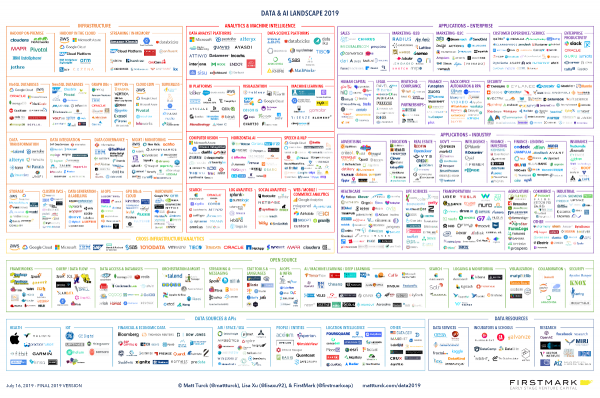
Az ilyen típusú illusztrációkat évente egy neves kockázati tőkebefektető, Matt Turck készít, aki a szoftverfejlesztésből származik. Itt van a blogja és , ahol partnereként dolgozik.
Különösen gyorsan fejlődtem, amikor egyedüli tesztelőként dolgoztam a projekten, vagy legalábbis a projekt kezdetén. Ilyenkor vállalnod kell az egész tesztelési folyamatot, nincs lehetőséged hátrálni, csak előre. Eleinte ez ijesztő volt, de most már egyértelműek számomra a kihívás előnyei:
- Soha nem kommunikálsz annyira a teljes csapattal, mivel nincs egyetlen közvetítő az interakciók során: sem tesztmenedzser, sem más tesztelők.
- A projektre való merülés rendkívül mély és minden komponensről átfogó és részletes információd van.
- A fejlesztők nem úgy néznek rád, mint a „tesztelő srácra, aki nem tudni mit csinál”, hanem inkább egyenrangú félként, aki jelentős hasznot hoz a csapatnak az automatikus tesztjeivel és a hibák előrejelzésével a termék egyes pontjain.
- Ennek eredményeként hatékonyabb, kvalifikáltabb és keresettebb leszel.
Ahogy a projekt bővült, 100%-ban mentorává váltam az új tesztelőknek, akik csatlakoztak, tanítottam őket, és átadtam azokat a tudásokat, amelyeket saját magam is elsajátítottam. Emellett, a projekt függvényében, nem mindig kaptam a legmagasabb szintű automatizálási szakembereket a vezetőségtől, és szükségem volt vagy őket automatizálásra tanítani (ha kedvük volt hozzá), vagy olyan eszközöket létrehozni, amelyeket a mindennapi tevékenységeik során használhatnak (adatgeneráló és feltöltő eszközök, eszköz a terhelési teszteléshez / stabilitás ellenőrzéséhez „gyorsan” stb.).
Egy konkrét projekt példája
Sajnos a titoktartási kötelezettségek miatt nem tudok részletesen beszélni a projektekről, amelyeken dolgoztam, de megadom egy tipikus Data Quality Engineer feladat példáit egy projekt keretein belül.
A projekt lényege - adatokat előkészítő platform létrehozása gépi tanulási modellek tanítása céljából. A megrendelő egy nagy amerikai gyógyszergyártó cég volt. Technikai szempontból ez egy klaszter , amely az példányain fut, több mikroszolgáltatással és az EPAM cég Open Source projektjével alapul - , melyet a konkrét megrendelő igényeihez alakítottak (jelenleg a projekt átalakul az ). Az ETL folyamatokat és az adatokat áthelyeztük az ügyfél rendszeréből a Buckets-be. Ezután egy gépi tanulási modell Docker képe került telepítésre a platformra, amely az új adatokon tanult, és a REST API interfészen keresztül adta meg a vállalkozást érdeklő előrejelzéseket, amelyek konkrét feladatokat oldottak meg.
Képileg körülbelül így nézett ki:
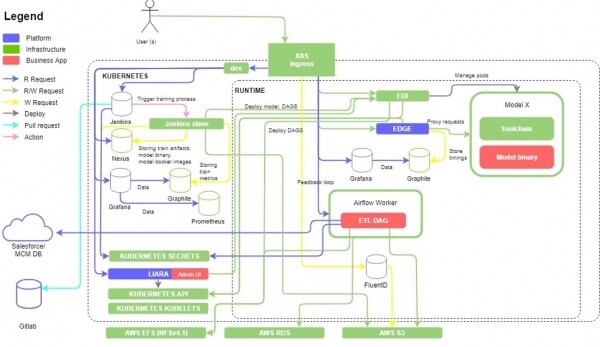
A funkcionális tesztelésből ezen a projekten bőséges mennyiség állt rendelkezésre, és figyelembe véve a funkciók fejlesztésének sebességét, valamint a kiadási ciklus fenntartásának szükségességét (kéthetes sprintek), már az elején gondolkodni kellett a legkritikusabb rendszerkomponensek automatizált teszteléséről. A platform nagy része, amely Kubernetes alapú, automatizált tesztekkel volt lefedve, amelyeket a + Python nyelv segítségével valósítottak meg, azonban ezeket fenntartani és bővíteni is kellett. Ezen kívül, az ügyfél kényelme érdekében, létrehoztak egy GUI-t a gépi tanulási modellek kezelésére, amelyeket a klaszterre telepítettek, valamint lehetőséget adtak arra, hogy megadják, honnan és hova szükséges áthelyezni az adatokat a modellek tanításához. Ez a széleskörű kiegészítés automatikus funkcionális ellenőrzések kiterjesztését vonzotta magával, amelyeket többnyire REST API hívásokon és néhány end-to-end UI teszten keresztül végeztek. Körülbelül az egész folyamat közepén csatlakozott hozzánk egy manuális tesztelő, aki nagyszerűen teljesítette a termék verzióinak elfogadási tesztelését és a kapcsolatot az ügyféllel az újabb kiadás átvételéről. Ezen kívül, az új szakember megjelenésével dokumentálni tudtuk a munkánkat, és hozzáadtunk néhány nagyon fontos manuális ellenőrzést, amelyet nehéz volt azonnal automatizálni.
Végül, miután elértük a stabilitást a platformon és a GUI réteg fölött, nekiláttunk az ETL folyamatok felépítésének az Apache Airflow DAG-ok segítségével. Az adatminőség automatizált ellenőrzése egyedi Airflow DAG-ok írásával valósult meg, amelyek ellenőrizték az ETL folyamat eredményeit. A projekt keretein belül szerencsénk volt, és az ügyfél hozzáférést biztosított számunkra névtelenített adatbázisokhoz, amelyeken teszteltünk. Ellenőriztük az adatokat soronként a típusoknak való megfelelés, a sérült adatok előfordulása, az összes rekord száma az előzetes és utáni állapot szerint, az ETL folyamat által végzett aggregációs transzformációk, a változó oszlopnevek stb. összehasonlításával. Ezen kívül ezeket az ellenőrzéseket különböző adatforrásokra is kiterjesztettük, például a SalesForce mellett MySQL-ra is.
Az adatvégső minőségi ellenőrzéseket már az S3 szinten hajtották végre, ahol az adatok tárolódtak és készen álltak a gépi tanulás modellek betanításához. Az adatok nyerésére a végső CSV fájlból, amely az S3 tárolóban volt, és azok validálására kódot írtunk a .
A megrendelő részéről az is elvárás volt, hogy az adatok egy része egy S3 tárolóban, másik része pedig egy másikban legyen tárolva. Ehhez további ellenőrzéseket is meg kellett írni, amelyek figyelemmel kísérték a szortírozás hitelességét.
Általános tapasztalat más projektekről
A Data Quality mérnök legátfogóbb tevékenységeinek például a következőket tartalmazhatják:
- Tesztadatok előkészítése (érvényes, érvénytelen, nagy, kicsi) automatizált eszközön keresztül.
- A kész adatállományt betölteni az eredeti forrásba, és ellenőrizni a használhatóságát.
- ETL folyamatok indítása az adatállomány feldolgozására az eredeti tárolóból végleges vagy átmeneti használatra, bizonyos beállítások alkalmazásával (ha lehetséges konfigurálható paraméterek megadása az ETL feladat számára).
- A feldolgozott ETL folyamat által előállított adatok minőségének és a üzleti követelményeknek való megfelelőségének ellenőrzése.
A fő hangsúlynak nemcsak azon kell lennie, hogy az adatfolyam a rendszerben egyáltalán működött és eljutott a végéig (ami a funkcionális tesztelés része), hanem elsősorban az adatok ellenőrzésére és validálására kell irányulnia az elvárt követelményeknek való megfelelés, anomáliák felderítése és más szempontok szempontjából.
Eszközök
Az ilyen adatok ellenőrzésének egyik technikája lehet a láncellenőrzések megszervezése az adatfeldolgozás minden szakaszában, úgynevezett „data chain” — az adatok ellenőrzése a forrástól a végső felhasználás helyéig. Az ilyen típusú ellenőrzéseket leggyakrabban SQL lekérdezések írásával valósítják meg. Nyilvánvaló, hogy ezeknek a lekérdezéseknek a lehető legkönnyedebbnek kell lenniük, és egyes adatminőségi elemeket kell ellenőrizniük (táblák metaadatai, üres sorok, NULL, szintaxis hibák — egyéb szükséges attributumok ellenőrzése).
A regressziós tesztelés esetében, amelyben már meglévő (nem módosítható, csak kis mértékben módosítható) adathalmazon alapul, az automatikus tesztek kódjában már készen álló adatellenőrzési sablonok tárolhatók a minőség megfelelőségére (a táblák elvárt metaadatai; az olyan sorok, amelyek véletlenszerűen válaszhatók ki a teszt során, és egyebek).
A tesztelés során tesztelési ETL-folyamatokat is kell írnunk, olyan keretrendszerek segítségével, mint az Apache Airflow, vagy akár egy black-box felhőeszköz, mint a , és mások. Ez a körülmény arra kényszeríti a tesztmérnököt, hogy mélyebben megismerje a fenti eszközök működési elveit, és még hatékonyabban végezze el a funkcionális tesztelést (például a projektben lévő ETL-folyamatokhoz) és használja azokat az adatok ellenőrzésére. Különösen az Apache Airflow-hoz már készen álló operátorok állnak rendelkezésre népszerű analitikai adatbázisokkal való munkához, például . A legalapvetőbb példája a használatának már le van írva, ezért nem fogom megismételni.
A kész megoldásokon kívül senki nem tilthatja meg, hogy saját technikákat és eszközöket valósítsanak meg. Ez nemcsak a projektnek lesz haszna, hanem a Data Quality Engineer számára is, aki így fejlesztheti technikai látókörét és kódolási készségeit.
Hogyan működik ez egy valós projektben
A legjobb példa az utolsó bekezdésekre a „data chain”, ETL és a mindennapos ellenőrzések témájában a következő folyamat egy valós projektből:
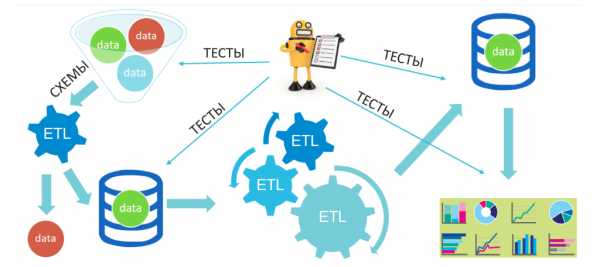
Itt a rendszerünkhöz beérkező „ tölcsérbe” különféle adatokat kapunk (természetesen általunk előkészítve): érvényes, érvénytelen, kevert stb., majd ezek szűrve kerülnek egy köztes tárolóba, ahol újabb átalakítások várják őket, végül a végső tárolóba kerülnek, ahonnan az elemzés, az adatház építése és az üzleti meglátások keresése történik. Egy ilyen rendszerben, anélkül, hogy funkcionálisan ellenőriznénk az ETL folyamatok működését, arra összpontosítunk, hogy az adatok minőségét a transzformációk előtt és után, valamint az analitikába történő kibocsátásukat figyeljük.
Összefoglalva az elmondottakat, függetlenül attól, hogy hol dolgoztam, mindenhol részt vettem olyan Data projekteken, amelyek az alábbi jellemzőkkel rendelkeztek:
- Csak az automatizáció révén lehet ellenőrizni bizonyos eseteket és elérni az üzlet számára elfogadható kiadási ciklust.
- Egy ilyen projekten a tesztelő a csapat egyik legjobban megbecsült tagja, mivel óriási hasznot hoz a csapat minden tagjának (a tesztelés felgyorsítása, jó adatok a Data Scientist számára, hibák észlelése a korai szakaszban).
- Nem számít, hogy saját vasadon dolgozol vagy felhőben — minden erőforrás egy Hortonworks, Cloudera, Mesos, Kubernetes típusú klaszterbe van absztrahálva stb.
- A projektek mikro-szerviz alapú megközelítéseken épülnek, a párhuzamos és elosztott számítások dominálnak.
Megjegyzem, hogy a Data Quality tesztelésével foglalkozó tesztelő szakember szakmai fókusza a termék kódjára és a használt eszközökre helyeződik.
A Data Quality tesztelés jellemzői
Ezen kívül a következő, nagyon általános (és kizárólag szubjektív) jellemzőket emeltem ki a Data (Big Data) projekteken (rendszereken) történő tesztelés és más területek tesztelése között:
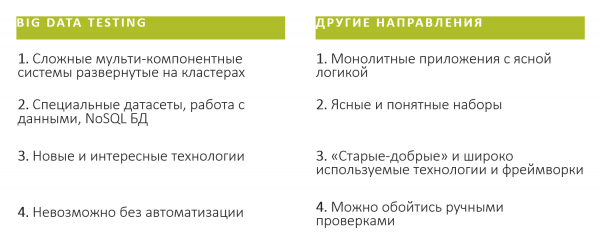
Hasznos linkek
- Elmélet: .
- EPAM
- Ajánlott anyagok kezdő Data Quality mérnökök számára:
- Ingyenes kurzus a Stepik-en: .
- Kurzus a LinkedIn Learning-en: .
- Cikkek:
- ;
- ;
- ;
- Videó:
- ;
- ;
Zárás
Data Quality — ez egy nagyon fiatal, ígéretes terület, amelynek része lenni annyit jelent, mint egy startup részesévé válni. A Data Quality révén számos modern, keresett technológiába merülhet el, de a legfontosabb, hogy hatalmas lehetőségek nyílnak meg az ötletei generálására és megvalósítására. A folyamatos fejlesztési megközelítést nemcsak a projekt során, hanem a saját fejlődése érdekében is alkalmazhatja, szakemberként folyamatosan fejlődve.
Forrás: habr.com
