

Javaslom, hogy ismerkedjen meg Andrej Szalnyikov 2016 eleji előadásának a "PostgreSQL-ben bloat-ot okozó tipikus hibák" című megvalósításával.
Ebben az előadásban a leggyakoribb hibákat fogom elemezni, amelyek a tervezési és a kódolási szakaszban előfordulnak. Csak azokat a hibákat emelem ki, amelyek bloat-ot okoznak a PostgreSQL-ben. Általában ezek a teljes rendszer teljesítményének kezdetét jelentik, miközben kezdetben nem mutattak előjelet.
Örömmel üdvözlök mindenkit! Ez az előadás nem annyira technikai, mint a kollégám előzője. Ez az előadás főként a backend rendszerek fejlesztőire fókuszál, mivel nagy számú ügyfelünk van. Mindannyian ugyanazokat a hibákat követik el. Ezekről fogok beszélni. Elmagyarázom, hogy ezek a hibák milyen súlyos következményekkel járhatnak.
Miért követnek el hibákat? Két okból történnek: először is, a szerencsére támaszkodva, hátha működik, illetve az ismeretlen mechanizmusok miatt, amelyek a rendszer és az alkalmazás között, valamint magában az adatbázisban zajlanak.
Három példát fogok bemutatni borzalmas grafikákkal arról, hogyan történt a romlás. Röviden bemutatom a mögöttes mechanizmust, mi történik, hogyan lehet kezelni a problémákat, amikor felmerülnek, és milyen megelőző módszereket érdemes alkalmazni a hibák elkerülésére. Beszélek a segédeszközökről is, és hasznos linkeket adok.
Tesztadatbázist használtam, amelyben két tábla volt. Az egyik a klienti számlákat, a másik pedig a számlákhoz kapcsolódó tranzakciókat tartalmazza. Valamilyen időközönként frissítjük ezeken a számlákon a fennmaradó összegeket.
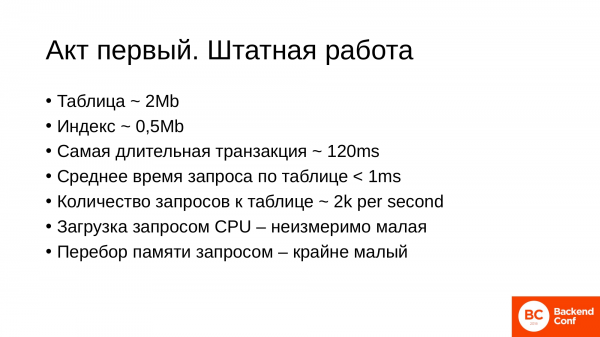
A táblázat kiindulási adatai: elég kicsi, 2 MB. Az adatbázis és a konkrét táblázat válaszideje is nagyon jó. Az átlagos terhelés – 2000 tranzakció másodpercenként a táblázaton.
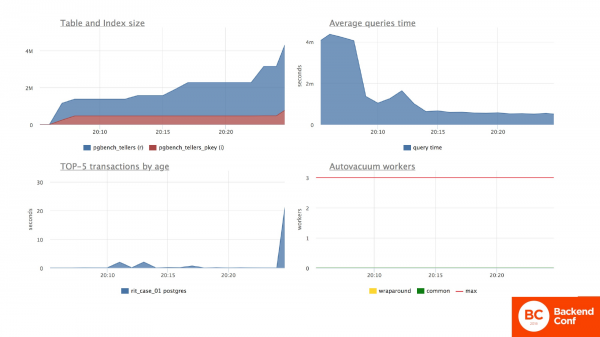
Ez az előadás során grafikonokat fogok bemutatni, hogy szemléletes legyen, mi történik. Mindig lesz két dián grafikon. Az első dia a szerveren zajló általános eseményeket mutatja be.
Ebben a helyzetben valóban látjuk, hogy a táblázat kicsi méretű. Az index is kicsi, 2 MB. Ez az első grafikon balról.
A szerver átlagos válaszideje is stabil és alacsony. Ez a jobb felső grafikon.
A bal alsó grafikon a leghosszabb tranzakciókat mutatja. Látjuk, hogy a tranzakciók gyorsan végrehajtódnak. Az autovákum még nem működik itt, mert ez egy kezdeti teszt volt. Később működni fog, és hasznos lesz számunkra.
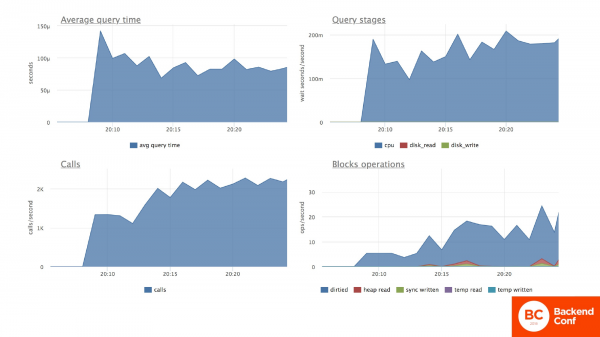
A második diát mindig a vizsgált táblázatnak szenteljük. Ebben a helyzetben folyamatosan frissítjük az ügyfélnél lévő egyenlegeket. Azt látjuk, hogy az átlagos válaszidő a frissítési művelethez elég jó, kevesebb mint egy milliszekundum. Látjuk azt is, hogy a processzor erőforrásai (ez a jobb felső grafikon) egyenletesen és viszonylag alacsonyan kerülnek felhasználásra.
A jobb alsó grafikon azt mutatja, hogy mennyi operatív és diszk memória áll rendelkezésünkre, mielőtt megkeressük a szükséges sort, mielőtt frissítjük. Az operációk száma a táblázaton – 2000 másodpercenként, ahogy az elején mondtam.
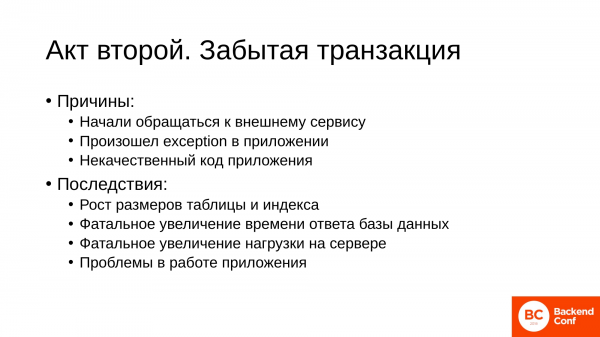
És most tragédia történik. Valamilyen okból hosszú, elfeledett tranzakció lép fel. Az okok általában elég banálisak:
- Az egyik leggyakoribb ok, hogy a programkódunk elkezdett kapcsolatba lépni egy külső szolgáltatással. És ez a szolgáltatás nem válaszol. Azaz, megnyitottunk egy tranzakciót, változást hajtottunk végre az adatbázisban, és elmentünk az alkalmazásból e-maileket olvasni vagy egy másik szolgáltatáshoz létrejött kapcsolat keretein belül, és valamilyen okból nem válaszol. Így a munkamenetünk egy olyan állapotba kerül, amelyből nem tudjuk, mikor oldódik meg.
- A másik helyzet, amikor a kódban valamilyen okból kivétel lép fel. És a kivételt nem kezeltük le a tranzakció bezárásához. Így egy lógó munkamenetünk marad egy nyitott tranzakcióval.
- A harmadik pedig egy elég gyakori eset: a rossz minőségű kód. Néhány keretrendszer megnyit egy tranzakciót. Az lóg, és lehet, hogy az alkalmazásban nem tudod, hogy lóg.
Mik ezek a dolgok, hová vezetnek?
Arra, hogy a táblázatok és indexek hirtelen megnőnek. Ez éppen az a bloat hatás. Az adatbázis számára ez azt jelenti, hogy drámai módon megnő az adatbázis válaszideje, nő a terhelés az adatbázis szerverén. Ennek eredményeként az alkalmazás szenvedni fog. Mert ha a kódban 10 milliszekundumot költöttél az adatbázis lekérdezésére, 10 milliszekundumot a logikádra, akkor a funkció 20 milliszekundum alatt végzett. Most viszont sokkal szomorúbb helyzetbe kerülsz.
Nézzük meg, mi történik. A bal alsó grafikon azt mutatja, hogy hosszú tranzakciónk van. A bal felső grafikonon pedig láthatjuk, hogy a táblázat mérete két megabájtról hirtelen háromszáz megabájtra ugrik. Eközben az adatok mennyisége a táblázatban változatlan maradt, tehát ott sok a felesleges adat.
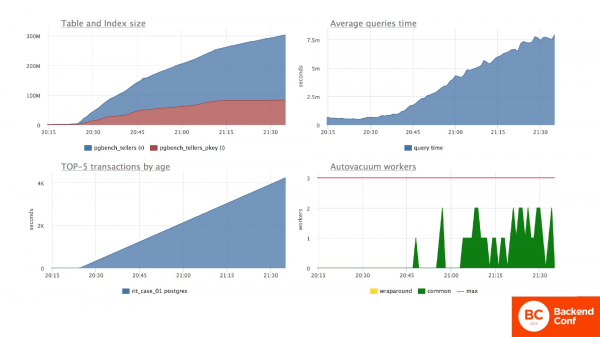
Az általános helyzet a szerver átlagos válaszidejével is több nagyságrendet változott. Azaz, az összes kérés a szerverhez jelentősen lelassult. Eközben a Postgres belső folyamatai, mint például az automatikus takarítás, elindultak, próbálnak valamit tenni és erőforrást fogyasztanak.
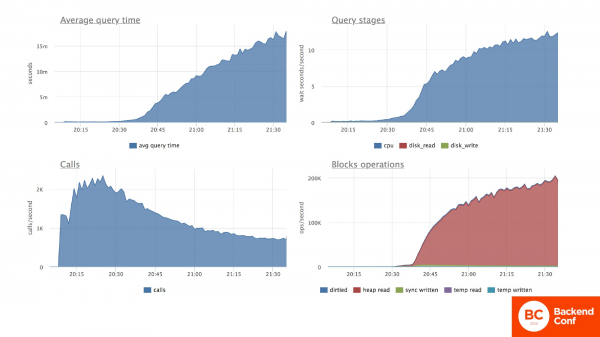
Mi történik a táblázatunkkal? Ugyanez. A táblázat átlagos válaszideje több nagyságrendet emelkedett. Ha konkrétan az erőforrás-fogyasztásra nézünk, akkor azt látjuk, hogy jelentősen megnőtt a processzorra nehezedő terhelés. Ez a jobb felső grafikon. Ennek oka, hogy a processzornak rengeteg felesleges sort kell átnéznie, hogy megtalálja az egy szükségeset. Ez a jobb alsó grafikon. Ennek eredményeként a másodpercenkénti hívások száma szignifikánsan csökkent, mert az adatbázis nem képes azonos számú kérés feldolgozására.
Vissza kell térnünk az életbe. Bejegyzünk az internetre, és megtudjuk, hogy a hosszú tranzakciók problémát okoznak. Megkeressük és megszüntetjük ezt a tranzakciót. És minden visszaáll a normális kerékvágásba. Minden úgy működik, ahogy kell.
Megnyugodtunk, de néhány idő elteltével elkezdjük észrevenni, hogy az alkalmazás nem úgy működik, mint a vészhelyzet előtt. A kérelmek továbbra is lassabban feldolgozódnak, méghozzá jelentősen lassabban. Az én példámban másfél-kétszer lassabban. A szerver terhelése is magasabb, mint a vészhelyzet előtt volt.
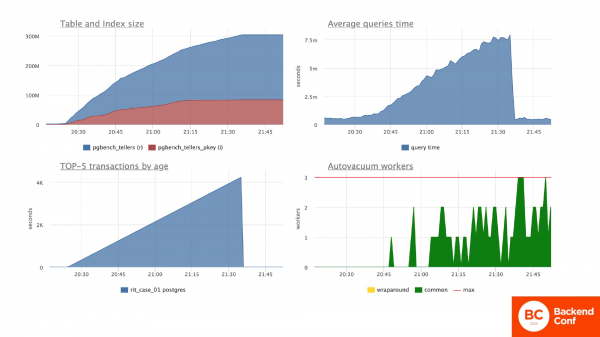
A kérdés: „Mi történik az adatbázissal ebben az időszakban?”. Az adatbázissal a következő helyzet zajlik. A tranzakciók grafikonján látható, hogy leállt, és valóban nincsenek hosszú tranzakciók. De a táblázat mérete vészhelyzet alatt drasztikusan megnőtt. Azóta nem csökkent. Az adatbázis átlagos ideje stabilizálódott. A válaszok pedig úgy tűnik, hogy megfelelő sebességgel áramlanak. Az automatikus takarítás aktívabbá vált és elkezdett valamit tenni a táblázattal, mert több adat feldolgozása szükséges.
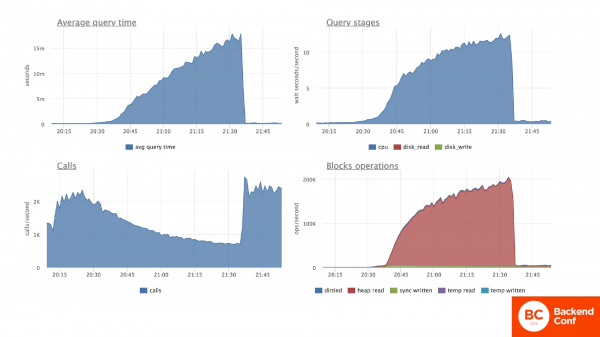
A konkrétan a vizsgált táblázatra vonatkozóan, ahol a maradványokat módosítjuk: a válaszidő a lekérdezésre látszólag normalizálódott. De valójában másfél szor magasabb.
A processzorterhelés szempontjából láthatjuk, hogy a terhelés nem tért vissza a baleset előtti megfelelő szintre. Az okok a jobb alsó grafikonban rejlenek. Látszik, hogy ott a memória egy bizonyos mennyiségének a feldolgozása történik. Vagyis a szükséges sor kereséséhez a szerver adatbázisának erőforrásait pazaroljuk haszontalan adatok feldolgozására. A másodpercenkénti tranzakciók száma stabilizálódott.
Összességében jó, de a helyzet rosszabb, mint volt. Nyilvánvaló degradáció történt az adatbázisban, ami annak a következménye, hogy az alkalmazásunk ezzel az adatbázissal dolgozik.
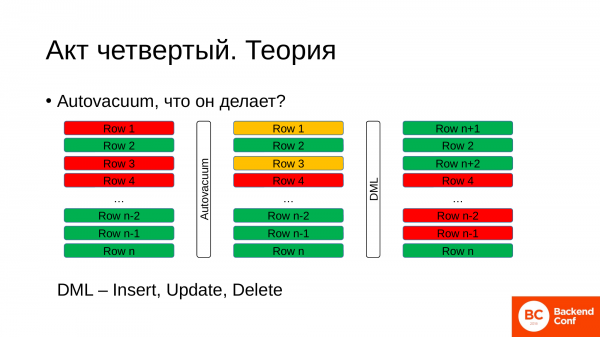
És hogy kiderítsük, mi történik ott, ha nem voltál a korábbi előadáson, itt van egy kis elmélet. Az elmélet a belső folyamatról. Mire való az autovákum, és mit csinál?
Röviden az érthetőség kedvéért. Valamikor van egy táblázatunk. A táblázatban sorok vannak. Ezek a sorok lehetnek aktívak, élőek, és most szükségünk van rájuk. A képen zöld színnel vannak jelölve. Vannak „halott” sorok is, amelyek már feldolgozódtak, frissültek, új bejegyzések keletkeztek róluk. Ezeket úgy jelölik, hogy már nem érdeklik az adatbázist. De a Postgres sajátosságai miatt még mindig a táblázatban maradnak.
Miért van szükség az autovákumra? Az autovákum egy pillanatban eljön, megkeresi az adatbázist, és ezt kérdezi: "Kérlek, add meg a legöregebb tranzakció azonosítóját, amely jelenleg nyitva van az adatbázisban." Az adatbázis visszaadja ezt az azonosítót. Az autovákum ezen az alapon végigvizsgálja a táblázat sorait. És ha látja, hogy bizonyos sorok módosítottak régebbi tranzakciók által, akkor jogot formálhat arra, hogy ezeket a sorokat kijelölje, mint amelyeket a jövőben újra felhasználhatunk új adatok írásához. Ez egy háttérfolyamat.
Ebben az időben továbbra is dolgozunk az adatbázissal, folytatunk valamilyen módosítást a táblázatban. És ezekre a sorokra, amelyeket újra felhasználhatunk, új adatokat írunk. Így folyamatosan keletkeznek újabb halott régi sorok, amelyeket lecserélünk az újonnan szükséges sorokra. Ez a PostgreSQL normális működési állapota.
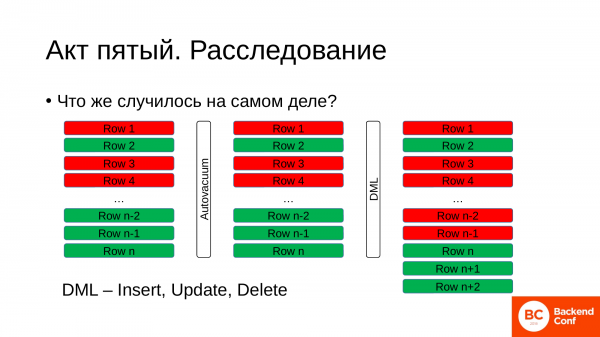
Mi történt a baleset során? Hogyan zajlott ez a folyamat?
Volt egy táblázatunk valamilyen állapotban, néhány sor élő, néhány halott. Jött az automatikus takarító. Megkérdezte az adatbázist, hogy mi a legidősebb tranzakciónk, mi a hozzá tartozó azonosítója. Megkapta ezt az azonosítót, amely lehet órákkal ezelőtt történt, vagy akár tíz perccel ezelőtt. Ez attól függ, hogy mennyire van terhelve az adatbázisunk. Aztán elkezdett keresni olyan sorokat, amelyeket újra felhasználhat. De nem talált ilyet a táblázatunkban.
De közben továbbra is dolgozunk a táblázaton. Valamit csinálunk benne, frissítjük, módosítjuk az adatokat. Mi történik eközben az adatbázissal? Nincs más választása, mint új sorokat írni a meglévő táblázat végére. Ezzel a táblázatunk mérete elkezd megnőni.
Valójában zöld sorokra van szükségünk a munkához. De egy ilyen probléma során előfordul, hogy a zöld sorok aránya rendkívül alacsony az egész táblázatban.
Amikor végrehajtunk egy lekérdezést, az adatbázisnak végig kell mennie az összes soron: a piros és a zöld sorokon is, hogy megtalálja a szükséges sort. Az adatok felesleges bloat-ja, amely elherdálja a lemeztárolónkat, azt jelenti, hogy emlékezzen, hogy volt 2 MB, lett 300 MB? Most pedig cserélje le a megabájtokat gigabájtokra, és elég gyorsan el fogja veszíteni az összes lemeztároló erőforrását.
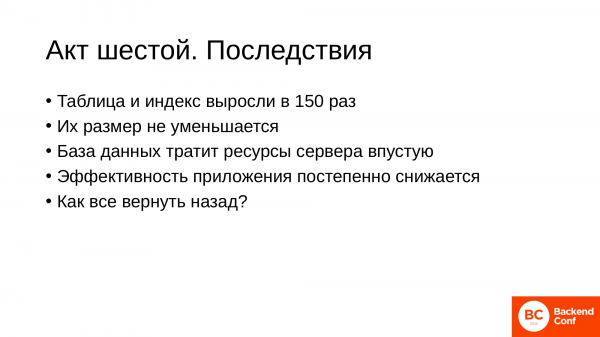
Mik lehetnek a következmények számunkra?
- Az én példámban a táblázat és az index 150-szeresére nőtt. Néhány ügyfelünknél sokkal drámaibb esetek voltak, amikor a lemezhely egyszerűen elkezdett kifogyni.
- A táblázatok mérete önmagában soha nem csökken. Az automatikus takarító egyes esetekben levághatja a táblázat végét, ha ott csak halott sorok vannak. De mivel folyamatosan rotálódik, egy zöld sor a végén ragadhat és nem frissülhet, míg a többi sor valahol a táblázat elején lesz beírva. De ez egy annyira valószínűtlen esemény, hogy nem érdemes remélni, hogy a táblázat mérete csökken.
- Az adatbázisnak át kell néznie az összes felesleges sort. Ezáltal disk erőforrásokat, CPU erőforrásokat és energiafogyasztást pazarolunk.
- Ez közvetlenül hatással van az alkalmazásunkra, mert ha kezdetben 10 milliszekundumot töltöttünk el a lekérdezésre, 10 milliszekundumot a kódunkra, akkor a hiba idején 1 másodpercet költöttünk a lekérdezésre és 10 milliszekundumot a kódra, tehát az alkalmazás teljesítménye a töredékére esett vissza. Amikor a hibát megszüntettük, 20 milliszekundumra emelkedett a lekérdezés ideje és 10 milliszekundumra a kódé. Ez azt jelenti, hogy továbbra is másfél szoros teljesítménycsökkentéssel néztünk szembe. Mindez egyetlen tranzakció miatt történt, ami megakadt, lehet, hogy a mi hibánkból.
- A kérdés: "Hogyan állíthatjuk vissza mindent?", hogy minden jól menjen és a lekérdezések olyan gyorsan fussanak, mint a hiba előtt.
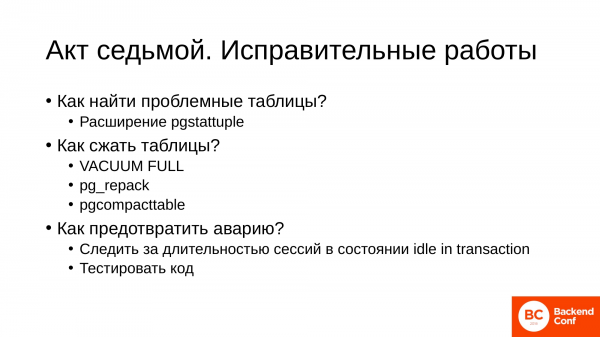
Ehhez van egy meghatározott munkafolyamat, amelyet végre kell hajtani.
Először meg kell találnunk a problémás táblákat, amelyek megnövekedtek. Értelemszerűen vannak olyan táblák, ahol a beírás aktívabb, és vannak, ahol kevésbé. És ehhez használható a kiterjesztés . E kiterjesztés telepítésével olyan lekérdezéseket írhat, amelyek segítenek megtalálni a jelentősen megnövekedett táblákat.
Miután megtalálta ezeket a táblákat, azokat tömöríteni kell. Erre már léteznek eszközök. A vállalatunk három eszközt használ. Az első a beépített VACUUM FULL. Ez kemény, szigorú és könyörtelen, de néha nagyon hasznos. és – harmadik féltől származó eszközök a táblák tömörítéséhez. Ezek kímélőbbek az adatbázissal szemben.
Ezek attól függően használhatók, hogy mi a kényelmesebb az Ön számára. De erről a legvégén fogok beszélni. A legfontosabb, hogy három eszköz áll rendelkezésre. Van miből választani.
Miután mindent rendbe hoztunk és megbizonyosodtunk arról, hogy minden jól működik, tudnunk kell, hogyan lehet megakadályozni, hogy ez a helyzet a jövőben előforduljon:
- Ez viszonylag könnyen megelőzhető. Figyelni kell a Master-szerveren a munkamenetek időtartamára. Különösen veszélyesek az idle in transaction állapotú munkamenetek. Ezek azok, amelyek éppen tranzakciót nyitottak, valamit tettek, majd elmentek, vagy egyszerűen megakadtak, elvesztek a kódban.
- Fejlesztőként fontos, hogy teszteljék a kódot olyan helyzetek előfordulásakor. Ez nem nehéz feladat. Egy hasznos ellenőrzést fog végezni. Elkerülhetik a hosszú tranzakciókkal kapcsolatos számos "gyerekbetegséget".
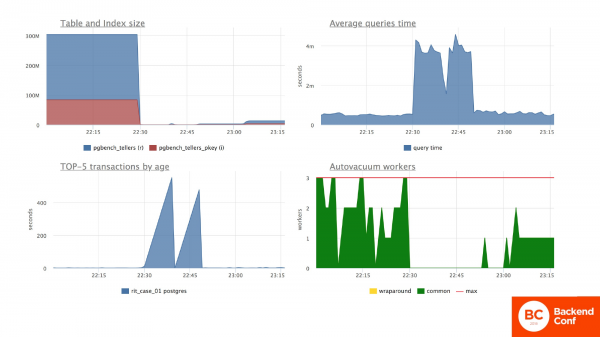
Ezeken a grafikonokon meg akartam mutatni, hogyan változott meg a táblázat és az adatbázis viselkedése, miután a VACUUM FULL műveletet végrehajtottam a táblázaton. Ez nem a produkciós adatbázisom.
A tábla mérete azonnal visszatért a normális működési állapotába, pár megabájtra. Ez nem befolyásolta különösebben a szerver átlagos válaszidejét.
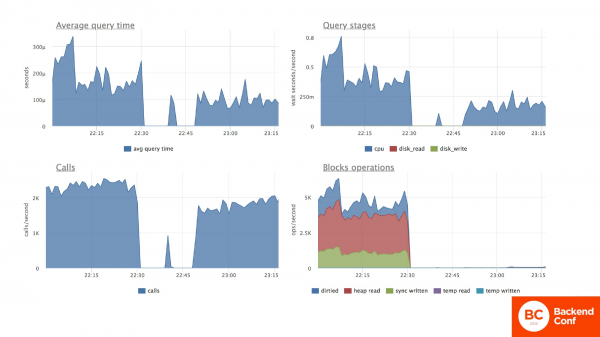
De konkrétan a tesztelt táblázatunk esetében, ahol frissítettük a számlák egyenlegét, látható, hogy az átlagos válaszidő a táblázaton belüli adatok frissítése során csökkent a korábbi szintre. A kérés teljesítésére felhasznált CPU-erőforrások is visszaestek a korábbi szintre. A jobb alsó grafikon pedig azt mutatja, hogy most azonnal megtaláljuk azt a sorozatot, amely szükséges számunkra, anélkül, hogy a táblázat tömörítése előtt lévő halott sorokat kellene átnézni. Az átlagos kérésidők nagyjából ugyanazon a szinten maradtak. De itt inkább a hardverem hibájáról van szó.
Ezzel véget ért az első történet. Ez a leggyakoribb eset, és mindenkivel megtörténik, függetlenül a kliens tapasztalatától vagy a programozók képesítéseitől. Előbb-utóbb biztosan bekövetkezik.
A második történet, ahol elosztjuk a terhelést és optimalizáljuk a szerver erőforrásait.
- Már megnőttünk és komoly fiúk lettünk. Megértettük, hogy van egy replikánk, és jó lenne egyensúlyozni a terhelést: az adatokat a Masterre írni, és a replikáról olvasni. Ez a helyzet általában akkor merül fel, amikor jelentéseket vagy ETL-t szeretnénk készíteni. A business ennek nagyon örül. Szeretnének sokféle jelentést különböző bonyolult elemzésekkel.
- A jelentések órákig tartanak, mert a bonyolult elemzést nem lehet milliárdos gyorsasággal kiszámítani. Mi, mint vidám fiúk, kódot írunk. Az alkalmazásban végrehajtunk egyesítéseket, hogy az adatokat a Masterre írjuk, a jelentéseket pedig a replikán végezzük.
- Elosszuk a terhelést.
- Minden jól működik. Ügyesek vagyunk.
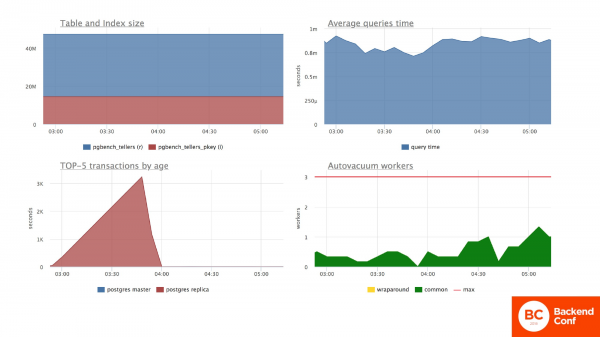
És hogyan néz ki ez a helyzet? Ezeken a grafikonokon kifejezetten a tranzakciók időtartama mellett a replikáról származó tranzakciók időtartamát is hozzáadtam. Minden más grafikon kizárólag a Master szerverhez tartozik.
A jelentések táblázata eddig növekedett. Több lett belőlük. Látjuk, hogy a szerver válaszideje stabil. Látjuk, hogy a replikánk egy hosszú tranzakciót futtat, ami már 2 órája tart. Látjuk, hogy az autovakuum nyugodtan dolgozik, ami a törölt sorokat kezeli. Minden rendben van nálunk.
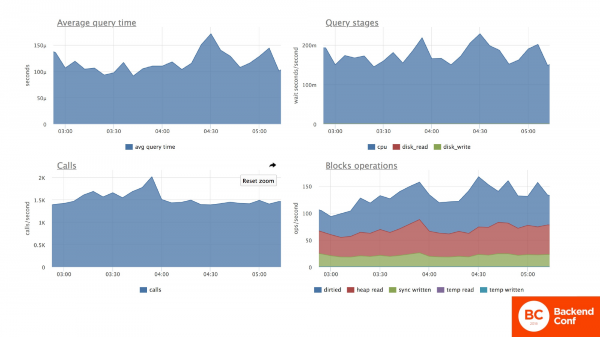
A konkrét vizsgált táblázatra vonatkozóan folytatjuk a számlák egyenlegének frissítését. És nálunk is stabil a válaszidő a lekérdezésekre, stabil erőforrás-felhasználás. Minden rendben van nálunk.
Minden jól van addig, amíg ezek a jelentések nem kezdenek konfliktusba ütközni a replikációval. És ezek rendszeres időközönként megjelennek.
Belesünk az internetre, és elkezdjük olvasni, hogy miért történik ez. És megtaláljuk a megoldást.
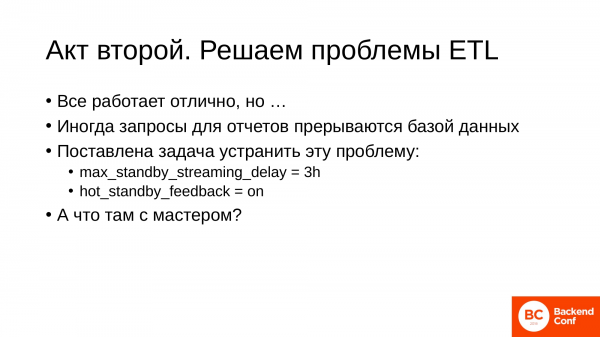
Az első megoldás - megnövelni a replikációs késleltetést. Tudjuk, hogy a jelentés 3 órán át fut. Beállítjuk a replikációs késleltetést - 3 órára. Minden elindítunk, de akkor is továbbra is problémáink vannak azzal, hogy a jelentések néha megszakadnak.
Azt akarjuk, hogy minden tökéletes legyen. Tovább keresgélünk, és találunk egy remek beállítást az interneten - hot_standby_feedback. Bekapcsoljuk. A hot_standby_feedback lehetővé teszi számunkra, hogy fenntartjuk az autovakuum munkáját a Mester szerveren. Ezzel teljesen megszabadulunk a replikációs konfliktusoktól. Minden jól működik a jelentéseinkkel.
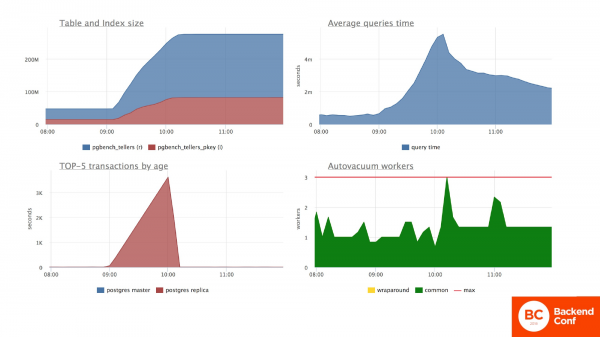
De mi történik közben a Mester szerverrel? A Mester szerveren totális katasztrófa zajlik. Most a grafikonokat figyeljük, amikor mindkét beállítást bekapcsoltam. És látjuk, hogy a replikán lévő session valamilyen módon befolyásolja a Mester szerver helyzetét. Valóban befolyásolja, mert leállította az autovakuumot, ami a törölt sorokat tisztítja. A táblázat mérete újra az egekbe szökött. Az összes lekérdezés átlagos végrehajtási ideje az adatbázison szintén az egekbe szökött. Az autovakuumok kicsit megfeszültek.
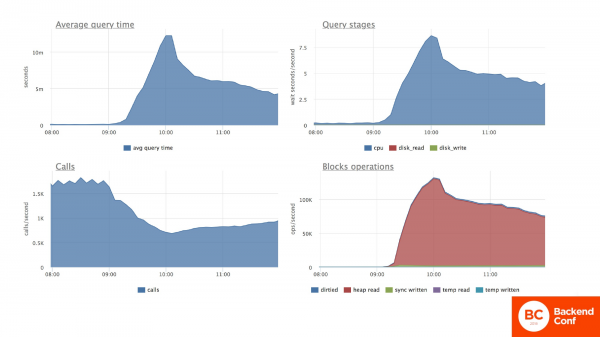
Konkrétan a mi táblázatunkkal látjuk, hogy a benne lévő adatok frissítése is az egekbe szökött. A CPU erőforrás-felhasználás is jelentősen megnövekedett. Ismét egy nagy mennyiségű haszontalan törölt sorokat nézünk át. És ezen a táblázaton a válaszidő és a tranzakciók száma csökkent.
Hogyan fog ez kinézni, ha nem tudjuk, miről beszéltem előtte?
- Kezdjük el keresni a problémákat. Ha az első részben problémákkal szembesültünk, tudjuk, hogy ez lehet a hosszú tranzakciók miatt, és a Mesterhez nyúlunk. A probléma nálunk a Mester oldalon van. Zakatol. Fűt, a Load Average pedig a százhoz közelít.
- Ott lassulnak a kérések, de nem látunk semmilyen hosszú tranzakciót. És nem értjük, mi a probléma. Nem tudjuk, hol keressünk.
- Ellenőrizzük a szerverhardvert. Előfordulhat, hogy a RAID elromlott. Talán az egyik memória modulunk meghibásodott. Bármi lehet. De nem, a szerverek újak, minden jól működik.
- Mindenki rohangál: az adminisztrátorok, a fejlesztők és a vezető. Semmi sem segít.
- És egy pillanatban minden váratlanul elkezd helyreállni.
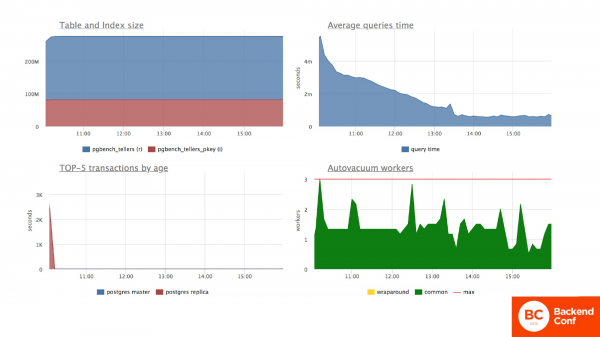
A replikánk eközben egy kérés végrehajtódott és elment. Megkaptuk a jelentést. Az üzlet még mindig elégedett. Ahogy látjuk, a táblázatunk újra megnőtt és nem szándékozik csökkenni. A munkamenetek grafikonján hagytam egy darabot erről a hosszú tranzakcióról a replikáról, hogy láthassátok, mennyi idő telik el, míg a helyzet stabilizálódik.
A munkamenet elment. És csak egy idő után a szerver többé-kevésbé helyreáll. Az átlagos válaszidő a kérésekhez a Mester szerveren normalizálódik. Mert végre az automatikus takarítás lehetőséget kapott arra, hogy eltávolítsa, megjelölje ezeket a holt sorokat. És elkezdte végezni a munkáját. És amilyen gyorsan végzi, olyan gyorsan kerülünk helyre.
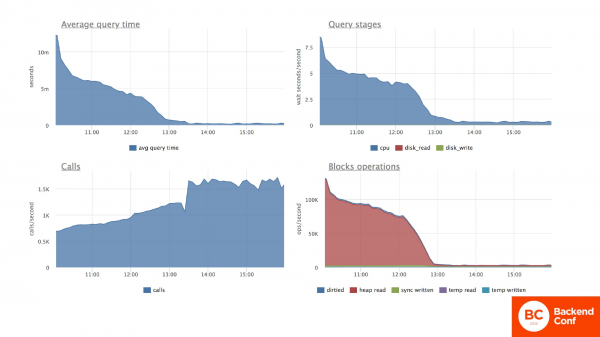
Az érintett táblázatunkon, ahol frissítjük a számlák egyenlegét, ugyanazt a képet látjuk. A számla frissítési idő átlagosan szintén fokozatosan normalizálódik. A CPU által felhasznált erőforrások is csökkennek. És a másodpercenkénti tranzakciók száma visszatér a normál értékre. De újra nem a rendes szintre, ami a baleset előtt volt.
Bármilyen esetben teljesítménycsökkenéssel szembesülünk, ahogy az első esetben másfél-kétszeres, néha még ennél is nagyobb.
Úgy tűnik, mindent jól csináltunk. Elosztottuk a terhelést. A berendezés nem áll üresen. Okosan felosztottuk a kéréseket, de így is rosszul sikerült.
- Ne kapcsolja be a hot_standby_feedback-t? Igen, ezt nem ajánlott bekapcsolni különösebb indok nélkül. Mert ez a beállítás közvetlenül befolyásolja a Master szervert, és leállítja az automatikus vákuum működését ott. Ha ezt bekapcsolja egy replikán, és elfelejti, könnyen tönkreteheti a Master-t, és komoly problémákat okozhat az alkalmazásban.
- Növelje meg a max_standby_streaming_delay-t? Igen, ez igaz a jelentésekre. Ha háromórás jelentése van, és nem akarja, hogy a replikációs konfliktusok miatt leálljon, egyszerűen növelje meg a késleltetést. Hosszú jelentések soha nem igényelnek azonnali adatokat, amelyek a rendszerbe érkeznek. Ha három órás, akkor bizonyára egy régi adatperiódusra indítja. Önnek teljesen mindegy, hogy három órás késleltetése van, vagy hat órás, de akkor stabilan megkapja a jelentéseket, és nem lesz problémája a leállásokkal.
- Természetesen ellenőrizni kell a hosszú munkameneteket a replikákon, különösen, ha úgy döntött, hogy bekapcsolja a hot_standby_feedback-et a replikán. Mert bármilyen helyzet előfordulhat. Átadtuk ezt a replikát egy fejlesztőnek, hogy tesztelje a lekérdezéseket. Ő írt egy őrült lekérdezést. Lefuttatta, és elment teázni, míg mi a Master-t megöltük. Vagy egy nem megfelelő alkalmazást engedünk odáig. A helyzetek változatosak. A replikákon lévő munkameneteket ugyanúgy figyelni kell, mint a Master-en.
- Ha gyors és hosszú lekérdezései vannak a replikákon, akkor ebben az esetben célszerű a terhelés elosztását szétbontani. Ez a streaming_delay-re vonatkozik. A gyorsaknak legyen egy replikájuk kisebb replikációs késleltetéssel. A hosszú jelentésekhez pedig legyen egy replikájuk, amely akár 6 órát, akár 24 órát is késlekedhet. Ez teljesen normális helyzet.
Ugyanazzal a módszerrel szüntetjük meg a következményeket:
- Megkeressük a megnövekedett táblákat.
- És tömörítjük a legmegfelelőbb eszközzel, amely nekünk megfelel.
A második történet itt véget ért. Térjünk át a harmadik történetre.
Ez is elég szokványos a számunkra, amelyben migrációt végzünk.
- Bármely szoftvertermék növekszik. A követelmények folyamatosan változnak. Mindig fejlődni akarunk. És néha szükséges a táblázat adatait frissíteni, éppen egy frissítést végrehajtva a migrációnk során az új funkcióhoz, amelyet bevezetünk a fejlődésünk keretein belül.
- A régi adatformátum nem megfelelő. Tegyük fel, hogy most rátérünk a második táblázatra, ahol ezekre a számlákra vonatkozó műveleteim vannak. És feltételezzük, hogy rubelben voltak, de döntöttünk úgy, hogy növeljük a pontosságot, és fillérekben végezzük. Ehhez frissíteni kell: a művelet összegén lévő mezőt meg kell szorozni százal.
- A modern világban automatizált eszközöket használunk az adatbázisok verzióellenőrzésére. Tegyük fel, . Ide írjuk a migrációnkat. Teszteljük a tesztadatbázisunkon. Minden rendben van. A frissítés sikeresen végbemegy. Kicsit leállítja a működést, de így frissített adatokat kapunk. És elindíthatjuk az új funkciókat ezen az alapon. Mindent leteszteltünk, ellenőriztünk. Mindenki megerősítette.
- Elvégeztük a tervezett munkálatokat, végrehajtottuk a migrációt.
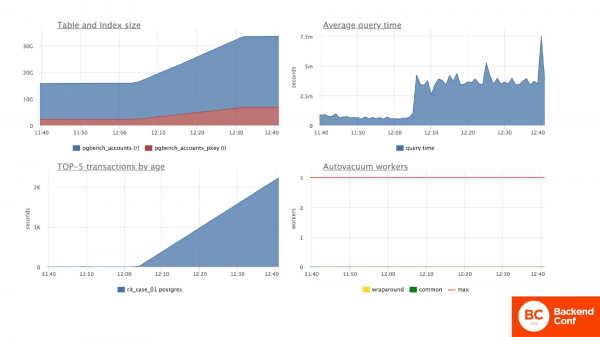
Itt a frissítéssel ellátott migráció bemutatása előttetek. Mivel ezek számlákra vonatkozó műveleteim vannak, a táblázat 15 GB volt. És mivel minden egyes sort frissítünk, a frissítéssel megdupláztuk a táblázat méretét, mert minden egyes sort újraírtunk.
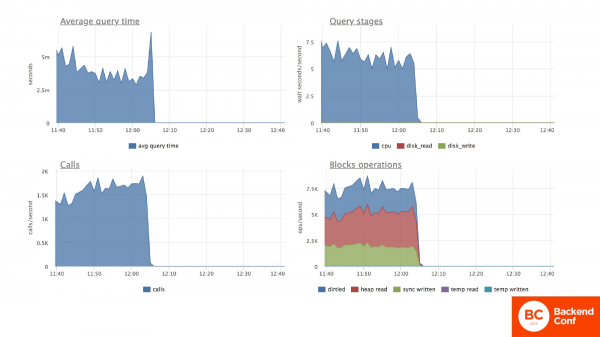
A migráció során nem tudtunk semmit csinálni ezzel a táblázattal, mert minden kérése várakozásra állt, amíg befejeződik ez a frissítés. De szeretném felhívni a figyelmet a függőleges tengelyen lévő számokra. Tehát az átlaga az előtti migrációs kérések időtartama körülbelül 5 milliszekundum, és a CPU terhelés, a memória olvasási műveletek száma kevesebb mint 7,5.
A migráció sikeresen lezajlott, de újra problémáink adódtak.
A migráció sikeres volt, de:
- A régi funkciók végrehajtása tovább tartott.
- A táblázat megint nőtt a méretei.
- A szerver terhelése ismét nagyobb lett, mint amilyen korábban volt.
- És természetesen még mindig foglalkozunk a jól működő funkciókkal, amelyeket egy kicsit javítottunk.
És ez megint bloat, ami újra megnehezíti az életünket.
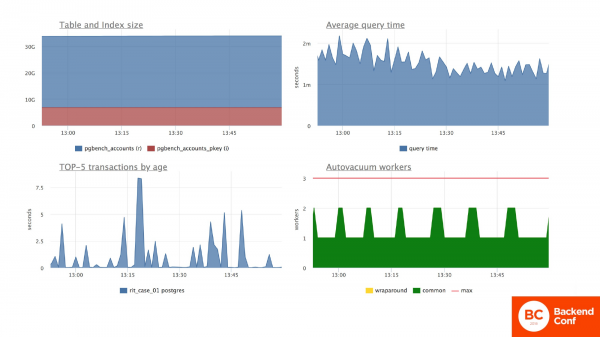
Itt bemutatom, hogy a táblázat, akárcsak az előző két esetben, nem készül visszatérni a korábbi méretekhez. A szerver átlagos terhelése látszólag megfelelő.
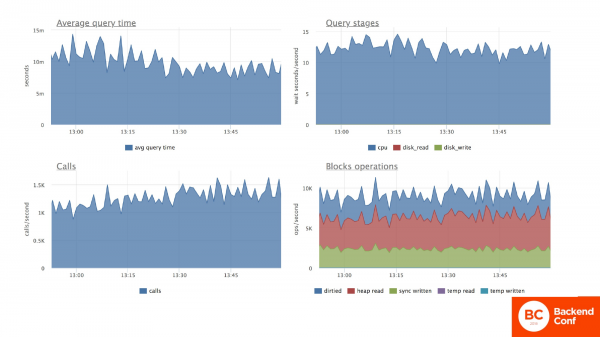
Ha megnézzük a számlák táblázatát, azt látjuk, hogy a lekérdezések átlagos ideje megduplázódott ehhez a táblázathoz képest. A processzor terhelése és a memóriában kezelt sorok száma 7,5 fölé ugrott, míg korábban alatta volt. A processzorok esetében a növekedés kétszeres, a blokkoperációk esetében másfél, tehát a szerver teljesítménye romlott. Ennek következményeként a mi alkalmazásunk teljesítménye is csökkent. Közben a hívások száma nagyjából ugyanazon a szinten maradt.
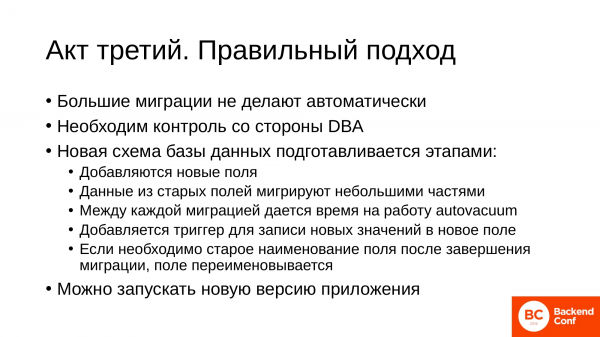
Itt a legfontosabb megérteni, hogyan kell helyesen végrehajtani az ilyen migrációkat. Ezeket el kell végezni. Mi rendszeresen végezzük ezeket a migrációkat.
- Az ilyen nagy migrációkat sosem végzik automatikusan. Mindig kontrolláltak kell, hogy legyenek.
- Szükséges a kontroll egy tapasztalt személy részéről. Ha van DBA a csapatban, akkor hagyjuk, hogy ő végezze. Ez az ő munkája. Ha nincs, akkor a legtapasztaltabb személy végezze, aki tudja, hogyan kell dolgozni az adatbázisokkal.
- Az új adatbázis séma mindig lépésről lépésre készül, még akkor is, ha csak egy oszlopot frissítünk, tehát előre, a legújabb alkalmazásverzió kiadása előtt:
- Új mezők kerülnek hozzáadásra, ahová az éppen frissített adatokat fogjuk rögzíteni.
- Az adatokat az öreg mezőből az új mezőbe kis részekben másoljuk át. Miért csináljuk ezt? Először is mindig ellenőrizzük ennek a folyamatnak a menetét. Tudjuk, hogy eddig ennyi köteg adatot átvittünk és még ennyi van hátra.
- A második pozitív hatás, hogy minden ilyen köteg között lezárjuk a tranzakciót, nyitunk egy újat, és ez lehetőséget ad az automatikus takarításnak, hogy működjön a táblán, megjelöli a halott sorokat újrahasználatra.
- Azok számára, akik az alkalmazásunk működése során fognak megjelenni (még mindig fut a régi alkalmazás), hozzárendelünk egy triggert, ami az új értékeket az új mezőkbe írja. A mi esetünkben ez az öreg érték százszorosára való szorzása.
- Ha teljesen makacsak vagyunk, és ugyanazt a mezőt akarjuk, akkor minden migráció befejezése után és a legújabb alkalmazás verziójának kiadása előtt egyszerűen átnevezzük a mezőket. A régieket valamiféle kitalált névre, az újak pedig az öreg mezők nevére.
- Csak ezt követően indítjuk el az új verziót.
Ezáltal nem fogunk bloatot kapni, és nem romlik a teljesítmény.
Ezzel a harmadik történet véget ért.
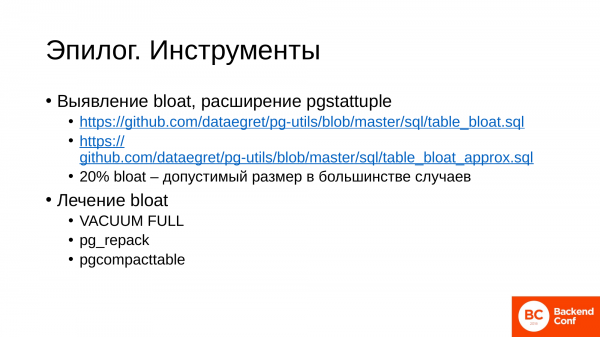
Most pedig egy kicsit részletesebben az eszközökről, amelyeket az első történetben említettem.
Bbefore searching for bloat, it is essential to install the extension. .
Annak érdekében, hogy ne kelljen kitalálni a lekérdezéseket, már megírtuk őket a munkánk során. Ezeket használhatja. Itt két lekérdezés található.
- Az első lekérdezés meglehetősen hosszú ideig fut, de pontos értékeket fog mutatni a bloat-ról a táblázatban.
- A második gyorsabban működik és nagyon hatékony, amikor gyorsan fel kell mérni, hogy van-e bloat a táblázatban. Ezenkívül fontos megérteni, hogy a bloat mindig jelen van a Postgres táblázatokban. Ez az MVCC modell sajátossága.
- A 20% bloat normális a táblázatok esetében a legtöbb esetben. Tehát nem kell aggódnia, és nem szükséges tömöríteni ezt a táblát.
Miként lehet azonosítani a megnagyobbodott táblákat, már tisztáztuk, mégpedig azoktól a felesleges adatokatól, amelyek megnövelték a méretüket.
Most pedig arról, hogyan lehet javítani a bloat-ot:
- Ha van egy kis táblázatunk és jó lemezeink, azaz a táblázat mérete akár egy gigabájt, érdemes a VACUUM FULL-t használni. Ez pár másodperces exkluzív zárolást igényel a táblázaton, de gyorsan és hatékonyan végzi el a feladatot. Mi is a VACUUM FULL? Exkluzív zárolást hoz létre a táblázaton, és a régi táblákról átmásolja a jelenlegi sorokat egy új táblázatba. Végül helyet cserélnek. A régi fájlok törlése, az új fájlok beillesztése a régiek helyére. Azonban a működése alatt exkluzív táblázat zárolásra van szüksége, ami azt jelenti, hogy nem lehet az adott táblázathoz hozzáférni: sem írni bele, sem olvasni belőle, sem módosítani. A VACUUM FULL emellett további lemezterületet is igényel az adatok eltárolásához.
- A következő eszköz . Alapelvei nagyon hasonlítanak a VACUUM FULL-ra, mert szintén régi fájlokból új fájlokba másolja az adatokat, majd cseréli őket a táblázatban. De nem kér exkluzív zárolást a táblázaton a munka elején, csak akkor, amikor már készen állnak az adatok a fájlok cseréjére. A lemezforrásokkal kapcsolatos követelményei hasonlóak mint a VACUUM FULL-nak. Tehát szüksége van plusz lemezterületre, ami néha kritikus lehet, ha terabájtos táblák vannak. Emellett eléggé erőforrásigényes, mivel aktívan dolgozik a bemenet-kimenettel.
- A harmadik segédeszköz pedig . A pgcompacttable jobban kíméli az erőforrásokat, mert kissé más elvek szerint működik. A pgcompacttable lényegében azzal foglalkozik, hogy az összes aktív sort elöl tartja a táblázatban a frissítések során. Ezután futtat egy takarítást a táblázaton, mivel tudjuk, hogy elöl találhatók az élő, hátul pedig a holt sorok. A takarítás pedig leválasztja ezt a 'farkat', tehát nem igényel túl sok plusz lemezterületet. Ráadásul az erőforrásait is lehet optimalizálni.
Minden eszközzel.
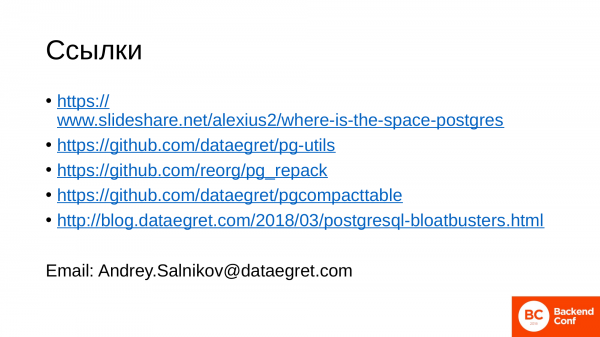
Ha a bloat téma érdekesnek tűnik számodra a további mélyebb belenézés szempontjából, itt van néhány hasznos link:
- – ez a kollégám előadása. Átfogóan arról szól, hogy hova tűnik el a hely a Postgres működése és élete során. Nagy és részletes technikai rész található benne az adatbázis-adminisztrátorok számára a bloat-ról.
- – ez a link a mi tárolónkhoz, ahol sok hasznos szkriptet tárolunk az adatbázis állapotának ellenőrzésére. Itt találhatsz bloat keresésére szolgáló szkripteket.
- és linkek az eszközökhöz, amelyek segítenek a táblázatok optimalizálásában.
- – ez a kollégám bejegyzése. Itt elég alaposan és technikailag tárgyalja a bloat-ot, közvetlenül az adminisztrátorok szintjén.
Itt inkább ezt a 'szörnyűséget' próbáltam bemutatni a fejlesztőknek, mivel ők közvetlenül a mi adatbázisaink ügyfelei, és meg kell érteniük, hogy bizonyos intézkedések milyen következményekkel járhatnak. Remélem, sikerült. Köszönöm a figyelmet!
Kérdések
Köszönöm az előadást! Arról beszélt, hogyan lehet azonosítani a problémákat. De hogyan lehet ezeket megelőzni? Volt egy helyzetem, amikor a lekérdezések nemcsak külső szolgáltatásokra való hivatkozás miatt akadtak meg. Csak valamilyen furcsa egyesítések voltak. Volt néhány kicsi, ártalmatlan lekérdezés, amelyek 24 órán keresztül akadtak, majd valami furcsát kezdtek el művelni. Nagyon hasonlít arra, amit leírtál. Hogyan lehet ezt nyomon követni? Ülnöm kellene és folyamatosan figyelnem, hogy melyik lekérdezés akadt meg? Hogyan lehet ezt megelőzni?
Ebben az esetben – ez a cégük adminisztrátorának a feladata, nem feltétlenül a DBA-é.
Én adminisztrátor vagyok.
A PostgreSQL-ben van egy pg_stat_activity nézet, amely megmutatja a leragadt lekérdezéseket. Így láthatod, hogy mennyi ideig akadtak meg.
Minden 5 percben be kell lépnem, és megnéznem?
Állítsd be a cron-t és ellenőrizd. Ha hosszú kérésed van, írj egy levelet, és ennyi. Vagyis nem kell a szemednek néznie, ezt automatizálni lehet. Érkezik egy levél, amire reagálsz. Vagy automatikusan is elérheted.
Vannak világos okai, amiért ez történik?
Néhányat már felsoroltam. Mások bonyolultabb példák, és ott a beszélgetés hosszú lehet.
Köszönöm a beszámolót! A pg_repack eszközről szeretnék kérdezni. Ha nem hoz létre kizárólagos zárolást, akkor...
Kizárólagos zárolást hoz létre.
… akkor potenciálisan adatokat veszíthetek. Az alkalmazásomnak nem szabadna semmit írnia ilyenkor?
Nem, az nyugodtan működik a táblával, vagyis a pg_repack először áthelyezi az összes élő sort, ami van. Természetesen történik valamilyen írás a táblába. Csak ezt a végső részt dobja hozzá.
Vagyis a végén mégiscsak csinálja?
A végén kizárólagos zárolást vesz a fájlok felcseréléséhez.
Ez gyorsabb lesz, mint a VACUUM FULL?
A VACUUM FULL, amikor elkezdődött, azonnal kizárólagos zárolást vett. És amíg mindent el nem végez, nem oldja fel. A pg_repack csak a fájlok cseréjének pillanatában hoz létre kizárólagos zárolást. Ebben a pillanatban nem írsz oda, de az adatok nem vesznek el, minden rendben lesz.
Helló! Meséltél az autovákuum működéséről. Volt egy diagram piros, sárga és zöld cellákkal. Vagyis a sárgákat töröltnek jelölte. Tehát ezekbe lehet új dolgokat írni?
Igen. A Postgres nem törli a sorokat. Ennek ilyen a sajátossága. Ha frissítettünk egy sort, a régi sor töröltként van megjelölve. Azt a tranzakció azonosítója állítja be, amelyik ezt a sort megváltoztatta, és beírjuk az új sort. És vannak olyan sessionök, amelyek potenciálisan olvashatják őket. Egy idő után ezek már nagyon öreggé válnak. Az autovákuum működésének lényege, hogy átfut ezeken a sorokon és megjelöli őket feleslegesnek. És oda új adatokat lehet írni.
Értem. De a kérdés egy kicsit nem erről szól. Nem fejeztem be. Tegyük fel, hogy van egy táblánk. Van benne változó méretű mező. És ha megpróbálok valamit újonnan beilleszteni, akkor az a régi cellába egyszerűen nem fér be.
Nem, ott ígyis úgyis frissül az egész sor. A Postgresben két adattárolási modell létezik. Attól függ, hogy milyen típusú adatokról van szó. Vannak adatok, amelyek közvetlenül a táblában találhatók, és vannak további tos-adatok. Ezek nagy mennyiségű adatok: szöveg, json. Ezek külön táblákban vannak tárolva. És ezen táblák esetében is ugyanez a helyzet a bloat-tal, tehát minden ugyanolyan. Csak külön vannak kezelve.
Köszönöm a prezentációt! Mennyire elfogadható a kérdések időtartamának korlátozására a statement timeout használata?
Nagyon elfogadható. Mi ezt mindenhol használjuk. Mivel nincsenek saját szolgáltatásaink, távoli támogatást nyújtunk, így eléggé különböző ügyfeleink vannak. Mindenkit teljes mértékben kielégít ez. Tehát vannak cron feladataink, amelyek ellenőrzik. Egyszerűen egyeztetjük az ügyféllel a munkamenetek időtartamát, amely előtt nem zárjuk le. Ez lehet egy perc, lehet 10 perc is. Ez az adatbázis terhelésétől és céljától függ. De mindannyian a pg_stat_activity-t használjuk.
Köszönöm a prezentációt! Próbálom alkalmazni a prezentációját az alkalmazásaimra. Úgy tűnik, hogy mindenütt elindítunk egy tranzakciót, mindenütt egyértelműen befejezzük azt. Ha valamilyen kivétel történik, akkor is rollback történik. És itt elgondolkodtam. Hiszen lehet, hogy a tranzakció nem egyértelműen indul el. Ez talán egy tipp a hölgynek. Ha egyszerűen csak frissítek egy rekordot, akkor a tranzakció elindul a PostgreSQL-ben, és csak akkor fejeződik be, amikor a kapcsolat megszakad?
Ha most az alkalmazás szintjéről beszélünk, akkor ez attól függ, hogy melyik drivert használja, melyik ORM van használatban. Itt nagyon sok beállítás van. Ha az auto commit on van engedélyezve, akkor a tranzakció elindul, majd azonnal befejeződik.
Tehát azonnal a frissítés után záródik le?
Ez a beállításoktól függ. Egy beállítást már említettem. Ez az auto commit on. Ez meglehetősen elterjedt. Ha engedélyezve van, akkor a tranzakció nyitva állt, majd be is zárult. Ha nem mondtad ki egyértelműen a „start transaction” és „end transaction” parancsokat, hanem csak egy lekérdezést indítottál a munkamenetben.
Üdvözlöm! Köszönöm a prezentációt! Tegyük fel, hogy van egy adatbázisunk, amely folyamatosan nő és a szerveren elfogy a hely. Vannak valamilyen eszközök erre a helyzet megoldására?
A szerveren található helyet érdemes figyelni.
Például, ha a DBA elment teázni, nyaralásra ment stb.
Amikor fájlrendszert hoznak létre, akkor legalább valamilyen tartalék helyet foglalnak, ahová nem írnak adatokat.
Mi van, ha teljesen nullára csökkentjük?
Ez akár 'foglaltnak' is nevezhető, ami azt jelenti, hogy felszabadítható, és attól függően, hogy mennyire nagyra hozták létre, szabad helyet kaptál. Alapértelmezés szerint nem tudom, mennyi hely van ott. Egy másik esetben – lemezeket kell hozni, hogy legyen hely a helyreállítási művelethez. Törölhetsz egy táblát, amelynek garantáltan nincs szüksége.
Nincsenek más eszközök?
Ez mindig manuális munka. A helyszínen derül ki, hogy mit érdemes tenni, mert vannak kritikus és nem kritikus adatok. És minden adatbázis és alkalmazás, amely vele dolgozik, a vállalkozástól függ. Mindig a helyszínen dől el.
Köszönöm a bemutatót! Két kérdésem van. Először is, a bemutató során azt láttam, hogy ha egy tranzakció leragad, akkor nő mind a táblázati térfogat, mind az index mérete. A bemutatóban volt sok eszköz, amelyek a táblát tömörítik. Mi a helyzet az indexel?
Ezeket is tömörítik.
De a vákuum nem érinti az indexet?
Néhány eszköz dolgozik az indexszel. Például a pg_rapack, pgcompacttable. A vákuum újraalkotja az indexeket, érinti őket. A VACUUM FULL lényege, hogy mindent újraírjon, vagyis mindenkivel dolgozik.
A második kérdésem. Nem értettem, miért függnek a jelentések ennyire a replikációtól. Úgy tűnt, hogy a jelentések – ezek olvasások, míg a replikáció – írás.
Miben áll a replikációs konfliktus? Van egy Mesterünk, ahol a folyamatok zajlanak. Ott avtvákuum történik. Az avtvákuum valójában mit csinál? Eltávolít néhány régi sort. Ha ebben az időben a replikán egy kérés zajlik, amely ezekről a régi sorokról olvas, és a Mesterünknél az avtvákuum azokat a sorokat rekvizírozta, mint amelyek újraírásra alkalmasak, akkor újraírtuk őket. És megérkezett egy adatcsomag, amikor újra kellene írni azokat a sorokat, amelyek szükségesek a replikán lévő kéréshez. A replikációs folyamat megvárja azt az időtúllépést, amelyet beállítottál. Aztán a PostgreSQL eldönti, mi fontosabb. A replikáció fontosabb számára, mint a kérdés, és leállítja a kérdést, hogy végrehajtsa ezeket a változtatásokat a replikán.
András, van egy kérdésem. Ezek a csodás grafikonok, amelyeket a prezentáció során mutattál, a te eszközöd munkájának az eredményei? Mivel készítetted a grafikonokat?
Ez egy szolgáltatás .
Ez egy kereskedelmi termék?
Igen. Ez egy kereskedelmi termék.
Forrás: habr.com
