

Nemrég egy meglehetősen szokatlan feladattal találkoztam a MetalLB forgalomirányításának beállításában. Semmi gond, hiszen a MetalLB-hez általában nem szükséges külön intézkedés, de az esetünkben van egy elég nagy klaszterünk, viszonylag egyszerű hálózati konfigurációval.
Ebben a cikkben elmondom, hogyan állítható be a forrás- és a politikaalapú forgalomirányítás klaszterének külső hálózatához.
Nem fogok részletesen foglalkozni a MetalLB telepítésével és beállításával, mivel feltételezem, hogy már van némi tapasztalatod. Javaslom, hogy azonnal térjünk a lényegre, nevezetesen a forgalomirányítás beállítására. Tehát négy esetünket vizsgáljuk meg:
Eset 1: Amikor a beállítás nem szükséges
Nézzük meg az egyszerű esetet.
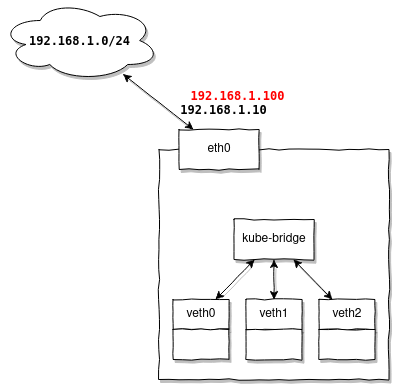
További forgalomirányítási beállításra nincs szükség, amikor a MetalLB által kiosztott IP-címek ugyanabban a hálózati alhálózatban vannak, mint a csomópontjaid címei.
Például van egy alhálózatod 192.168.1.0/24, ezen van egy útválasztó 192.168.1.1, és a csomópontjaid a következő címeket kapják: 192.168.1.10-30, akkor a MetalLB számára beállíthatod a tartományt 192.168.1.100-120 , és biztos lehetsz benne, hogy ez további beállítás nélkül működni fog.
Miért van ez így? Mert a csomópontjaid már rendelkeznek beállított útvonalakkal:
# ip route
default via 192.168.1.1 dev eth0 onlink
192.168.1.0/24 dev eth0 proto kernel scope link src 192.168.1.10
És a ugyanabból a tartományból származó címek újra felhasználják őket bármiféle további intézkedés nélkül.
Eset 2: Amikor további beállítás szükséges
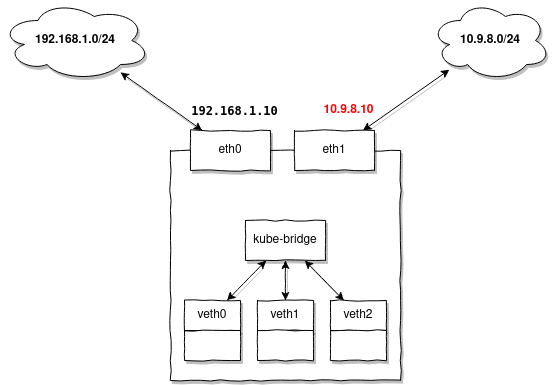
További útvonalakat kell beállítanod, amikor a csomópontjaidnak nincsen beállítva IP address vagy útvonal a MetalLB által kiosztott címek alhálózatába.
Részletesebben elmagyarázom. Minden alkalommal, amikor a MetalLB kioszt egy IP-címet, ez összehasonlítható egy egyszerű címzéssel:
ip addr add 10.9.8.7/32 dev loNe feledd, hogy:
- a) A cím a prefikszel van kijelölve
/32ezért az alhálózathoz nem adódik automatikusan útvonal (ez csupán egy cím) - b) A cím bármely csomóponti interfészhez hozzárendelhető (például loopback). Itt érdemes megemlíteni a Linux hálózati stackjének sajátosságait. Nem számít, melyik interfészhez adod a címet, a kernel mindig feldolgozza az arp-kéréseket, és válaszokat küld bármelyik interfészen, ez a viselkedés helyesnek számít, és ráadásul széles körben használják olyan dinamikus környezetben, mint a Kubernetes.
Ezt a viselkedést beállítható, például szigorú arp engedélyezésével:
echo 1 > /proc/sys/net/ipv4/conf/all/arp_ignore
echo 2 > /proc/sys/net/ipv4/conf/all/arp_announce
Ebben az esetben az ARP-válaszokat csak akkor küldik el, ha a felület kifejezetten tartalmaz egy adott IP-címet. Ez a beállítás kötelező, ha a MetalLB-t használni kívánja, és a kube-proxy IPVS üzemmódban működik.
A MetalLB azonban nem használja a kernelt az ARP-kérések feldolgozására, hanem ezt önállóan, felhasználói térben végzi, így ez az opció nem befolyásolja a MetalLB működését.
Térjünk vissza a feladatunkhoz. Ha a kiosztott címeknek nincs útvonaluk a csomópontjain, előbb létre kell hoznia azt minden csomóponton:
ip route add 10.9.8.0/24 dev eth13. eset: Amikor szükség van source-alapú útválasztásra
Source-alapú útválasztást akkor kell beállítani, amikor a csomagokat egy külön gateway-en keresztül kapja, nem azon, ami alapértelmezetten be van állítva, így a válaszcsoportnak is ugyanazon a gateway-en kell távoznia.
Például van egy az Ön csomópontjainak fenntartott alhálózata, de külső címeket szeretne kiosztani a MetalLB segítségével. Tegyük fel, hogy van néhány cím az alhálózatból, 192.168.1.0/24 amelyek a 100-as VLAN-ban találhatók, és azokat szeretné használni a Kubernetes-szolgáltatások külső eléréséhez. 1.2.3.0/24 A kérés elküldésekor a
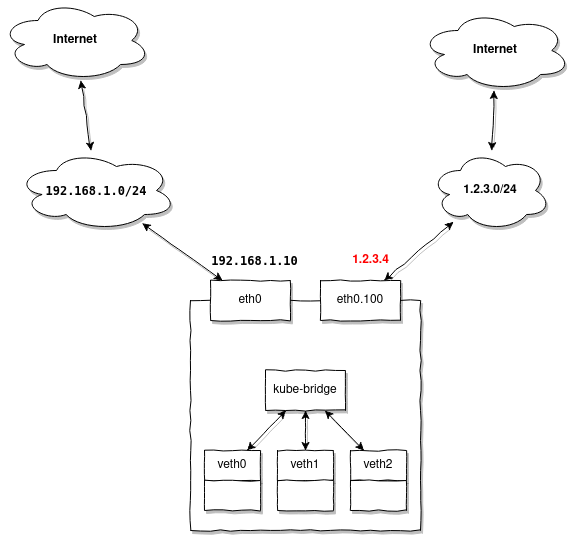
más alhálózatból érkezik, mint a 1.2.3.4 és választ vár. Az a csomópont, amely jelenleg a MetalLB által kiosztott cím mestere, 1.2.3.0/24 csomagot kap a routertől, de a válaszának ugyanazon az úton kell mennie, mint amerről 1.2.3.4Kapta a csomagot. 1.2.3.1Mivel a csomópontunk már beállította az alapértelmezett gateway-t, 1.2.3.1.
a válasz alapértelmezetten oda fog menni, nem pedig a 192.168.1.1, amelyen keresztül a csomagot megkaptuk. 1.2.3.1Hogyan kezeljük ezt a helyzetet?
Ebben az esetben fel kell készítenie az összes csomópontját, hogy készen álljanak a külső címek szolgáltatására további beállítások nélkül. Azaz a fent említett példához előre létre kell hoznia a VLAN-interfészt a csomóponton:
ip link add link eth0 name eth0.100 type vlan id 100 ip link set eth0.100 up
Ezután hozzá kell adnia az útvonalakat:ip route add 1.2.3.0/24 dev eth0.100 table 100 ip route add default via 1.2.3.1 table 100
Vegye figyelembe, hogy az útvonalakat egy külön útválasztási táblába adjuk hozzá,itt csak két útvonalat fog tartalmazni, amelyek szükségesek a válaszcsomag küldésére a gateway-en keresztül, 100 amely a 1.2.3.1eth0.100 interfészen található. Most egy egyszerű szabályt kell hozzáadnunk:.
ip rule add from 1.2.3.0/24 lookup 100
amely egyértelműen mondja: ha a csomag forráscíme a, akkor használja az útválasztási táblát. 1.2.3.0/24belül van, akkor ezt a routing táblát kell használni. 100. Itt már részleteztük az útvonalat, amely elküldi őt 1.2.3.1
4. eset: Amikor policy-alapú útvonalválasztásra van szükség
A hálózat topológiája hasonló az előző példához, de tegyük fel, hogy szeretnéd, hogy a külső címekhez is hozzáférhess a tartózkodási területről 1.2.3.0/24 a podjaidból:
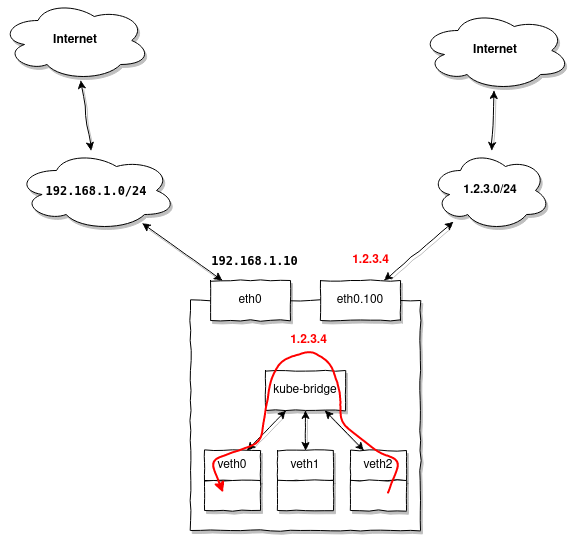
A lényeg az, hogy bármely címre való hivatkozáskor 1.2.3.0/24, a válaszcsomag a node-ra érkezik, és a forrást egy adott tartományban találja 1.2.3.0/24 majd engedelmesen elküldik Most egy egyszerű szabályt kell hozzáadnunk:, de mi azt akarjuk, hogy a Kubernetes átirányítsa az első podunkba, amely az eredeti kérést generálta.
A probléma megoldása nem volt egyszerű, de a policy-alapú útvonalválasztásnak köszönhetően lehetségessé vált:
A folyamat jobban megértéséhez bemutatok egy blokk diagramot a netfilterhez:
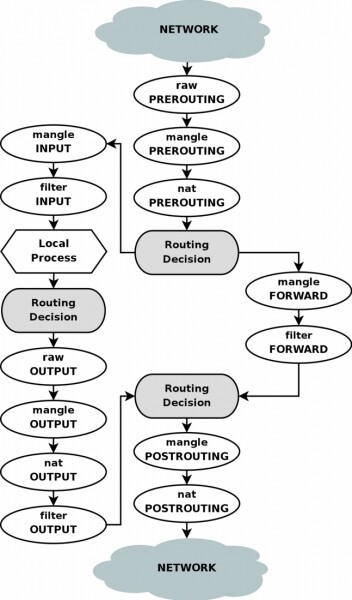
Először, az előző példához hasonlóan, létrehozunk egy további útválasztási táblát:
Vegye figyelembe, hogy az útvonalakat egy külön útválasztási táblába adjuk hozzá,Most hozzáadunk néhány szabályt az iptables-hez:
iptables -t mangle -A PREROUTING -i eth0.100 -j CONNMARK --set-mark 0x100
iptables -t mangle -A PREROUTING -j CONNMARK --restore-mark
iptables -t mangle -A PREROUTING -m mark ! --mark 0 -j RETURN
iptables -t mangle -A POSTROUTING -j CONNMARK --save-mark
Ezek a szabályok megjelölik a bejövő kapcsolatokat az interfészen Most egy egyszerű szabályt kell hozzáadnunk:, minden csomagot címkézve 0x100, ezzel a címkével lesznek megjelölve a válaszok is az egyes kapcsolat keretein belül.
Most hozzáadhatunk egy útválasztási szabályt:
ip rule add from 1.2.3.0/24 fwmark 0x100 lookup 100Tehát minden csomagot a forráscímmel 1.2.3.0/24 és a címkével 0x100 a táblát használva kell útvonalazni. 100.
Ezért a más interfészen érkező egyéb csomagok nem esnek ezen szabály alá, ami lehetővé teszi számukra, hogy a Kubernetes szokásos eszközeivel legyenek útvonalazva.
Van még egy dolog, a Linuxban létezik az úgynevezett visszafelé irányuló szűrő, amely elrontja az egészet, és egyszerű ellenőrzést végez: minden bejövő csomag számára megcseréli a csomag forráscímét a küldő címére, és ellenőrzi, hogy a csomag elhagyhatja-e azon az interfészen, amelyen megkapták; ha nem, akkor szűri.
A probléma az, hogy a mi esetünkben nem fog helyesen működni, de ezt ki tudjuk kapcsolni:
echo 0 > /proc/sys/net/ipv4/conf/all/rp_filter
echo 0 > /proc/sys/net/ipv4/conf/eth0.100/rp_filter
Vegye figyelembe, hogy az első parancs a globális rp_filter viselkedést irányítja; ha ezt nem kapcsolod ki, a második parancsnak nem lesz hatása. Mindazonáltal a többi interfész továbbra is bekapcsolt rp_filterrel marad.
Annak érdekében, hogy ne korlátozzuk a szűrő működését teljesen, használhatjuk az rp_filter megvalósítást a netfilter számára. Az iptables rpfilter moduljaként való alkalmazásával elég rugalmas szabályokat állíthatunk be, például:
iptables -t raw -A PREROUTING -i eth0.100 -d 1.2.3.0/24 -j RETURN
iptables -t raw -A PREROUTING -i eth0.100 -m rpfilter --invert -j DROP
az rp_filter aktiválása az interfészen Most egy egyszerű szabályt kell hozzáadnunk: minden cím kivételével 1.2.3.0/24.
Forrás: habr.com
