

A nevem Juri, a Sitimobil rendszergazdálkodási csoport vezetője vagyok. Ma megosztom tapasztalataimat a vékony lemezalapú (thin provisioning) Linux fájlrendszerek technológiájával kapcsolatban, és elmondom, hogyan alkalmazhatók ezek a vállalat CI/CD folyamataiban. Megvizsgáljuk azt a helyzetet, amikor a kód automatikus teszteléséhez a termelésbe való telepítés során minél gyorsabban szükségünk van MySQL adatbázis másolatokra, amelyek a lehető legközelebb állnak a "éles" verzióhoz, elérhetőek olvasásra és írásra.
Bevezetés: Miért érdemes káros tanácsokat adni?
Logikus kérdés, hiszen léteznek bevált mechanizmusok az adatbázis sémák migrálására tesztkörnyezetekbe. Miért is kellene egy alapvetően nem shardolt adatbázist ilyen méretekig felnövelni? Ráadásul a teszteléshez nem is szükséges minden adat. Megpróbálom elmagyarázni.
Körülbelül egy évvel ezelőtt, a taxiaggregátorunk gyors növekedése közepette (2018-ban a befejezett utazások száma körülbelül 15-szörösére nőtt), a adataink mennyisége is megnőtt, a szerverekre nehezedő teher és a kiadások gyakorisága is emelkedett. A következő helyzetben találtuk magunkat:
- Az alap MySQL adatbázis körülbelül 1000 táblára nőtt, összesen 2,5 TB terjedelemmel, és továbbra is növekedett.
- Nem volt lehetőségünk gyorsan sharda-ra váltani és az adatbázist szétszedni. Az a régi megközelítés, hogy "bármilyen adatot írok az adatbázisba, ahogyan csak akarok" sok JOIN és belső táblasorozat miatt lehetetlenné tette ezt.
- Nem volt mechanizmus az adatbázis séma migrálására tesztkörnyezetekbe.
- Nem volt automatikus kódtesztelés a telepítés során.
Az utolsó problémát a lehető leggyorsabban szerettük volna megoldani. Már írtunk teszteket Postman-ben a fő PHP-monolith tesztelésére, de nem volt elegendő aktuális adatbázisunk. Ugyanakkor nem tudtunk éjszaka replikát létrehozni, mesterré tenni azt, és napközben elérhetővé tenni: a túl sok kiadás és változtatás, például az adatok és az adatbázis sémáiban, nem tette volna működőképessé a környezetet már a nap közepére. Ráadásul a kiadásokat csak a munkanapra korlátozni nem lett volna hatékony.
Ennek ellenére a feladatot elvégeztük: az első működő környezetünket már két hét elteltével megkaptuk. Azóta sok változáson ment keresztül, és továbbra is használatban van.
Ezután részletesen ismertetem a megoldásunk fejlesztésének minden lépését és szakaszát. Meg fog győződni arról, hogy ez a módszer megérdemli a létezést.
Mi az a „vékony rezerválás”?
Ez egy hardveres vagy szoftveres technológia (más néven sparse volumes), amely lehetővé teszi, hogy több erőforrást allokáljunk, mint amennyi fizikailag rendelkezésre áll. Az allokált térfogatnak meg kell felelnie a just-enough (éppen annyi, amennyi szükséges) és just-in-time (a szükséges időben) kritériumoknak. Főként különböző tárolórendszerekben használják, hogy elegendő mennyiségű lemezterületet biztosítsanak, amely meghaladja a ténylegesen elérhető kapacitást. A technológiát különböző fájlrendszerek támogatják, például LVM2, ZFS, BTRFS. Széleskörűen alkalmazzák virtualizációs hypervízorokban. A vékony rezerválás lehetővé tette számunkra, hogy gyorsan hozzunk létre annyi másolatot az adatokat tartalmazó fő partíció pillanatképeiből, amennyire szükségünk volt (MySQL adatbázis data könyvtára).
Első stand, Thin LVM technológia
Ezt a fejezetet még így is elnevezhetjük: „Hogyan készítsünk maximálisan gyors pillanatképeket nagy adatmennyiségekről , csökkentve a fájlrendszer és a MySQL adatbázis stabilitását elfogadhatatlan szintre.”
Mivel már használtuk az LVM-et az operációs rendszerek fő partícióinak kialakításához, ezért döntöttünk azzal, hogy ezzel kezdjük. Először szükségünk volt egy külön fizikai gépre – a MySQL fő adatbázisunk replikájára, ahol kérésre létrehozhatunk egy pillanatképet a replikáról, és felmerhetjük azt egy külön MySQL példányban. A tesztelés ideje alatt megengedtük, hogy ezen a példányon módosító műveleteket hajtsanak végre, és a tesztek befejezése után sikeresen töröltük azt. A szerver konfigurációja a következő volt:
- 2 x Intel Silver 4114 (10×2,2 GHz HT)
- 8 x 32 GB DDR4
- 8 x 1920 GB Intel SSD RAID vezérlővel az Adaptec RAID-10 formátumban
A RAID vezérlő és a szoftveres RAID MD közötti választásról külön cikket is lehetne írni. Csak annyit mondhatok, hogy két tényező befolyásolta a választásunkat:
- A feladat felvetésének idején minden adatbázist RAID vezérlőkre telepítettünk, ezért mondhatjuk, hogy történelmileg így alakult.
- A fájlrendszer szintetikus tesztjein és a MySQL különböző műveleteivel végzett tesztek teljesítménykülönbsége minimális volt.
A RAID-10 array was created: we set up a single Volume Group (VG) for the entire volume (with overhead of about 6.7 GB) and created a logical partition (Logical Volume, LV) for the system of 50 GB. In a typical situation, the remaining space would be allocated for the MySQL partition. However, we needed thin provisioning, so we first created a pool within which we set aside a partition for /var/lib/mysql of 3.5 TB (based on expected DB sizes):
lvcreate -l 100%FREE -T vga/thin
lvcreate -V 3.5T -T vga/thin -n mysql
We formatted the partition in ext4, mounted it, wrote a replica, and established the initial setup. Then we created an API wrapper that should create snapshots, launch a MySQL database instance on a specified port, and remove the created instance. Since only system calls are used in this process, we chose the standard bash scripting language, and for the API binding, we implemented an open-source solution using HTTP → bash. , written in Go.
One day we will release our bash scripts as open source, but for now, I will simply describe the main algorithm:
Creating the main snapshot snapmain:
- We stop the main replica.
- We impose a lock on operations with the snapshot snapmain.
- We create a new snapshot snapmain.
- We start MySQL and remove the lock.
Creating a DB on an arbitrary port from snapmain:
- We impose a lock on the specific DB instance (port).
- We check for the existence of the lock on creating the main snapshot. If it exists, we wait and recheck every 5 seconds.
- We check if there is an old LV partition of the instance.
3.1 If it exists, we stop the MySQL instance with kill -9 and remove the LV partition. - We create a new instance from snapmain.
- We prepare and mount directories for this instance.
- We remove slave indicators (files) and start the MySQL instance.
- We promote it to master.
- We remove the lock.
Deleting a DB on an arbitrary port:
- We impose a lock on the specific DB instance (port).
- We kill the MySQL instance using kill -9.
- We unmount the directories.
- We remove the LV partition and lift the lock.
Example commands for cloning partitions of the new DB instance:
lvcreate -n stage_3307 -s vga/snapmain
lvchange -ay -K vga/stage_3307
mount -o noatime,nodiratime,data=writeback /dev/mapper/vga-stage_3307 /mnt/stage_3307
Mostrazzuk a fő problémát, amellyel a vékonyan virtualizált tárolás során szembesültünk. A SSD-meghajtók teljesítményébe ütköztünk. Ez a Thin LVM sajátos működéséből adódott, amely alapvetően alacsony szintű, 4 MB méretű blokkokkal dolgozik. Így nézett ki ez:
- Készítünk egy pillanatfelvételt a fő partícióról /var/lib/mysql.
- Elindítjuk a replikációt, hogy utolérjük a mestert.
- Bármilyen változtatás a replikák tábláiban régi, változatlan adatok blokkjait tárolja a pillanatfelvételi partíción.
- Bármely változás a tesztpéldányban régi, változatlan adatok blokkjait tárolja a klónozott pillanatfelvétel partícióján ennek a példánynak.
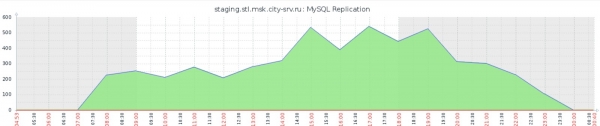
- 100%-os bemeneti/kimeneti terheltséget kapunk a készüléken, minden művelet lelassul, és a replikáció fokozatosan elmarad.
- A munkanap végére néhány órás lemaradást tapasztalunk.
Hogyan küzdöttünk ezzel, hogy ésszerűbb eredményt kapjunk (alapvető pontok):
RAID vezérlő:
- Alapértelmezés szerint letiltottunk mindenféle gyorsítást.
- Írjon vissza (amikor az adatok a pufferbe kerülnek, a felvétel befejeződik, mielőtt a tényleges mentés megtörténik a lemezen).
Fájlrendszer:
- A /var/lib/mysql csatlakozási pontnál beírtuk noatime,nodiratime,data=writeback
- Az ext4 naplózást a tune2fs segítségével letiltottuk.
MySQL:
- Beírtuk innodb_flush_method = O_DSYNC (növeltük a felvétel sebességét, csökkentve ezáltal a megbízhatóságot).
- Letiltottuk a naplózást, a naplókra nincs szükségünk.
- Beírtuk innodb_buffer_pool_size = 4G (minél kisebb az InnoDB pool mérete, annál gyorsabban leáll a MySQL, és annál gyorsabban készítünk pillanatfelvételt).
Ez messze nem teljes lista, különösen a MySQL esetében. Más változtatások általában kisebb jelentőségűek, és nem mindig és egész pontosan alkalmazhatók. Például annak érdekében, hogy csökkentsük a lemezek terhelését, még a innodb_parallel_doublewrite_path -ot is áthelyeztük a /dev/shm-be, ami egyes esetekben akár 5 másodpercet is spórolt nekünk egy nem megfelelően leállított példány indításánál.
Miért állítjuk le a MySQL-t, mielőtt pillanatfelvételt készítünk? Hiszen készíthetjük azt egy működő replikából is. Ez igaz, csak hogy az új DB példány a pillanatfelvétel alapján alapértelmezés szerint sérültnek számít, és teljes átvizsgálást igényel az indításkor. A replikát leállítani egyértelműen gyorsabb, bár ez végül a legidőigényesebb művelet az egész folyamatban.
Ennek eredményeként sokkal elfogadhatóbb időzítéseket és működésre kész standot kaptunk. Bár, ahogy a fő replikának a replikációs késedelmét bemutató grafikon is mutatja, a helyzet még mindig messze van az ideáltól:
Más hátrányok között említést érdemel a Thin LVM medence megfigyelésének gyakorlatilag lehetetlensége: a rendszeres standard iostat funkciók mellett például nem lehet megérteni, hogy a medence melyik eleme termel a legnagyobb terhelést a fájlrendszeren.
Külön említést érdemel egy nagy hátrány, amely a fentebb említett optimalizálással kapcsolatos: YOLO standot kaptunk. Körülbelül havonta egyszer vagy kétszer az ext4 nem bírta el az ilyen mértékű megterhelést, és visszafordíthatatlanul megsérült, újraformázást és a replikasor megújítását igényelve. Sebességet nyerve, reménytelenül tönkretettük a stabilitást.
Milyen metrikákra érdemes figyelni a Thin LVM üzemeltetése során:
- Thin pool adathányad %
- Thin pool metadathányad %
Ha a megdöbbentő adathely hiányát a standunk túléli (elég, ha megtisztítjuk a lemezeket), akkor a metadathányad hiánya a medence teljes összeomlásához és annak nulláról való újralétrehozásához vezet.
A fájlrendszer a medencében idővel nagyon erősen töredezik. Javaslom, hogy napi egyszer indítsuk el a krónikus parancsot: fstrim -v /var/lib/mysql.
Közbenső következtetések:
- A technológia könnyen alkalmazható, akárcsak maga az LVM, és nem igényel különösebb szaktudást a mérnöktől.
- Kiválóan alkalmas kis méretű és nem túl leterhelt adatbázisokhoz. Minél kisebb az adatbázis, annál kevesebb chunk mozog a fájlrendszeren belül a medencében, és annál alacsonyabb a lemezek terhelése.
- Feladatunkhoz más megoldásokat kezdtünk keresni, amiről a következő szakasz szól.
A második stand, a ZFS technológia
Régen foglalkoztam a ZFS fájlrendszerrel, de akkor a ZFS kétségtelenül jól működött saját natív operációs rendszer családjában, a Solarisban. Volt egy FreeBSD-re portolt verzió, amely elég jó szintű megvalósítással rendelkezett. Ezen kívül létezett egy befejezetlen port Linuxra, amit alig használtak. Az adatszerkezet B-fájl (amúgy ugyanúgy, mint az InnoDB MySQL esetében) miatt a ZFS nem teljesített jól olyan telepítéseken, ahol nagyon sok fájl volt. Mindez együtt azzal, hogy előzetesen tanulmányozni kellett a technikai részleteket, hosszú időre kizárta ezt a fájlrendszert a gyakorlatomból. Megjelentek az ext4 és xfs fájlrendszerek, amelyek standarddá váltak. De figyelembe véve, hogy a ZFS bőven megfelel a feladatunkhoz, és a Linux verziója, a visszajelzések szerint, egy teljesen megfelelő termékké fejlődött (bár nem teljes támogatottsággal, ezért a ZFS-re teljesen az elejétől rendszert telepíteni csak különféle trükkökkel lehet), úgy döntöttünk, hogy kipróbáljuk.
Nyilvánvaló okokból egy hasonló konfigurációjú állomást választottunk (kivéve a RAID vezérlőt). Nyolc 1920 GB-os SSD-t telepítettünk. Nem volt kedvünk saját hálózati képet készíteni a ZFS gyámról, ezért az összes lemezből levágtunk 50 GB-ot és ebből MD RAID-10 rendszert készítettünk. A maradék 1950 GB-ot minden lemezen a ZFS RAID-10 analógjává egyesítettük:
zpool create zpool mirror /dev/sda2 /dev/sdb2 mirror /dev/sdc2 /dev/sdd2 mirror /dev/sde2 /dev/sdf2 mirror /dev/sdg2 /dev/sdh2Készítettünk partíciókat a MySQL számára:
zfs create zpool/mysql
zfs set compression=gzip zpool/mysql
zfs set recordsize=128k zpool/mysql
zfs set atime=off zpool/mysql
zfs create zpool/mysql/data
zfs set recordsize=16k zpool/mysql/data
zfs set primarycache=metadata zpool/mysql/data
zfs set mountpoint=/var/lib/mysql zpool/mysql/data
Figyeljünk arra, hogy bekapcsoltuk a hivatalos gzip adatsűrítést. Sok processzoreforrással rendelkezünk a szerveren, és azok nincsenek teljesen kihasználva. Ennek eredményeként a 3 TB-os adatbázisunk 1,6 TB-ra zsugorodott, és mivel a gyenge láncszem, ahogy a múltban is, a lemezek maximális teljesítménye, minél kevesebb adatunk van, annál jobb; az elejétől egy remek bónuszt kapunk a ZFS-től! Csúcsidőben, teljes terhelés mellett a gzip fenntartása akár 4 magot is igényel, de nekünk ez nem okoz gondot.
A továbbiakban a bevezetés gyorsabban haladt. Az LVM állomásról másoltuk a MySQL replikációs beállításokat. Költöttünk egy kis időt a ZFS parancsokra való átírásra, de alapvetően az algoritmusok ugyanazok maradtak. Példa egy pillanatkép létrehozására:
zfs set snapdir=visible zpool/mysql/data
zfs create zpool/stage_3307
zfs clone zpool/mysql/data@snapmain zpool/stage_3307/data
zfs set mountpoint=/mnt/stage_3307 zpool/stage_3307/data
A további finomhangolás keretében: a ZFS szétválasztottuk a metadatákat és a naplókat az l2arc és zil memóriájába. A feladatunkhoz ez, mint később kiderült, felesleges volt, de egyelőre fenntartottuk ezt az optimalizálást, mert szükség esetén könnyen módosítható. A negatív hatások közé tartozik, hogy a szerver újraindítása után újra létre kell hozni a megfelelő memóriaterületeket. Az alábbiakban a zpool status kivágása:
logs
      /dev/shm/zil_slog.img  ONLINE       0     0     0
cache
      /dev/shm/l2arc.img     ONLINE       0     0     0
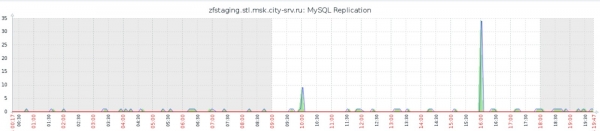
Ebben a konfigurációban elkezdtük tesztelni a standot, és nagyszerű eredményeket kaptunk: két egyidejűleg működő adatbázis példánnyal (és aktív fő replikával) a snapshotokon a lemezterhelés 50-60% volt.
Megszabadultunk a legfontosabb problémánktól, amit a replikálás késleltetésének grafikonja is mutat (hasonlítsa össze a korábbi grafikonokkal a Thin LVM szekcióban):
Ezen kívül, ennek köszönhetően, minden műveletben jelentősen felgyorsultunk: egy teljes snapshot létrehozása a replikálás leállításával és indításával legfeljebb 40 másodpercet vesz igénybe, míg egy új MySQL példány telepítése a snapshotból legfeljebb 20 másodpercig tarthat. Ez mindkettőnket és a kód tesztjeinket is teljes mértékben kielégíti.
Közbenső következtetések:
- Az eredmények teljes mértékben kielégítették a szükségletünket egy éles adatbázis másolatának megszerzésére a kód teszteléséhez.
- A technológia megértést igényel: tudnia kell, mi az a ZFS és hogyan kell vele dolgozni.
- Nem ellenőriztük a ZFS aktuális működési állapotát nagy mennyiségű (1 milliótól) kis fájloknál. De feltételezzük, hogy a probléma fennáll, ezért nem javasolnám ezt a fájlrendszert semmilyen fájltárolóhoz.
Mi következik?
A stand-alone setup does not require further adjustments; we are satisfied with the result. In the future, we may add table exclusions for replication settings that are unnecessary for testing, which will further reduce the database size. We have not tested the BTRFS system and its implementation of thin provisioning. However, that task is not a priority anymore since the main goal has been achieved. Overall, we want to move away from the previously described approach—implementing working database migrations into the test environment, creating a separate database testing circuit, and addressing the sharding of the main database. Many of these initiatives are already in progress, and we will definitely share updates in forthcoming articles.
Összegzés
The initial task was accomplished, albeit in an unconventional manner. The intermediate results outlined the advantages and disadvantages of each technology employed, so let’s decide which technology can be used and when:
- Thin LVM — suitable for small databases and when there is neither the desire nor the time to study ZFS.
- ZFS — if there is experience working with it or the ability to dedicate time to learning in any situation.
At a higher level, this article is not just a comparison of the two file system technologies. The main idea I’d like to convey and emphasize is that one should not be afraid to think outside the box in business-critical situations and rely solely on ready-made solutions. There was a time when our entire technical department could shake their heads and declare that creating three-terabyte database backups in under a minute was impossible, and that we don’t need risky technologies; let’s just do it the right way. That could have been feasible, but we would have lost around six months to a year and many client trips (travel being our primary business metric) without testing and during deployment. By taking an unconventional approach, we did not spend as much time on implementation, gained experience in both new and previously neglected technologies, and provided testing precisely when we needed it most. Undoubtedly, this positively impacted all our metrics. The choice is always yours, and we, from our side, will continue to share interesting current and future achievements in our blog.
Forrás: habr.com
