

Minden jót!
Nekem Nikita a nevem, a Циан mérnöki csapatának csapatvezetője vagyok. Az egyik feladatom a cégnél az, hogy az infrastrukturális események számát a termelési környezetben nullára csökkentsem.
A következőkben szó lesz arról, ami sok fájdalmat okozott nekünk, és cikkem célja, hogy másokat ne engedjük megismételni a hibáinkat, vagy legalább minimalizáljuk azok hatását.
Előszó
Réges-régen, amikor a Циан monolitikus volt, és a mikroszolgáltatásoknak nyoma sem volt, a forrás elérhetőségét 3-5 oldal ellenőrzésével mértük.
Ha válaszolnak — minden rendben, ha hosszú ideig nem válaszolnak — riasztás. Mennyi ideig kell nem működniük ahhoz, hogy ezt eseménynek számítsák, az a megbeszéléseken dőlt el. A mérnökkör mindig részt vett az események kivizsgálásában. Amikor a vizsgálat véget ért, posztmortemot írtunk — egyfajta jelentést küldtünk e-mailben a formátumban: mi történt, mennyi ideig tartott, mit tettünk abban a pillanatban, mit fogunk tenni a jövőben.
A weboldal főoldalai, vagy hogyan tudjuk, hogy elértük a mélypontot
Ahhoz, hogy valahogy megértsük a hiba prioritását, kiemeltük a legfontosabb üzleti funkciókhoz kapcsolódó weboldalakat. Ezeken mérjük az sikeres / sikertelen kérések és időtúllépések számát. Ily módon mérjük az üzemidőt.
Tegyük fel, hogy kiderült, hogy van néhány nagyon fontos szekció a weboldalon, amelyek a fő szolgáltatásért felelnek — hirdetések kereséséért és beküldéséért. Ha a hibával végződött kérések száma meghaladja az 1%-ot, az kritikus eseménynek számít. Ha a forgalmas időszakban 15 percen belül a hibák aránya meghaladja a 0,1%-ot, az szintén kritikus esemény. Ezek a kritériumok lefedik az események nagy részét, a többi nem témája ennek a cikknek.
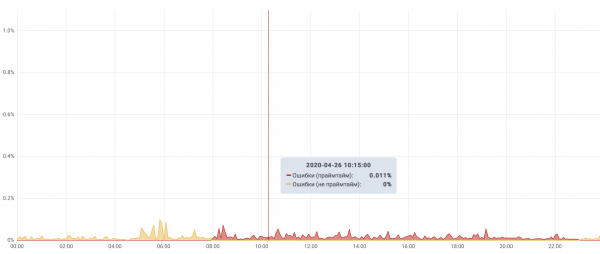
A Циан legjobb eseményeinek toplistája
Tehát biztosan megtanultuk megállapítani, hogy esemény történt.
Most minden esemény részletesen dokumentálva van, és Jirában epikusan tükröződik. Egyébként: ehhez külön projektet indítottunk, amit FAIL-nak neveztünk — csak epikokat lehet benne létrehozni.
Ha összegyűjtjük az elmúlt évek összes kudarcát, az élen állnak:
- mssql-hez kapcsolódó események;
- külső tényezők által okozott események;
- adminisztrátori hibák.
Most részletesebben foglalkozunk az adminisztrátori hibákkal, valamint néhány más érdekes kudarccal.
Ötödik hely — "Rendrakás a DNS-ben"
Ez egy borongós kedd volt. Elhatároztuk, hogy rendbe tesszük a DNS klasztert.
Úgy döntöttünk, hogy a belső dns-szervereket bindről powerdns-re állítjuk át, teljesen külön szerverekre, ahol csak dns működik.
Egy dns-szervert helyeztünk el minden adatközpontunk különböző helyszínein, és elérkezett a pillanat, hogy átkonvertáljunk a bindről powerdns-re, valamint az infrastruktúrát az új szerverekre állítsuk.
A migráció leghevesebb időszakában az összes, a helyi cachelési bindben megadott szerver közül csak egy maradt, ami a Szentpétervári adatközpontban volt. Ez az adatközpont kezdetben nem volt kritikus számunkra, de hirtelen single point of failure lett. szerverekPont abban az időszakban, amikor a migráció zajlott, leállt a kapcsolat Moszkva és Szentpétervár között. Gyakorlatilag öt percig DNS nélkül maradtunk, és csak akkor álltunk vissza, amikor
a hibákat elhárították. the host Ha korábban figyelmen kívül hagytuk a külső tényezőket a munkák előkészítése során, most ezeket is beleszámoltuk abba, amire fel kell készülnünk. Most már arra törekszünk, hogy minden komponens n-2 szinten legyen fenntartva, és a munkák idejére ezt a szintet n-1-re tudjuk csökkenteni.
Következtetések:
A cselekvési terv összeállítása során jelöljük ki azokat a pontokat, ahol a szolgáltatás leállhat, és gondoljuk át a forgatókönyvet, amikor minden a legrosszabbul alakul, előre.
- Terjessze el a belső dns-szervereket különböző geolokációk/adatközpontok/szekrények/switch-ek/bemenetek között.
- Minden szerveren telepítsen egy helyi cachelő dns-szervert, amely az alap dns-szerverekre irányítja a kéréseket, és ha ez nem elérhető, akkor a cache-ből válaszol.
- A negyedik pont – „Rendet rakunk az Nginx-ben”
Egy szép napon csapatunk úgy döntött, hogy "ennyi elég", és elindult az nginx konfigurációk átstrukturálása. Fő célunk az volt, hogy intuitív struktúrába hozzuk a konfigokat. Korábban minden "történelmileg kialakult" volt, és semmiféle logikát nem hordozott. Most minden server_name-t saját nevű fájlba vittünk, és a konfigokat mappákba osztottuk. Megjegyzendő, hogy a konfig 253949 sorból vagy 7836520 karakterből áll, és közel 7 megabájt helyet foglal el. A struktúra legfelső szintje:
Nginx struktúra
Nginx struktúra
├── hozzáférés
│   ├── allow.list
...
│   └── whitelist.conf
├── geobase
│   ├── exclude.conf
...
│   └── geo_ip_to_region_id.conf
├── geodb
│   ├── GeoIP.dat
│   ├── GeoIP2-Country.mmdb
│   └── GeoLiteCity.dat
├── inc
│   ├── error.inc
...
│   └── proxy.inc
├── lists.d
│   ├── bot.conf
...
│   ├── dynamic
│   └── geo.conf
├── lua
│   ├── cookie.lua
│   ├── log
│   │   └── log.lua
│   ├── logics
│   │   ├── include.lua
│   │   ├── ...
│   │   └── utils.lua
│   └── prom
│       ├── stats.lua
│       └── stats_prometheus.lua
├── map.d
│   ├── access.conf
│   ├── ..
│   └── zones.conf
├── nginx.conf
├── robots.txt
├── server.d
│   ├── cian.ru
│   │   ├── cian.ru.conf
│   │   ├── ...
│   │   └── my.cian.ru.conf
├── service.d
│   ├── ...
│   └── status.conf
└── upstream.d
    ├── cian-mcs.conf
    ├── ...
    └── wafserver.conf
Jelentősen javult, de a konfigurációk átnevezése és elosztása során néhány hibás kiterjesztésűvé vált, és nem került bele az include *.conf direktívába. Ennek következményeként egyes hosztok elérhetetlenné váltak, és 301-es választ adtak a főoldalra. Mivel a válaszkód nem 5xx/4xx volt, ezt nem vették észre azonnal, csak reggelre. Ezt követően elkezdtük írni a teszteket az infrastruktúra komponensek ellenőrzésére.
Következtetések:
- Helyesen struktúráld a konfigurációkat (nem csak az nginx esetében), és gondold át a struktúrát a projekt korai szakaszában. Ezzel érthetőbbé teszed őket a csapat számára, ami csökkenti a TTM-et.
- Néhány infrastruktúra komponenshez írj teszteket. Például: ellenőrizd, hogy minden kulcsfontosságú server_name a megfelelő státuszt adja vissza, + a válasz törzsét. Elég, ha csak pár szkripted van, amelyek ellenőrzik a komponens alapfunkcióit, hogy ne kelljen három óra után kapkodva felidézni, hogy mit kell még ellenőrizni.
Harmadik hely — „Hirtelen elfogyott a hely a Cassandrán”
Az adatok fokozatosan növekedtek, és minden jól ment, amíg a Cassandra klaszterben a nagy case space-ek repair-jei elkezdtek megbukni, mert a tömörítés nem tudott működni rajtuk.
Egy borongós napon a klaszter majdnem tökfejjé változott, mégpedig:
- a klaszter összesen körülbelül 20%-os helyet hagyott magának;
- teljes nódokat nem lehet hozzáadni, mert a nód hozzáadása után nem történik cleanup a részlegeken a hely hiánya miatt;
- a teljesítmény fokozatosan csökken, mivel a tömörítés nem működik;
- a klaszter vészüzemmódban működik.
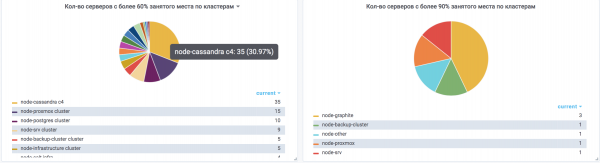
A kimenet — hozzáadtunk még 5 csomópontot cleanup nélkül, majd fokozatosan elkezdtük kivonni őket a klaszterből, és újra bevezetni, mint üres csomópontokat, ahol elfogyott a hely. Az eltöltött idő sokkal több, mint amit szeretnénk. Kockázat volt a klaszter részleges vagy teljes elérhetetlensége.
Következtetések:
- Minden Cassandra szerveren az egyes partíciók legfeljebb 60%-át szabad kihasználni.
- A CPU-t legfeljebb 50%-ig szabad terhelniük.
- Nem szabad elhanyagolni a kapacitás-tervezést, és azt minden komponens esetében meg kell fontolni a saját specifikációjának megfelelően.
- Minél több csomópont van a klaszterben, annál jobb. Azok a szerverek, amelyek kis mennyiségű adatot tárolnak, gyorsabban újraindíthatók, és ilyen klasztert könnyebb helyreállítani.
A második hely — "Eltűntek az adatok a consul key-value tárolóból"
A szolgáltatás-felfedezéshez mi, akárcsak sokan mások, a consolt használjuk. De nálunk a key-value párok még a monolit blue-green telepítésére is szolgálnak. Itt található az aktív és inaktív upstreamok információja, amelyek a telepítés során felváltják egymást. Ehhez írtunk egy telepítő szolgáltatást, amely kölcsönhatásba lépett a KV-vel. Egy bizonyos időpontban az adatok eltűntek a KV-ből. Emlék alapján állítottuk vissza őket, de számos hibával. Ennek következtében a telepítés során a terhelés egyenlőtlenül oszlott meg az upstreamok között, és számos 502-es hibát kaptunk a backendek CPU-terhelése miatt. Végül PostgreSQL-re váltottunk a consul KV-ről, ahonnan az adatokat már nem olyan egyszerű eltávolítani.
Következtetések:
- Azok a szolgáltatások, amelyek nem igényelnek semmiféle hitelesítést, nem tartalmazhatnak kritikus adatokat a webhely működéséhez. Például, ha nincs hitelesítés az ES-ben, akkor a hozzáférést a hálózati szinten kellene megtiltani mindenhonnan, ahol nem szükséges, és csak a szükséges hozzáférést kellene fenntartani, valamint be kellene állítani az action.destructive_requires_name: true értéket.
- Gyakorolják a biztonsági másolat készítésének és helyreállításának mechanizmusát előre. Például készítsetek előre egy scriptet (például Pythonban), amely képes biztonsági másolatot készíteni és helyreállítani.
Az első hely — "Kapitány a nyilvánvaló"
Egy ponton észrevettük, hogy a terhelés egyenlőtlenül oszlik el az Nginx upstreamok között, amikor a háttérben 10+ szerver volt. Mivel a round-robin az első upstreamtól az utolsóig, sorrendben irányította a kéréseket, és minden Nginx újratöltés után kezdett elölről, az első upstreamokhoz mindig több kérés érkezett, mint a többiekhez. Ennek következtében lassabban működtek, és szenvedett az egész webhely. Ez egyre észrevehetőbbé vált a forgalom növekedésével. Egyszerűen frissíteni az Nginxet a random funkció beiktatásához nem volt elegendő — sok lua kódot át kellett dolgozni, amely nem működött az 1.15-ös verzión (akkor). Így végül meg kellett patchelnünk az Nginx 1.14.2-t, hogy támogassa a random-ot. Ez megoldotta a problémát. Ez a hiba a "nem nyilvánvaló kapitány" címét nyeri.
Következtetések:
Nagyon érdekes és izgalmas volt felfedezni ezt a hibát).
- Állítsa be a monitorozást úgy, hogy segítse gyorsan megtalálni az ilyen ingadozásokat. Például használhatja az ELK-t, hogy nyomon kövesse az RPS-t minden háttérben lévő upstreamhoz, figyelemmel kísérve azok válaszidejét az Nginx szempontjából. Ebben az esetben ez segített felfedni a problémát.
A nagyobb része a hibáknak elkerülhető lett volna, ha alaposabban megközelítjük, amit csinálunk. Mindig emlékeznünk kell Murphy törvényére: Ami rosszul sikerülhet, az rosszul is fog sikerülni, és az összes komponenst ennek megfelelően kell építeni.
Forrás: habr.com
