

Projektjeinkben mikroszolgáltatás-architektúrát használunk. Teljesítmény szűk keresztmetszeteinek felmerülésekor sok időt töltünk a naplózás monitorozásával és elemezésével. Amikor egyes műveletek időzítéseit naplófájlba írjuk, általában nehéz megérteni, hogy mi okozta ezen műveletek meghívását, nyomon követni a lépések sorrendjét, vagy az egyik művelet időzítési eltérését a másikkal szemben különböző szolgáltatásokban.
A manuális munka minimalizálása érdekében úgy döntöttünk, hogy igénybe veszünk egy nyomkövetési eszközt. Ebben a cikkben arról lesz szó, hogy hogyan és mire használható a nyomkövetés, valamint hogyan hajtottuk végre ezt.
Milyen problémákat lehet megoldani a nyomkövetés segítéségével
- Ajánlott megtalálni a teljesítmény szűk keresztmetszeteit, akár egyetlen szolgáltatáson belül, akár az összes résztvevő szolgáltatás közötti végrehajtási fában. Például:
- Sok rövid egymás utáni hívás a szolgáltatások között, például geokódolás vagy adatbázis hívása.
- Hosszú várakozások a bemenet-kiadás terén, például adatok továbbítása a hálózaton vagy olvasás lemezről.
- Hosszan tartó adatok parszolása.
- Hosszú műveletek, amelyek CPU-t igényelnek.
- Olyan kódblokkok, amelyek nem szükségesek a végső eredmény megszerzéséhez, és eltávolíthatók, vagy elhalaszthatók.
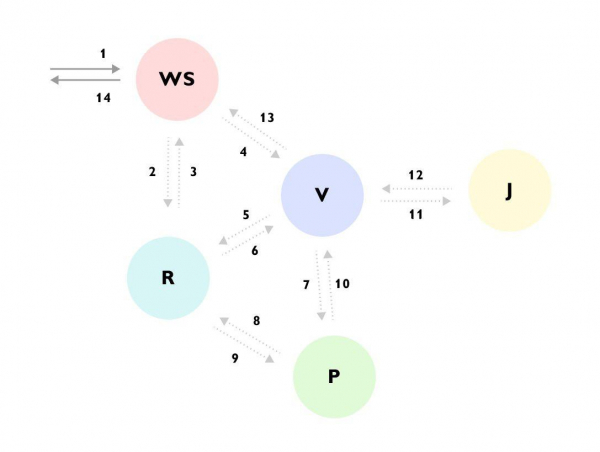
- Vizuálisan érthetővé válik, hogy milyen sorrendben történnek a meghívások és mi történik, amikor egy műveletet végrehajtanak.

Látszik, hogy például a Kérés megérkezett a WS szolgáltatáshoz -> a WS szolgáltatás kiegészítette az adatokat az R szolgáltatás segítségével -> majd továbbküldte a kérést a V szolgáltatásnak -> a V szolgáltatás sok adatot töltött le az R szolgáltatásból -> ellátogattunk a P szolgáltatáshoz -> a P szolgáltatás ismét meglátogatta az R szolgáltatást -> a V szolgáltatás figyelmen kívül hagyta az eredményt és elment a J szolgáltatáshoz -> és csak ezután küldött választ a WS szolgáltatásnak, miközben a háttérben még valamit számolt.
Ilyen nyomozás vagy részletes dokumentáció nélkül nagyon nehéz megérteni, mi történik, amikor először nézünk a kódra, és a kód különböző szolgáltatások között szóródik, rejtve számos bean és interfész mögött. - Információk gyűjtése a végrehajtási fááról a további késleltetett elemzés érdekében. A végrehajtás minden szakaszában a nyomozásba olyan információt adhatunk hozzá, amely az adott szakaszban elérhető, és később kideríthetjük, milyen bemeneti adatok vezettek ehhez a forgatókönyvhöz. Például:
- Felhasználó ID
- Jogosultságok
- A kiválasztott módszer típusa
- A napló vagy a végrehajtási hiba
- A nyomvonalak átalakítása metrikák alhalmazává, és további elemzés már metrikaként.
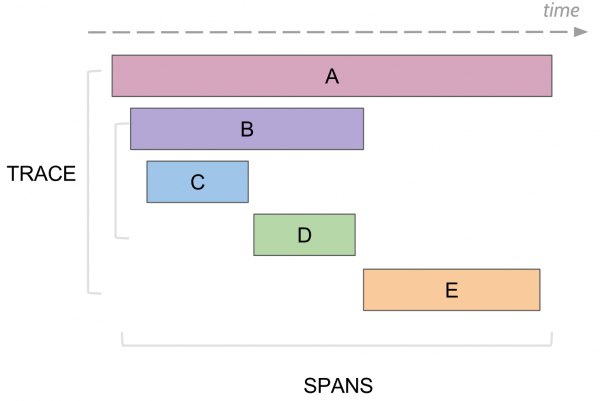
Mi tud naplózni a nyomvonal. Span
A nyomvonalban létezik a span fogalma, ez egy log párhuzama a konzolon. A spannek vannak:
- Név, általában ez a végrehajtott módszer neve
- Szolgáltatás neve, amelyben a span létrejött
- Saját egyedi azonosító
- Valamilyen meta információ key/value formátumban, amelyet naplóztak benne. Például a módszer paraméterei vagy hogy a módszer hibával végződött-e vagy sem
- Ennek a spannek a végrehajtásának kezdeti és befejezési időpontja
- Szülő span azonosító
Minden span a span gyűjtőhöz kerül, hogy eltárolja az adatbázisban a további megtekintés céljából, amint befejezte a futását. Később felépíthető az összes span fája a szülőazonosítók alapján. Elemzéskor például megtalálhatóak azok a spannek egy adott szolgáltatásban, amelyek meghaladták egy bizonyos időt. Ezután, ha rákattint egy konkrét spanra, látható az összes fa fentről és alulról e spannek.
Opentrace, Jaeger és hogyan valósítottuk ezt meg a projektjeinkben
Van egy közös szabvány , amely leírja, hogyan és mit kell összegyűjteni, anélkül, hogy a nyomvonalat egy nyelv konkrét megvalósításához kötnénk. Például Java esetén a nyomvonalakkal való munka a közös Opentrace API-n keresztül történik, ami mögött például a Jaeger vagy egy üres alapértelmezett implementáció áll, amely semmit sem csinál.
Nálunk a mint az Opentrace implementációja használatos. Több komponenst tartalmaz:
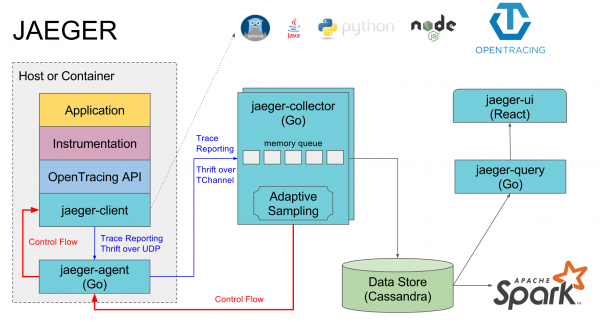
- Jaeger-agent — helyi ügynök, amely általában minden gépen fut, és a szolgáltatások logolnak a helyi alapértelmezett portra. Ha az ügynök nincs, akkor az összes szolgáltatás nyomvonala ezen a gépen általában le van tiltva
- Jaeger-collector — ebbe minden ügynök elküldi a begyűjtött nyomvonalakat, és ő azokat elhelyezi az kiválasztott adatbázisban
- Adatbázis — általában a Cassandra preferált náluk, de mi az Elasticsearch-t használjuk, van megvalósítás más pár adatbázis számára és egy in-memory implementáció, ami semmit sem tárol a lemezen
- Jaeger-query — ez a szolgáltatás, ami az adatbázisba megy és visszaadja a már összegyűjtött nyomvonalakat az elemzéshez
- Jaeger-ui — ez egy webes felület a nyomvonalak keresésére és megtekintésére, amely a jaeger-query-t használja
Külön komponensként említhető az Opentrace Jaeger megvalósítása konkrét nyelvekhez, amelyen keresztül a spannek a jaeger-agentbe kerülnek.
Az io.opentracing.Tracer interfész implementálására vonatkozik, ezután minden nyom követni lesz átküldve a valódi ügynökbe.
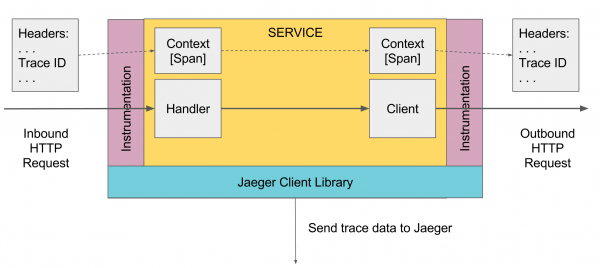
A Spring komponensekhez is csatlakoztatható és a Jaeger által biztosított implementáció amely automatikusan konfigurálja a nyomkövetést minden, ezen komponensek által átfolyó dologra, például HTTP kérések a kontrollerekbe, adatbázis-kérések JDBC-n keresztül stb.
Nyomok naplózása Java nyelven
Valahol a legfelső szinten létre kell hozni az első Span-t, ezt automatán egy Spring-vezérlő végezheti egy kérés érkezésekor, vagy manuálisan, ha nincs ilyen. Ezután átkerül a Scope alá. Ha egy alatta lévő módszer hozzá szeretne adni egy Span-t, a jelenlegi activeSpan-t a Scope-ból veszi, új Span-t hoz létre, megmondja, hogy a szülője a kapott activeSpan, és az új Span-t aktívvá teszi. A külső szolgáltatások hívásakor az aktuális aktív Span-t átadják nekik, és azok új Spans-t hoznak létre, amelyek ehhez a Span-hoz kapcsolódnak.
Mindez a Tracer példányon keresztül történik, amelyet a DI mechanizmuson keresztül lehet megszerezni, vagy a GlobalTracer.get() használatával mint globális változót, ha a DI mechanizmus nem működik. Alapértelmezés szerint, ha a tracer nincs inicializálva, a NoopTracer tér vissza, amely semmit sem csinál.
A tracet a ScopeManager-en keresztül a jelenlegi scope-ból szerzik meg, létrehoznak egy új scope-ot a jelenlegiből egy új span hozzákapcsolásával, majd a létrehozott Scope-t le is zárják, amely bezárja a létrehozott span-t és visszaállítja az előző Scope aktív állapotát. A Scope a szálhoz van kötve, ezért több szálas programozásnál nem szabad elfelejteni, hogy az aktív span-t át kell adni a másik szálnak, hogy a másik szál Scope-ját ehhez a span-hoz kapcsolják.
io.opentracing.Tracer tracer = ...; // GlobalTracer.get()

void DoSmth () {
   try (Scope scope = tracer.buildSpan("DoSmth").startActive(true)) {
      ...
   }
}
void DoOther () {
    Span span = tracer.buildSpan("someWork").start();
    try (Scope scope = tracer.scopeManager().activate(span, false)) {
        // Dolgozom.
    } catch(Exception ex) {
        Tags.ERROR.set(span, true);
        span.log(Map.of(Fields.EVENT, "error", Fields.ERROR_OBJECT, ex, Fields.MESSAGE, ex.getMessage()));
    } finally {
        span.finish();
    }
}

void DoAsync () {
    try (Scope scope = tracer.buildSpan("ServiceHandlerSpan").startActive(false)) {
        ...
        final Span span = scope.span();
        doAsyncWork(() -> {
            // 2. lépés fent: a Span újraaktiválása a callbackben, a startActive() false-ra állítása, ha a Span befejezése szükséges.
            try (Scope scope = tracer.scopeManager().activate(span, false)) {
                ...
            }
        });
    }
}
A párhuzamos programozáshoz szintén elérhető a TracedExecutorService és hasonló burkolók, amelyek automatikusan továbbítják a jelenlegi spant a szálba, amikor aszinkron feladatokat indítunk:
private ExecutorService executor = new TracedExecutorService(
    Executors.newFixedThreadPool(10), GlobalTracer.get()
);
Külső HTTP kérésekhez létezik
HttpClient httpClient = new TracingHttpClientBuilder().build();Problémák, amelyekkel szembesültünk
- A binek és a DI nem mindig működik, ha a tracer nem szolgáltatásban vagy komponensben van, akkor A Tracer nem működhet, és akkor a GlobalTracer.get() használatára van szükség.
- Az annotációk nem működnek, ha ez nem komponens vagy szolgáltatás, vagy ha a metódushívás egy szomszédos metódusból történik ugyanabban az osztályban. Óvatosnak kell lenni, ellenőrizni, mi működik, és manuális trace létrehozást kell használni, ha a @Traced nem működik. Ezenkívül hozzá lehet rendelni egy kiegészítő fordítót a java annotációkhoz, így mindenhol működniük kell.
- A régi spring és spring boot esetén az opentracing spring cloud automatikus konfigurációja nem működik a DI hibái miatt, így ha automatikusan szeretnénk, hogy a trace-ek működjenek a spring komponensekben, hasonlóan lehet eljárni, mint
- A groovy-ban nem működik a try with resources, mindenképpen használni kell a try finally-t.
- Minden szolgáltatásnál meghatározandó a saját spring.application.name, amely alatt a trace-ek naplózódnak. Ráadásul külön név a produkciós és teszt környezethez, hogy ne keveredjenek.
- Ha a GlobalTracer-t és a tomcat-ot használjuk, akkor minden, a tomcatban futó szolgáltatás ugyanazzal a GlobalTracer-rel rendelkezik, így mindenhol ugyanaz lesz a szolgáltatás neve.
- Trace-ek hozzáadásakor biztosnak kell lenni abban, hogy azt nem hívják meg sokszor ciklusban. Hozzá kell adni egy közös trace-et minden híváshoz, amely naplózza az összesített futási időt. Ellenkező esetben a felesleges terhelés jöhet létre.
- Egyszer a jaeger-ui-ban túl nagy kéréseket küldtünk egy nagy számú trace-ra, és mivel nem vártunk a válaszra, újra megpróbáltuk. Ennek eredményeként a jaeger-query sok memóriát használt és lelassította az elastic-et. A jaeger-query újraindítása segített.
Trace-ek mintavételezése, tárolása és megtekintése
Három típus létezik :
- Const, ami minden trace-t elküld és tárol.
- Probabilistic, ami a trace-eket egy megadott valószínűséggel kiszűri.
- A ratelimiter that limits the number of traces per second. These settings can be configured on the client, either on jaeger-agent or in the collector. Currently, we use const 1 in the stack of validators since the requests are not very frequent but take a considerable amount of time. In the future, if it causes excessive load on the system, a limit can be set.
If using Cassandra, it stores traces by default only for two days. We use and traces are stored indefinitely and are not deleted. A separate index is created each day, for example jaeger-service-2019-03-04. In the future, we need to set up automatic cleanup of old traces.
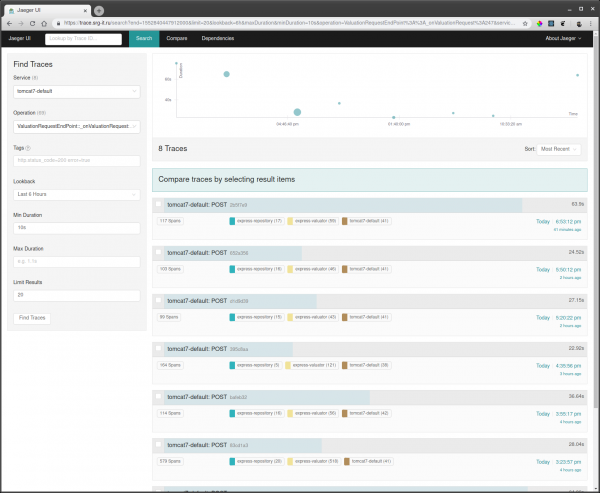
To view traces, you need to:
- Select the service to filter the traces by, for example, tomcat7-default for the service running in Tomcat, which cannot have its own name.
- Next, choose the operation, time interval, and minimum operation time, for example, from 10 seconds, to only retrieve long executions.

- Go to one of the traces and see what caused the slowdown.

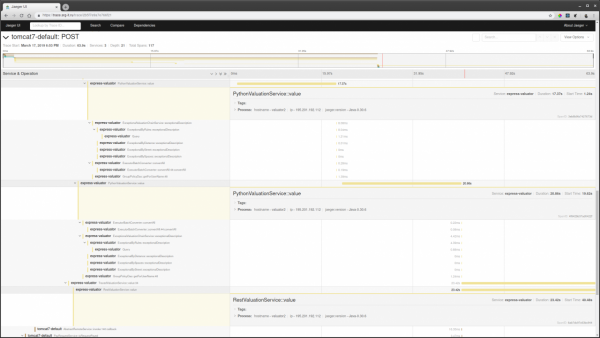
Also, if a request ID is known, you can find the trace by this ID through tag search if it is logged in the span trace.
kódkönyvtárra lépésével érheti el.
- OpenTracing documentation
- Jaeger documentation
- Connecting Jaeger Java
- Connecting Spring OpenTracing
Cikkek
- Jaeger OpenTracing and Microservices in a Real Project on PHP and Golang
- Evolving Distributed Tracing at Uber Engineering
- Running Jaeger Agent on bare metal
Video
- How We Used Jaeger and Prometheus to Deliver Lightning-Fast User Queries — Bryan Boreham
- Intro: Jaeger — Yuri Shkuro, Uber & Pavol Loffay, Red Hat
- Serghei Iakovlev, "A Short Story of a Great Victory: OpenTracing, AWS and Jaeger"
Forrás: habr.com
