

A Kubernetes teljes elsajátításához ismerni kell a klaszteres erőforrások skálázásának különböző módjait: ez az egyik legfontosabb feladat a Kubernetes-ben. Felkészítettünk egy átfogó áttekintést a horizontális és vertikális automatikus skálázás mechanizmusairól, valamint a klaszterek méretének megváltoztatásáról, és ajánlásokat adtunk arra, hogyan használhatjuk őket hatékonyan.
A cikket fordították le, akik megvalósították az automatikus skálázást a .
Miért fontos a skálázásra gondolni
— az erőforrások és az orkestráció kezelésére szolgáló eszköz. Természetesen érdemes foglalkozni a telepítési, monitorozási és pods kezelési funkciókkal is (a pod modul egy konténer csoport, amely a kérésekre válaszul indul el).
Ugyanakkor érdemes elgondolkodni az alábbi kérdéseken:
- Hogyan lehet skálázni a modulokat és alkalmazásokat?
- Hogyan tarthatók a konténerek működőképes és hatékony állapotban?
- Hogyan reagáljunk a kódban és a felhasználók által végzett munkákra bekövetkező állandó változásokra?
A Kubernetes klaszterek beállítása az erőforrások és a teljesítmény kiegyensúlyozására bonyolult feladat lehet, szakértelmet igényel a Kubernetes belső működéséről. Az alkalmazás vagy szolgáltatások terhelése a nap folyamán vagy akár egy órán belül is változhat, ezért a kiegyensúlyozást folyamatos folyamként érdemes elképzelni.
A Kubernetes automatikus skálázási szintjei
A hatékony automatikus skálázáshoz két szint közötti koordináció szükséges:
- A pod szint, amely magában foglalja a horizontális (Horizontal Pod Autoscaler, HPA) és vertikális automatikus skálázást (Vertical Pod Autoscaler, VPA). Ez a meglévő erőforrások skálázása a konténereid számára.
- A klaszter szint, amelyet a klaszter automatikus skálázó (Cluster Autoscaler, CA) kezel, amely növeli vagy csökkenti a klaszteren belüli csomópontok számát.
A horizontális automatikus skálázó modul (HPA)
Ahogy a névből is kiderül, az HPA a pod-replikák számát skálázza. Az replikák számának megváltoztatására a legtöbb devops szakember a processzor- és memóriahasználatot használja alapul. Azonban a rendszer a alapján is skálázható, azokat vagy akár .
A HPA működésének magas szintű ábrázolása:
- A HPA folyamatosan ellenőrzi az üzembe állításkor megadott metrikák értékeit, alapértelmezett 30 másodperces időközönként.
- A HPA próbálja növelni a modulok számát, ha egy megadott küszöböt elérnek.
- A HPA frissíti a replikák számát a telepítési/replikációs vezérlőn belül.
- A telepítési/replikációs vezérlő ezután telepíti az összes szükséges további modult.
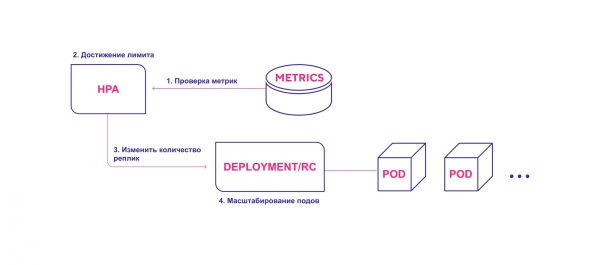
A HPA elindítja a modulok telepítési folyamatát, amikor a metrikák küszöbértékeit elérik.
A HPA használata során vegye figyelembe a következőket:
- A HPA alapértelmezett ellenőrzési időköze 30 másodperc. Ezt a kapcsoló határozza meg: horizontal-pod-autoscaler-sync-period a vezérlő kezelésében.
- Az alapértelmezett relatív hiba 10%.
- Az utolsó modulnövelés után a HPA három percig várja a metrikák stabilizálódását. Ezt az időtartamot a következő kapcsoló állítja be: horizontal-pod-autoscaler-upscale-delay.
- Az utolsó modulcsökkentés után a HPA öt percig várja a stabilizálódást. Ezt az időtartamot a következő kapcsoló határozza meg: horizontal-pod-autoscaler-downscale-delay.
- A HPA legjobban a telepítési objektumokkal működik, nem a replikációs vezérlőkkel. A horizontális automatikus skálázás nem kompatibilis a gördülő frissítéssel, amely közvetlenül manipulálja a replikációs kontrollereket. Telepítéskor a replikák száma közvetlenül a telepítési objektumoktól függ.
A podok függőleges automatikus skálázása
A függőleges automatikus skálázás (VPA) több (vagy kevesebb) CPU- vagy memóriaidőt biztosít a meglévő podok számára. Állapotait megőrző (stateful) vagy állapot nélküli (stateless) podok számára alkalmas, de elsősorban az stateful szolgáltatásokhoz van tervezve. Azonban alkalmazhatja a VPA-t állapot nélküli modulokkal is, ha szükséges az eredetileg kiosztott erőforrások automatikus kiigazítása.
A VPA reagál az OOM (out of memory, memóriahiány) eseményekre is. A CPU-idő és a memória mennyiségének megváltoztatásához a podok újraindítása szükséges. Az újraindításnál a VPA betartja az elosztási költségkeretet (), hogy garantálja a szükséges minimális modulok számát.
Beállíthatja a minimális és maximális erőforrást minden modulhoz. Így korlátozhatja a kiosztott memória maximális mennyiségét 8 GB-ra. Ez hasznos, ha a jelenlegi csomópontok pontosan nem tudnak 8 GB-nál több memóriát kiosztani a konténernek. A részletes specifikációk és a működés mechanizmusa a következő linken található .
Emellett a VPA-nak van egy érdekes ajánlási funkciója (VPA Recommender). Ez nyomon követi az erőforrások használatát és az OOM eseményeket minden modulban, hogy új memória- és processzorteljesítmény értékeket javasoljon egy intelligens algoritmus alapján, amely figyelembe veszi a történeti metrikákat. Van egy API is, amely elfogadja a pod leíróját, és visszaadja a javasolt erőforrásszámokat.
Érdemes megjegyezni, hogy a VPA Recommender nem követi a "limit" erőforrásokat. Ez azt eredményezheti, hogy a modul monopolizálja az erőforrásokat a csomópontokon belül. Jobb, ha korlátozást állít be a névtér szintjén, hogy elkerülje a hatalmas memória- vagy processzoridő-felhasználást.
A VPA működésének magas szintű sémája:
- A VPA folyamatosan ellenőrzi a telepítéskor megadott metrikák értékeit, alapértelmezett 10 másodperces időközönként.
- Ha elérik a megadott küszöböt, a VPA megpróbálja módosítani a kiosztott erőforrások mennyiségét.
- A VPA frissíti az erőforrások mennyiségét a telepítési/replikációs vezérlőn belül.
- A modulok újraindításakor az összes új erőforrás alkalmazva van a létrehozott példányokra.
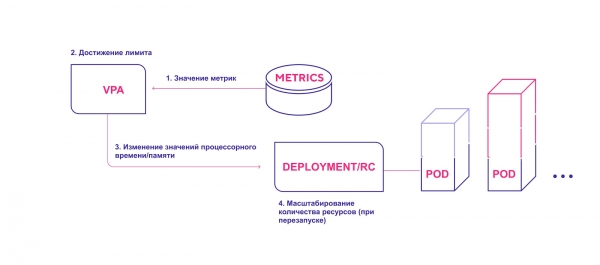
A VPA hozzáadja a szükséges erőforrások mennyiségét
Vegye figyelembe a következő szempontokat a VPA használata során:
- A skálázás kötelező pod újraindítást igényel. Ez szükséges a változtatások utáni instabil működés elkerülése érdekében. A megbízhatóság érdekében a modulok újraindítják és elosztják a csomópontokon az új kiosztott erőforrások alapján.
- A VPA és az HPA jelenleg nem kompatibilis egymással, és nem működhetnek ugyanazon podokon. Ha egy klaszterben mindkét skálázási mechanizmust alkalmazza, győződjön meg arról, hogy a beállítások nem engedik meg számukra, hogy ugyanazokon az objektumokon aktiválódjanak.
- A VPA a konténerek erőforrás-igényeit a múltbeli és a jelenlegi felhasználás alapján állítja be. Nem állít be erőforrás-felhasználási korlátokat. Problémák léphetnek fel, ha olyan alkalmazások működnek, amelyek egyre több erőforrást igényelnek, ami miatt a Kubernetes leállítja az adott podot.
- A VPA még fejlesztés alatt áll. Készüljön fel arra, hogy a közeljövőben a rendszer változásokon mehet keresztül. Olvassa el a és . A tervek között szerepel a VPA és a HPA együttműködésének megvalósítása, valamint modulok telepítése együtt a vertikális automatikus méretezés politikájával (például egy speciális címke: 'requires VPA').
Kubernetes klaszter automatikus méretezése
A Klaszter Automatikus Méretező (Cluster Autoscaler, CA) a várakozó podok száma alapján módosítja a csomópontok számát. A rendszer időnként ellenőrzi a várakozó modulok jelenlétét—és növeli a klaszter méretét, ha több erőforrásra van szükség, és ha a klaszter nem lépi túl a megadott korlátokat. A CA kommunikál a felhőszolgáltatóval, új csomópontokat kér tőle, vagy felszabadítja az inaktívakat. Az első nyilvános CA verzió a Kubernetes 1.8-ban jelent meg.
A CA működésének magasszintű vázlata:
- A CA alapértelmezett 10 másodperces időközönként ellenőrzi a várakozó modulok jelenlétét.
- Ha egy vagy több modul várakozik, mert a klaszterben nincs elég elérhető erőforrás a telepítésükhöz, próbál egy vagy több új csomópontot elindítani.
- Amikor a felhőszolgáltató az szükséges csomópontot biztosítja, az csatlakozik a klaszterhez és készen áll a podok kezelésére.
- A Kubernetes ütemező a várakozó modulokat az új csomópontra osztja be. Ha ezután egyes modulok még mindig várakoznak, a folyamat megismétlődik—új csomópontok kerülnek a klaszterbe.
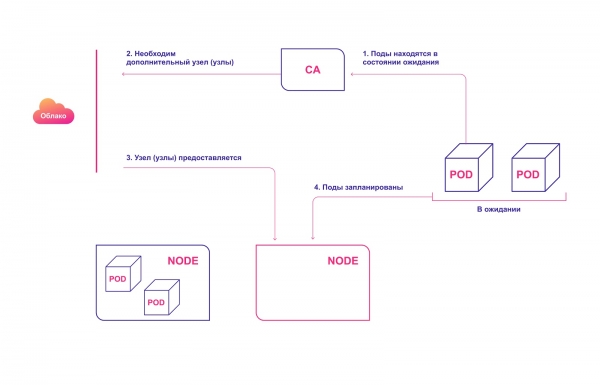
Automatikus csomópont-kijelölés a felhőben
A CA használatakor vegye figyelembe a következőket:
- A CA garantálja, hogy a klaszter minden modulja számára van hely az indításhoz, függetlenül a processzor terhelésétől. Ezen kívül megpróbálja garantálni, hogy a klaszterben nincsenek felesleges csomópontok.
- A CA körülbelül 30 másodpercen belül észleli a méretezési igényt.
- Miután egy csomópont feleslegessé válik, a CA alapértelmezés szerint 10 percet vár, mielőtt méretezné a rendszert.
- A automatikus skálázási rendszerben található a kiterjesztők (expanders) fogalma. Ezek különböző stratégiák a csomópontok csoportjának kiválasztására, ahová újakat adnak hozzá.
- Felelősen használja az opciót cluster-autoscaler.kubernetes.io/safe-to-evict (true). Ha túl sok pod-ot állít be, vagy ha azok sok helyen szétszórva vannak a csomópontok között, nagymértékben elveszíti a klaszter csökkentésének lehetőségét.
- Használja , hogy megakadályozza a pod-ok eltávolítását, ami miatt alkalmazása egy része teljesen leállhat.
Hogyan interakcióznak a Kubernetes automatikus skálázó rendszerei egymással
A tökéletes harmónia érdekében érdemes alkalmazni az automatikus skálázást a pod szinten (HPA/VPA) és a klaszter szinten is. Ezek viszonylag egyszerűen kommunikálnak egymással:
- Az HPA vagy VPA frissíti a pod-ok replikáit vagy a meglévő pod-okhoz hozzárendelt erőforrásokat.
- Ha a tervezett méretezéshez nincs elegendő csomópont, a CA észleli a várakozó pod-okat.
- A CA új csomópontokat allokál.
- A modulok új csomópontokra oszlanak el.
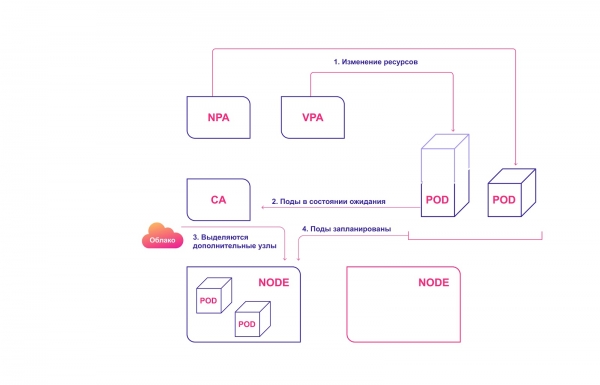
Kubernetes méretező rendszerek közös rendszere
Tipikus hibák a Kubernetes automatikus skálázásában
Több tipikus problémával találkoznak a devops szakemberek, amikor megpróbálják alkalmazni az automatikus skálázást.
A HPA és VPA metrikáktól és néhány történeti adatból függenek. Ha nem áll rendelkezésre elegendő erőforrás, a modulok összeomlanak, és nem tudják generálni a metrikákat. Ebben az esetben az automatikus skálázás soha nem fog megvalósulni.
Magának a méretezési műveletnek időérzékenynek kell lennie. Azt akarjuk, hogy a modulok és a klaszter gyorsan méreteződjenek — még mielőtt a felhasználók észlelnének bármilyen problémát vagy hibát. Ezért figyelembe kell venni a pod-ok és a klaszter átlagos méretezési idejét.
Ideális esetben — 4 perc:
- 30 másodperc. Célmetrikák frissítése: 30−60 másodperc.
- 30 másodperc. Az HPA ellenőrzi a metrikák értékét: 30 másodperc.
- Kevesebb mint 2 másodperc. A pod modulok létrejönnek és várakozó állapotba kerülnek: 1 másodperc.
- Kevesebb mint 2 másodperc. A CA észleli a várakozó modulokat és hívásokat indít az új csomópontok előkészítésére: 1 másodperc.
- 3 perc. A felhőszolgáltató kiosztja a csomópontokat. A K8s vár, amíg készen állnak: legfeljebb 10 perc (több tényezőtől függ).
A legrosszabb (realistább) forgatókönyv — 12 perc:
- 30 másodperc. A célméretek frissítése.
- 30 másodperc. Az HPA ellenőrzi a metrikák értékeit.
- Kevesebb mint 2 másodperc. A pod modulok létrejönnek és várakozó állapotba kerülnek.
- Kevesebb mint 2 másodperc. A CA látja a várakozó modulokat, és hívásokat küld a csomópontok előkészítésére.
- 10 perc. A felhőszolgáltató kiosztja a csomópontokat. A K8s vár, amíg készen állnak. A várakozási idő több tényezőtől függ, például a szolgáltató késlekedésétől, az operációs rendszer késlekedésétől, a segédprogramok működésétől.
Ne keverje össze a felhőszolgáltatók skálázási mechanizmusait a mi CA-nkkal. Az utóbbi a Kubernetes klaszteren belül működik, míg a felhőszolgáltató mechanizmusa a csomópontok elosztásán alapul. Nincs rálátása, hogy mi történik a pod-jaival vagy az alkalmazásával. Ezek a rendszerek párhuzamosan működnek.
Hogyan kezeljük a skálázást a Kubernetesben
- A Kubernetes egy erőforráskezelő és orkestráló eszköz. A pod-ok és a klaszter erőforrásainak kezelésének műveletei kulcsfontosságú mérföldkövet jelentenek a Kubernetes elsajátításában.
- Ismerje meg a pod-ok skálázhatóságának logikáját az HPA és VPA figyelembevételével.
- A CA-t csak akkor érdemes használni, ha jól érti a saját pod-jainak és konténereinek szükségleteit.
- A klaszter optimális beállításához meg kell értenie, hogyan működnek együtt a különböző skálázási rendszerek.
- A skálázás idejének értékelésekor vegye figyelembe a legrosszabb és legjobb forgatókönyveket.
Forrás: habr.com
