

Valószínűleg ma már senkinek sem kérdés, miért fontos a szolgáltatások metrikáinak gyűjtése. A következő logikus lépés a gyűjtött metrikákra alapozott riasztások beállítása, amelyek értesítik a zökkenőmentes adateltérésekről az Ön által preferált csatornákon (e-mail, Slack, Telegram). A szállodai online foglalási szolgáltatásunkban minden metrikánk az InfluxDB-be áramlik, és a Grafana-ban jelenik meg, ahol az alapvető riasztások is be vannak állítva. Az olyan feladatokhoz, mint például "számolja ki ezt és hasonlítsa össze ezzel", a Kapacitort használjuk.
A Kapacitor a TICK-stack része, amely képes feldolgozni az InfluxDB-ből származó metrikákat. Összekapcsolhatja a különböző méréseket (join), kiszámolhat valami hasznosat az így kapott adatokból, visszaírhatja az eredményt az InfluxDB-be, és riasztást küldhet Slackra/Télégramra/e-mailre.
Az egész stack nagyon menő és részletes , de mindig akadnak olyan hasznos dolgok, amelyek kifejezetten nem találhatóak a kézikönyvekben. Ebben a cikkben összeállítottam néhány ilyen hasznos, nem nyilvánvaló tanácsot (a TICKscript alapvető szintaxisát leírtam ) és bemutatom, hogyan alkalmazhatók az egyik feladatunk példáján.
Kezdjük!
float & int, számítási hibák
Ez egy teljesen szokványos probléma, ami átkonvertálással megoldható:
var alert_float = 5.0
var alert_int = 10
data|eval(lambda: float("value") > alert_float OR float("value") < float("alert_int"))
default() használata
Ha a címke/mező nincs kitöltve, számítási hibák lépnek fel:
|default()
        .tag('status', 'empty')
        .field('value', 0)
fill a join-ban (inner vs outer)
Alapértelmezés szerint a join eldobja azokat a pontokat, ahol nincsenek adatok (inner).
A fill('null') alkalmazásával outer join-t végez, amely után default()-ot kell alkalmazni, hogy kitöltse az üres értékeket:
var data = res1
    |join(res2)
        .as('res1', 'res2')
        .fill('null')
    |default()
        .field('res1.value', 0.0)
        .field('res2.value', 100.0)
Itt van azonban egy árnyalat. Ha a fenti példában az egyik sorozat (res1 vagy res2) üres, akkor az eredmény sorozat (data) is üres lesz. Erről több issue található a GitHubon (,, , ) - várjuk a javításokat és egy kicsit szenvedünk.
Kondicionálók használata a számításokban (if a lambda-ban)
|eval(lambda: if("value" > 0, true, false)
Az utolsó öt perc a pipeline-ból az időszakra
Például, ha össze kell hasonlítania az utolsó öt perc értékeit az előző héttel. Két külön batch-enként vehet igénybe két adathalmazon, vagy kinyerhet egy részt egy nagyobb időszakból:
|where(lambda: duration((unixNano(now()) - unixNano("time"))/1000, 1u) < 5m)
Az utolsó öt perc alternatívája lehet a BarrierNode használata, amely korábban megszűri az adatokat a megadott időpont előtt:
|barrier()
        .period(5m)
Példák a Go-alapú sablonok használatára az üzenetekben
A sablonok a csomag formátumának felelnek meg , az alábbiakban néhány gyakran előforduló feladat.
if-else
Rendbe hozzuk a dolgokat, és nem zavarjuk a népet a felesleges szöveggel:
|alert()
    ...
    .message(
        '{{ if eq .Level "OK" }}Most már rendben van{{ else }}Főnök, minden tönkrement{{end}}'
    )
Két tizedesjegy az üzenetben
Javítjuk az üzenet olvashatóságát:
|alert()
    ...
    .message(
        'most az érték {{ index .Fields "value" | printf "%0.2f" }}'
    )
Változók kibővítése az üzenetben
Több információt adunk az üzenethez a "Miért üvölt?" kérdés megválaszolásához:
var warnAlert = 10
  |alert()
    ...
    .message(
       'Ma az érték kevesebb mint '+string(warnAlert)+'%'
    )
Egyedi azonosító az riasztásnak
Hasznos, amikor az adatokban több csoport van, különben csak egy riasztás generálódik:
|alert()
      ...
      .id('{{ index .Tags "myname" }}\/{{ index .Tags "myfield" }}')
Egyedi handlerek
A hosszú handlerrészben van exec, amely lehetővé teszi a saját szkriptünk végrehajtását a megadott paraméterekkel (stdin) – csak a kreativitás számít!
Az egyik egyedi megoldásunk egy kis Python szkript a Slack értesítések küldésére.
Először azt akartuk, hogy az üzenetben egy grafana-ból származó, hitelesítéssel védett képet küldjünk. Aztán - OK-t írni a korábbi értesítési szálban, ugyanabba a csoportba, nem külön üzenetként. Később egyre több hibát szeretnénk beírni az üzenetbe az utolsó X percben.
Külön téma - kapcsolat más szolgáltatásokkal és bármilyen művelet, amelyet az értesítések kezdeményeznek (csak ha az ön ellenőrzése megfelelően működik).
Handlerről készült példa, ahol a slack_handler.py a saját írású szkriptünk:
topic: slack_graph
id: slack_graph.alert
match: level() != INFO AND changed() == TRUE
kind: exec
options:
  prog: \/sbin\/slack_handler.py
  args: ["-c", "CHANNELID", "--graph", "--search"]
Hogyan debuggolni?
Log kimeneti megoldás
|log()
      .level("error")
      .prefix("valami")
Nézd (cli): kapacitor -url :9092 logs lvl=error
HTTP kimeneti megoldás
Megjeleníti az aktuális folyamatban lévő adatokat:
|httpOut('valami')
Nézd (get): :9092\/kapacitor\/v1\/tasks\/task_name\/valami
Végrehajtási séma
- Minden feladat visszaad egy végrehajtási fát hasznos számadatokkal .
- Vesszük a blokkot .
- Beillesztjük a nézőbe, .
Hol máshol kaphatunk timestamp-et
timestamp az influxdb-ben visszafelé íráskor
Például, egy órás kérések összege alapján (groupBy(1h)) állítunk be riasztást, és azt szeretnénk, hogy a bekövetkezett riasztás az influxdb-be kerüljön (hogy szépen megjeleníthessük a probléma tényét a grafikonon a grafana-ban).
Az influxDBOut() az riasztásból a time értéket menti a timestamp-ba, így a grafikonon a pont korábban/később kerül rögzítésre, mint ahogyan a riasztás megérkezett.
Amikor precizitásra van szükség: ezt a problémát megkerüljük egy egyedi handler hívásával, amely az aktuális timestamp-tel rögzíti az adatokat az influxdb-be.
docker, építés és telepítés
A kapacitor indításakor fel tudja tölteni a feladatokat, sablonokat és kezelőket a konfigurációban megadott könyvtárból, a [load] blokkban.
A feladat helyes létrehozásához a következő dolgokra van szükség:
- A fájl neve – kibővül id-ként/a szkript neveként
- Típus – stream/batch
- dbrp – kulcsszó, amely jelzi, hogy melyik adatbázisban + politikában működik a szkript (dbrp "supplier"."autogen")
Ha bármely batch-feladatban nem lesz dbrp sor, az egész szolgáltatás elutasítja a futtatást, és erről szép nyíltan tájékoztat a naplóban.
A chronograf-ban ezzel szemben nem kell, hogy legyen ez a sor, a felületen nem fogadható el, és hibát ad.
Konténer építésekor hasznos trükk: a Dockerfile -1-t ad vissza, ha vannak sorok /*.+dbrp, ami lehetővé teszi, hogy azonnal megértsük a hiba okát az építési folyamat során.
join egy a sokhoz
Példa feladat: meg kell nézni a szolgáltatás 95-ös percentílis idejét egy héten, és össze kell hasonlítani a legutolsó 10 percet ezzel az értékkel.
Nem lehet join-t végrehajtani egy a sokhoz, a last/mean/median a pontok csoportjánál stream-mé alakítja a csomópontot, és hibát ad: „cannot add child mismatched edges: batch -> stream”.
A batch eredménye, mint változó a lambda kifejezésben, szintén nem helyettesíthető.
Van lehetőség arra, hogy az első batch szükséges számjegyeit fájlba mentjük udf segítségével, és ezt a fájlt sideload-on keresztül betöltjük.
Mit oldottunk meg ezzel?
Körülbelül 100 szállítójuk van, mindegyikhez lehet néhány csatlakozás, ezt csatornának nevezzük. Ezekből a csatornákból körülbelül 300 van, mindegyik csatorna le is szakadhat. Az összes rögzített metrikából az error rate-et fogjuk monitorozni (requests és errors).
Miért nem grafana?
A grafanában beállított error riasztásoknak több hátránya van. Néhány kritikus, míg mások elhanyagolhatóak, a helyzettől függően.
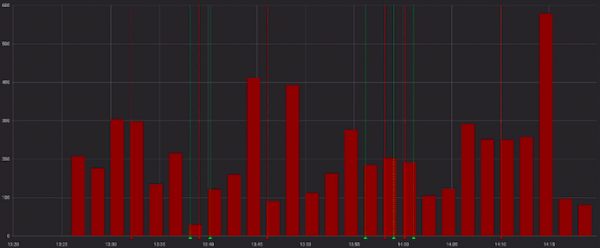
A grafana nem tud számításokat végezni az mérések között + riasztás, pedig nekünk a rate-re van szükség (requests-errors)/requests.
A hibák csúnyán néznek ki:
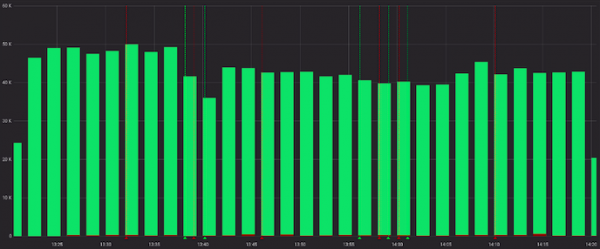
És kevésbé csúnyán, ha a sikeres kérésekkel nézzük:
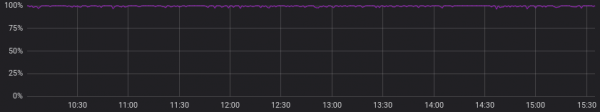
Rendben, előre meg tudjuk számítani a grafana előtti arányt, és bizonyos esetekben ez megfelelő lehet. De nem a miénkben, mivel minden csatornára egyedi "normális" arány kerül meghatározásra, és az értesítések statikus értékeken alapulnak (kézi keresés, változtatás, ha gyakran riaszt).
Itt vannak a különböző csatornákra vonatkozó "normális" példák:
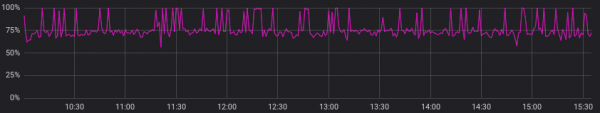
Ne vegyük figyelembe a korábbi pontot, és feltételezzük, hogy minden szolgáltató "normális" helyzete hasonló. Most minden rendben van, és a grafana értesítésekkel ki tudjuk jönni?
Ki tudjuk, de ez nem ideális, mert választanunk kell az alábbi lehetőségek közül:
a) számos grafikont készíteni minden csatornára külön (és szenvedni a karbantartásukkal)
b) egy grafikonra hagyni az összes csatornát (és elveszni a színes vonalakban és a beállított értesítésekben)
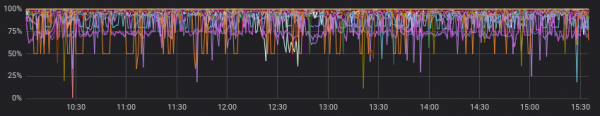
Hogyan csináltuk?
Ismét, a dokumentációban van egy jó kezdő például (), amelyet meg lehet nézni vagy alapként használni hasonló feladatokhoz.
Mire jutottunk:
- két sorozat összekapcsolása néhány órán belül, csatornák szerinti csoportosítás;
- kitöltjük a sorozatokat csoportonként, ha nem voltak adatok;
- összehasonlítjuk az elmúlt 10 perc mediánját a korábbi adatokkal;
- kiáltunk, ha valamit felfedeztünk;
- a kiszámolt arányokat és a bekövetkezett riasztásokat az influxdb-be írjuk;
- hasznos üzenetet küldünk a slackbe.
Véleményem szerint maximálisan sikerült mindent elérnünk, amit a kibocsátáskor szeretnénk (sőt, még kicsit többet is egyedi kezelőkkel).
A github.com-on meg lehet nézni és a kapott szkriptről.
A kapott kód példája:
dbrp "supplier"."autogen"
var name = 'requests.rate'
var grafana_dash = 'pczpmYZWU/mydashboard'
var grafana_panel = '26'
var period = 8h
var todayPeriod = 10m
var every = 1m
var warnAlert = 15
var warnReset = 5
var reqQuery = 'SELECT sum("count") AS value FROM "supplier"."autogen"."requests"'
var errQuery = 'SELECT sum("count") AS value FROM "supplier"."autogen"."errors"'

var prevErr = batch
 |query(errQuery)
 .period(period)
 .every(every)
 .groupBy(1m, 'channel', 'supplier')

var prevReq = batch
 |query(reqQuery)
 .period(period)
 .every(every)
 .groupBy(1m, 'channel', 'supplier')

var rates = prevReq
 |join(prevErr)
 .as('req', 'err')
 .tolerance(1m)
 .fill('null')
 // заполняем значения нулями, если их не было
 |default()
 .field('err.value', 0.0)
 .field('req.value', 0.0)
 // if в lambda: считаем рейт, только если ошибки были
 |eval(lambda: if("err.value" > 0, 100.0 * (float("req.value") - float("err.value")) / float("req.value"), 100.0))
 .as('rate')

// записываем посчитанные значения в инфлюкс
rates
 |influxDBOut()
 .quiet()
 .create()
 .database('kapacitor')
 .retentionPolicy('autogen')
 .measurement('rates')

// выбираем данные за последние 10 минут, считаем медиану
var todayRate = rates
 |where(lambda: duration((unixNano(now()) - unixNano("time")) / 1000, 1u)  warnAlert)
 .warnReset(lambda: ("prev.median" - "today.median") < warnReset)
 .flapping(0.25, 0.5)
 .stateChangesOnly()
 // собираем в message ссылку на график дашборда графаны
 .message(
 '{{ .Level }}: {{ index .Tags "channel" }} err/req ratio ({{ index .Tags "supplier" }})
{{ if eq .Level "OK" }}It is ok now{{ else }}
'+string(todayPeriod)+' median is {{ index .Fields "today.median" | printf "%0.2f" }}%, by previous '+string(period)+' is {{ index .Fields "prev.median" | printf "%0.2f" }}%{{ end }}
http://grafana.ostrovok.in/d/'+string(grafana_dash)+'
?var-supplier={{ index .Tags "supplier" }}&var-channel={{ index .Tags "channel" }}&panelId='+string(grafana_panel)+'&fullscreen&tz=UTC0300'
 )
 .id('{{ index .Tags "name" }}{{ index .Tags "channel" }}')
 .levelTag('level')
 .messageField('message')
 .durationField('duration')
 .topic('slack_graph')

// "today.median" дублируем как "value", также пишем в инфлюкс остальные филды алерта (keep)
trigger
 |eval(lambda: "today.median")
 .as('value')
 .keep()
 |influxDBOut()
 .quiet()
 .create()
 .database('kapacitor')
 .retentionPolicy('autogen')
 .measurement('alerts')
 .tag('alertName', name)
Mi a kimenet?
A Kapacitor csodálatosan tudja végezni a monitorozást és a riasztást, sok csoportosítással, plusz számításokat végez a már rögzített metrikák alapján, egyedi műveleteket hajt végre és szkripteket indít (udf).
A belépési küszöb nem túl magas – próbáld ki, ha a Grafana vagy más eszközök nem teljesen elégítik ki az igényeidet.
Forrás: habr.com
