

Rövid bevezető szó
Úgy gondolom, hogy több dolgot tudnánk megvalósítani, ha lépésről lépésre útmutatót kapnánk arról, hogy mit és hogyan kell csinálni. Magam is emlékszem olyan pillanatokra az életemben, amikor nem tudtam elkezdeni valamit, mert egyszerűen nem értettem, hol is kellene kezdeni. Lehetséges, hogy régen az interneten láttad a „Data Science” kifejezést, és úgy érezted, hogy ez messze van tőled, hogy azok, akik vele foglalkoznak, valahol máshol, egy másik világban vannak. De nem, ők éppen itt vannak. És lehet, hogy ennek a területnek köszönhetően bukkantál rá egy cikkre a hírfolyamodban. Rengeteg kurzus áll rendelkezésre, amely segít elsajátítani ezt a mesterséget, és én most segítek neked megtenni az első lépést.
Nos, készen állsz? Azonnal mondom, hogy tudnod kell a Python 3-at, mert ezt fogom használni itt. Azt is javaslom, hogy előre telepítsd a Jupyter Notebook-ot, vagy nézd meg, hogyan használhatod a Google Colab-ot.
Első lépés
A Kaggle egy jelentős segítőd lesz ebben a dologban. Alapvetően meg lehet nélküle is boldogulni, de erről egy másik cikkben fogok beszélni. Ez egy olyan platform, ahol Data Science versenyeket rendeznek. Minden egyes ilyen verseny elején hihetetlen mennyiségű tapasztalatot fogsz szerezni különféle feladatok megoldásában, fejlesztésben és csapatmunkában, ami a mai világban kulcsfontosságú.
A feladatunkat onnan vesszük. Ennek a neve: „Titanic”. A feladat a következő: előre jelezni, hogy a kiválasztott egyének közül ki fog túlélni. Összességében a Data Science szakemberek feladata az adatok gyűjtése, feldolgozása, a modell betanítása, a prognózis készítése stb. A Kaggle-en azonban lehetőségünk van a adatgyűjtési szakasz kihagyására — az adatok már rendelkezésre állnak a platformon. Le kell töltenünk őket, és kezdhetjük is a munkát!
Ezt az alábbi módon tehetjük meg:
az Adatok fülön található fájlokban találhatók az adatok


Letöltöttük az adatokat, előkészítettük a Jupyter jegyzeteinket és…
Második lépés
Hogyan töltsük most le ezeket az adatokat?
Először is importáljuk a szükséges könyvtárakat:
import pandas as pd
import numpy as np
A Pandas lehetővé teszi számunkra, hogy .csv fájlokat töltsünk be a további feldolgozáshoz.
A Numpy szükséges ahhoz, hogy az adatainkat mátrixba szervezzük számokkal.
Továbbmegyünk. Vegyük a train.csv fájlt, és töltsük fel:
dataset = pd.read_csv('train.csv')
A dataset mostázatunkat a train.csv fájlon keresztül a dataset változón keresztül fogjuk hivatkozni. Nézzük meg, mi található ott:
dataset.head()
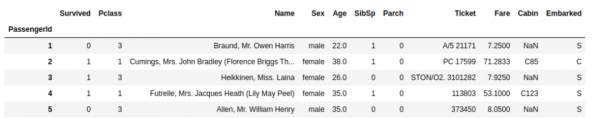
A head() függvény lehetővé teszi számunkra, hogy megnézzük az adatkeret első néhány sorát.
A Survived oszlop éppen azok az eredmények, amelyek az adatkeretben ismertek. A feladat szempontjából meg kell jósolnunk a Survived oszlopot a test.csv adatokra. Ezek az adatok tartalmazzák a Titanic más utasainak információit, amelyek esetében számunkra, mint a feladat megoldói, ismeretlenek az eredmények.
Tehát osszuk fel a táblázatunkat függő és független adatokra. Itt minden egyszerű. A függő adatok azok az adatok, amelyek függenek a függetlenektől, vagyis az eredményekben találhatók. A független adatok azok, amelyek befolyásolják az eredményt.
Például, van egy ilyen adataink:
„Vova informatikát tanult – nem.
Vova informatikából 2-t kapott.”
Az informatika értékelése attól függ, hogy Vova tanult-e informatikát. Érthető? Tovább haladunk, már közelebb vagyunk a célhoz!
A független adatok hagyományos változója az X. A függő adatoké az y.
A következőt tesszük:
X = dataset.iloc[ : , 2 : ]
y = dataset.iloc[ : , 1 : 2 ]
Mi ez? Az iloc[:, 2:] függvénnyel azt mondjuk a Python-nak: szeretném látni az X változóban azokat az adatokat, amelyek a második oszloptól kezdődnek (beleértve, és a számítás nullától kezdődik). A második sorban azt mondjuk, hogy szeretnénk az y változóban látni az első oszlop adatait.
[ a:b, c:d ] — ez az a szerkezet, amelyet használunk a zárójelekben. Ha nem adunk meg egyes változókat, azok alapértelmezettként fognak megmaradni. Tehát megadhatjuk [:,: d], és akkor az adatkeretben minden oszlopot megkapunk, kivéve azokat, amelyek d-től kezdődően következnek. Az a és b változók a sorokat határozzák meg, de azokra nekünk mind szükségünk van, így azokat alapértelmezettnek hagyjuk.
Nézzük meg, mit kaptunk:
X.head() 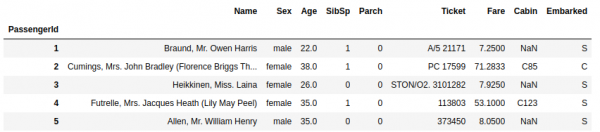
y.head() 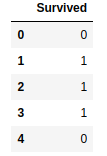
Annak érdekében, hogy leegyszerűsítsük ezt a kis leckét, eltávolítjuk azokat az oszlopokat, amelyek különös „gondozást” igényelnek, vagy amelyek egyáltalán nem befolyásolják a túlélést. Ezekben str típusú adatok szerepelnek.
count = ['Name', 'Ticket', 'Cabin', 'Embarked']
X.drop(count, inplace=True, axis=1)
Szuper! Térjünk át a következő lépésre.
Harmadik lépés
Itt kódolnunk kell az adatainkat, hogy a gép jobban megértse, hogyan hatnak ezek az adatok az eredményre. De nem mindent kódolunk, csak a str típusú adatokat, amelyeket otthagytunk. A "Nem" oszlop. Hogyan szeretnénk kódolni? Képzeljük el az ember nemét vektorként: 10 — férfi, 01 — nő.
Kezdetnek a táblázatainkat NumPy mátrixra konvertáljuk:
X = np.array(X)
y = np.array(y)
Most nézzük:
from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import OneHotEncoder

ct = ColumnTransformer(transformers=[('encoder', OneHotEncoder(), [1])],
                       remainder='passthrough')
X = np.array(ct.fit_transform(X))
A sklearn könyvtár egy nagyon hasznos könyvtár, amely lehetővé teszi, hogy teljes mértékben dolgozzunk az adatokkal a Data Science területén. Rengeteg érdekes gépi tanulási modellt tartalmaz, és lehetővé teszi számunkra az adatok előkészítését is.
A OneHotEncoder segítségével kódolhatjuk az ember nemét a fent leírt módon. Két osztályt fogunk létrehozni: férfi és nő. Ha az illető férfi, akkor az "férfi" oszlopba 1 szerepel, a "nő" oszlopba pedig 0.
A OneHotEncoder() után [1] áll, ami azt jelenti, hogy az 1. számú oszlopot akarjuk kódolni (nullától számítva).
Szuper. Haladjunk tovább!
Általában előfordul, hogy egyes adatok üresen maradnak (azaz NaN — nem szám). Például van információnk egy emberről: a neve, neme. De az életkor elem hiányzik. Ilyen esetben egy módszert alkalmazunk: kiszámítjuk az összes oszlop átlagát, és ha egyes adatok hiányoznak az oszlopban, akkor az ürességet az átlagértékkel töltjük ki.
from sklearn.impute import SimpleImputer
imputer = SimpleImputer(missing_values=np.nan, strategy='mean')
imputer.fit(X)
X = imputer.transform(X)
Most vegyük figyelembe, hogy előfordul, hogy az adatok nagyon széles skálán mozognak. Egyes adatok a [0:1] tartományban vannak, míg mások több száz és ezer értéket is elérhetnek. Ennek a variálásnak a kiküszöbölésére és a pontosság növelésére skálázzuk az adatokat. Az összes szám ne haladja meg a hármat. Ehhez a StandartScaler funkciót fogjuk használni.
from sklearn.preprocessing import StandardScaler
sc = StandardScaler()
X[:, 2:] = sc.fit_transform(X[:, 2:])
Most az adataink így néznek ki:

Kiváló. Már közel vagyunk a célunkhoz!
Negyedik lépés
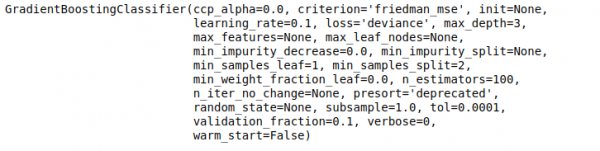
Tanuljuk meg az első modellünket! Az sklearn könyvtárból rengeteg érdekes dolgot találhatunk. A feladathoz a Gradient Boosting Classifier modellt alkalmaztam. Osztályozót használunk, mivel a feladatunk osztályozási feladat. Az előrejelzést 1-re (túlélte) vagy 0-ra (nem élte túl) kell besorolni.
from sklearn.ensemble import GradientBoostingClassifier
gbc = GradientBoostingClassifier(learning_rate=0.5, max_depth=5, n_estimators=150)
gbc.fit(X, y)
A fit függvény azt mondja a Python-nak: hagyjuk, hogy a modell keresse a kapcsolatokat X és y között.
Kevesebb mint egy másodperc, és a modell kész.
Hogyan lehet alkalmazni? Most meglátjuk!
Ötödik lépés. Következtetés
Most szükségünk van egy táblázatra a tesztadatainkkal, amelyekre előrejelzést kell készíteni. Ezzel a táblával ugyanazokat a lépéseket kell végrehajtanunk, amelyeket X esetében tettünk.
X_test = pd.read_csv('test.csv', index_col=0)

count = ['Name', 'Ticket', 'Cabin', 'Embarked']
X_test.drop(count, inplace=True, axis=1)

X_test = np.array(X_test)

from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import OneHotEncoder
ct = ColumnTransformer(transformers=[('encoder', OneHotEncoder(), [1])],
                       remainder='passthrough')
X_test = np.array(ct.fit_transform(X_test))

from sklearn.impute import SimpleImputer
imputer = SimpleImputer(missing_values=np.nan, strategy='mean')
imputer.fit(X_test)
X_test = imputer.transform(X_test)

from sklearn.preprocessing import StandardScaler
sc = StandardScaler()
X_test[:, 2:] = sc.fit_transform(X_test[:, 2:])
Alkalmazzuk a modellünket!
gbc_predict = gbc.predict(X_test)
Minden kész. Elkészítettük az előrejelzést. Most ezt csv fájlba kell írni, és fel kell tölteni a weboldalra.
np.savetxt('my_gbc_predict.csv', gbc_predict, delimiter=",", header = 'Survived')
Kész. Megkaptuk a fájlt, amely tartalmazza az előrejelzéseket minden utasra. Még csak fel kell tölteni ezeket a megoldásokat a weboldalra, és meg kell kapni az előrejelzés értékelését. Ez a primitív megoldás nemcsak 74%-os helyes válaszadást ad nyilvánosan, hanem egy kis lökést is a Data Science-ben. A legkíváncsibbak bármikor írhatnak nekem privát üzenetet, és kérdezhetnek. Köszönöm mindenkinek!
Forrás: habr.com
