

Bevezető
A világon létezik egy rendkívül egyszerű és hasznos eszköz — , és így alakult, hogy ez régóta gyökeret vert a gyártási folyamatunkban (bár a verzióját telepíteni nem tudtuk, de biztosan nem a legfrissebb volt). Közvetlen céljára használjuk — bináris patch-ek építése. Ha ránézünk, mi található a tárolóban, kissé szomorúvá válik az ember: lényegében régóta elhagyott, és sok dolog jelentősen elavult (valamikor pár változtatást bejuttatott ide egy egykori kollégám, de az rég volt). Szóval eldöntöttem, hogy életre keltsem: forkoltam, kidobtam azt, amit nem tervezek használni, átállítottam a projektet , beágyaztam a „forró” mikrofunkciókat, eltüntettem a veremből a nagy tömböket (és a változó méretű tömböket, amiktől őszintén szólva „robbanást” kaptam), újra futtattam a profilozót — és megtudtam, hogy körülbelül az idő 40%-át elviszi a …
Mi a helyzet az fwrite-tel?
Ebben a kódban az fwrite (az én konkrét tesztem esetében: patch építése közeli 300 MB fájlok között, a bemenetek teljesen a memóriában) milliószor hívódik meg kicsi méretű pufferral. Nyilvánvaló, hogy ez a dolog lassítani fog, és ezért szeretném valahogy befolyásolni ezt a helyzetet. Különféle adatforrások, aszinkron I/O bevezetésére egyelőre nincs vágyam, egyszerűbb megoldást szerettem volna találni. Az első, ami eszembe jutott — növelni a buffer méretét
setvbuf(file, nullptr, _IOFBF, 64* 1024)de lényeges javulást nem értem el az eredményben (most az fwrite körülbelül az idő 37%-át tette ki) — tehát a dolog mégsem a gyakori adatrögzítésen múlik. Ha „a motorház alá” nézünk, láthatjuk, hogy az fwrite belsejében körülbelül így folyik a lock/unlock a FILE struktúrával (pszeudokód, az egész elemzés a Visual Studio 2017 alatt történt):
size_t fwrite (const void *buffer, size_t size, size_t count, FILE *stream)
{
   size_t retval = 0;
   _lock_str(stream);   /* lezárás */
   __try
   {
      retval = _fwrite_nolock(buffer, size, count, stream);
   }
   __finally
   {
       _unlock_str(stream);   /* feloldás */
   }
   return retval;
}
Ha a profilozóra támaszkodunk, a _fwrite_nolock mindössze az idő 6%-át teszi ki, a többi pedig az overhead. Az én konkrét esetemben a szálbiztonság nyilvánvalóan fölösleges, ezzel én is áldozatot hozok, lecserélve az fwrite hívást — még az érvekkel se kell túlbonyolítani. Összegzésül: ez az egyszerű trükk jelentősen csökkentette az eredmények írásának költségeit, amelyek az eredeti változatban csaknem a teljes időráfordítás felét tették ki. Egyébként a POSIX világában létezik egy hasonló funkció — . Általánosságban, a fread-re is ez vonatkozik. Így pár #define segítségével egy meglehetősen platformfüggetlen megoldást hozhatunk létre felesleges zárolások nélkül, ha azok nem szükségesek (és ez elég gyakran előfordul).
fwrite, _fwrite_nolock, setvbuf
Absztraháljunk az eredeti projekttől és nézzük meg egy konkrét eset tesztelését: egy nagy fájl (512 MB) írása rendkívül kis darabokban — 1 bájt. Teszt rendszer: AMD Ryzen 7 1700, 16 GB RAM, HDD 7200 rpm 64 MB cache, Windows 10 1809, a bináris 32 bitesre épült, optimalizálva van, a könyvtár statikusan linkelve.
Kísérlethez készült minta:
#include <chrono>
#include <cstdio>
#include <inttypes.h>
#include <memory>

#ifdef _MSC_VER
#define fwrite_unlocked _fwrite_nolock
#endif

using namespace std::chrono;

int main()
{
    std::unique_ptr<FILE, int(*)(FILE*)> file(fopen("test.bin", "wb"), fclose);
    if (!file)
        return 1;

    constexpr size_t TEST_BUFFER_SIZE = 256 * 1024;
    if (setvbuf(file.get(), nullptr, _IOFBF, TEST_BUFFER_SIZE) != 0)
        return 2;

    auto start = steady_clock::now();
    const uint8_t b = 77;
    constexpr size_t TEST_FILE_SIZE = 512 * 1024 * 1024;
    for (size_t i = 0; i < TEST_FILE_SIZE; ++i)
        fwrite_unlocked(&b, 1, sizeof(b), file.get());

    auto end = steady_clock::now();
    auto interval = duration_cast<microseconds>(end - start);
    printf("Time: %lldn", interval.count());

    return 0;
}
A változók között szerepel a TEST_BUFFER_SIZE, továbbá néhány esetben a fwrite_unlocked-ot fwrite-re cseréljük. Kezdjük a fwrite esettel, anélkül, hogy kifejezetten beállítanánk a pufferméretet (kommentáljuk a setvbuf-ot és a kapcsolódó kódot): idő 27048906 μs, írási sebesség — 18.93 MB/s. Most állítsuk be a pufferméretet 64 KB-ra: idő — 25037111 μs, sebesség — 20.44 MB/s. Most teszteljük a _fwrite_nolock-ot a setvbuf hívása nélkül: 7262221 μs, sebesség — 70.5 MB/s!
Folytassuk a puffermérettel kapcsolatos kísérleteket (setvbuf):
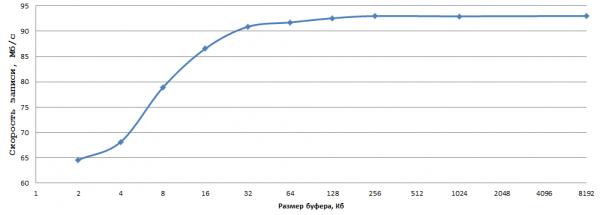
Az adatok 5 kísérlet átlagolásával készültek, a hibát nem számoltam. Véleményem szerint a 93 MB/s írási sebesség 1 bájtírás mellett egy hagyományos HDD-n nagyon jó eredmény, csupán meg kell találni az optimális pufferméretet (az én esetemben 256 KB — éppen megfelelő) és szükség esetén a fwrite-t cserélni _fwrite_nolock/fwrite_unlocked-ra (ha nincs szükség szálbiztonságra, természetesen).
Hasonlóan a fread-re is ilyen körülmények között. Mivel „hardveres” Linux gépem nincs kéznél (az egyenlőre nem számít), korlátozott kísérletet végeztem egy virtuális gépen (Hyper-V, OpenSUSE 15, GCC 8.3.1) — az összefüggés alapvetően ugyanez: a „nyers” fwrite 20 MB/s, fwrite + 256 KB-os pufferral 23 MB/s-ot produkált, fwrite_unlocked ugyanolyan pufferral — 35 MB/s (a bináris 64 bites volt, g++ -o2 -s -static-libgcc -static-libstdc++ fwrite_test.cpp -o fwrite_test).
Utószó
A cikk írásának célja egy egyszerű és sok esetben hatékony módszer bemutatása volt (korábban nem találkoztam a _fwrite_nolock/fwrite_unlocked funkciókkal, nem túl népszerűek – pedig kár). A tartalom újdonságára nem tartok igényt, de remélem, hogy a cikk hasznos lesz a közösség számára.
Forrás: habr.com
