

A VictoriaMetrics egy gyors és skálázható DBMS az időalapú adatok tárolására és feldolgozására (az idő és a megfelelő értékek halmaza alkotja az adatokat, például amelyek időszakos érzékelőállapot-ellenőrzés vagy metrikagyűjtés révén jöttek létre).
A nevem Kolobaev Pavel. DevOps, SRE, LeroyMerlin, mindez kód formájában – ez mind rólunk szól: rólam és LeroyMerlin más munkatársairól.
Van egy OpenStack alapú felhőnk. Ott van egy kis hivatkozás a technikai radarra.
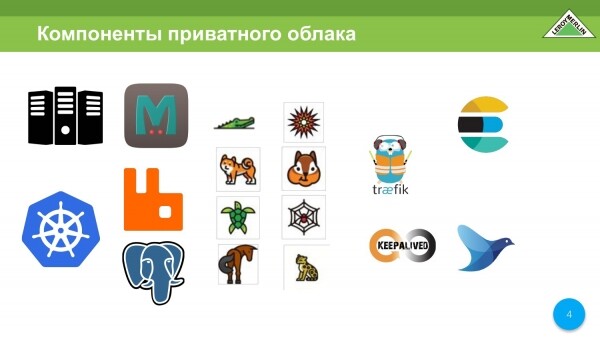
Ez Kubernetes hardverén alapul, valamint minden kapcsolódó szolgáltatásán az OpenStackhez és a naplózáshoz.
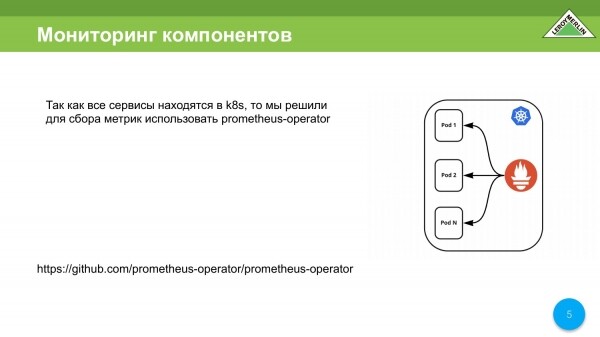
Így nézett ki a fejlesztési tervünk. Amikor mindezt kidolgoztuk, volt egy Prometheus operátorunk, aki a K8s klaszter belsejében tárolta az adatokat. Automatikusan megtalálja, hogy mit kell összeszedni, és durván fogalmazva, odahelyezi magának.
Minden adatot ki kell vinnünk a Kubernetes klaszteren kívül, mert ha valami történik, meg kell értenünk, hogy mi történt és hol.
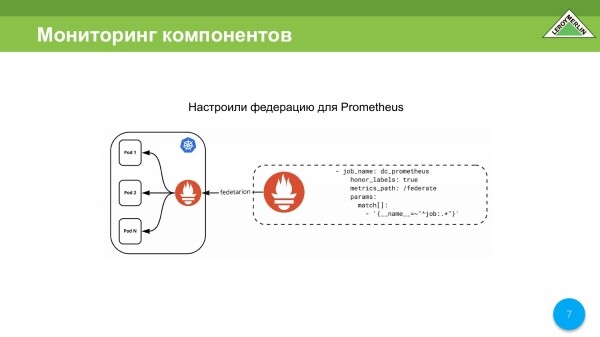
Az első megoldás – federation használata, amikor van egy külső Prometheusunk, és a klaszter Kuberneteshez a federation mechanizmusán keresztül férünk hozzá.
De itt kisebb problémák jelentkeznek. A mi esetünkben a probléma akkor kezdődött, amikor 250 000 metrikánk volt, majd amikor 400 000 metrikára nőtt, rájöttünk, hogy így nem tudunk dolgozni. A scrape_timeout-t 25 másodpercre növeltük.
Miért kellett ezt megtennünk? A Prometheus az időzítést a lekérdezés kezdetétől számolja. Nem számít, hogy az adatok még mindig érkeznek. Ha az adott időintervallumon belül az adatok nem áramlanak, és a session http-n nem záródik le, akkor a session kudarcnak számít, és az adatok nem jutnak be magába a Prometheusba.
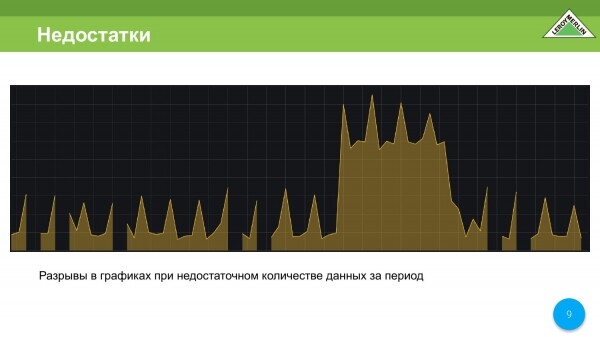
Mindenki ismeri azokat a grafikonokat, amelyeket akkor kapunk, amikor az adatok egy része hiányzik. A grafikonok megszakadtak, és ez minket nem elégedett meg.
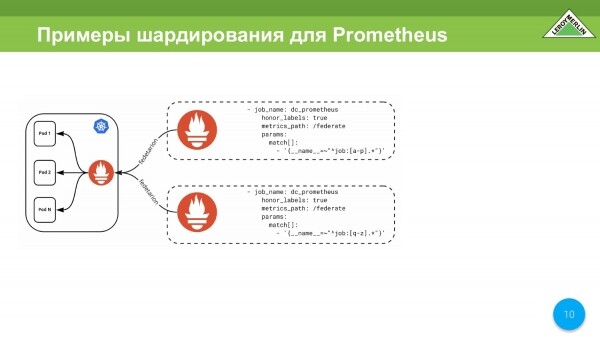
A következő lehetőség – sharding két különböző Prometheus alapján ugyanazon federation mechanizmuson keresztül.
Például, egyszerűen az neveik szerint shardolni őket. Ezt is lehet használni, de úgy döntöttünk, hogy további lépésekre van szükség.
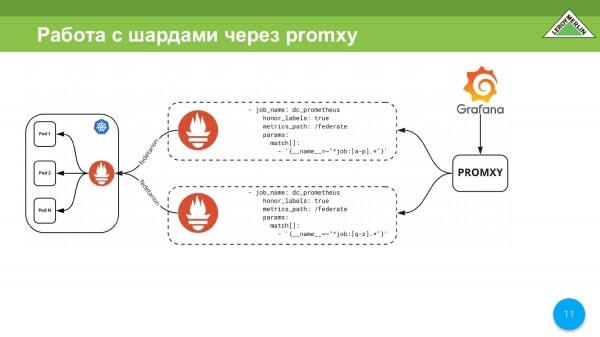
Ezeket a shardokat most valahogy kezelni kell. Használhatunk promxy-t, amely elmegy a shard területére, és többszörözni az adatokat. Két sharddal egyetlen belépési pontként működik. Ezt promxy segítségével meg lehet valósítani, de jelenleg túl bonyolult.
Az első lehetőség, hogy lemondjunk a federation mechanizmusról, mert ez nagyon lassú.
A Prometheus fejlesztői egyértelműen mondják: „Hölgyeim és Uraim, használjanak más TimescaleDB-t, mert mi nem fogjuk sokáig támogatni a metrikák hosszú tárolását”. Ez nem az ő feladatuk. 
Papíron feljegyezzük, hogy nekünk mégis szükségünk van a külső exportálásra, hogy ne tároljunk mindent egy helyen.
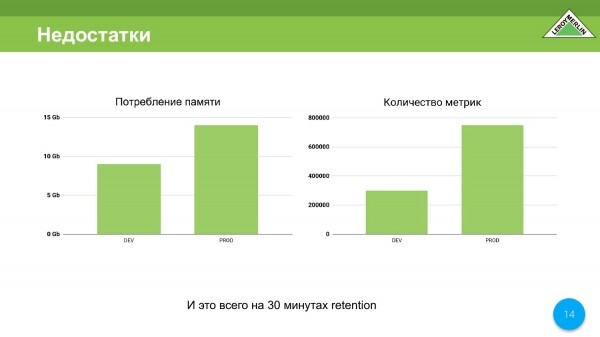
A második hátrány a memóriafogyasztás. Igen, tudom, hogy sokan azt mondják, hogy 2020-ban pár gigabájt memória nem nagy pénz, de mindenesetre.
Jelenleg van dev és prod környezetünk. A dev környezetben körülbelül 9 gigabájtunk van 350 000 metrikára. A prod környezetben pedig 14 gigabájt van 780 000 metrikára. Ezzel együtt a retention time csak 30 perc. Ez rossz. Most megmagyarázom, miért.
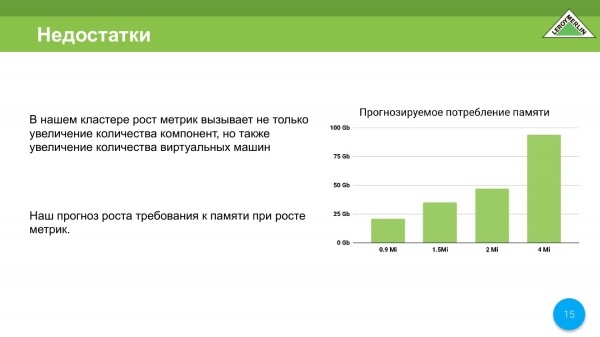
Megcsináljuk a számítást, azaz másfél millió metrikánál, ahhoz már elég közel állunk, a tervezési fázisban 35-37 gigabájt memória jön ki. De már 4 millió metrikánál körülbelül 90 gigabájt memória szükséges. Ez a Prometheus fejlesztői által biztosított képlet alapján lett kiszámítva. Megvizsgáltuk a korrelációt, és rájöttünk, hogy nem akarunk pár milliót fizetni egy szerverért, amely csak a monitorozásra szolgál.
Nemcsak a gépek száma nőni fog, hanem a virtuális gépeket is monitorozzuk. Tehát minél több virtuális gép van, annál több különböző metrika van stb. Külön növekedés vár ránk a metrikák szempontjából a klaszterünkben.
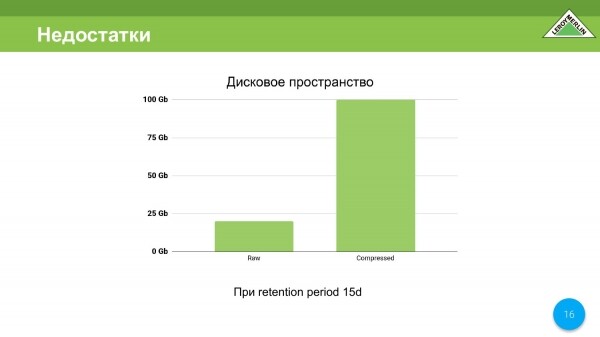
A lemezterülettel kapcsolatban a helyzet nem annyira rossz, de szeretnénk javítani rajta. 15 nap alatt összesen 120 gigabájtunk volt, amiből 100 tömörített adat, 20 pedig tömörítetlen adat, de mindig szeretnénk kevesebbet.
Ennek megfelelően feljegyzünk egy újabb pontot – a nagy erőforrásfogyasztást, amit szeretnénk tényleg megtakarítani, mert nem akarjuk, hogy a monitorozó klaszterünk több erőforrást egyen, mint az OpenStack kezelő klaszterünk.
Van még egy hátrány a Prometheusban, amit észleltünk, ez pedig a memória korlátozásának hiánya. A Prometheus helyzete sokkal rosszabb, mert egyáltalán nincsenek ilyen kapcsolók. A docker memória korlátozást használni sem lehet opció. Ha például a RAF lerobban és ott 20-30 gigabájt van, akkor nagyon hosszú időbe telik az újraindítás.
Ez egy újabb ok, amiért a Prometheus nem felel meg nekünk, azaz nem lehet korlátozni a memóriafogyasztást.
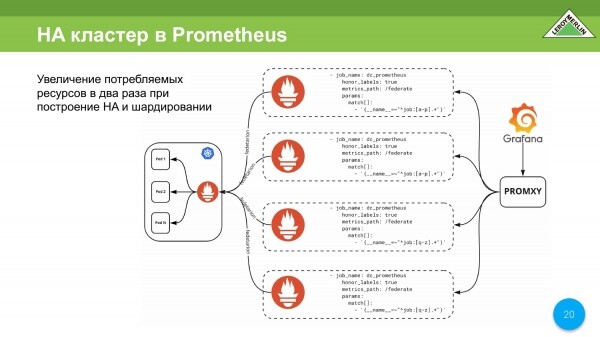
Lehetséges lenne egy ilyen sémát megvalósítani. Erre a sémára van szükségünk ahhoz, hogy HA klasztert szervezzünk. Azt akarjuk, hogy a metrikáink mindig és mindenhol elérhetők legyenek, még akkor is, ha az a szerver, amely tárolja ezeket a metrikákat, leáll. Így ki kell alakítanunk egy ilyen sémát.
Ez a séma azt jelzi, hogy a shardok duplikálódni fognak, így a felhasznált erőforrások is duplikálódnak. Majdnem vízszintesen skálázható, de ennek ellenére az erőforrások fogyasztása rettentő lesz.
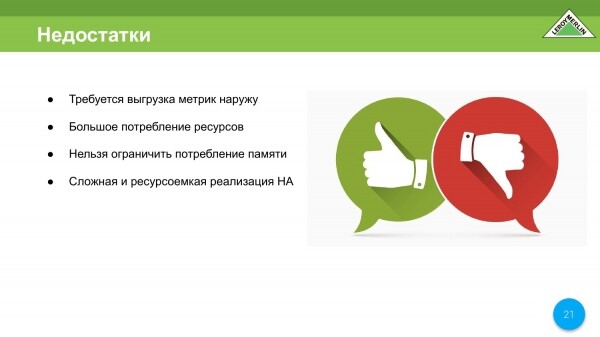
A hátrányokat felsorolva, ahogyan mi azokat megfogalmaztuk:
- Kívánatos a metrikák külső kiadása.
- Magas erőforrásfogyasztás.
- Nem lehet korlátozni a memóriafogyasztást.
- Bonyolult és erőforrásigényes a HA megvalósítása.
Mi úgy döntöttünk, hogy elhagyjuk a Prometheust mint tárolót.
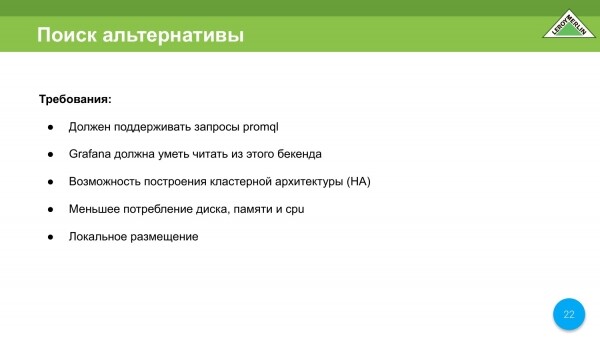
További követelményeket határoztunk meg, amelyeket szükségesnek tartunk. Ezek:
- A promql támogatása, mert már sok minden íródott a Prometheus alá: lekérdezések, riasztások.
- Van Grafana is, amely szintén a Prometheus-ra lett írva backendként. Nem szeretnénk újra írni a vezérlőpultokat.
- Normális HA architektúrát szeretnénk építeni.
- Csökkenteni akarjuk mindenféle erőforrás fogyasztását.
- Van egy apró szempont. Nem tudunk különféle felhő alapú metrikagyűjtő rendszereket használni. Nem tudjuk, hogy mik fogják elhagyni ezeket a metrikákat. Mivel oda bármi elmehet, kénytelenek vagyunk a helyi elhelyezésre korlátozódni.
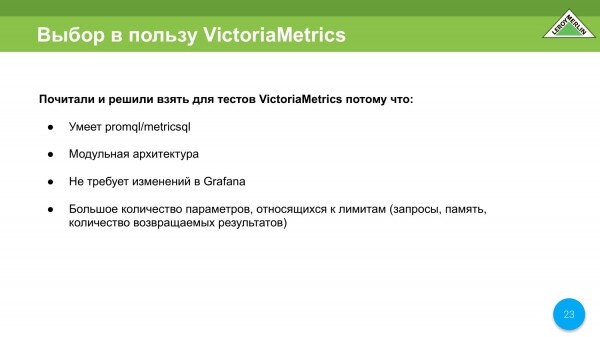
A választási lehetőségek korlátozottak voltak. Összegyűjtöttük mindazt, amivel tapasztalatunk volt. Megnéztük a Prometheus integrációs oldalát, rengeteg cikket olvastunk, és megnéztük, hogy egyáltalán mi létezik. Végül a VictoriaMetrics-t választottuk a Prometheus helyettesítésére.
Miért? Mert:
- Támogatja a promql-t.
- Moduláris architektúrával rendelkezik.
- Nem igényel módosításokat a Grafanában.
- A legfontosabb, hogy valószínűleg metrikatárolót fogunk biztosítani a cégünkön belül mint szolgáltatást, ezért előre tekintünk a különféle korlátozások irányába, hogy a felhasználók korlátozott formában használhassák a klaszter összes erőforrását, mivel van esély arra, hogy multitenancy lesz.
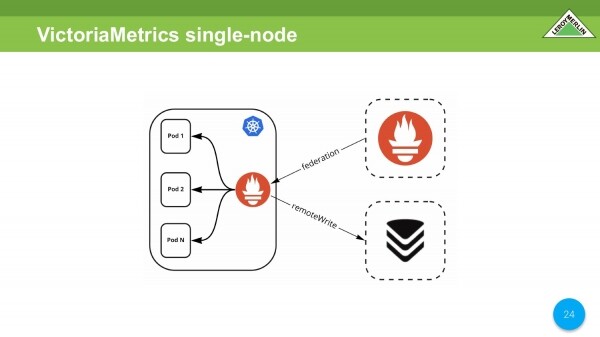
Elvégezzük az első összehasonlítást. Az ugyanazt a Prometheust vesszük a klaszterben, amelyet egy külső Prometheus keres fel. A VictoriaMetrics-t a remoteWrite-on keresztül adjuk hozzá.
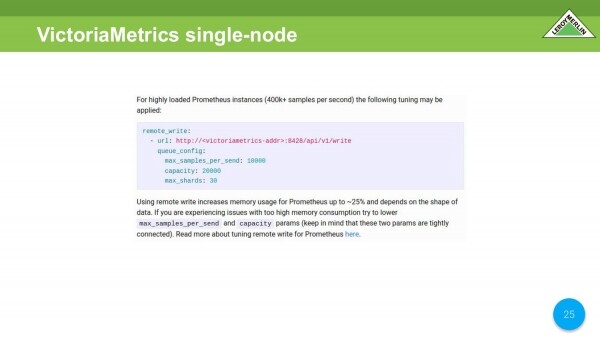
Azonnal szeretném tisztázni, hogy itt egy kis CPU-növekedést tapasztaltunk a VictoriaMetrics részéről. A VictoriaMetrics wikin olvasható, hogy mely paraméterek a legjobbak. Ellenőriztük őket. Nagyon jól csökkentették a CPU-fogyasztást.
A mi esetünkben a Kubernetes klaszterben lévő Prometheus memóriafogyasztása nem nőtt jelentősen.
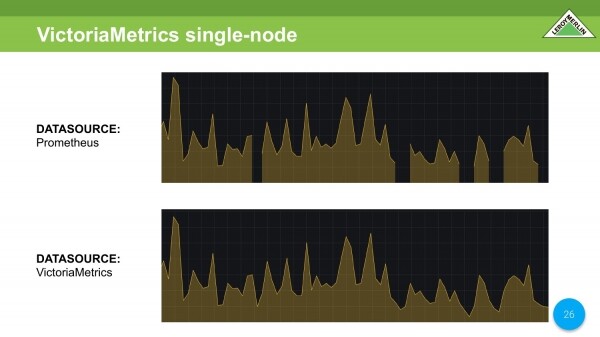
Összehasonlítunk két adatszolgáltatót, amelyek ugyanazokat az adatokat reprezentálják. A Prometheusban ugyanazokat a hiányzó adatokat látjuk. A VictoriaMetricsban minden rendben van.
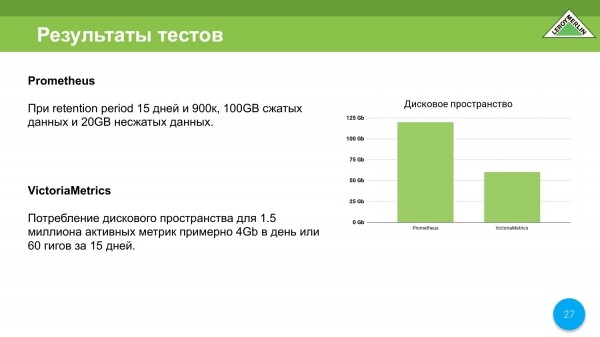
A teszteredmények a tárolóhely kapacitásáról. A Prometheusban összesen 120 gigabájtot kaptunk. A VictoriaMetricsban már napi 4 gigabájtot kapunk. Ott kicsit más a mechanizmus, mint amit a Prometheusban megszoktunk. Azaz az adatok már elég jól tömörödnek naponta, félórán belül. Ezek már jól tömörítettek naponta, félórán belül, annak ellenére, hogy később az adatokat még egyesíteni fogják. Végül is megtakarítottunk a tárolóhelyen.
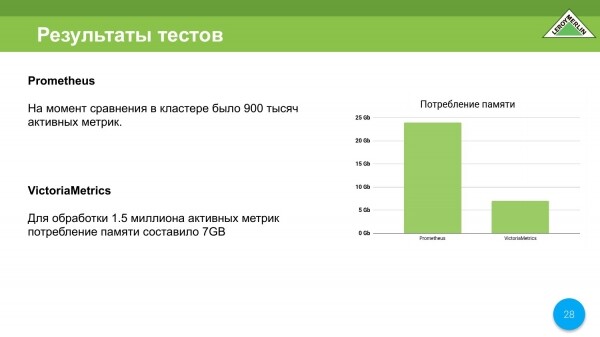
Továbbá spórolunk a memóriafogyasztáson is. A Prometheus a tesztelés idején egy virtuális gépen futott – 8 mag, 24 gigabájt. A Prometheus gyakorlatilag mindent elvett. OOM Killer miatt leállt. Ekkor mindössze 900 000 aktív metrikába torkollott. Ez körülbelül 25 000-27 000 metrikát jelent másodpercenként.
A VictoriaMetrics kétmagos virtuális gépen futott 8 gigabájt RAM-mal. Sikerült jól működésre bírnunk a VictoriaMetrics-ot, néhány dolgot variálva a 8 gigabájtos gépen. Végül 7 gigabájtban megálltunk. Eközben a metrikák megjelenítési sebességét, tehát a kontent sebességét, még jobb eredményt értünk el, mint a Prometheusnál.
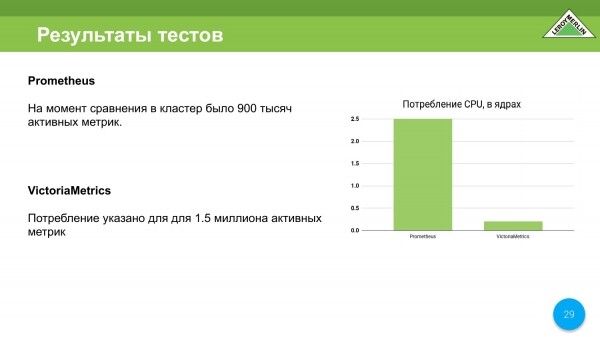
A CPU-igény sokkal jobb lett a Prometheushoz képest. Itt a Prometheus 2,5 magot igényel, míg a VictoriaMetrics mindössze 0,25 magot. A kezdésnél 0,5 mag. Az egyesítés folyamatában 1 magra emelkedik, de ez rendkívül ritka.
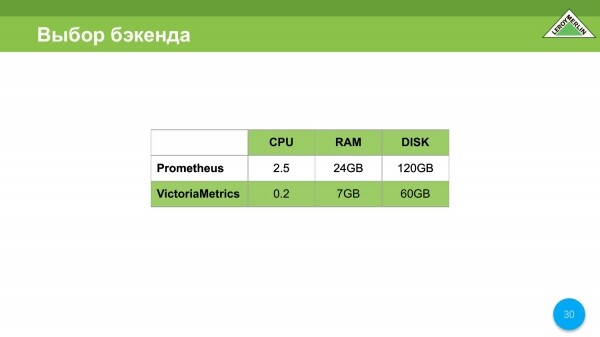
A mi esetünkben a VictoriaMetrics-ra választás érthető okok miatt esett, spórolni akartunk, és spóroltunk.
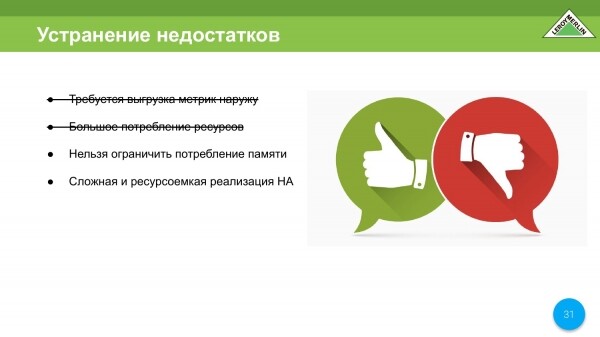
Kettő dolgot azonnal kizárunk – ezek a metrikák kiadásának és a nagy erőforrás-fogyasztásnak a kérdése. Két pont maradt, amelyet még mindig meg kell oldanunk.
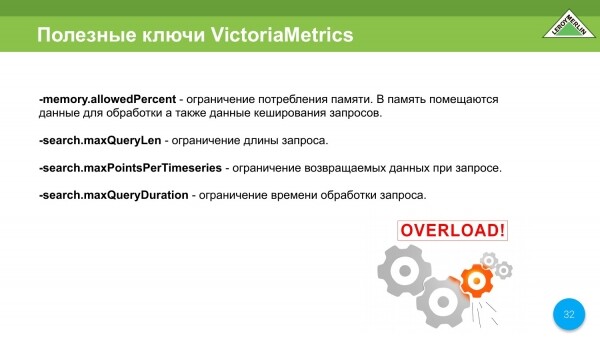
Itt azonnal szeretném hangsúlyozni, hogy a VictoriaMetrics-t a metrikák tárolására tekintjük. De mivel valószínűleg a VictoriaMetrics-t a Leroy teljes tárolására fogjuk biztosítani, szükséges, hogy a klasztert használókat korlátozzuk, hogy ne terheljék meg.
Van egy remek lehetőség, amely lehetővé teszi az idő, az adatmennyiség és a végrehajtási idő korlátozását.
Emellett van egy nagyszerű opció, amely lehetővé teszi a memóriafogyasztás korlátozását, így megtalálhatjuk azt az egyensúlyt, amely normális működési sebességet és megfelelő erőforrás-felhasználást biztosít.
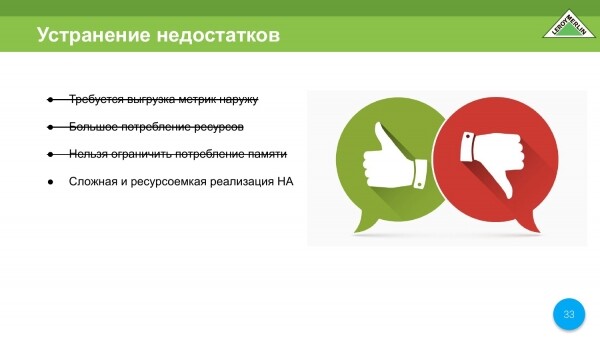
Ez még egy hátrány, azaz kivehetjük a pontot - nem lehet korlátozni a memóriafogyasztást.
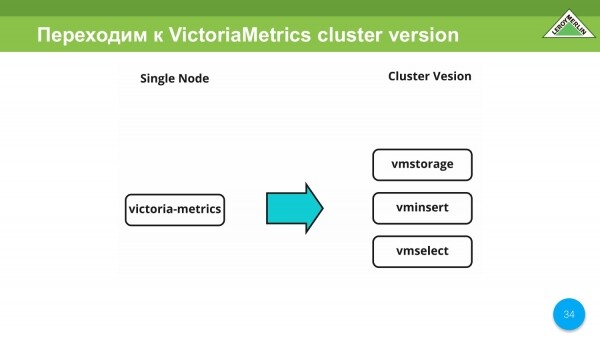
Az első iterációk során a VictoriaMetrics Single Node-ot teszteltük. Ezután áttérünk a VictoriaMetrics Cluster verzióra.
Itt szabad kezet kapunk abban, hogy különböző szolgáltatásokat helyezhetünk el a VictoriaMetrics-ben attól függően, hogy milyen erőforrásokat fogyasztanak. Ez egy nagyon rugalmas és kényelmes megoldás. Mi magunk is használtuk.
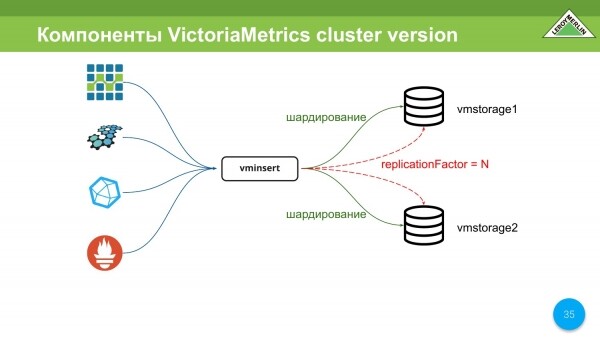
A VictoriaMetrics Cluster verzió fő összetevői a vmstorage. Ezekből lehet N darab. A mi esetünkben egyelőre kettő van.
És van a vminsert. Ez egy proxy szerver, amely lehetővé teszi számunkra: a shard-olást az összes tároló között, amelyet neki megadtunk, és egy replikát is lehetővé tesz, azaz shard-olás és replikáció egyaránt lesz.
A vminsert támogatja az OpenTSDB, Graphite, InfluxDB protokollokat és a Prometheus remoteWrite-ot.
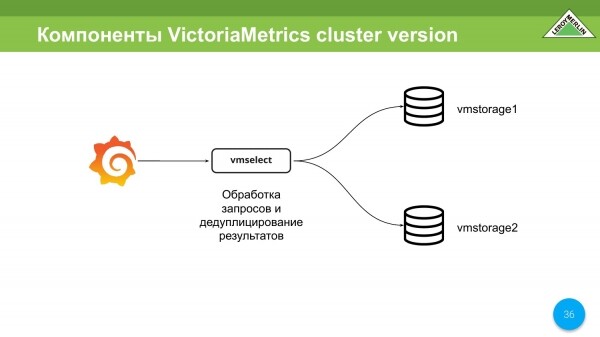
Van még a vmselect. Ennek a fő feladata, hogy hozzátartozó adatokat kérjen le a vmstorage-tól, deduplikálja ezeket az adatokat és átadja az ügyfélnek.
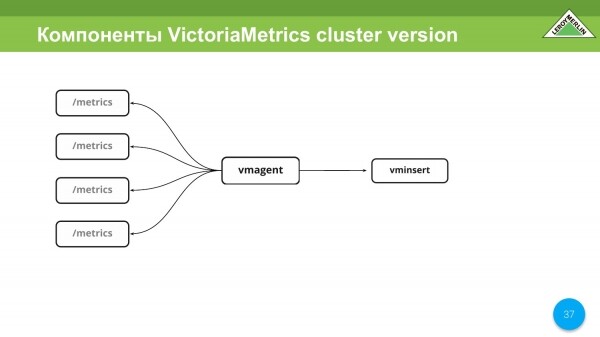
Van egy csodálatos dolog a vmagent. Nagyon tetszik nekünk. Ugyanolyan módon konfigurálható, mint a Prometheus, és mindent ugyanúgy csinál, mint a Prometheus. Azaz különböző entitásokról, szolgáltatásoktól gyűjti a metrikákat, és továbbítja őket a vminsert-be. Innentől már csak rajtatok múlik.
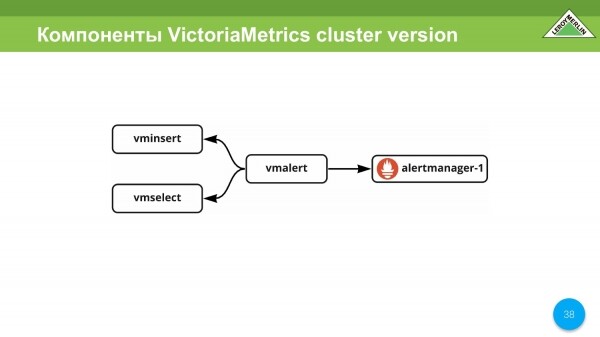
Még egy nagyszerű szolgáltatás a vmalert, amely lehetővé teszi, hogy a VictoriaMetrics-t hátsó végként használja, adatokat kap a vminsert-től, és továbbítja a vmselect-nek a feldolgozott adatokat. Az alert-ek és a szabályok feldolgozását végzi. Az alert-ek esetében az alertmanager-en keresztül kapjuk meg az értesítéseket.
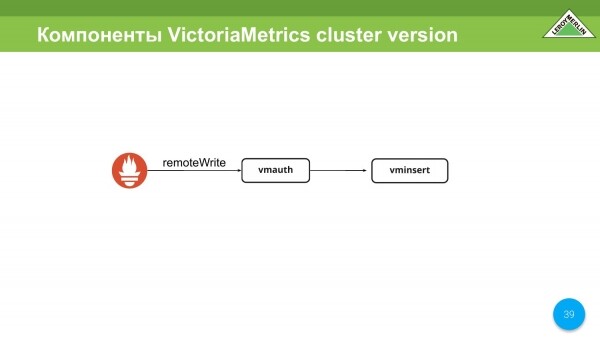
Van egy wmauth komponensünk is. Esetleg használni fogjuk, vagy lehet, hogy nem (még nem döntöttünk erről) az Authorization rendszerként a multitenancy verziónkban. Támogatja a Prometheus remoteWrite-ot, és alap URL alapján tudja hitelesíteni, pontosabban annak második részét, ahol írhattok vagy nem írhattok.
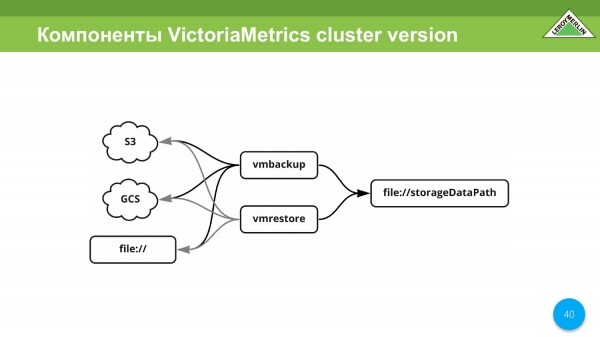
Van még vmbackup és vmrestore. Ezek lényegében minden adat visszaállítására és mentésére szolgálnak. Támogatja az S3, GCS, fájlokat.
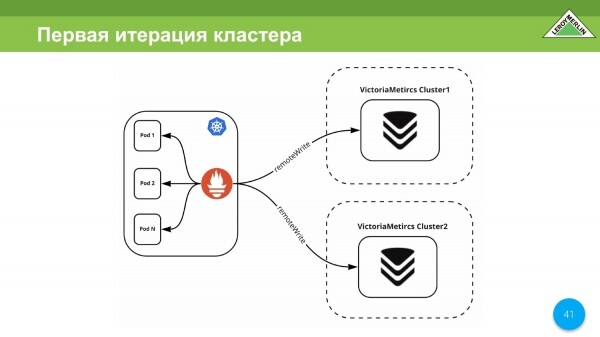
A klaszterünk első iterációját a karantén idején készítettük el. Akkoriban nem volt replikánk, ezért az iterációnk két különálló és független klasztert jelentett, amelyekbe a remoteWrite segítségével kaptuk az adatokat.
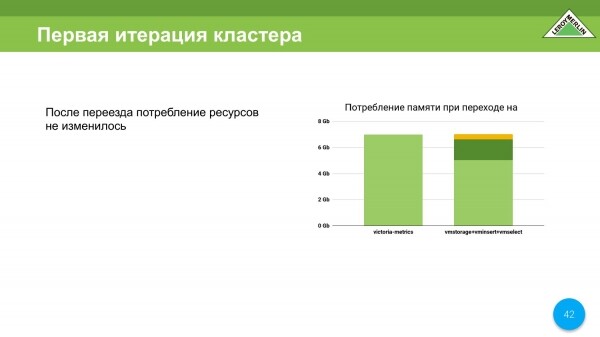
Itt megjegyzem, hogy amikor a VictoriaMetrics Single Node-ról a VictoriaMetrics Cluster Version-ra váltottunk, ugyanannyi erőforrást használtunk, azaz a fő forrás a memória volt. Így oszlottak meg az adataink, vagyis az erőforrás-felhasználás.
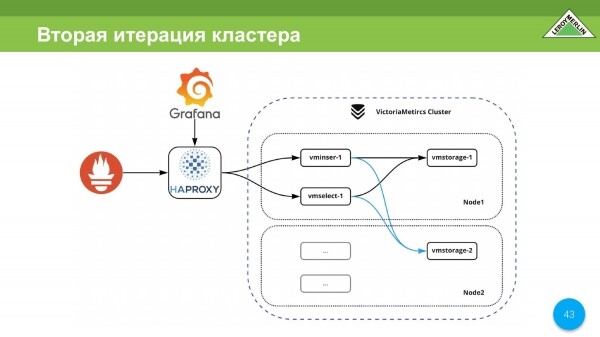
Itt már hozzáadtunk egy replikát. Mindent egy viszonylag nagy klaszterbe egyesítettünk. Az adatok shard-olva és replikálva egyaránt vannak.
A klaszternek van N belépési pontja, azaz a Prometheus adatokat adhat hozzá a HAPROXY-n keresztül. Ez nálunk a belépési pont. Ezen a belépési ponton keresztül lehet bejutni a Grafana-ba.
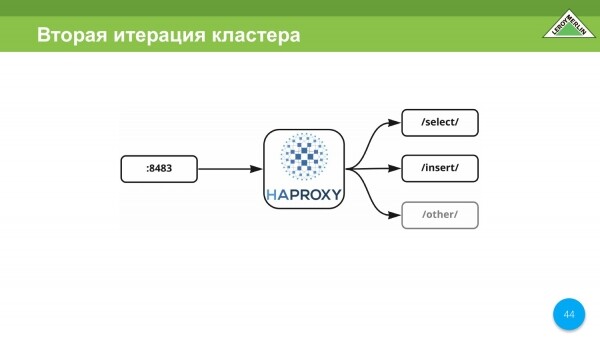
A mi esetünkben a HAPROXY az egyetlen port, amely proxizza a selectet, insertet és a többi szolgáltatást belülre a klaszterbe. Ebben az esetben nem lehetett egy címet létrehozni, több belépési pontot kellett kialakítanunk, mert a VictoriaMetrics klasztert futtató virtuális gépek különböző zónákban vannak egy felhőszolgáltatón belül, azaz nem a saját felhőnkben, hanem kívül.
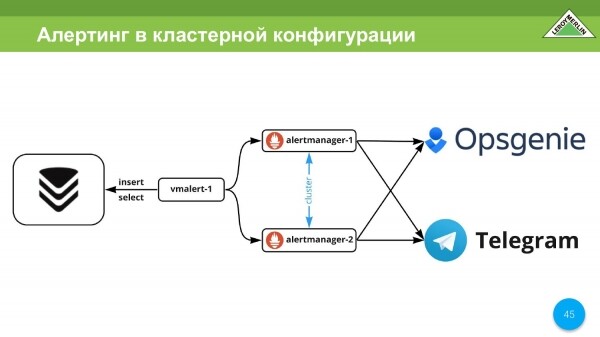
Van riasztásunk. Használjuk. A Prometheus alertmanagert alkalmazzuk. Riasztások szállítására az Opsgenie-t és a Telegramot használjuk. A Telegramon a dev csapat küld, lehet, hogy a prod részéről is jön valami, de inkább statisztikai adatok érkeznek, melyek az mérnököknek szükségesek. Az Opsgenie pedig kritikus riasztásokat kezel. Ezek telefonhívások és incidenskezelés.
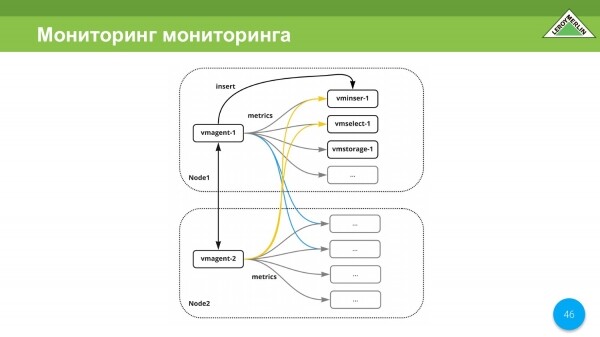
Az örök kérdés: "Ki figyeli a monitorozást?" A mi esetünkben a monitorozás magát a monitorozást figyeli, mert vmagent-et használunk minden noden. Mivel a nodok különböző adatközpontokban helyezkednek el egy szolgáltatón belül, minden adatközpontnak saját csatornája van, függetlenek és még ha bekövetkezik a split brain, akkor is megkapjuk a riasztásokat. Igen, több lesz, de jobb inkább több riasztást kapni, mint egyet sem.
Befejezzük a listánkat a HA megvalósításával.
Továbbá szeretném megemlíteni a VictoriaMetrics közösséggel való tapasztalataimat. Nagyon pozitív élményt kaptunk. A srácok segítőkészek. Minden felvetett esetbe próbálnak belelátni.
Felvetettem kérdéseket a GitHub-on. Ezeket nagyon gyorsan megoldották. Van még pár nyitott kérdés, de már a kód alapján látom, hogy folyik a munka ebben az irányban.
A fő probléma az iterációk során számomra az volt, hogy ha leállítottam egy csomópontot, az első 30 másodpercben a vminsert nem tudta, hogy a backend nem elérhető. Most ezt már megoldottuk. És szó szerint egy vagy két másodperc alatt az adatok már mindegyik fennmaradó csomópontról beérkeznek, és a kérés már nem vár az eltűnt csomópontra.
Valamikor szeretnénk, hogy a VictoriaMetrics egy VictoriaMetrics operátor legyen. Megvártuk. Jelenleg aktívan dolgozunk a VictoriaMetrics operátor köré épített csomagoláson, hogy átvigyük az összes előzetes számítási szabályt, stb. Prometheus-ra, mivel elég aktívan használjuk a Prometheus operátorral járó szabályokat.
Vannak javaslatok a klaszterre vonatkozó megvalósítás javítására. Ezeket fent kifejtettem.
És nagyon szeretnénk a downsamplingot. Az esetünkben a downsampling kizárólag a trendek megjelenítésére szükséges. Durván fogalmazva, egyetlen metrikára egy nap alatt elegendő lesz. Ezek a trendek szükségesek egy évre, háromra, öt évre, tíz évre. És egyetlen metrikai érték teljesen elegendő.
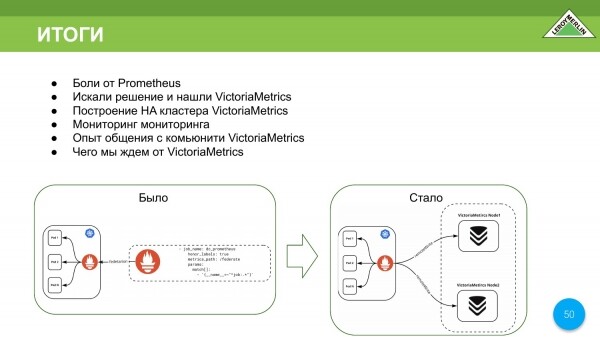
- Szenvedtünk a fájdalomtól, akárcsak néhány kollégánk, miközben a Prometheus-t használtuk.
- Mi a VictoriaMetrics-t választottuk.
- Jól méretezhető mind vertikálisan, mind horizontálisan.
- Különböző komponenseket oszthatunk el különböző csomópontok között a klaszterben, korlátozhatjuk őket memória szempontjából, bővíthetjük a memóriát, stb.
A VictoriaMetrics-t fogjuk használni, mert nagyon tetszik nekünk. Íme, mi volt és mi lett belőle.
Néhány qr-kód a VictoriaMetrics chathoz, az én elérhetőségeim, a LeroyMerlin technikai radarja.
Forrás: habr.com
