

Háttér
Sajnálatos módon a szervert egy titkosító vírus támadta meg, amely "szerencsés véletlen" folytán részben érintetlenül hagyta az .ibd fájlokat (az innodb táblák nyers adatfájljait), ugyanakkor teljesen titkosította az .fpm fájlokat (a struktúrákat). Az .idb fájlokat a következőképpen lehetett csoportosítani:
- visszaállíthatóak a szokásos eszközökkel és útmutatókkal. Az ilyen esetekhez van egy remek ;
- részben titkosított táblák. Főként ezek nagy táblák, amelyekre (ahogy megértettem) a támadók nem rendelkeztek elegendő memóriával a teljes titkosításhoz;
- valamint teljesen titkosított táblák, amelyek nem állíthatók vissza.
A táblák ha hová tartoznak, azt egy banális módszerrel tudtuk meghatározni: bármely szövegszerkesztőben kinyitva a megfelelő kódolással (az én esetemben ez UTF8) és egyszerűen átnézve a fájlt, hogy van-e benne szöveges mező, például:
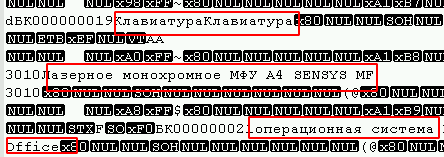
Továbbá, a fájl elején sok 0-ás bájt látható, és a blokkok titkosítási algoritmusát használó vírusok (a legelterjedtebb) általában ezeket is érintik.

Az én esetemben a támadók minden titkosított fájl végén hagytak egy 4 bájtból álló sort (1, 0, 0, 0), ami megkönnyítette a feladatot. A nem fertőzött fájlok keresésére elegendő volt egy script:
def opened(path):
    files = os.listdir(path)
    for f in files:
        if os.path.isfile(path + f):
            yield path + f

for full_path in opened("C:somepath"):
    file = open(full_path, "rb")
    last_string = ""
    for line in file:
        last_string = line
        file.close()
    if (last_string[len(last_string) -4:len(last_string)]) != (1, 0, 0, 0):
        print(full_path)
Így sikerült megtalálni a fájlokat, amelyek az első típushoz tartoznak. A második hosszú manuális munkát igényel, de a már talált fájlok elegendőek voltak. Minden szép és jó, de tudni kell teljesen pontos szerkezetét és (természetesen) előfordult olyan eset, amikor folyamatosan változó táblával kellett dolgozni. Senki sem emlékezett, hogy a mező típusa változott-e, vagy új oszlopot adtak-e hozzá.
Sajnos a Debris City nem tudott segíteni egy ilyen esetben, ezért íródik ez a cikk.
Térjünk a lényegre
Van egy három hónappal ezelőtti táblázatstruktúra, amely nem egyezik a jelenlegivel (lehet, hogy csak egy mező miatt, de akár több is). A táblázat struktúrája:
CREATE TABLE `table_1` (
    `id` INT (11),
    `date` DATETIME ,
    `description` TEXT ,
    `id_point` INT (11),
    `id_user` INT (11),
    `date_start` DATETIME ,
    `date_finish` DATETIME ,
    `photo` INT (1),
    `id_client` INT (11),
    `status` INT (1),
    `lead__time` TIME ,
    `sendstatus` TINYINT (4)
);
E közben ki kell vonni:
id_pointINT (11);id_userINT (11);date_startDATETIME ;date_finishDATETIME .
A visszaállításhoz bájt-alapú elemzés szükséges az .ibd fájlra, majd azok átkonvertálása olvashatóbb formátumba. Mivel a keresett adatok megtalálásához elegendő olyan típusú adatok, mint például int és datetime, a cikk csak ezeket fogja leírni, de néha hivatkozni fog más adat típusokra is, amelyek hasznosak lehetnek hasonló esetekben.
Probléma 1: a DATETIME és TEXT típusú mezőkben NULL értékek voltak, és a fájlban egyszerűen átugorják őket, emiatt nem tudtuk meghatározni a helyreállításhoz szükséges struktúrát az én esetemben. Az új oszlopok alapértelmezett értéke null volt, és egyes tranzakciók elveszhettek az innodb_flush_log_at_trx_commit = 0 beállítás miatt, ezért a struktúra meghatározásához további időt kellett volna költeni.
Probléma 2: figyelembe kell venni, hogy a DELETE utasítással törölt sorok továbbra is megtalálhatóak az ibd fájlban, de az ALTER TABLE során a struktúrájuk nem frissül. Ennek következtében az adatok struktúrája a fájl elejétől a vége felé változhat. Ha gyakran használja az OPTIMIZE TABLE parancsot, akkor valószínűleg nem fog ilyen problémával találkozni.
Figyeljünk arra, hogy, a DBMS verziója befolyásolja az adatok tárolásának módját, és ez a példa más főbb verziók esetén nem működhet. Az én esetemben a Windows verziót használtam, amely a mariadb 10.1.24 volt. Ezenkívül, bár a mariadb-ban InnoDB táblákkal dolgozik, tulajdonképpen azok , ami kizárja az InnoDB mysql módszer alkalmazhatóságát.
Fájl elemzése
Pythonban az adat típusa az adatokat unicode-ban jeleníti meg a szokásos szám készlet helyett. Bár a fájlt ilyen formában is meg lehet vizsgálni, de a kényelem kedvéért a bájtokat numerikus formátumba lehet átkonvertálni, a bájt tömböt pedig egy szokásos tömbbé (list(example_byte_array)). Minden esetben mindkét módszer hasznos lehet az elemzéshez.
Több ibd fájl megtekintésekor a következőkkel találkozhatunk:
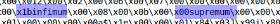
Ráadásul, ha a fájlt ezen kulcsszavak mentén osztjuk fel, akkor túlnyomórészt egyenletes adatblokkok keletkeznek. Az infimumot fogjuk használni osztóként.
table = table.split("infimum".encode())Érdekes megfigyelés, hogy a kis mennyiségű adatokkal rendelkező táblák esetén az infimum és supremum között van egy mutató a blokkban lévő sorok számára.
 — teszt tábla 1 sorral
 — teszt tábla 2 sorral
A szöveges tömb table[0] kihagyható. Átnézve nem találtam nyers adatokat a táblákban. Valószínűleg ez a blokk az indexek és kulcsok tárolására szolgál.
A table[1]-től kezdve és átkonvertálva numerikus tömbbé, már észlelhetők bizonyos mintázatok, mégpedig:
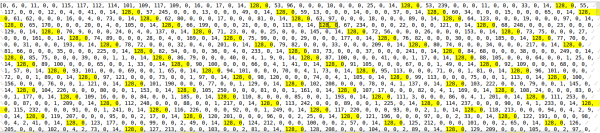
Ezek int értékek, amelyek szövegformátumban vannak tárolva. Az első bájt azt jelzi, hogy a szám pozitív vagy negatív. Az én esetemben minden szám pozitív. A maradék 3 bájt segítségével a következő függvény segítségével ki tudom deríteni a számot. Szkript:
def find_int(val: str):  # példa '128, 1, 2, 3'
    val = [int(v) for v in val.split(", ")]
    result_int = val[1]*256**2 + val[2]*256*1 + val[3]
    return result_int
Például, 128, 0, 0, 1 = 1, vagy 128, 0, 75, 108 = 19308.
A táblázatban volt egy auto-increment primér kulcs, és itt is felfedezhető.
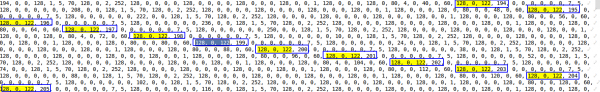
A teszt táblázatok adatai alapján kiderült, hogy a DATETIME objektum 5 bájt hosszú, amely 153-mal kezdődik (valószínűleg az éves intervallumokat jelöli). Mivel a DATETIME tartomány '1000-01-01' és '9999-12-31' között van, úgy vélem, a bájtok száma változhat, de az én esetemben az adatok 2016 és 2019 között mozognak, ezért azt mondhatjuk, hogy 5 bájt elegendő.
A másodpercek nélküli idő meghatározásához a következő függvényeket írtuk meg. Szkript:
day_ = lambda x: x % 64 // 2  # {x,x,X,x,x }

def hour_(x1, x2):  # {x,x,X1,X2,x}
    if x1 % 2 == 0:
        return x2 // 16
    elif x1 % 2 == 1:
        return x2 // 16 + 16
    else:
        raise ValueError

min_ = lambda x1, x2: (x1 % 16) * 4 + (x2 // 64)  # {x,x,x,X1,X2}
Az év és hónap számára nem tudtam megfelelően működő függvényt írni, ezért hardcode-olnom kellett. Szkript:
ym_list = {'2016, 1': '153, 152, 64', '2016, 2': '153, 152, 128',
           '2016, 3': '153, 152, 192', '2016, 4': '153, 153, 0',
           '2016, 5': '153, 153, 64', '2016, 6': '153, 153, 128',
           '2016, 7': '153, 153, 192', '2016, 8': '153, 154, 0',
           '2016, 9': '153, 154, 64', '2016, 10': '153, 154, 128',
           '2016, 11': '153, 154, 192', '2016, 12': '153, 155, 0',
           '2017, 1': '153, 155, 128', '2017, 2': '153, 155, 192',
           '2017, 3': '153, 156, 0', '2017, 4': '153, 156, 64',
           '2017, 5': '153, 156, 128', '2017, 6': '153, 156, 192',
           '2017, 7': '153, 157, 0', '2017, 8': '153, 157, 64',
           '2017, 9': '153, 157, 128', '2017, 10': '153, 157, 192',
           '2017, 11': '153, 158, 0', '2017, 12': '153, 158, 64',
           '2018, 1': '153, 158, 192', '2018, 2': '153, 159, 0',
           '2018, 3': '153, 159, 64', '2018, 4': '153, 159, 128',
           '2018, 5': '153, 159, 192', '2018, 6': '153, 160, 0',
           '2018, 7': '153, 160, 64', '2018, 8': '153, 160, 128',
           '2018, 9': '153, 160, 192', '2018, 10': '153, 161, 0',
           '2018, 11': '153, 161, 64', '2018, 12': '153, 161, 128',
           '2019, 1': '153, 162, 0', '2019, 2': '153, 162, 64',
           '2019, 3': '153, 162, 128', '2019, 4': '153, 162, 192',
           '2019, 5': '153, 163, 0', '2019, 6': '153, 163, 64',
           '2019, 7': '153, 163, 128', '2019, 8': '153, 163, 192',
           '2019, 9': '153, 164, 0', '2019, 10': '153, 164, 64',
           '2019, 11': '153, 164, 128', '2019, 12': '153, 164, 192',
           '2020, 1': '153, 165, 64', '2020, 2': '153, 165, 128',
           '2020, 3': '153, 165, 192','2020, 4': '153, 166, 0',
           '2020, 5': '153, 166, 64', '2020, 6': '153, 1, 128',
           '2020, 7': '153, 166, 192', '2020, 8': '153, 167, 0',
           '2020, 9': '153, 167, 64','2020, 10': '153, 167, 128',
           '2020, 11': '153, 167, 192', '2020, 12': '153, 168, 0'}

def year_month(x1, x2):  # {x,X,X,x,x }

    for key, value in ym_list.items():
        key = [int(k) for k in key.replace("'", "").split(", ")]
        value = [int(v) for v in value.split(", ")]
        if x1 == value[1] and x2 // 64 == value[2] // 64:
            return key
    return 0, 0
Biztos vagyok benne, hogy ha időt szánunk rá, ezt a félreértést is meg lehet szüntetni.
Következő lépésként, egy datetime objektumot visszaadó függvény. Script:
def find_data_time(val:str):
    val = [int(v) for v in val.split(", ")]
    day = day_(val[2])
    hour = hour_(val[2], val[3])
    minutes = min_(val[3], val[4])
    year, month = year_month(val[1], val[2])
    return datetime(year, month, day, hour, minutes)
Sikerült észlelni az int, int, datetime, datetime értékek közötti gyakran előforduló ismétlődéseket. 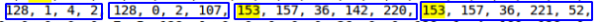 , úgy tűnik, ez az, amire szükség van. Ráadásul az ilyen sorozat kétszer nem ismétlődik meg egy sorban.
Reguláris kifejezés használatával keressük a szükséges adatokat:
fined = re.findall(r'128, d*, d*, d*, 128, d*, d*, d*, 153, 1[6,5,4,3]d, d*, d*, d*, 153, 1[6,5,4,3]d, d*, d*, d*', int_array)Vegyük észre, hogy a keresés során e kifejezés alapján nem lehet meghatározni a NULL értékeket a szükséges mezőkben, de az én esetemben ez nem kritikus. Ezután egy ciklusban átvizsgáljuk a találtakat. Script:
eredmény = []
for val in fined:
    pre_result = []
    bd_int  = re.findall(r"128, d*, d*, d*", val)
    bd_date= re.findall(r"(153, 1[6,5,4,3]d, d*, d*, d*)", val)
    for it in bd_int:
        pre_result.append(find_int(bd_int[it]))
    for bd in bd_date:
        pre_result.append(find_data_time(bd))
    result.append(pre_result)
Maga a lényeg, hogy a result tömbből származó adatok azok, amikre szükségünk van. ###PS.###
Értem, hogy ez a módszer nem mindenki számára lesz megfelelő, de a cikk fő célja inkább az, hogy cselekvésre ösztönözzön, mintsem hogy minden problémáját megoldja. Úgy gondolom, a legjobb megoldás az lenne, ha elkezdené tanulmányozni a forráskódot magát. , de a korlátozott idő miatt a jelenlegi módszer tűnik a leggyorsabbnak.
Egyes esetekben, ha elemezte a fájlt, akkor képes lesz meghatározni a hozzávetőleges struktúrát, és az above hivatkozások egyik standard módszerével rekonstruálni. Ez sokkal helyesebb lesz, és kevesebb problémát okoz.
Forrás: habr.com
