

Üdvözlöm, és először is egy kis líra. Néha irigylem azokat a kollégákat, akik otthonról dolgoznak – hiszen csodálatos, hogy az Internethez csatlakozott világ bármelyik pontjáról lehet dolgozni, szünetet bármikor be lehet iktatni, projektfelelősség és határidők, nem pedig az irodában 8-17 óráig lenni. Az én pozícióm és munkaköri feladataim gyakorlatilag kizárják a hosszú távú távolmaradást az adatközpontból. Azonban – időnként előfordulnak érdekes esetek, mint ami az alábbiakban szerepel – és megértem, hogy kevés olyan pozíció van, ahol ennyi lehetőség van a belső troubleshooter kreatív kifejezésére.
Kis diszklaimer – a cikk írásának időpontjában az eset teljesen nem megoldott, de figyelembe véve a szolgáltatók válaszidejét, a teljes megoldás még hónapokat is igénybe vehet, míg a tapasztalataimat már most szeretném megosztani. Remélem, tisztelt olvasók, megbocsátják nekem ezt a sietséget. De elég a vizet, mi a helyzet az esettel?
Először is a bevezetés: van egy cég (ahol hálózati mérnökként dolgozom), amely ügyfélmegoldásokat hostol privát VMWare felhőben. A legtöbb új megoldás VXLAN szegmensekhez csatlakozik, amelyeket az NSX-V kezel – nem fogom értékelni, mennyi időt nyertem ezzel a megoldással, röviden szólva – sokat. Még a kollégák NSX ESG beállítására is sikerült tanítani, és kis ügyfélmegoldások zökkenőmentesen valósulnak meg részvételem nélkül. Fontos megjegyzés – a control plane unicast-replikáción alapul. A hipervizorok redundánsan kapcsolódnak két interfészen keresztül különböző Juniper QFX5100 fizikai switch-ekhez (Virtual Chassis-be összeállítva) és a route based on originating virtual port időzítési politikájával – ez azért van, hogy teljes legyen a kép.
Az ügyfélmegoldások nagyon változatosak: a Windows IIS-től, ahol minden webkiszolgáló komponens egy gépen van telepítve, egészen a viszonylag nagyokig – például load-balanced Apache webfrontok + LB MariaDB Galera-ban + megosztó kiszolgálók, amelyeket GlusterFS segítségével szinkronizálnak. Gyakorlatilag minden szervert külön kell figyelni, és nem minden komponensnek van nyilvános címe – ha Ön már találkozott ezzel a feladattal, és van elegánsabb megoldása, örömmel fogadom a tanácsait.
Az én megfigyelési megoldásom a tűzfal (Fortigate) "csatlakoztatásán" alapul minden belső ügyfélhálózathoz (+SNAT, és természetesen a megengedett forgalom típusára vonatkozó szigorú korlátozások) és a belső címek figyelésén. Ezzel elérhető egyfajta egységesítés és a megfigyelés egyszerűsítése. Maga a megfigyelés a PRTG szerver klaszterből történik. A megfigyelés vázlata körülbelül így néz ki:
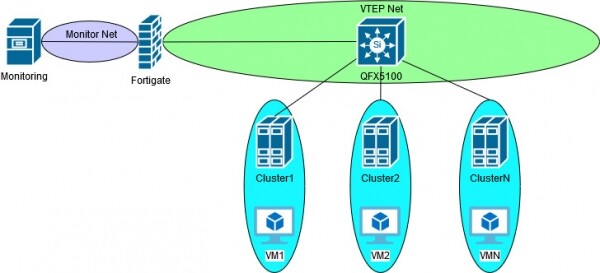
Amíg csak VLAN-okkal dolgoztunk, minden meglehetősen szokványos volt és pontosan úgy működött, mint egy óra. A NSX-V és VXLAN bevezetése után felmerült a kérdés — lehet-e a régi módon folytatni a megfigyelést? E kérdés felvetésekor a leg "gyorsabb" megoldás az NSX ESG telepítése és a VXLAN trunk interfész csatlakoztatása volt a VTEP hálózathoz. Gyorsnak idézőjelben, mivel a GUI használata az ügyfélhálózatok, SNAT és tűzfalszabályok beállításához bár egységesíti a kezelést a vSphere egységes felületén, de véleményem szerint meglehetősen terjedelmes és mint minden, korlátozza a hibakereséshez rendelkezésre álló eszközök körét. Aki használta az NSX ESG-t „valódi” tűzfal helyettesítéseként, az valószínűleg egyetértene. Bár talán egy ilyen megoldás stabilabb lenne — hiszen minden egyetlen beszállítón belül történik.
Egy másik megoldás az NSX DLR híd üzemmódban való használata VLAN és VXLAN között. Itt minden világos — gyakorlatilag elveszik a VXLAN használatának előnye — hiszen ebben az esetben ugyanúgy VLAN-t kell húzni a monitorozó telepítéshez. Egyébként ennek a megoldásnak a kidolgozása során találkoztam egy problémával, amikor a DLR-híd nem küldött csomagokat a virtuális gépnek, amelyik ugyanazon a hoszton volt vele. Tudom, tudom — a NSX-V könyvekben és útmutatókban egyértelműen le van írva, hogy az NSX Edge-nek külön klaszter kell, de ez a könyvekben van… Akárhogy is, a támogatással eltöltött pár hónap után nem oldottuk meg a problémát. Az eljárás logikáját viszont megértettem — a hipervizor kernel modulja, amely a VXLAN encapsulációért felelős, nem volt használatban, ha a DLR és a megfigyelt szerver ugyanazon a hoszton található, mivel a forgalom nem hagyja el a hosztot, és logikailag kapcsolódnia kell a VXLAN szegmenshez — az encapsuláció nem szükséges. A támogatással a vdrPort virtuális interfésznél álltunk meg, amely logikailag egyesíti az uplinkeket, és ő is végzi a hídszerűség/encapsulációt — itt észleltünk eltérést a bejövő forgalomban, amelyet jelen ügyben felvettem a feldolgozásra. De, mint mondtam, ezt az ügyet nem fejeztem be, mivel egy másik projektre irányítottak, és az ág kezdetben is zsákutca volt, így nem volt különösebb kedvem fejleszteni. Ha jól emlékszem, a probléma az NSX 6.1.4 és 6.2 verzióiban volt megfigyelhető.
És itt — bingo! A Fortinet bejelenti a natív . És nem csak point-to-point vagy VXLAN-over-IPSec, nem szoftveres hídszerűség VLAN-VXLAN — mindezt már az 5.4-es verzió óta kezdték bevezetni (és másoknál is megjelent ), és a valódi támogatás unicast vezérlő síkjához. A megoldás implementálása során egy másik problémával is szembesültem — a megfigyelt szerverek időnként „eltűntek”, majd megjelentek a monitorozásban, bár a virtuális gép aktív volt. Mint kiderült, ennek az volt az oka, hogy elfelejtettem engedélyezni a Pinget a VXLAN interfészen. A klaszterek újraelosztásakor a virtuális gépek mozogtak, és a vMotion a Ping segítségével zárult le, hogy megjelölje az új ESXi gazdagépet, ahová a gép átkonfigurálódott. Hiburázom, de ez a probléma ismét megtépázta a bizalmat a gyártó, ebben az esetben Fortinet, támogatásában. Nem is beszélve arról, hogy minden VXLAN-nal kapcsolatos eset azzal a kérdéssel kezdődik: „hol található a VLAN-VXLAN beállítás a szoftveres kapcsolódón?” Ezúttal azt tanácsolták, hogy változtassak az MTU-n — ez a Pinghez van, ami 32 byte. Aztán „játszadozz” a tcp-send-mss és tcp-receive-mss beállításokkal a politikákban — a VXLAN, ami UDP-ben van beágyazva. Huh, elnézést — nagyon sokat mondtam. Szóval ezt a problémát saját erőmből oldottam meg.
Miután sikeresen végrehajtottuk a tesztforgalmat, úgy döntöttünk, hogy bevezetjük ezt a megoldást. A termelési környezetben kiderült, hogy egy-két nap után fokozatosan minden eltűnik, ami VXLAN-on keresztül van figyelve. Az interfész deaktiválása/aktiválása segített, de csak időlegesen. Emlékezve a gyártó támogatásának lassúságára, én magam kezdtem el a hibaelhárítást — végül is az én cégem, az én hálózatom — az én felelősségem.
A hibaelhárítás menete spoiler alatt. Aki fáradt a betűktől és a hencegéstől — ugorjon át, és lépjen a posztanalízishez.
A hibaelhárítás meneteKöszönöm, hogy folytatták az olvasást — folytassuk!
Tehát, a megfigyelés egy ideig működik, majd magától leáll. Ezért a tűzfal politikákban valószínűleg nincs probléma. Azonban, mivel korábban már szembesültem a Fortigate 5.6+ verziókban lévő rendszerfolyamatok fagyásának problémájával, először a „diagnose debug flow”-t nézzük — a forgalom várhatóan engedélyezve van, és elhagyja az interfészt, és várhatóan semmi sem érkezik válaszként. Tehát tovább ásunk a veremben. Sajnos el kell rejtenem a címeket, még ha RFC1918-as címekről is van szó, de remélem, hogy elegendő leírást adok a folyamat megértéséhez. A VXLAN-on belüli szerver címe x.x.x.15, a Fortigate interfésze x.x.x.254, az összes többi cím a VTEP hálózathoz tartozik.
A VXLAN encapsulated packet transfer requires correct information in several tables. For the overlay, this includes ARP and OVSDB, while for the underlay, it also includes ARP and CAM. In the case of Fortigate, VXLAN FDB is OVSDB. Let’s start there:
 fortigate (root) #diag sys vxlan fdb list vxlan-LS
mac=00:50:56:8f:3f:5a state=0x0002 flags=0x00 remote_ip=ü.ü.ü.47 port=4789 vni=5008 ifindex=7
Everything here is quite straightforward — the MAC address of the virtual machine must be on the VTEP with the address ü.ü.ü.47. Looking at the contents and settings of the ESXI cluster, I find that the MAC of the virtual machine is correct, and the VTEP address is also correct. I check the CAM/ARP table on the Fortigate — once again everything matches with the settings of the ESXI host:
fortigate (root) #get sys arp | grep ü.ü.ü.47
ü.ü.ü.47 0 00:50:56:65:f6:2c dmz
The tables are correct and the traffic is going out — maybe the problem is not with Fortigate? I deliberately skipped the traffic switching analysis on the Juniper — logically, this should be the next troubleshooting step, but my network is simple — only one VLAN for VTEP and all components are directly connected. Plus, I remember the case with the DLR bridge, VDR, and disappearing traffic — I go to sniff on the ESXI host and simultaneously create a case with VMWare. Below, the MAC "97:6e" belongs to Fortigate, vmnic1 is the interface that has the VTEP with the address ü.ü.ü.47, sniffing in both directions "—dir 2":
pktcap-uw --uplink vmnic1 --vni 5008 --mac 90:6c:ac:a9:97:6e --dir 2 -o /tmp/monitor.pcap
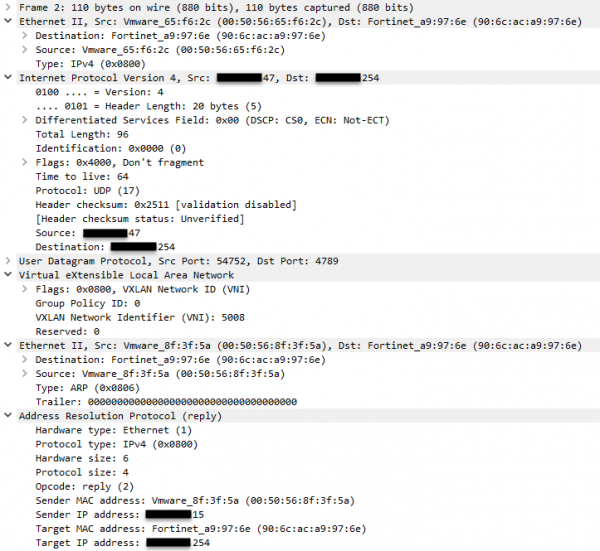
Progress — in the sniff, I see an ARP request and the incoming response. I only bring the ARP response, and everything is correct there. I didn’t mention that during all this time, the monitoring server is pinging the address х.х.х.15 — where is the ICMP traffic? I remember that I have two uplinks. One could argue that the source virtual port is the same (my teaming policy), which means that the same uplink should be chosen for the same vNIC, but since I am on the host, checking the other uplink is not a problem:
pktcap-uw --uplink vmnic4 --vni 5008 --mac 90:6c:ac:a9:97:6e --dir 2 -o /tmp/monitor.pcap
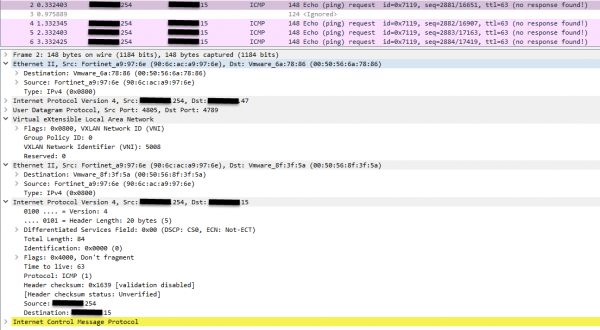
Több kérés érkezik a FortiGate-től, de válasz nincs. Vagyis a probléma nem a FortiGate-ben van. Hát mindegy – gondoltam – megint ugyanaz a probléma a VDR eltűnő forgalmával, megint pár hónapig tart, amíg a megfelelő irányba terelgetem az ügyet. Pár nap múlva lenyugodva, és nem akarva megelégedni a felfüggesztett állapottal, elkezdtem még több sniffert gyűjteni a támogatáshoz, hogy felgyorsítsam a folyamatot. És itt a „véletlenül” a tekintetem az Ethernet kapszulázás alatt lévő burkolatra téved. A király nem igazi és a VTEP MAC címe nem egyezik az IP-jével. Alaphelyzetbe állítom, sniffelem, kutatom – igaz, hogy nem igaz. Itt van az ARP táblázat a könnyebb összehasonlítás érdekében. Kérjük, figyeljen a legelső Ethernet kapszulázásra a fenti képen:
fortigate (root) #get sys arp | grep 1.1.1.47
1.1.1.47 0 00:50:56:65:f6:2c dmz
fortigate (root) #get sys arp | grep 1.1.1.42
1.1.1.42 0 00:50:56:6a:78:86 dmz
Tehát, mit kapunk az eredményül – a virtuális gép migrálása után a FortiGate megpróbálja forgalmat küldeni a VTEP-re a (helyes) VXLAN FDB-ből, de hibás DST MAC címet használ, és a forgalmat várhatóan eldobja a hypervisor fogadó interfésze. Ráadásul az esetek egy a négyből ez a MAC a migrációs gépet indító eredeti hypervisorhoz tartozott.
Tegnap kaptam egy levelet a Fortinet támogatásától – az ügyemmel kapcsolatban nyitottak egy hibát, 615586. Egyáltalán nem tudom, örüljek-e vagy szomorkodjak: egyesek szerint a probléma nem a beállításokban van, mások szerint a javítás a legjobb esetben a következő firmware frissítéssel érkezik. Az egóm duzzasztja egy másik hibát is, amelyet múlt hónapban fedeztem fel, igaz, akkor az HTML5 GUI vSphere-ben. Hát, ez már egy helyi QA osztály a szállítóktól...
Merészen feltételezem a következőt:
1 — a multicast vezérlési sík valószínűleg nem lesz kitéve a leírt probléma - hiszen a VTEP MAC címek a csoport IP címéből származnak, amelyre az interfész fel van iratkozva.
2 — valószínűleg a FortiGate problémája van a Network Processorra (nagyjából a CEF-hez hasonló) történő ülések offloadolásával – ha minden csomagot a CPU-n keresztül engedünk át, akkor olyan táblázatok lépnek működésbe, amelyek tartalmazzák a helyes – legalábbis látszólag – információt. Ennek a feltételezésnek kedvez az is, hogy segít az interfész lezárása / megnyitása vagy néhány perc várakozás – 5 percnél hosszabb.
3 — a teaming politika megváltoztatása, például explicit failover-re, vagy a LAG bevezetése nem oldja meg a problémát, mivel a megfigyelések szerint a forgalom a kapszulázott csomagokban a forrást adó hypervisor MAC címének „megrekedését” figyelték meg.
Ennek fényében megoszthatom, hogy nemrég fedeztem fel , ahol az egyik cikkben azt állították, hogy a stateful tűzfalak és a cache-elt adatátviteli módszerek csak ideiglenes megoldások. Nos, nem vagyok elég tapasztalt az IT terén ahhoz, hogy ilyet állítsak, ráadásul nem minden blogcikk állításával értek egyet rögtön. De valami azt súgja, hogy van igazság Ivan szavaiban.
Köszönöm a figyelmet! Örömmel válaszolok a kérdésekre és várom a konstruktív kritikát.
Forrás: habr.com
