

A Zabbix egy monitorozó rendszer. Mint minden más rendszer, ez is három alapvető problémával szembesül, amelyek a monitorozó rendszerekre jellemzőek: adatok gyűjtése és feldolgozása, a történet tárolása és annak tisztítása.
Az adatok megszerzése, feldolgozása és rögzítése időt vesz igénybe. Kicsit, de egy nagy rendszer esetében ez jelentős késlekedéshez vezethet. A tárolás problémája az adatokhoz való hozzáférés kérdése. Ezeket jelentések, ellenőrzések és triggerek használják. Az adatok hozzáférésének késlekedése szintén befolyásolja a teljesítményt. Amikor az adatbázisok megnőnek, a nem releváns adatokat el kell távolítani. Az eltávolítás pedig nehéz művelet, amely szintén erőforrásokat igényel.
A Zabbix adatgyűjtési és tárolási késlekedésproblémáit gyorsítótárazással oldják meg: különféle gyorsítótárak, adatbázison belüli gyorsítárazás. A harmadik problémára a gyorsítárazás nem megfelelő, ezért a Zabbix a TimescaleDB-t alkalmazta. Erről fog beszélni Andrej Gusszin — technikai támogató mérnök . André a Zabbix-nál több mint 6 éve dolgozik a támogatásban, és közvetlenül is foglalkozik a teljesítménnyel.
Hogyan működik a TimescaleDB, és mekkora teljesítményt nyújt a hagyományos PostgreSQL-hez képest? Milyen szerepet játszik a Zabbix a TimescaleDB adatbázis számára? Hogyan lehet nulláról elindítani, és hogyan migrálhatunk PostgreSQL-ről, és melyik konfiguráció teljesítménye a legjobb? Ezt mind a továbbiakban megismerheti.

Teljesítmény kihívások
Minden monitorozó rendszer bizonyos teljesítmény kihívásokkal találkozik. Háromról fogok beszélni: adatok gyűjtése és feldolgozása, tárolás, a történet tisztítása.
Gyors adatgyűjtés és feldolgozás. Egy jó monitorozó rendszernek gyorsan kell megszereznie az összes adatot és azokat a triggerekkel összhangban feldolgoznia — saját kritériumai szerint. A feldolgozás után a rendszernek ezeket az adatokat is gyorsan el kell tárolnia az adatbázisban, hogy később felhasználhassa őket.
Történelem tárolása. Egy jó monitorozó rendszernek tárolnia kell a történelmet az adatbázisban, és könnyen hozzáférhetővé kell tennie a metrikáihoz. A történet szükséges, hogy jelentésekhez, grafikonokhoz, triggerekkel, küszöbértékekkel és számított adatpontok figyelmeztetésekhez történő felhasználásához hozzáférhessünk.
A történelem tisztítása. Néha elérkezik az a nap, amikor már nincs szükség a metrikák tárolására. Miért lenne szüksége öt évvel ezelőtt, egy hónappal vagy két hónappal ezelőtti adatokra: egyes csomópontok eltávolításra kerültek, egyes hosztok vagy metrikák már nem szükségesek, mert elavultak és már nem gyűjtik őket. Egy jó monitoring rendszernek tárolnia kell a történelmi adatokat, és időnként törölnie kell őket, hogy az adatbázis ne duzzadjon meg.
Az elavult adatok törlése sürgető kérdés, amely jelentősen befolyásolja az adatbázis teljesítményét.
Zabbix cache-elés
A Zabbixban az első és második hívás a cache-elés segítségével van megoldva. Az adatok gyűjtésére és feldolgozására a RAM-ot használják. Tárolás céljából történik az eseményekben, grafikonokban és számított adatelemekben. Az adatbázis oldalán van egy bizonyos cache-elés a fő lekérdezésekhez, például grafikonokhoz.
A Zabbix szerver oldalán a cache-elés a következőket foglalja magában:
- ConfigurationCache;
- ValueCache;
- HistoryCache;
- TrendsCache.
Nézzük meg őket részletesebben.
ConfigurationCache
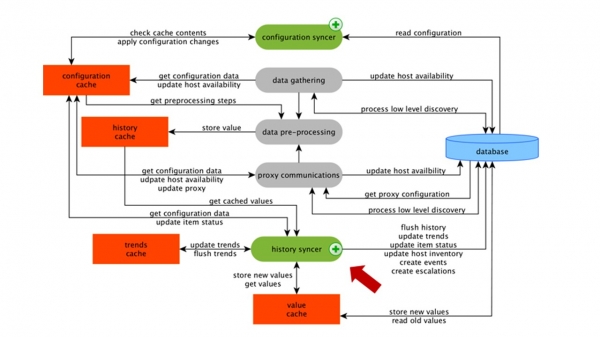
Ez a fő cache, ahol a metrikákat, hosztokat, adatelemeket és triggereket tároljuk — mindazt, ami a PreProcessinghez és az adatok gyűjtéséhez szükséges.
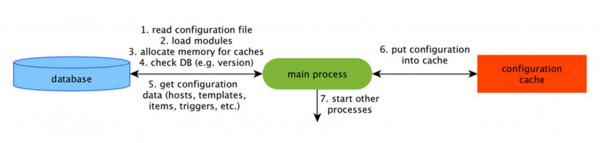
Mindez a ConfigurationCache-ben tárolódik, hogy ne generáljon felesleges lekérdezéseket az adatbázisban. A szerver indítása után frissítjük ezt a cache-t, konfigurációkat hozunk létre, és időszakonként frissítjük őket.
Adatgyűjtés
A séma elég nagy, de a fő része az gyűjtők.Ezek különböző „pollerek” — adatgyűjtési folyamatok. Ezek felelősek a különböző típusú gyűjtésért: SNMP-n, IPMI-n keresztül gyűjtik az adatokat, és mindezt a PreProcessingre továbbítják.
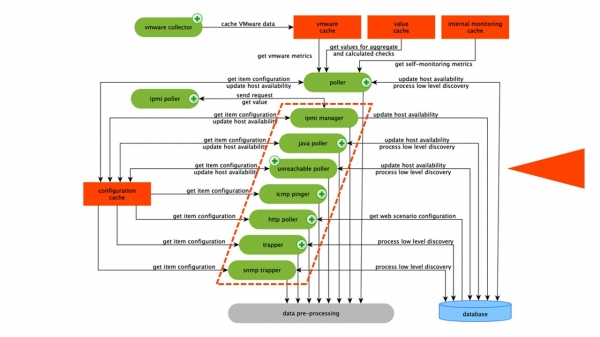 A gyűjtők narancssárga vonallal vannak körülhatárolva.
A Zabbixban léteznek számított aggregáló adatelemek, amelyek szükségesek az ellenőrzések agregálásához. Ha rendelkezésünkre állnak, akkor közvetlenül a ValueCache-ből vonjuk el az adatokat.
PreProcessing HistoryCache
Minden gyűjtő a ConfigurationCache-t használja, hogy feladatokat kapjon. Ezután a PreProcessingre továbbítják.
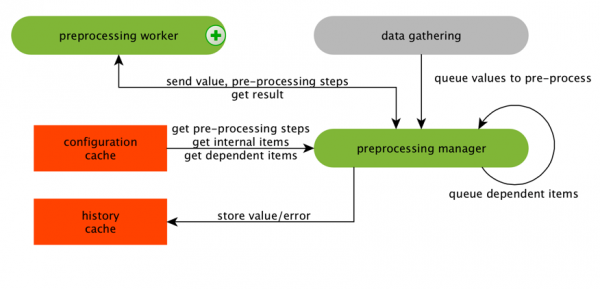
A PreProcessing a ConfigurationCache-t használja, hogy megkapja a PreProcessing lépéseit. Különböző módokon dolgozza fel ezeket az adatokat.
Az adatok PreProcessing általi feldolgozása után a HistoryCache-be mentjük őket, hogy feldolgozhassuk. Ezzel ér véget az adatgyűjtés, és áttérünk a Zabbix fő folyamatára — history syncer, mivel ez monolitikus architektúra.
Megjegyzés: A PreProcessing elég nehéz művelet. A 4.2-es verziótól proxy-ra került. Ha nagyon nagy a Zabbixunk, sok adatelemmel és gyakori gyűjtéssel, akkor ez jelentősen megkönnyíti a munkát.
ValueCache, történelmi és trendkészlet
A történeti szinkronizáló a fő folyamat, amely atomárisan dolgozza fel az adatokat, azaz minden egyes értéket.
A történeti szinkronizáló a HistoryCache-ből veszi az értékeket, és ellenőrzi a Configuration-ben a számításokra vonatkozó kiváltó okokat. Ha vannak, akkor kiszámolja őket.
A történeti szinkronizáló eseményt és eszkalációt hoz létre, hogy értesítéseket generáljon, ha a konfiguráció ezt megköveteli, és nyilvántartásba veszi. Ha vannak kiváltó okok a további feldolgozáshoz, ezeket az értékeket memóriában tartja a ValueCache-ben, hogy ne kelljen az eseménytáblára hivatkoznia. Így a ValueCache olyan adatokat halmoz fel, amelyek a kiváltó okok, illetve a számítandó elemek kiszámításához szükségesek.
A történeti szinkronizáló minden adatot tárol az adatbázisban, majd az az lemezre kerül. A feldolgozási folyamat itt véget ér.
Az adatbázisban való gyorsítótárazás
Az adatbázis oldalán különféle gyorsítótárak vannak, amikor grafikont vagy eseményjelentést szeretne megjeleníteni:
Innodb_buffer_poola MySQL oldalán;shared_buffersa PostgreSQL oldalán;effective_cache_sizeaz Oracle oldalán;shared_poola DB2 oldalán.
Sok más gyorsítótár is létezik, de ezek a legfontosabbak minden adatbázis számára. Ezek lehetővé teszik az operatív memória használatát a gyakran szükséges adatokhoz a lekérdezések során. Mindegyiknek megvan a saját technológiája erre.
Az adatbázis teljesítménye kritikus fontosságú
A Zabbix szerver folyamatosan összegyűjti az adatokat és tárolja azokat. Indításkor szintén olvas a történelemből a ValueCache feltöltéséhez. A Zabbix API, amely a webes interfész alapjain épül fel. A Zabbix API kapcsolatot létesít az adatbázissal, és megkapja a szükséges adatokat a grafikonokhoz, jelentésekhez, eseménylistsákhoz és legfrissebb problémákhoz.
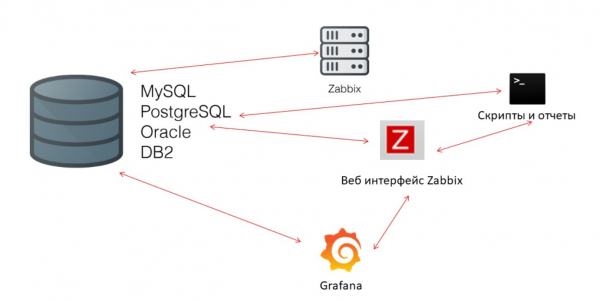
A vizualizáláshoz — Grafanába. Felhasználóink körében ez népszerű megoldás. Képes közvetlenül lekérdezéseket küldeni a Zabbix API-n keresztül az adatbázisba, és meghatározott versenyt teremt az adatok beszerzéséhez. Ezért szükség van egy finomabb és jobb adatbázisbeállításra, hogy megfeleljen a gyors eredménykiadásnak és tesztelésnek.
Housekeeper
A Zabbix teljesítményének harmadik kihívása a történetek tisztítása a Housekeeper segítségével. Az összes beállítást betartja — az adatgyűjtési elemeknél meg van adva, hogy hány napig kell tárolni a változások dinamikáját.
A TrendsCache-t pillanatok alatt számítjuk ki. Amikor adatok érkeznek, egy órára aggregáljuk őket, és táblákba írjuk a trendek változásainak dinamikájához.
A takarító program elindul és eltávolítja az információkat az adatbázisból a szokásos „selects” segítségével. Ez nem mindig hatékony, amit a belső folyamatok teljesítménygrafikonjaiból érthetünk meg.
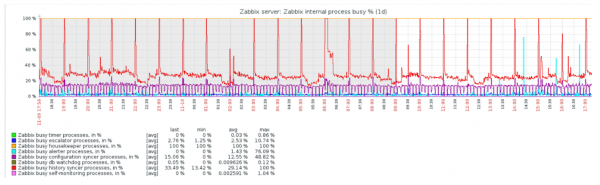
A piros grafikon azt mutatja, hogy a History syncer folyamatosan dolgozik. A felső narancssárga grafikon pedig a Housekeeper, ami folyamatosan elindul. Vár a DB-től, hogy eltávolítsa az összes olyan sort, amelyet megadott.
Mikor érdemes kikapcsolni a Housekeeper-t? Például, ha van egy „Item ID” és el kell távolítani az utolsó 5 ezer sort egy meghatározott időn belül. Nyilvánvalóan ez indexek révén történik. De általában a dataset nagyon nagy, és a DB így is leolvassa a lemezről és a cache-be emeli az adatokat. Ez mindig egy nagyon drága művelet a DB-nek, és az adatbázis méretétől függően teljesítményproblémákhoz vezethet.
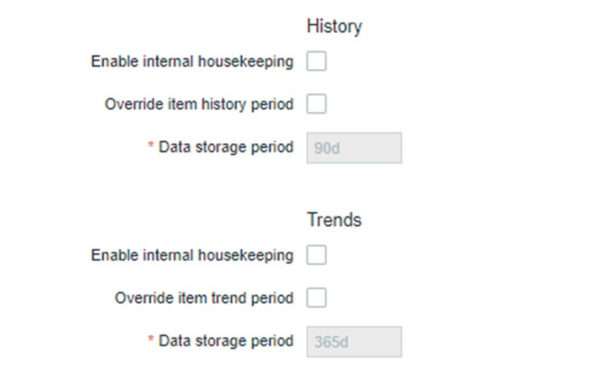
A Housekeeper egyszerűen kikapcsolható. A Web-interfészen van egy beállítás a „General Administration”-ban a Housekeeper számára. Kikapcsoljuk a belső Housekeeping-et a belső trendtörténethez, és már nem kezeli ezt.
A Housekeeper-t kikapcsolták, a grafikonok egyensúlyba kerültek — milyen problémák merülhetnek fel ilyenkor, és mi segíthet a harmadik teljesítményprobléma megoldásában?
Partitioning — szekcionálás vagy partícionálás
Általában a partícionálás különböző módon van beállítva minden relációs DB-nél, amelyet felsoroltam. Mindegyik saját technológiával rendelkezik, de összességében hasonlóak. Az új partíció létrehozása gyakran meghatározott problémákhoz vezet.
Általában a partíciókat a „setup”-tól függően állítják be — az egy nap alatt létrejövő adatok mennyiségétől. Általában a Partitioning-ot egy napra állítják be, ez a minimum. Az új partíciók trendjei — 1 hónapra.
Az értékek változhatnak nagyon nagy „setup” esetén. Ha a kis „setup” 5 000 nvps (új érték másodpercenként) alatti, a közepes — 5 000 és 25 000 között, akkor a nagy — 25 000 nvps felett. Ezek nagy és nagyon nagy telepítések, amelyek gondos adatbázis-beállítást igényelnek.
Nagyon nagy telepítéseken a napi szakasz nem biztos, hogy optimális. Láttam már MySQL partíciókat, amelyek napi 40 GB vagy annál nagyobb méretűek voltak. Ez egy nagyon nagy adatmennyiség, amely problémákhoz vezethet, és csökkenteni kell.
Mit ad a Partitioning?
Táblák szekcionálása. Gyakran ezek külön fájlok a lemezen. A lekérdezési terv optimálisan választ ki egy partíciót. A partícionálást általában tartomány szerint hajtják végre — ez a Zabbixra is vonatkozik. Mi itt "timestamp"-ot használunk — az idő az epochától kezdve. Nálunk ezek hagyományos számok. Megadja a nap kezdetét és végét — ez a partíció.
Gyors törlés — DELETE. Egy fájl/alttábla kerül kiválasztásra, nem pedig a sorok törlésének lekérdezése.
Jelentősen felgyorsítja az adatok lekérdezését SELECT — egy vagy több partíciót használ, nem az egész táblát. Ha két nappal ezelőtt adatokra van szüksége, azokat gyorsabban választják ki az adatbázisból, mert csak egy fájlt kell betölteni a cache-be, nem pedig egy nagy táblát.
Gyakran sok adatbázis is gyorsítja INSERT — a beillesztéseket a child-táblába.
TimescaleDB
A 4.2-es verziónál figyelmet fordítottunk a TimescaleDB-re. Ez egy PostgreSQL kiterjesztés natív interfésszel. A kiterjesztés hatékonyan kezeli az időbeli adatsorokat, miközben megőrzi a relációs adatbázisok előnyeit. A TimescaleDB automatikusan partícionál is.
A TimescaleDB-ben van egy fogalom hipertábla (hypertable), amelyet létrehoz. Ebben találhatók a chunkok — partíciók. A chunkok automatikusan kezelt darabjai a hipertáblának, amelyek nem befolyásolják más darabokat. Minden chunk rendelkezik egy saját időtartományával.
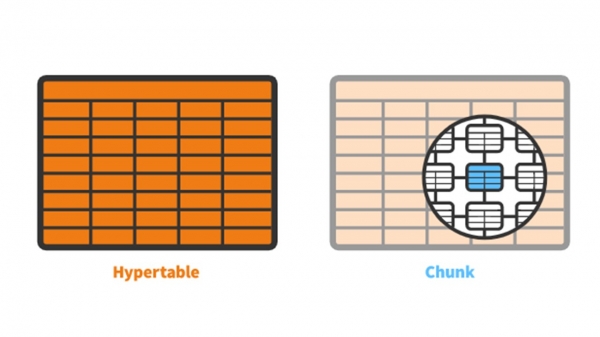
TimescaleDB vs PostgreSQL
A TimescaleDB valóban hatékonyan működik. A kiterjesztés készítői azt állítják, hogy ők a lekérdezések feldolgozásához helyesebb algoritmust használnak, különösen az <code>inserts</code> esetében. Amikor a dataset-bekérés méretei nőnek, az algoritmus folyamatos teljesítményt biztosít.
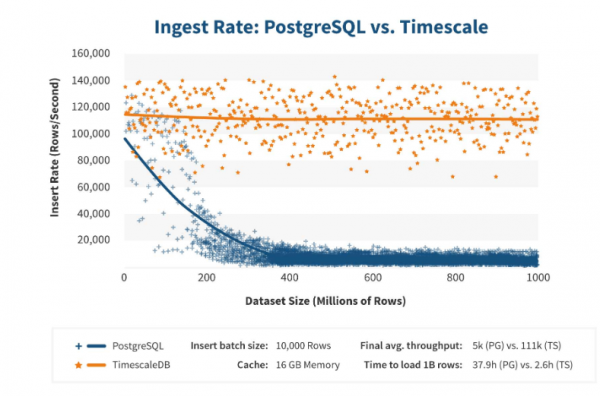
200 millió sor után a PostgreSQL általában jelentősen lelassul és teljesítményének 0-ra csökken. A TimescaleDB hatékonyan támogatja az "inserts"-et bármilyen mennyiségű adat mellett.
Telepítés
A TimescaleDB telepítése meglehetősen egyszerű bármely csomagra. A minden részletesen le van írva — ez a PostgreSQL hivatalos csomagjaitól függ. A TimescaleDB kézzel is összegyűjthető és lefordítható.
A Zabbix adatbázisban egyszerűen aktiváljuk a kiterjesztést:
echo "CREATE EXTENSION IF NOT EXISTS timescaledb CASCADE;" | sudo -u postgres psql zabbix Aktiválja a kiterjesztést és létrehozza azt a Zabbix adatbázisban. Az utolsó lépés a hipertábla létrehozása.
A történelem táblák migrálása TimescaleDB-re
Ehhez egy külön funkció áll rendelkezésre create_hypertable:
SELECT create_hypertable('history', 'clock', chunk_time_interval => 86400, migrate_data => true);
SELECT create_hypertable('history_unit', 'clock', chunk_time_interval => 86400, migrate_data => true);
SELECT create_hypertable('history_log', 'clock', chunk_time_interval => 86400, migrate_data => true);
SELECT create_hypertable('history_text', 'clock', chunk_time_interval => 86400, migrate_data => true);
SELECT create_hypertable('history_str', 'clock', chunk_time_interval => 86400, migrate_data => true);
SELECT create_hypertable('trends', 'clock', chunk_time_interval => 86400, migrate_data => true);
SELECT create_hypertable('trends_unit', 'clock', chunk_time_interval => 86400, migrate_data => true);
UPDATE config SET db_extension='timescaledb', hk_history_global=1, hk_trends_global=1
A függvény három paramétert tartalmaz. Az első — az adatbázisban lévő tábla,melyhez hipertáblát kell létrehozni. A második — mező, amely alapján létrehozzuk a chunk_time_interval — az a chunkok időszaka, amelyet használni fogunk. Az én esetemben az időszak egy nap — 86 400.
A harmadik paraméter — adatmigrálás. Ha beállítod a igaz, akkor az összes aktuális adat átkerül az előre létrehozott chunkokba. Én magam használtam adatmigrálás. Kb. 1 TB volt, ami több mint egy órát vett igénybe. Egyes esetekben a tesztelés során eltávolítottam a tárolásra nem kötelező karaktertípusú történeti adatokat, hogy ne kelljen átvinni őket.
Az utolsó lépés — UPDATE: az db_extension beállítása 'timescaledb', hogy az adatbázis tudja, hogy van ez a kiterjesztés. A Zabbix aktiválja ezt, és helyesen használja a szintaxist és a lekérdezéseket az adatbázisra — ezek azok a funkciók, amelyek szükségesek a TimescaleDB-hez.A hardver konfigurálása
Két szervert használtam. Az első —
VMware gép . Ez elég kicsi: 20 Intel® Xeon® CPU E5-2630 v4 @ 2.20GHz processzor, 16 GB RAM és 200 GB SSD meghajtó.Ezen telepítettem a PostgreSQL 10.8-t Debian 10.8-1.pgdg90+1 operációs rendszerrel és xfs fájlrendszert. Minden minimálisan beállítottam, hogy ez a konkrét adatbázis legyen használva, kivéve azt, amit a Zabbix saját magának fog használni.
Ugyanezen a gépen futott a Zabbix szerver, a PostgreSQL és
a terhelésminták . Összesen 50 aktív ügynököm volt, akik aLoadableModule , hogy nagyon gyorsan különböző eredményeket generáljanak: számokat, sztringeket. Nagy mennyiségű adatot töltöttem fel az adatbázisba.Eredetileg a konfiguráció tartalmazta
5 000 adatpontot minden hoszton. Szinte minden elem tartalmazott egy triggert, hogy hasonlítson a valós telepítésekhez. Néhány esetben több mint egy trigger is volt. Egy hálózati csomópont számára 3 000-7 000 triggert használunk. Az adatelemek frissítési időköze —.
4-7 másodperc. 4-7 másodpercA terhelést úgy szabályoztam, hogy nemcsak 50 ügynököt használtam, hanem még többet is hozzáadtam. Az adatok dinamikus elemeivel szabályoztam a terhelést, és az frissítési intervallumot 4 másodpercre csökkentettem.
PostgreSQL. 35 000 nvps
Az első indítás ezen a hardveren tiszta PostgreSQL-lel zajlott — 35 ezer érték másodpercenként. Mint látható, az adatok beszúrása másodpercek töredékét vesz igénybe — minden jól és gyorsan működik. Az egyetlen probléma, hogy a 200 GB-os SSD meghajtó gyorsan megtelik.
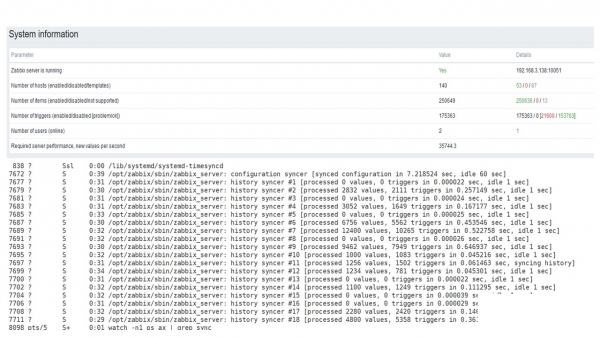
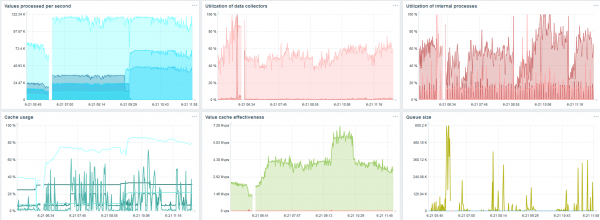
Ez a Zabbix teljesítménymérő standard műszerfala — a szerverek.
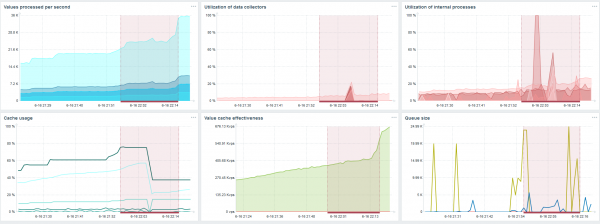
Az első kék grafikon — az értékek száma másodpercenként. A jobb oldali második grafikon — a gyűjtő folyamatok terhelése. A harmadik grafikon — a belső gyűjtési folyamatok terhelése: history syncerek és Housekeeper, amely itt elegendő ideig futott.
A negyedik grafikon a HistoryCache használatát mutatja. Ez lényegében egy puffert jelent az adatbázisba való szúrás előtt. Az ötödik zöld grafikon a ValueCache használatát mutatja, azaz hogy hány találat van a ValueCache-ben a triggereknél — ez néhány ezer érték másodpercenként.
PostgreSQL. 50 000 nvps
Ezután 50 ezer érték másodpercenkénti terhelésre növeltem ezt a hardvert.
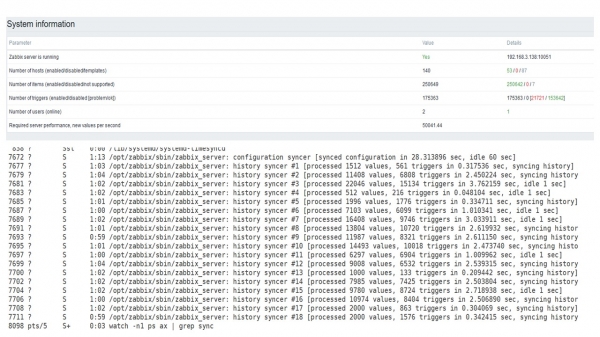
Housekeeper betöltésénél 10 ezer érték beszúrása 2-3 másodpercet vett igénybe.
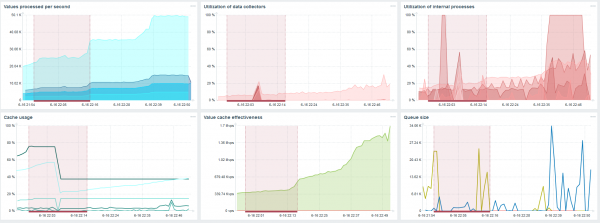
A Housekeeper már elkezdett hátráltatni a munkában.
A harmadik grafikonból látszik, hogy általában a trapper-ek és history syncerek terhelése még mindig 60% körül van. A negyedik grafikonon a HistoryCache már elkezdett aktívan feltöltődni a Housekeeper működése alatt. Az 20%-ra töltődött fel — ez körülbelül 0,5 GB.
PostgreSQL. 80 000 nvps
Ezután a terhelést 80 ezer érték másodpercenkéntire növeltem. Ez körülbelül 400 ezer adatot és 280 ezer trigert jelent.
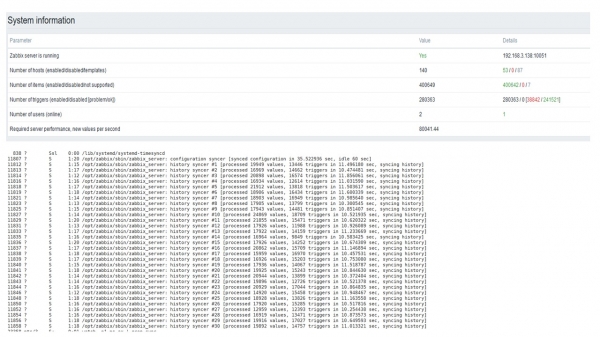
A harminc history syncer betöltésénél a beszúrás már eléggé magas.
Ezenkívül különböző paramétereket is növeltem: history syncerek, cache-ek.
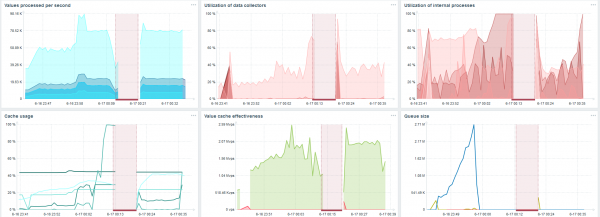
A hardveremen a history syncerek terhelése a maximumra nőtt. A HistoryCache gyorsan feltöltődött adatokkal — a pufferen feldolgozásra váró adatok gyűltek össze.
Ez idő alatt figyeltem, hogyan használják a processzort, a RAM-ot és a rendszer egyéb paramétereit, és felfedeztem, hogy a lemezhasználat maximális volt.
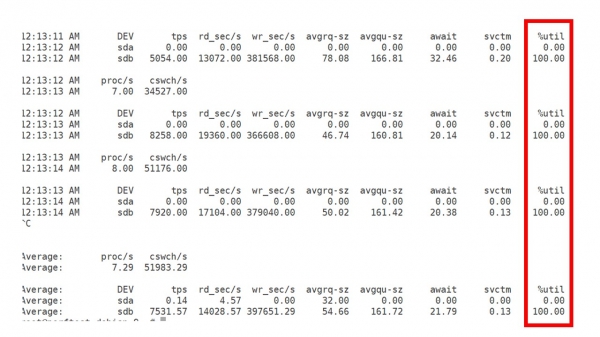
Elértem a lemez maximális kihasználtságát ezen a hardveren és ezen a virtuális gépen. Ilyen intenzitás mellett a PostgreSQL már aktívan kezdte eldobni az adatokat, és a lemez már nem tudta elvégezni az írást és az olvasást.
Második szerver
Kérek egy másik szervert, amely már 48 processzort és 128 GB RAM-ot tartalmazott. Finomítottam rajta – telepítettem 60 history syncert, és elértem egy megfelelő teljesítményt.
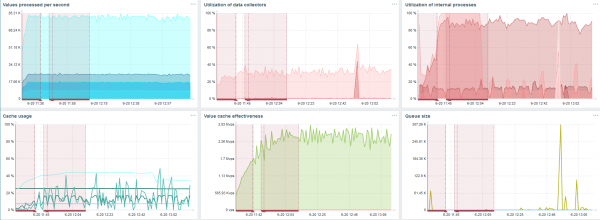
Valójában ez már a teljesítmény határa, ahol cselekedni kell.
TimescaleDB. 80 000 nvps
A fő feladatom az volt, hogy ellenőrizzem a TimescaleDB képességeit a Zabbix terhelésén. 80 ezer érték másodpercenként – ez sok, a metrikák gyűjtési gyakoriságával (Yandexen kívül, természetesen) és egy elég nagy „setup”-pal.
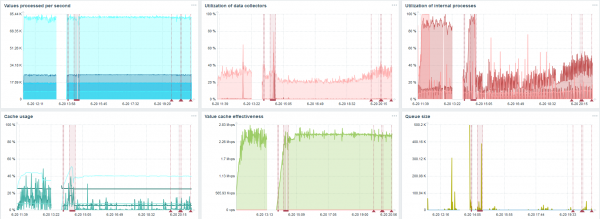
Minden grafikonon van egy görbe – ez éppen az adatok migrációja. A Zabbix szerveren történt görbéket követően a history syncer terhelési profilja drámaian megváltozott – háromszorosára csökkent.
A TimescaleDB lehetővé teszi, hogy az adatokat gyakorlatilag háromszor gyorsabban illesszük be, és kevesebb HistoryCache-t használjunk.
Ennek megfelelően az adatok időben érkeznek.
TimescaleDB. 120 000 nvps
Ezután az adatelemek számát 500 ezerre növeltem. A fő feladat az volt, hogy ellenőrizzem a TimescaleDB képességeit – a becsült érték 125 ezer érték másodpercenként.
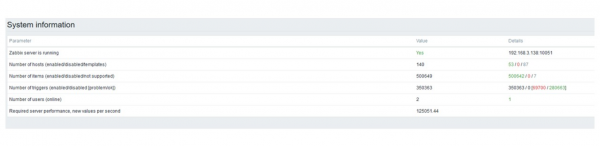
Ez egy működő „setup”, amely sokáig működhet. De mivel a diskem csak 1,5 TB-os volt, pár nap alatt megtöltöttem.
A legfontosabb, hogy ekkor új TimescaleDB partíciók is létrejöttek.
Teljesítmény szempontjából ez teljesen észrevétlen. Amikor a MySQL-ben például partíciókat hoznak létre, minden másképp zajlik. Általában éjszaka történik, mert blokkolja a közös beszúrást, a táblákkal való munkát, és szolgáltatásromlást okozhat. A TimescaleDB esetében erre nincs példa.
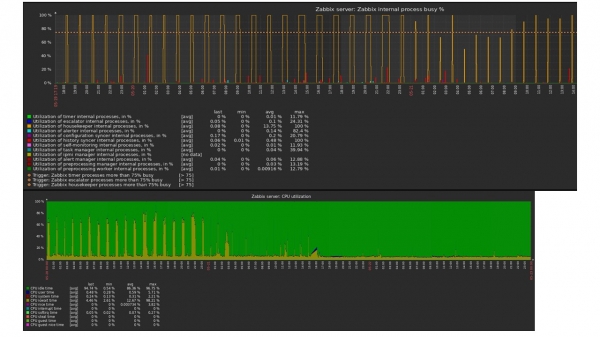
Például mutatok egy grafikont a közösség számos grafikonjából. A képen a TimescaleDB be van kapcsolva, ennek köszönhetően a processzor io.weight kihasználása csökkent. A belső folyamatok elemeinek használata is csökkent. Ráadásul ez egy szokásos virtuális gép szokványos plasztikus lemezein, nem SSD-n.
Következtetések
A TimescaleDB jó megoldás a kis „setup”-ok számára, amelyek a lemez teljesítményébe ütköznek. Ez lehetővé teszi, hogy jól működjenek, amíg az adatbázist gyorsabb hardverre nem migrálják.
A TimescaleDB egyszerűen beállítható, teljesítménynövekedést ad, jól működik a Zabbix-szal és előnyökkel bír a PostgreSQL-lel szemben..
Ha PostgreSQL-t használ, és nem tervezi a váltást, akkor javaslom, hogy a PostgreSQL-t használja a TimescaleDB kiterjesztésével Zabbix-szal együtt.Ez a megoldás hatékonyan működik közepes „setup”-okig.
Ha „magas teljesítményt” mondunk – ezt értjük alatta. . Nincs sok hátra, hogy megismerjük azokat a technológiákat és gyakorlatokat, amelyek lehetővé teszik a szolgáltatások számára, hogy milliárdnyi felhasználót szolgáljanak ki. Lista november 7-re és 8-ra már összeállítottuk, de még mindig lehet javasolni.
Iratkozzon fel a és , amelyeken bemutatjuk a közelgő konferencia különlegességeit, és megtudhatja, hogyan hozhatja ki a legtöbbet belőle.
Forrás: habr.com
