

A VictoriaMetrics, TimescaleDB és InfluxDB összehasonlítása történt egy milliárd adatpontból álló adathalmazon, 40K egyedi időbeli sorhoz tartozóan.
Néhány éve a Zabbix volt a középpontban. Minden bare metal szervernek nem volt több néhány mutatónál – processzorhasználat, memóriahasználat, lemezhasználat és hálózati használat. Így ezer szerver metrikái elfértek 40 ezer egyedi időbeli sorban, és a Zabbix MySQL-t használhat a időbeli sorok adatainak háttértáraként 🙂
Jelenleg egy alapértelmezett beállításokkal több mint 500 metrikát biztosít egy átlagos hoszton. Számos létezik különböző adatbázisokhoz, webszerverekhez, hardveres rendszerekhez stb. Mindegyikük sok hasznos mutatót kínál. Mind kezdi kitenni a maga mutatóit. Létezik Kubernetes klaszterekkel és pod-okkal, amelyek rengeteg metrikát felfednek. Ez ahhoz vezet, hogy a szerverek ezer egyedi metrikát mutatnak ki egy hoston. Így a 40K egyedi időbeli sor már nem számít magas teljesítménynek. A mainstream része lesz, amelyet bármely modern TSDB-nek könnyen kezelnie kell egy szerveren.
Mi számít nagynak az egyedi időbeli sorok számára manapság? Valószínűleg 400K vagy 4M? Esetleg 40M? Nézzük meg a modern TSDB-ket ezekkel a számokkal.
A benchmark beállítása
– egy nagyszerű benchmark eszköz a TSDB-k számára. Lehetővé teszi tetszőleges számú metrika generálását a szükséges időbeli sorok számának megadásával, amelyet 10-re osztanak – a flag (korábban -scale-var). A 10 az a száma a méréseknek (metrikáknak), amelyeket minden hoszton, szerveren generálunk. A következő adathalmazokat a TSBS segítségével készítettük a benchmarkhoz:
- 400K egyedi időbeli sor, 60 másodperc adatpontok közötti intervallum, az adatok teljes 3 napot fednek le, ~1.7B összes adatpont.
- 4M egyedi időbeli sor, 600 másodperces intervallum, az adatok teljes 3 napot fednek le, ~1.7B összes adatpont.
- 40M egyedi időbeli sor, 1 órás intervallum, az adatok teljes 3 napot fednek le, ~2.8 B összes adatpont.
Az ügyfél és a szerver dedikált példányokon futott a Google felhőben. Ezek a példányok a következő konfigurációkkal rendelkeztek:
- vCPUs: 16
- RAM: 60 GB
- Tárolás: egy 1 TB kapacitású hagyományos merevlemez. 120 MB/s olvasási/írási sávszélességet biztosít, 750 olvasási műveletet másodpercenként és 1,5K írási műveletet másodpercenként.
A TSDB-k hivatalos docker képekből lettek kinyerve és a dockeren a következő konfigurációkkal futottak:
VictoriaMetrics:
docker run -it --rm -v /mnt/disks/storage/vmetrics-data:/victoria-metrics-data -p 8080:8080 valyala/victoria-metricsInfluxDB értékek (- e szükséges a magas teljesítmény támogatásához. Részletek a ):
docker run -it --rm -p 8086:8086
-e INFLUXDB_DATA_MAX_VALUES_PER_TAG=4000000
-e INFLUXDB_DATA_CACHE_MAX_MEMORY_SIZE=100g
-e INFLUXDB_DATA_MAX_SERIES_PER_DATABASE=0
-v /mnt/disks/storage/influx-data:/var/lib/influxdb influxdb
TimescaleDB (a konfiguráció a fájlból származik):
MEM=`free -m | grep "Mem" | awk '{print $7}'`
let "SHARED=$MEM/4"
let "CACHE=2*$MEM/3"
let "WORK=($MEM-$SHARED)/30"
let "MAINT=$MEM/16"
let "WAL=$MEM/16"
docker run -it --rm -p 5432:5432
--shm-size=${SHARED}MB
-v /mnt/disks/storage/timescaledb-data:/var/lib/postgresql/data
timescale/timescaledb:latest-pg10 postgres
-cmax_wal_size=${WAL}MB
-clog_line_prefix="%m [%p]: [%x] %u@%d"
-clogging_collector=off
-csynchronous_commit=off
-cshared_buffers=${SHARED}MB
-ceffective_cache_size=${CACHE}MB
-cwork_mem=${WORK}MB
-cmaintenance_work_mem=${MAINT}MB
-cmax_files_per_process=100
Az adatok betöltője 16 párhuzamos szálon futott.
Ez a cikk csak a beszúrási teljesítménymutatók eredményeit tartalmazza. A mintavételi benchmark eredményei külön cikkben lesznek publikálva.
400K egyedi időbeli sorok
Kezdjük az egyszerű elemekkel — 400K. A benchmark eredményei:
- VictoriaMetrics: 2,6M adatpont másodpercenként; memóriahasználat: 3 GB; végső adatméret a lemezen: 965 MB
- InfluxDB: 1.2M adatpont másodpercenként; memóriahasználat: 8.5 GB; végső adatméret a lemezen: 1.6 GB
- Timescale: 849K adatpont másodpercenként; memóriahasználat: 2,5 GB; végső adatméret a lemezen: 50 GB
Ahogy az előbbiekből látható, a VictoriaMetrics a beszúrási teljesítményben és a tömörítési fokban nyer. A Timescale a memóriahasználatban nyer, de sok lemezterületet igényel — 29 byte adatpontonként.
Az alábbiakban bemutatjuk a CPU (processzor) kihasználtság grafikonját minden TSDB számára a benchmark során:
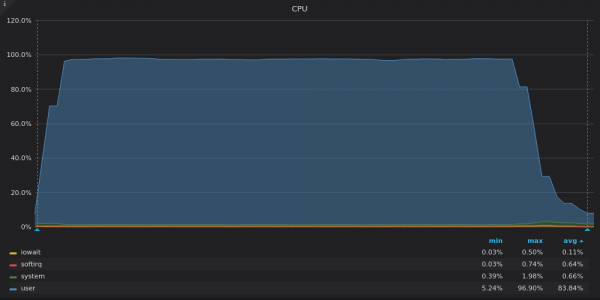
Fent látható képernyőfelvétel: VictoriaMetrics — CPU terhelhetősége a 400K egyedi metrikák beszúrási tesztjén.
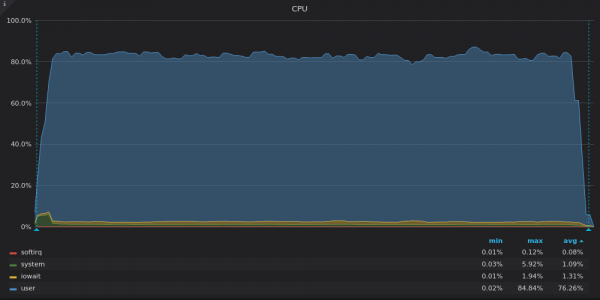
Fent látható képernyőfelvétel: InfluxDB — CPU terhelhetősége a 400K egyedi metrikák beszúrási tesztjén.
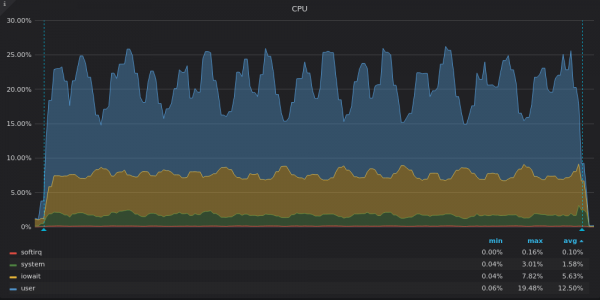
A fenti képernyőkép: TimescaleDB - CPU terhelés a 400K egyedi metrikát tartalmazó beszúrási teszt során.
A VictoriaMetrics az összes rendelkezésre álló vCPU-t kihasználja, míg az InfluxDB ~2 a 16 vCPU-ból.
A Timescale csak 3-4 a 16 vCPU-ból. A TimescaleDB időkezelési grafikonján megjelenő magas iowait és system arányok I/O alrendszeri szűk keresztmetszetre utalnak. Nézzük meg a lemezhasználati grafikonokat:
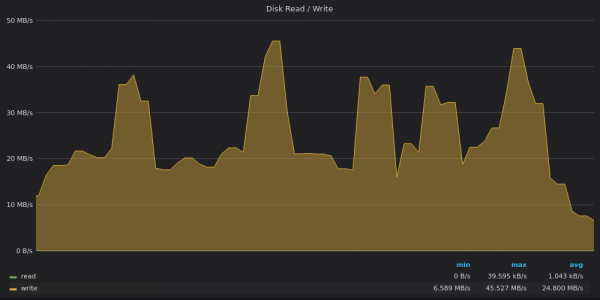
A fenti képernyőkép: VictoriaMetrics - Lemezhasználat a 400K egyedi metrikát tartalmazó beszúrási teszt során.
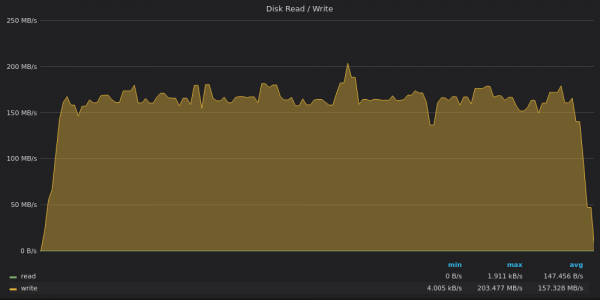
A fenti képernyőkép: InfluxDB - Lemezhasználat a 400K egyedi metrikát tartalmazó beszúrási teszt során.
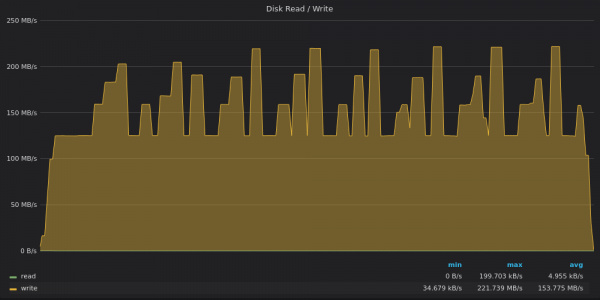
A fenti képernyőkép: TimescaleDB - Lemezhasználat a 400K egyedi metrikát tartalmazó beszúrási teszt során.
A VictoriaMetrics 20 Mbit/s sebességgel rögzíti az adatokat, amely csúcsokban 45 Mbit/s-ra emelkedik. A csúcsok a nagyobb részleges egyesítéseknek felelnek meg a fában. .
Az InfluxDB 160 MB/s sebességgel rögzíti az adatokat, míg az 1 TB-os lemez a 120 MB/s írási sebességgel.
A TimescaleDB írási sebessége 120 Mbit/s-ra van korlátozva, de néha átlépi ezt a határt és eléri a 220 Mbit/s csúcsértékeket. Ezek a csúcsok a korábbi grafikonon a nem elegendő CPU terheléshez kapcsolódó mélypontoknak felelnek meg.
Nézzük meg az I/O (be- és kimeneti) használati grafikonokat:
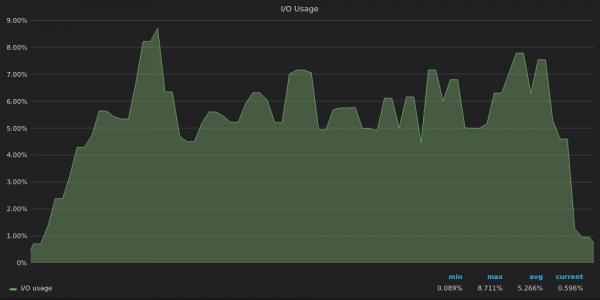
A fenti képernyőkép: VictoriaMetrics - I/O használat a 400K egyedi metrikát tartalmazó beszúrási teszt során.
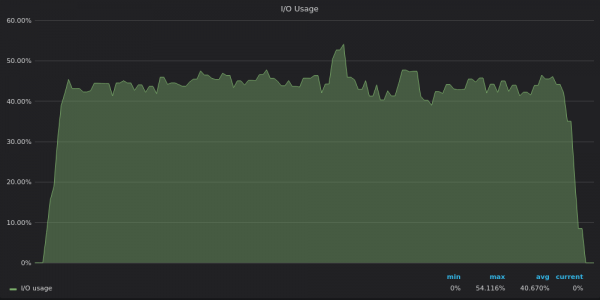
A fenti képernyőkép: InfluxDB - I/O használat a 400K egyedi metrikát tartalmazó beszúrási teszt során.
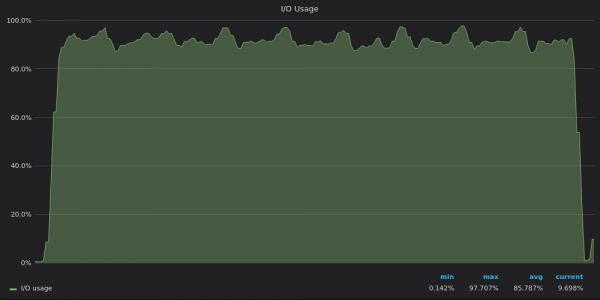
A fenti képernyőkép: TimescaleDB - I/O használat a 400K egyedi metrikát tartalmazó beszúrási teszt során.
Most már világos, hogy a TimescaleDB eléri az I/O határt, ezért nem tudja kihasználni a fennmaradó 12 vCPU-t.
4M egyedi idősort
A 4M időszak kissé kihívónak tűnik. De a versenytársaink sikeresen teljesítik ezt a vizsgát. A benchmark eredmények:
- VictoriaMetrics: 2,2M adatpont másodpercenként; memóriahasználat: 6 GB; a végső adatmennyiség a lemezen: 3 GB.
- InfluxDB: 330K adatpont másodpercenként; memóriahasználat: 20,5 GB; a végső adatmennyiség a lemezen: 18,4 GB.
- TimescaleDB: 480 ezer adatpont másodpercenként; memóriahasználat: 2,5 GB; végső adatmennyiség lemezen: 52 GB.
Az InfluxDB teljesítménye 1,2 millió adatpontról másodpercenként 400K idősortól 330 ezer adatpontra csökkent 4M idősortól. Ez jelentős teljesítménycsökkenés más versenytársakhoz képest. Nézzük meg a CPU használati grafikonokat, hogy megértsük ennek az esésnek az okát:
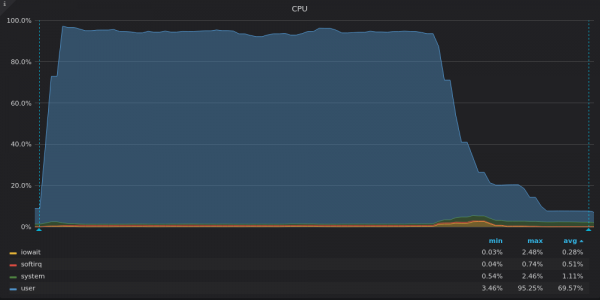
Fent látható képernyőfelvétel: VictoriaMetrics — CPU használat beszúrási teszten 4M egyedi idősort használva.
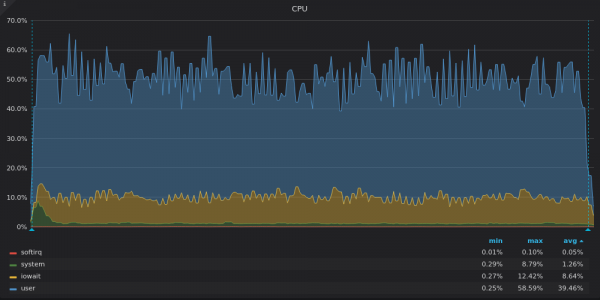
Fent látható képernyőfelvétel: InfluxDB — CPU használat beszúrási teszten 4M egyedi idősort használva.
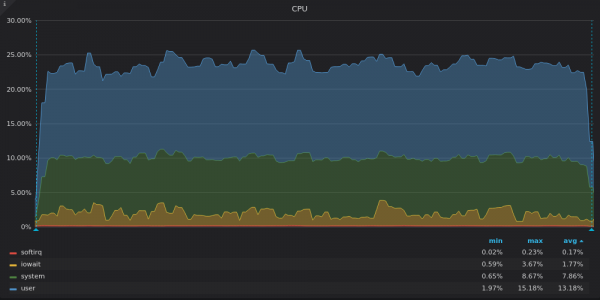
Fent látható képernyőfelvétel: TimescaleDB — CPU használat beszúrási teszten 4M egyedi idősort használva.
A VictoriaMetrics szinte az összes CPU teljesítményt kihasználja. A végén tapasztalható csökkenés a fennmaradó LSM egyesítések miatt van, miután az összes adatot beszúrták.
Az InfluxDB csak a 16 vCPU-ból 8-at használ, míg a TimescaleDB 4 vCPU-t használ. Mi a közös a grafikonjaikban? Magas iowait arány iowait, ami ismét a bemeneti/kimeneti szűk keresztmetszetre utal.
A TimescaleDB magas iowait arányt mutat. system. Feltételezzük, hogy a magas teljesítmény sok rendszerhívást vagy számos .
vizsgáljunk meg néhány lemezkapacitás grafikonját:
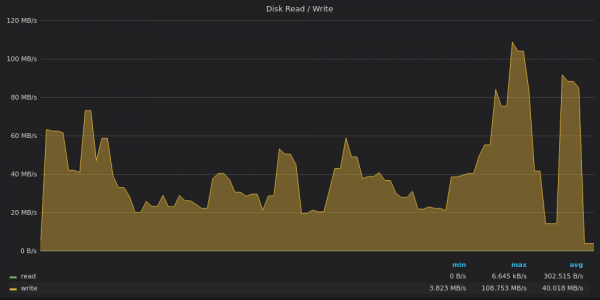
Fent látható képernyőfelvétel: VictoriaMetrics — A lemez sávszélessége 4M egyedi metricák beszúrásához.
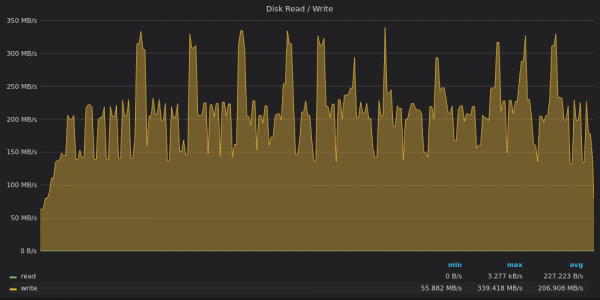
Fent látható képernyőfelvétel: InfluxDB — A lemez sávszélessége 4M egyedi metricák beszúrásához.
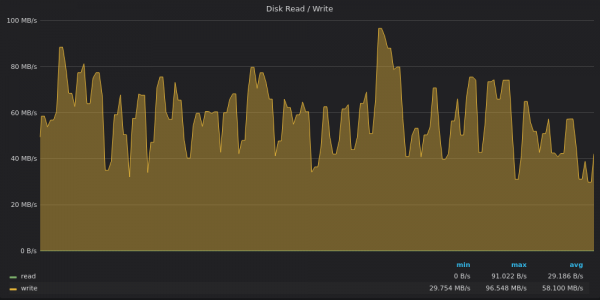
Fent látható képernyőfelvétel: TimescaleDB — A lemez sávszélessége 4M egyedi metricák beszúrásához.
A VictoriaMetrics 120 MB/s-es csúcsot ért el, míg az átlagos írási sebesség 40 MB/s volt. Valószínűleg a csúcsidőszak alatt több nehéz LSM egyesítés történt.
Az InfluxDB újra 200 MB/s-os átlagos írási sebességet hoz ki, a csúcs értékek 340 MB/s-ra emelkednek a 120 MB/s-os írási korlátnál 🙂
A TimescaleDB már nem korlátozódik a lemezre. Úgy tűnik, hogy valami más, a magas iowait arányhoz kapcsolódik. rendszer CPU terhelést.
Nézzük meg az IO használati grafikont:
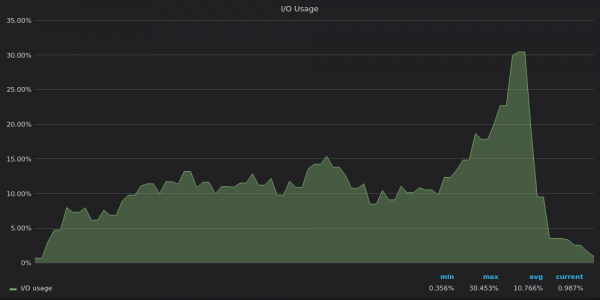
Fent látható képernyőfelvétel: VictoriaMetrics — IO használat beszúrási teszten 4M egyedi idősort használva.
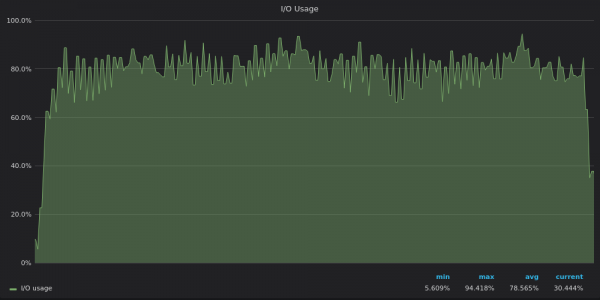
Fent látható képernyőfelvétel: InfluxDB — IO használat beszúrási teszten 4M egyedi idősort használva.
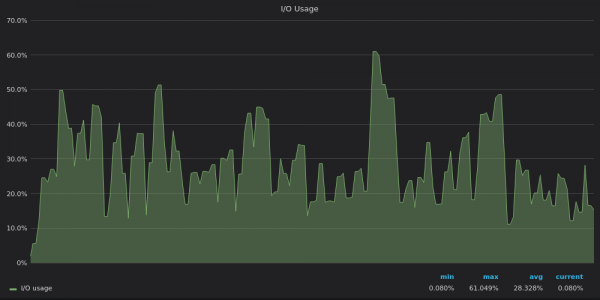
A fenti képernyőkép: TimescaleDB - IO kihasználás a 4M egyedi idősor beillesztési tesztje alatt.
Az IO használati grafikonok megegyeznek a lemezszélesség-grafikonokkal - az InfluxDB IO-besorolású, míg a VictoriaMetrics és a TimescaleDB tartalék IO erőforrásokkal rendelkezik.
40M egyedi idősor
A 40M egyedi idősor túl nagy volt az InfluxDB számára 🙁
A benchmark eredmények:
- VictoriaMetrics: 1,7M adatpont másodpercenként; memóriahasználat: 29 GB; lemezhasználat: 17 GB.
- InfluxDB: nem fejeződött be, mert 60 GB memóriára volt szüksége.
- TimescaleDB: 330K adatpont másodpercenként, memóriahasználat: 2,5 GB; lemezhasználat: 84GB.
A TimescaleDB kiemelkedően alacsony és stabil memóriahasználatot mutat - 2,5 GB - ami pontosan annyi, mint a 4M és 400K egyedi metrika esetén.
A VictoriaMetrics folyamatosan, 100 ezer adatpont sebességgel növekedett, amíg az összes 40M metrikus név és címke feldolgozása be nem fejeződött. Ezt követően elérte a tartós beillesztési sebességet, ami 1,5-2,0M adatpont másodpercenként, így a végső eredmény 1,7M adatpont másodpercenként volt.
A 40M egyedi idősor grafikonjai hasonlóak a 4M egyedi idősor grafikonjaihoz, így ezeket átugorhatjuk.
Következtetések
- A modern TSDB-k képesek kezelni a beillesztéseket több millió egyedi idősorra egyetlen szerveren. A következő cikkben megvizsgáljuk, mennyire jól teljesítenek a TSDB-k a millió egyedi idősorra vonatkozó lekérdezések esetén.
- A CPU alacsony kihasználtsága általában IO szűk keresztmetszetet jelez. Ezenkívül ez utalhat túlzottan szigorú zárolásra is, ahol csak néhány szál futhat egy időben.
- Az IO szűk keresztmetszet valóban létezik, különösen az SSD nélküli tárolókban, mint például a felhőszolgáltatók virtualizált blokkszínei.
- A VictoriaMetrics a legjobb optimalizálást biztosít a lassú, alacsony IO-teljesítményű tárolók számára. Legjobb sebességet és legjobb tömörítési arányt biztosít.
Töltse le és próbálja ki a saját adataikon. A megfelelő statikus bináris fájl elérhető itt: .
További információ a VictoriaMetrics-ról olvasható itt .
Frissítés: közzétéve reprodukálható eredményekkel.
Frissítés#2: Olvassa el a .
Frissítés #3: !
Telegram csoport:
Forrás: habr.com
