

Helló, alkalmazások létrehozásával foglalkozom adatbázisok számára. — ez a Mail.ru Group által kifejlesztett platform, amely ötvözi a nagy teljesítményű adatbázist és egy Lua nyelvű alkalmazás szervert. A Tarantool alapú megoldások magas feldolgozási sebességét részben az in-memory adatbázis üzemmód támogatása és az alkalmazás üzleti logikájának egyetlen címzett térben a adatokkal való végrehajtása biztosítja. Ekkor az adatkezelés tartóssága ACID tranzakciók segítségével van biztosítva (a lemezen WAL napló készül). A Tarantool beépített támogatással rendelkezik a replikáció és a sharding terén. A 2.1-es verziótól kezdődően SQL nyelvű lekérdezéseket is támogat.
Érezd a teljesítményt! (…vagyis élvezd a teljesítményt)
Mindez a Tarantoolt vonzó platformmá teszi a nagy terhelésű alkalmazások létrehozásához, amelyek adatbázisokkal dolgoznak. Az ilyen alkalmazásokban gyakran felmerül az adatok replikálásának szükségessége.
Ahogy már említettük, a Tarantoolban beépített adatreplikáció található. Ennek a működése abban áll, hogy a replikákon a mester napló (WAL) összes tranzakcióját sorban végrehajtják. Ez a replikáció általában (a továbbiakban nevezzük ennek alacsony szintű) a rendszer megbízhatóságának biztosítására és/vagy a terhelés olvasás közötti elosztására a klaszter csomópontjai között történik.
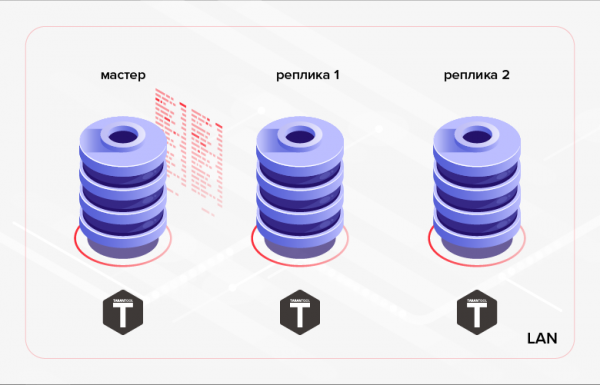
1. ábra. Replikáció a klaszteren belül
Alternatív forgatókönyv lehet a más adatbázisba való adatátvitel egyes BDból a feldolgozás/monitorozás érdekében. Az utóbbi esetben a magas szintű replikáció — az adat replikálása az alkalmazás üzleti logikáján keresztül. Tehát nem használunk előre elkészített megoldást, amely be van építve az adatbázisba, hanem magunk valósítjuk meg a replikációt az általunk fejlesztett alkalmazáson belül. Ennek a megközelítésnek előnyei és hátrányai is vannak. Soroljuk fel az előnyöket.
1. Adatforgalom megtakarítás:
- csak az adatok egy részét lehet továbbítani (például csak bizonyos táblázatokat, bizonyos oszlopok vagy bizonyos kritériumoknak megfelelő bejegyzések továbbítása).
- A magas szintű replikációt szekciókban lehet végrehajtani, ellentétben az alacsony szintű replikációval, amely folyamatosan, aszinkron (a jelenlegi Tarantool verzióban - 1.10 megvalósítva) vagy szinkron módon (a Tarantool következő verzióiban fog megvalósulni) történik; az alkalmazás először a adat szinkronizációját hajtja végre – adatcsere szekció, majd a replikációban szünet következik be, amely után következik a következő adatcsere szekció stb.
- Ha a rekord többször is megváltozott, csak az utolsó verziót lehet átadni (ellentétben az alacsony szintű replikációval, ahol a replikákon sorban lejátszásra kerülnek minden változtatás, amely a mesteroldalon történt).
2. Nincsenek bonyodalmak a HTTP-n történő csere megvalósításával, ami lehetővé teszi a távoli adatbázisok szinkronizálását.
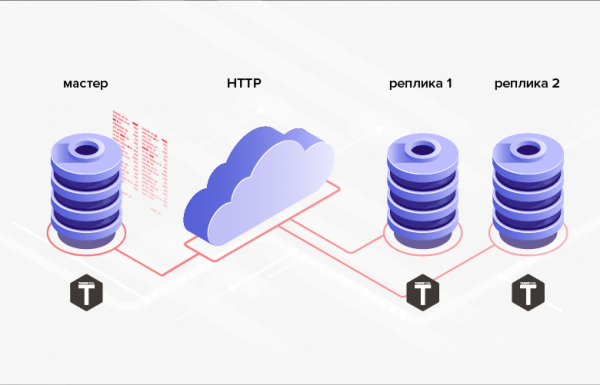
Ábra 2. HTTP-n történő replikáció
3. Az adatokat átadó adatbázisok struktúrái nem kötelesek azonosnak lenni (sőt, általában még különböző DBMS-ek, programozási nyelvek, platformok és így tovább használata is lehetséges).
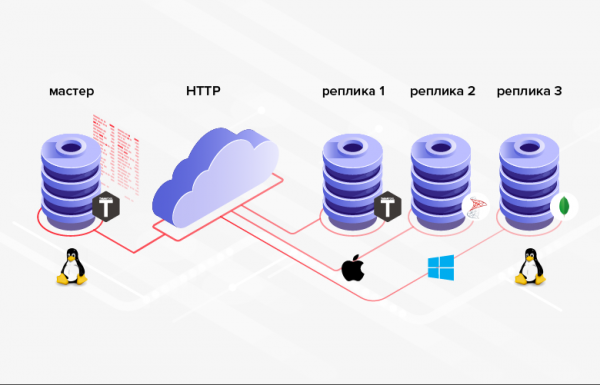
Ábra 3. Replikáció heterogén rendszerekben
A hátrány az, hogy átlagosan a programozás nehezebb / költségesebb, mint a konfigurálás, és a beépített funkciók beállítása helyett saját megoldását kell megvalósítani.
Ha az Ön esetében a fenti előnyök döntő fontosságúak (vagy szükséges feltétel), érdemes megfontolni a magas szintű replikáció használatát. Tekintsünk meg néhány módszert a Tarantool adatbázisban végzett magas szintű replikáció megvalósítására.
A forgalom minimalizálása
Tehát az egyik előnye a magas szintű replikációnak a forgalom megtakarítása. Ahhoz, hogy ez az előny teljes mértékben megmutatkozzon, minimalizálni kell az egyes adatcsere szekciók során átvitt adatok mennyiségét. Természetesen fontos figyelembe venni, hogy az adatcsere szekció végén az adatfogadónak szinkronban kell lennie a forrással (legalábbis az adat más részével, amely részt vesz a replikációban).
Hogyan lehet minimalizálni az alacsony szintű replikációnál átkonvertált adatok mennyiségét? A „tükrözött” megoldás lehet az adatválogatás időpont alapján. Ehhez használhatjuk a már meglévő táblázati dátum-idő mezőt (ha van). Például a „megrendelés” dokumentumnak lehet „megrendelés teljesítési idő” mezője — szállítási idő. A megoldás problémája abban rejlik, hogy ennek a mezőnek az értékei nem feltétlenül a rendelés létrehozásának sorrendjében helyezkednek el. Így nem tudjuk megjegyezni a mező maximális értékét szállítási idő, amely az előző adatcsere során került átadásra, és a következő adatcsere alkalmával az összes olyan rekordot ki tudjuk választani, amelyek mezőértéke magasabb szállítási idő. Az adatcsere között rekordok is kerülhettek hozzáadásra, amelyek alacsonyabb értékű mezővel rendelkeznek szállítási idő. Továbbá, a rendelés is módosulhatott, ami azonban nem érintette a mezőt szállítási idő. Mindkét esetben a változások nem lesznek átadva a forrástól a fogadóhoz. Ezeknek a problémáknak a megoldásához szükségünk lesz a "záró" adatátvitelre. Azaz, minden adatcsere alkalmával az összes olyan adatot át kell adnunk, amelynek értéke szállítási idő, meghaladja a múlt egy bizonyos pillanatát (például N órát a jelenlegi időponttól). Nyilvánvaló azonban, hogy a nagy rendszerek esetében ez a megközelítés erősen túlzott, és a forgalom megtakarítását, amire törekedünk, teljesen nullázhatja. Ezenkívül az átadott táblázatban lehet, hogy nincs a dátum/időhöz kapcsolódó mező.
Egy másik megoldás, amely megvalósítási szempontból bonyolultabb, az adatok átvételének megerősítése. Ebben az esetben minden adatcsere alkalmával minden olyan adat kerül átadásra, amelynek átvételét a fogadó nem erősítette meg. A megvalósításhoz be kell vezetni a forrás táblába egy logikai oszlopot (például, is_transferred). Ha a fogadó megerősíti a rekord átvételét, a megfelelő mező értéke igaz, után a rekord már nem vesz részt a cserékben. Ennek a megvalósítási módnak a következő hátrányai vannak. Először is, minden egyes átkonvertált rekordhoz generálni és küldeni kell egy megerősítést. Durván fogalmazva, ez az átadott adatok mennyiségének megduplázódásával és az oda-vissza kérések számának megduplázódásával járhat. Másodszor, nincs lehetőség arra, hogy ugyanazt a rekordot több fogadóhoz küldjük (az első fogadó, aki megkapja, megerősíti a fogadást saját nevében és az összes többinek).
A method free of the above-mentioned drawbacks consists of adding a column to the transmitted table for tracking changes in its rows. Such a column can have a datetime type and should be set/updated by the application to the current time every time records are added/changed (atomically with the addition/change). As an example, we will call this column update_time. By retaining the maximum value of this column's field for the transmitted records, we can start the next exchange session from that value (selecting records with a field value update_time, exceeding the previously saved value). The problem with this approach is that data changes can occur in batches. As a result, the values of the fields in the column update_time may not be unique. Thus, this column cannot be used for paginated data output. For paginated data output, additional mechanisms will have to be invented, which are likely to have very low efficiency (for example, retrieving all records from the database with a value update_time greater than the specified and outputting a specific number of records starting from some offset from the beginning of the selection).
We can increase the efficiency of data transmission by slightly improving the previous approach. For this, we will use an integer type (long integer) for the field values in the column for tracking changes. We will call this column row_ver. The field value of this column should still be set/updated each time a record is created/changed. But in this case, the field will be assigned not the current datetime, but the value of some counter, increased by one. As a result, the column row_ver will contain unique values and can be used not only for outputting the 'delta' of data (data that has been added/changed after the previous exchange session), but also for simple and efficient pagination of data.
The last proposed method of minimizing the amount of data transmitted within high-level replication seems to me the most optimal and universal. Let's elaborate on it in more detail.
Data transmission using a row version counter
A szerver/mester rész megvalósítása
Az MS SQL Serverben egy ilyen megközelítés megvalósításához létezik egy speciális oszloptípus — rowversion. Minden adatbázisnak van egy számlálója, amely minden alkalommal növekszik egy egységgel, amikor egy rekordot adunk hozzá vagy módosítunk egy olyan táblában, amely rendelkezik ilyen típusú oszloppal. rowversionEnnek a számlálónak az értékét automatikusan hozzárendelik ennek az oszlopnak a mezőjéhez az újonnan hozzáadott vagy módosított rekordban. A Tarantool adatbázis-kezelő nem rendelkezik hasonló beépített mechanizmussal. A Tarantoolban azonban ezt egyszerűen meg lehet valósítani kézzel. Nézzük meg, hogyan.
Kezdjük néhány terminológiával: a Tarantoolban a táblákat spásznak (space) nevezik, a rekordokat pedig tupláknak (tuple). A Tarantoolban szekvenciákat (sequence) is létrehozhatunk. A szekvenciák nem mások, mint névvel ellátott, rendezett egészértékek generátorai. Ez pontosan az, amire szükségünk van a céljainkhoz. Az alábbiakban létrehozunk egy ilyen szekvenciát.
Mielőtt bármilyen műveletet végeznénk az adatbázissal a Tarantoolban, futtatni kell a következő parancsot:
box.cfg{}Ennek eredményeként a Tarantool el kezd tárolni a jelenlegi könyvtárban adatbázis-mentéseket (snapshot) és tranzakciós naplókat.
Hozzuk létre a szekvenciát row_version:
box.schema.sequence.create('row_version',
    { if_not_exists = true })
Opció if_not_exists lehetővé teszi a létrehozó szkript többszöri végrehajtását: ha a tárgy már létezik, a Tarantool nem próbálja meg újból létrehozni. Ezt az opciót az összes jövőbeli DDL-parancsban használni fogjuk.
Hozzuk létre a példához szükséges spászt.
box.schema.space.create('goods', {
    format = {
        {
            name = 'id',
            type = 'unsigned'

        },
        {
            name = 'name',
            type = 'string'

        },
        {
            name = 'code',
            type = 'unsigned'

        },
        {
            name = 'row_ver',
            type = 'unsigned'

        }
    },
    if_not_exists = true
})
Itt megadtuk a spász nevét (goods), a mezők neveit és típusait.
Az auto-increment mezőket a Tarantoolban is szekvenciák segítségével hozzák létre. Hozzunk létre egy auto-increment elsődleges kulcsot a "id" mezőhöz id:
box.schema.sequence.create('goods_id',
    { if_not_exists = true })
box.space.goods:create_index('primary', {
    parts = { 'id' },
    sequence = 'goods_id',
    unique = true,
    type = 'HASH',
    if_not_exists = true
})
A Tarantool több index típust támogat. Leggyakrabban a TREE és HASH típusú indexeket használják, amelyek az elnevezésüknek megfelelő struktúrákra épülnek. A TREE a leguniverzálisabb index típus. Ez lehetővé teszi az adatok rendezett formában történő lekérdezését. Azonban egyenlőség alapján történő kereséshez a HASH típus jobban illik. Ennek megfelelően az elsődleges kulcs esetén érdemes HASH-t használni (amiért mi is ezt választottuk).
A mező használatához row_ver az átalakított adatok átadásához az ezen mezőhöz tartozó oszlopokhoz összekapcsolni kell a sorozat értékeit row_ver. De ellentétben az elsődleges kulccsal az oszlopmező értékének row_ver egyesével kell növekednie, nemcsak új rekordok hozzáadásakor, hanem meglévők módosításakor is. Ehhez triggerek használhatók. A Tarantool-ban két típusú trigger található a spaces-ekhez: before_replace és on_replace. A triggerek minden adatmódosításkor elindulnak a space-ben (minden érintett tuple esetében a trigger funkció elindul). A -triggerek lehetővé teszik a tuple adatainek módosítását, amelyhez a trigger alkalmazásra kerül. Ennek megfelelően a számunkra az utolsó típusa a triggereknek megfelelő. on_replace, before_replacebox.space.goods:before_replace(function(old, new)\n return box.tuple.new({new[1], new[2], new[3],\n box.sequence.row_version:next()})\nend)
Ez a trigger felváltja a mező értékét a tárolt tuple esetében a sorozat következő értékével row_ver Ahhoz, hogy adatokat lehessen lekérdezni a space-ből row_version.
az oszlop alapján goods , indexet hozunk létre: row_verbox.space.goods:create_index('row_ver', {\n parts = { 'row_ver' },\n unique = true,\n type = 'TREE',\n if_not_exists = true\n})
Az index típusa fa ( TREE), mivel az adatokat növekvő sorrendben szeretnénk kinyerni az oszlopban.Néhány adatot adunk hozzá a space-hez: row_ver.
box.space.goods:insert{nil, 'toll', 123}\nbox.space.goods:insert{nil, 'ceruza', 321}\nbox.space.goods:insert{nil, 'ecset', 100}\nbox.space.goods:insert{nil, 'vízfesték', 456}\nbox.space.goods:insert{nil, 'album', 101}\nbox.space.goods:insert{nil, 'notesz', 800}\nbox.space.goods:insert{nil, 'radír', 531}\nbox.space.goods:insert{nil, 'vonalzó', 135}
Mivel az első mező egy automatikus növekményző, helyette nil-t adunk át. A Tarantool automatikusan megadja a következő értéket. Hasonló módon a mező értékének megadásakor nil-at is adhatunk meg — vagy akár értéket sem kell megadni, mivel ez a mező a space utolsó pozícióját foglalja el. row_ver Ellenőrizzük a beszúrási eredményt:
Nézzük meg a beillesztés eredményét:
tarantool> box.space.goods:select()
---
- - [1, 'toll', 123, 1]
  - [2, 'ceruza', 321, 2]
  - [3, 'ecset', 100, 3]
  - [4, 'vízfesték', 456, 4]
  - [5, 'album', 101, 5]
  - [6, 'füzet', 800, 6]
  - [7, 'radír', 531, 7]
  - [8, 'vonalzó', 135, 8]
...
Ahogy látjuk, az első és az utolsó mező automatikusan kitöltődött. Most már könnyű lesz egy funkciót írni a lapozott adatkihozatalhoz. goods:
local page_size = 5
local function get_goods(row_ver)
    local index = box.space.goods.index.row_ver
    local goods = {}
    local counter = 0
    for _, tuple in index:pairs(row_ver, {
        iterator = 'GT' }) do
        local obj = tuple:tomap({ names_only = true })
        table.insert(goods, obj)
        counter = counter + 1
        if counter >= page_size then
            break
        end
    end
    return goods
end
A funkció paraméterként fogadja a változót row_ver, amitől kezdve a változások kihozatalát kell végrehajtani, és visszaadja a megváltozott adatok egy adagját.
A Tarantoolban az adatok lekérdezése indexeken keresztül történik. A funkció get_goods az indexen történő iterátort használja row_ver a megváltozott adatok lekérésére. Az iterátor típusa - GT (Nagyobb mint). Ez azt jelenti, hogy az iterátor sorozatosan bejárja az index értékeit a megadott kulcstól kezdve (mező értéke row_ver).
Az iterátor tuple-öket ad vissza. Ahhoz, hogy később HTTP-n keresztül tudjunk adatokat küldeni, az tuple-öket olyan struktúrává kell alakítani, ami kényelmes a sorosításhoz. A példában ehhez a szokásos tomapfunkciót használják. A tomap helyett saját funkciót is írhatunk. Például, átnevezhetjük a mezőt name, kihagyhatjuk a mezőt kód és hozzáadhatunk egy mezőt comment:
local function unflatten_goods(tuple)
    local obj = {}
    obj.id = tuple.id
    obj.goods_name = tuple.name
    obj.comment = 'valami megjegyzés'
    obj.row_ver = tuple.row_ver
    return obj
end
A kiadott adatok oldalának mérete (a rekordok száma egy adagban) a page_sizeváltozó határozza meg. A példában az érték page_size 5. A valós programban az oldal mérete általában nagyobb jelentőséggel bír. Ez a tér hosszmérésének átlagos méretétől függ. Az optimális oldalméretet kísérleti úton lehet megállapítani az adatátviteli idő mérésével. Minél nagyobb az oldal mérete, annál kevesebb körtúrára van szükség a küldő és a fogadó fél között. Így csökkenthető a változtatások összes átvitelének ideje. Ugyanakkor, ha túl nagy az oldal mérete, túl sokáig foglalhatjuk le a szervert a kiválasztás sorozatba állításával. Ennek következtében késések léphetnek fel más, a szerverre érkező kérések feldolgozásakor. A paraméter page_size betölthető a konfigurációs fájlból. Minden átadott térhez megadhatunk saját értéket. A többség számára azonban megfelelő lehet az alapértelmezett érték (például 100).
Végezzük el a funkciót get_goods:
tarantool> get_goods(0)

---
- - row_ver: 1
    code: 123
    name: toll
    id: 1
  - row_ver: 2
    code: 321
    name: ceruza
    id: 2
  - row_ver: 3
    code: 100
    name: ecset
    id: 3
  - row_ver: 4
    code: 456
    name: vízfesték
    id: 4
  - row_ver: 5
    code: 101
    name: album
    id: 5
...
Vegyük az utolsó sor mezőjének értékét, és hívjuk meg újra a funkciót: row_ver tarantool> get_goods(5)--- - - row_ver: 6 code: 800 name: jegyzetfüzet id: 6 - row_ver: 7 code: 531 name: radír id: 7 - row_ver: 8 code: 135 name: vonalzó id: 8 ...
És még egyszer:tarantool> get_goods(8) --- - [] ...
Ahogy látjuk, ilyen felhasználás mellett a funkció lapozva adja vissza az összes téradatot. Az utolsó oldal után üres kiválasztás következik. goodsVáltoztatásokat hajtunk végre a térben:
box.space.goods:update(4, {{'=', 6, 'füzet'}}) box.space.goods:insert{nil, 'klipsz', 234} box.space.goods:insert{nil, 'mappa', 432}
Megváltoztattuk a mező értékét egy rekord számára, és két új rekordot adtunk hozzá. name Ismételjük meg az utolsó hívást:
tarantool> get_goods(8) ---- - row_ver: 9 code: 800 name: füzet id: 6 - row_ver: 10 code: 234 name: klipsz id: 9 - row_ver: 11 code: 432 name: mappa id: 10 ...
A funkció visszaadta a megváltozott és az új rekordokat. Így a funkció lehetővé teszi az adatokat lekérni, amelyek a legutolsó hívás óta megváltoztak, ami az elemzett replikálási módszer alapja. get_goods A HTTP-n keresztüli JSON formátumban történő eredménykiadást nem tárgyaljuk a jelen cikk keretein belül. Erről itt olvashat:
A kliens/slave rész implementálása
Nézzük meg, hogyan néz ki a fogadó oldal implementációja. Hozzunk létre a fogadó oldalon egy teret a betöltött adatok tárolására:
Vizsgáljuk meg, hogyan néz ki a fogadószolgáltatás megvalósítása. Hozzunk létre egy teret a fogadó oldalon a feltöltött adatok tárolására:
box.schema.space.create('goods', {
    format = {
        {
            name = 'id',
            type = 'unsigned'

        },
        {
            name = 'name',
            type = 'string'

        },
        {
            name = 'code',
            type = 'unsigned'

        }
    },
    if_not_exists = true
})

box.space.goods:create_index('primary', {
    parts = { 'id' },
    sequence = 'goods_id',
    unique = true,
    type = 'HASH',
    if_not_exists = true
})
A tér a forrásban található térhez hasonló. De mivel nem tervezzük, hogy az így nyert adatokat máshova továbbítjuk, a row_ver cél térében nem található. A mezőben id forrásazonosítók fognak tárolódni. Ezért a fogadó oldalon nincs szükség arra, hogy azt automatikusan növekvővé tegyük.
Ezen kívül szükség lesz egy térre az értékek tárolásához. row_ver:
box.schema.space.create('row_ver', {
    format = {
        {
            name = 'space_name',
            type = 'string'

        },
        {
            name = 'value',
            type = 'string'

        }
    },
    if_not_exists = true
})

box.space.row_ver:create_index('primary', {
    parts = { 'space_name' },
    unique = true,
    type = 'HASH',
    if_not_exists = true
})
Minden feltöltött térhez (mező space_name) itt fogjuk tárolni az utoljára betöltött értéket row_ver (mező érték). Az elsődleges kulcs a space_name.
oszlop lesz. Hozzunk létre egy funkciót a tér adatainak HTTP-n való betöltéséhez. Ehhez szükség lesz egy könyvtárra, amely megvalósítja a HTTP-ügyfelet. A következő sor betölti a könyvtárat és létrehoz egy HTTP-ügyfél példányt: goods local http_client = require('http.client').new()
Ezen kívül szükség lesz egy könyvtárra a json deszerializálásához:local json = require('json')
Ez elegendő az adatbetöltő funkció létrehozásához:local function load_data(url, row_ver) local url = ('%s?rowVer=%s'):format(url, tostring(row_ver)) local body = nil local data = http_client:request('GET', url, body, { keepalive_idle = 1, keepalive_interval = 1 }) return json.decode(data.body) end
A funkció HTTP-kérést hajt végre az url címre, átadja benne paraméterként, és visszaadja a kérés deszerializált eredményét. row_ver A kapott adatok mentésének funkciója a következőképpen néz ki:
local function save_goods(goods) local n = #goods box.atomic(function() for i = 1, n do local obj = goods[i] box.space.goods:put( obj.id, obj.name, obj.code) end end) end
Az adatok térébe történő mentése ciklusban történik, melyet tranzakcióba helyezünk (ehhez a goods box.atomic ) funkciót használjuk a lemezműveletek számának csökkentésére.Végül a helyi tér és az forrással történő szinkronizálás funkciója így valósítható meg:
Először olvassuk be a korábban mentett értéket goods a tér számára.
local function sync_goods()
    local tuple = box.space.row_ver:get('goods')
    local row_ver = tuple and tuple.value or 0

    —— set your url here:
    local url = 'http://127.0.0.1:81/test/goods/list'

    while true do
        local goods = load_goods(url, row_ver)

        local count = #goods
        if count == 0 then
            return
        end

        save_goods(goods)

        row_ver = goods[count].rowVer
        box.space.row_ver:put({'goods', row_ver})
    end
end
Ha az hiányzik (az első csere), akkor azt vesszük mint row_ver a következő értéket. goods. Ha az nem létezik (első cserefolyamat), akkor azt vesszük alapul row_ver null. Ezután egy ciklusban oldalonként töltsük be a módosított adatokat a megadott url-ból. Minden iteráció során a kapott adatokat eltároljuk a megfelelő helyi space-be és frissítjük az értéket row_ver (a space-ben row_ver és a változóban row_ver) - vesszük az értéket row_ver a betöltött adatok utolsó sorából.
A véletlen ciklizálás elkerülése érdekében (a program hibája esetén) a ciklust while helyettesíthetjük a for:
for _ = 1, max_req do ... A függvény végrehajtása után sync_goods space goods a fogadóoldalon tartalmazni fogja a space összes tételének legfrissebb verzióját goods a forrásból.
Nyilvánvaló, hogy ezzel a módszerrel nem lehet adatokat törölni. Ha szükséges, használhatunk törlésre vonatkozó megjegyzést. A space-hez hozzáadjuk goods egy logikai mezőt is_deleted és a tényleges törlés helyett logikai törlést alkalmazunk - beállítjuk a mező értékét is_deleted az értékre igaz. Néha a logikai mező helyett is_deleted kényelmesebb használni egy mezőt, deletáltamelyben a tétel logikai törlésének dátum- és időpontja tárolódik. A logikai törlés végrehajtása után a törlésre kijelölt tétel a forrásból a fogadóba kerül (a fenti logika szerint).
A sorozat row_ver más spacet adatok átvitelére is használható: nem szükséges minden átadott space esetében külön sorozatot létrehozni.
Megvizsgáltuk a Tarantool DBMS-ben használt adatok magas szintű replikációjának hatékony módját.
Következtetések
- A Tarantool DBMS vonzó, ígéretes termék a nagy terhelésű alkalmazások létrehozásához.
- A magas szintű adatreplikációnak számos előnye van az alacsony szintű replikációval szemben.
- A cikkben tárgyalt magas szintű replikációs módszer minimalizálja az átvitt adatok mennyiségét azáltal, hogy csak azokat a tételeket továbbítja, amelyek a legutolsó csere után módosultak.
Forrás: habr.com
