

Az egyik tipikus forgatókönyv minden ismert alkalmazásban az adatok keresése meghatározott kritériumok alapján, és azok kényelmes olvasási formátumban történő megjelenítése. Itt további lehetőségek is lehetnek, mint például a rendezés, csoportosítás és a lapozás. A feladat alapvetően triviális, de sok fejlesztő sok hibát elkövet a megoldás során, amelyek később a teljesítményt rontják. Tekintsük át a feladat különböző megoldási lehetőségeit, és fogalmazzunk meg ajánlásokat a leghatékonyabb megvalósítás kiválasztásához.
Lapozási lehetőség #1
A legegyszerűbb lehetőség, ami eszünkbe jut - az a hibátlan, klasszikus formájú keresési eredmények lapozása.
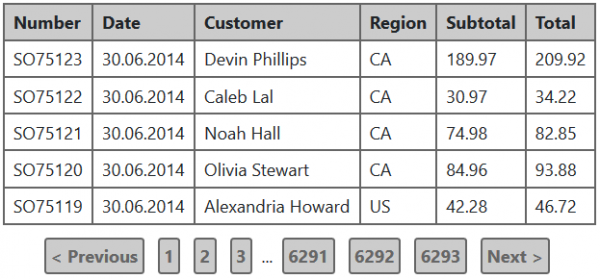
Tegyük fel, hogy az alkalmazás relációs adatbázist használ. Ebben az esetben a megfelelő formátumban történő információmegjelenítéshez két SQL lekérdezést kell végrehajtani:
- Az aktuális oldalhoz tartozó sorok lekérése.
- A keresési kritériumoknak megfelelő összes sor számának kiszámítása - ez szükséges az oldalak megjelenítéséhez.
Az első lekérdezést nézzük meg egy teszt MS SQL adatbázis példáján. a 2016-os kiszolgálón. Ehhez a Sales.SalesOrderHeader táblát fogjuk használni:
SELECT * FROM Sales.SalesOrderHeader
ORDER BY OrderDate DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
A fenti lekérdezés az utolsó 50 megrendelést jeleníti meg a hozzáadás dátuma szerint csökkenő sorrendben, más szavakkal - az utolsó 50 megrendelést.
Ez gyorsan végrehajtható a tesztadatbázison, de nézzük meg a végrehajtási tervet és a bemeneti-kimeneti statisztikát:
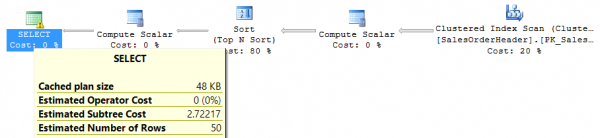
Tábla 'SalesOrderHeader'. Scan count 1, logikai olvasások 698, fizikai olvasások 0, előre olvasások 0, lob logikai olvasások 0, lob fizikai olvasások 0, lob előre olvasások 0.A bemeneti/kimeneti statisztika minden lekérdezéshez a SET STATISTICS IO ON parancs végrehajtásával érhető el a lekérdezési környezetben.
Ahogy a végrehajtási tervből látható, a leginkább erőforrás-igényes művelet a kiválasztott tábla összes sorának rendezése a hozzáadás dátuma szerint. A probléma az, hogy minél több sor jelenik meg a táblában, annál nehezebbé válik a rendezés. Az efféle helyzeteket a gyakorlatban érdemes elkerülni, így indexet adunk a hozzáadás dátumára, és megnézzük, változott-e az erőforrás-felhasználás:
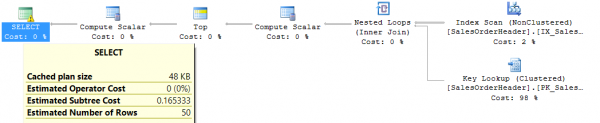
Tábla 'SalesOrderHeader'. Scan count 1, logikai olvasások 165, fizikai olvasások 0, előre olvasások 5, lob logikai olvasások 0, lob fizikai olvasások 0, lob előre olvasások 0.
Nyilvánvalóan sokkal jobb lett. De vajon minden probléma megoldódott? Módosítsuk a keresési lekérdezést, hogy a termékek összértéke meghaladja a 100 dollárt:
SELECT * FROM Sales.SalesOrderHeader
WHERE SubTotal > 100
ORDER BY OrderDate DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
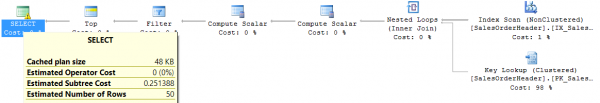
A 'SalesOrderHeader' tábla. Ellenőrzési szám 1, logikai olvasások 1081, fizikai olvasások 0, előreolvasások 0, lob logikai olvasások 0, lob fizikai olvasások 0, lob előreolvasások 0.Érdekes helyzet állt elő: a lekérdezés terve nem sokkal rosszabb, mint az előző, de a logikai olvasások száma majdnem duplája annak, mint ami a tábla teljes átvizsgálásakor volt. A megoldás az, hogy ha a már meglévő indexből összetett indexet készítünk, és második mezőként hozzáadjuk a termékek összárát, akkor újra 165 logikai olvasást kapunk:
CREATE INDEX IX_SalesOrderHeader_OrderDate_SubTotal on Sales.SalesOrderHeader(OrderDate, SubTotal);
Ezt a példasort még sokáig folytathatnánk, de két alapvető gondolatot szeretnék itt kifejezni:
- Bármely új kritérium vagy rendezési sorrend hozzáadása a keresési lekérdezéshez jelentősen befolyásolhatja annak végrehajtási sebességét.
- De ha csak az adatok egy részét szeretnénk kiolvasni, nem pedig az összes találatot, amely megfelel a keresési feltételeknek – rengeteg módja van az ilyen lekérdezés optimalizálásának.
Most térjünk át a második lekérdezésre, amelyet az elején említettünk – arra, amely azokat a rekordokat számolja, amelyek megfelelnek a keresési kritériumnak. Vegyük ugyanezt a példát – rendeléseket keresünk, amelyek 100 dollárnál drágábbak:
SELECT COUNT(1) FROM Sales.SalesOrderHeader
WHERE SubTotal > 100
A fent említett összetett index meglétében ezt kapjuk:
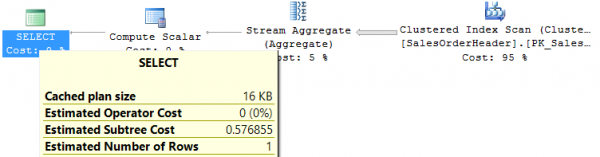
Tábla 'SalesOrderHeader'. Scan count 1, logikai olvasások 698, fizikai olvasások 0, előre olvasások 0, lob logikai olvasások 0, lob fizikai olvasások 0, lob előre olvasások 0.Az, hogy a lekérdezés az egész indexet átvizsgálja – nem meglepő, hiszen a SubTotal mező nem az első helyen áll, ezért a lekérdezés nem tudja azt kihasználni. A probléma úgy oldható meg, hogy újabb indexet készítünk a SubTotal mezőre, ami végül már csak 48 logikai olvasást eredményez.
További példákat is hozhatnánk a számoló lekérdezésekre, de a lényeg ugyanaz marad: az adatok lekérdezése és a teljes számolt mennyiség – ez két alapvetően különböző lekérdezés, és mindkettő saját optimalizálási intézkedéseket igényel. Általánosságban nem lesz lehetséges olyan indexkombinációt találni, amely mindkét lekérdezésnél ugyanúgy jól működik.
Ezért az egyik fontos követelmény, amit tisztázni kell egy ilyen keresési megoldás fejlesztése során, hogy valóban fontos-e a vállalkozás számára, hogy lássa a megtalált elemek összes számát. Gyakran nem. Szerintem a konkrét oldalszámokra történő navigáció nagyon szűk alkalmazási terület, mivel a legtöbb esetben a lapozás így néz ki: „ugorj a következő oldalra”.
Lapozás #2
Tegyük fel, hogy a felhasználóknak nem fontos ismerni a megtalált elemek összes számát. Próbáljuk meg egyszerűsíteni a keresési oldalt:
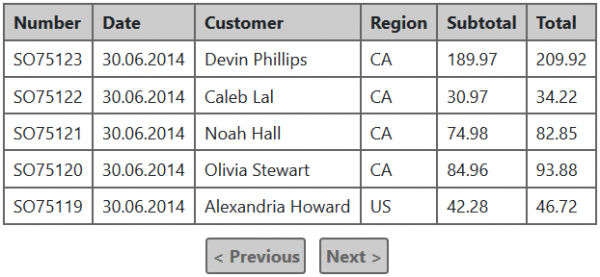
Valójában az egyetlen változás az, hogy nincs lehetőség a konkrét oldalszámokra történő ugrásra, és most ennek a táblázatnak nem kell tudnia, hány összesen lehet. De felmerül a kérdés - hogyan tudja a táblázat, hogy van-e adat a következő oldalra (hogy helyesen megjelenítse a „Következő” linket)?
A válasz nagyon egyszerű: ki lehet olvasni az adatbázisból egy bejegyzéssel többet, mint amennyire szükség van a megjelenítéshez, és ennek a „többlet” bejegyzésnek a megléte fogja mutatni, van-e következő adag. Így a látott adatok egy oldalának megszerzéséhez csak egy lekérdezést kell végrehajtani, ami lényegesen javítja a teljesítményt és megkönnyíti ennek a funkciónak a fenntartását. Volt olyan tapasztalatom, amikor az összes rekord számának megszámlálásáról való lemondás a találatok kiadását 4-5-ször felgyorsította.
Ehhez a megközelítéshez több felhasználói felület-változat létezik: a „vissza” és „előre” gombok, mint a fenti példában, az „még több betöltése” gomb, amely egyszerűen hozzáad egy új adagot a megjelenített eredményekhez, és a „végtelen görgetés”, amely az „még több betöltése” elvén működik, de a következő adag megszerzésének jele, hogy a felhasználó az összes megjelenített eredményt végigpörgeti. Akárhogy is van a vizuális megoldás, az adatszűrés elve ugyanaz marad.
A lapozás megvalósításának finomságai
Minden példában, amit fentebb említettem, a „eltolás + mennyiség” megközelítést alkalmazzák, amikor a lekérdezésben meg van határozva, hogy a találatok melyik sorától kezdve és hány sort kell visszaküldeni. Először nézzük meg, hogyan lehet a paraméterek átadását a legjobban megszervezni. Gyakorlatomban több módszert is láttam:
- A kért oldal sorszáma (pageIndex), az oldal mérete (pageSize).
- Az első rekord sorszáma, amelyet vissza kell adni (startIndex), a maximális rekordok száma az eredményben (count).
- Az első rekord sorszáma, amelyet vissza kell adni (startIndex), az utolsó rekord sorszáma, amelyet vissza kell adni (endIndex).
Első pillantásra úgy tűnhet, hogy ez annyira egyszerű, hogy nincs különbség. De nem így van — a második opció (startIndex, count) a legkényelmesebb és leguniverzálisabb megoldás. Ennek több oka is van:
- A fenti, +1 rekord kivonásos megközelítés alapján az első opció, a pageIndex és pageSize rendkívül kényelmetlen. Például, ha 50 rekordot szeretnénk megjeleníteni egy oldalon. A fenti algoritmus szerint egy rekorddal többet kell olvasni, mint ami szükséges. Ha ezt a „+1”-et nem végezzük el a szerveren, akkor az első oldal esetében az 1-től 51-ig kell lekérdezni a rekordokat, a másodiknál pedig 51-től 101-ig stb. Ha az oldal méretét 51-re állítjuk és növeljük a pageIndex-et, akkor a második oldal 52-től 102-ig fog visszaadni stb. Ennek megfelelően az első opcióban az egyetlen módja a következő oldalra való navigáció normalizálásának — hogy a szerver oldalán behelyettesítjük a „többlet” sor kivonását, ami nagyon diszkrét részlet lesz.
- A harmadik opció teljesen értelmetlen, mivel a lekérdezések végrehajtásához a legtöbb adatbázisban mindenképpen át kell adni a rekordok számát, nem az utolsó rekord indexét. Lehet, hogy a startIndex és endIndex kivonás egyszerű aritmetikai művelet, de itt szükségtelen.
Most a „távolság + mennyiség” elv alapján a paging megvalósításának hátrányait kell leírni:
- Minden következő oldal lekérése költségesebb és lassabb lesz, mint az előző, mert az adatbázisnak minden rekordot végig kell néznie „az elejétől” a keresési és rendezési kritériumok szerint, majd megállni a szükséges szakasznál.
- Nem minden DBMS támogatja ezt a megközelítést.
Vannak alternatívák, de ezek sem tökéletesek. Az egyik ilyen megközelítést „keyset paging”-nek vagy „seek method”-nak hívják, és a következőképpen működik: a lap utolsó rekordjának mezőértékeit elmenthetjük, majd ezeket felhasználhatjuk a következő adag lekérdezésére. Például, így hajtottunk végre egy lekérdezést:
SELECT * FROM Sales.SalesOrderHeader
ORDER BY OrderDate DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
A legutolsó bejegyzésben a rendelési dátum értéke ‘2014-06-29’ lett. Ezért a következő oldal lekérdezéséhez próbálkozhatunk az alábbi végrehajtásával:
SELECT * FROM Sales.SalesOrderHeader
WHERE OrderDate < '2014-06-29'
ORDER BY OrderDate DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
A probléma az, hogy az OrderDate nem egyedi mező, és a fenti feltétel valószínűleg sok szükséges sort kihagy. Az egyértelműség érdekében ehhez a lekérdezéshez hozzá kell adni egy egyedi mezőt (tegyük fel, hogy 75074 az utolsó elsődleges kulcs értéke az első adathalazásból):
SELECT * FROM Sales.SalesOrderHeader
WHERE (OrderDate = '2014-06-29' AND SalesOrderID < 75074)
   OR (OrderDate < '2014-06-29')
ORDER BY OrderDate DESC, SalesOrderID DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
Ez a változat helyesen működik, de általános esetben nehezen optimalizálható, mivel a feltétel OR operátort tartalmaz. Ha az OrderDate növekedésével a fő kulcs értéke is növekszik, a feltételt egyszerűsíthetjük, ha csak a SalesOrderID szűrőt hagyjuk meg. De ha nincs szoros korreláció az elsődleges kulcs értékei és a rendezett összehasonlító mező között — a legtöbb DBMS esetén elkerülni ezt az OR-t nem lehet. A tudomásom szerint egy ismert kivétel a PostgreSQL, ahol teljes mértékben támogatják a tuple összehasonlítást, és a fenti feltétel úgy is megfogalmazható, hogy „WHERE (OrderDate, SalesOrderID) < (‘2014-06-29’, 75074)”. Ha a két mezőből álló összetett kulcs áll rendelkezésre, hasonló lekérdezésnek elég könnyűnek kell lennie.
Egy második alternatív megközelítést találhatunk például a vagy — amikor a lekérdezés az adatok mellett egy speciális azonosítót is visszaad, amelyen keresztül megszerezhető a következő adathalazás. Ha ez az azonosító korlátlan élettartamú (mint a Cosmos DB esetében), akkor ez nagyszerű módja a lapozás megvalósításának a lapok között való folyamatos átmenethez (a fent említett #2 opcióval). Lehetséges hátrányai: nem minden DBMS támogatja; a következő adathalazáshoz kapott azonosítónak korlátozott élettartama lehet, ami általánosságban nem alkalmas a felhasználói interakció megvalósítására (mint például az ElasticSearch scroll API esetén).
Bonyolult szűrés
Nézzük meg a feladatot részletesebben. Tegyük fel, hogy megjelent a követelmény a úgynevezett faceted search megvalósítására, amely jól ismert az online boltokban. A fent említett példák a rendelés táblázatának alapján nem túl informatívak ebben az esetben, ezért térjünk át az AdventureWorks adatbázis Product táblázatára:
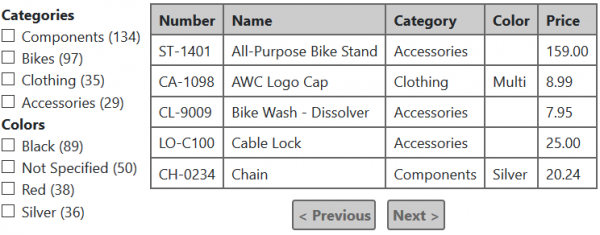
Mi a faceted search lényege? Az, hogy minden szűrőelemhez megmutatja a megfelelő kritériumnak megfelelő bejegyzések számát figyelembe véve az összes többi kategóriában kiválasztott szűrőt.
Például, ha ebben a példában a Bikes kategóriát és a Black színt választjuk, a táblázat csak fekete színű kerékpárokat fog megjeleníteni, de:
- Minden kritérium esetében a „Kategóriák” csoportból megjelenik a fekete színű termékek száma.
- Minden kritérium esetében a „Színek” csoportból megjelenik a fekete színű kerékpárok száma.
Itt egy példa az ilyen feltételek eredményeinek megjelenítésére:
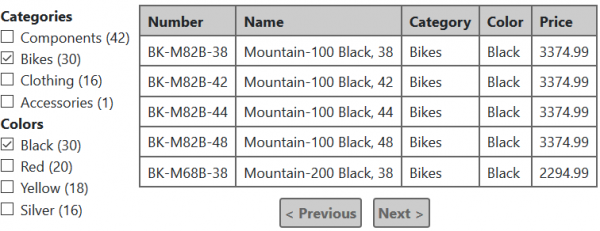
Ha emellett a „Clothing” kategóriát is bejelöljük, a táblázat megmutatja az elérhető fekete színű ruházati termékeket is. A fekete színű termékek száma a „Szín” szekcióban szintén új feltételek szerint lesz újraszámítva, de a „Kategóriák” szekcióban semmi sem változik… Remélem, ezek a példák elegendőek ahhoz, hogy megértsük a faceted search működésének szokásos algoritmusát.
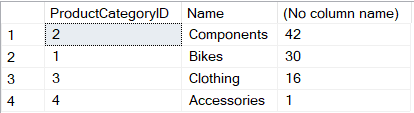
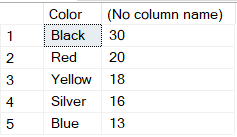
Most képzeljük el, hogyan lehet ezt megvalósítani egy relációs adatbázisban. Minden kritériumcsoport, mint például a Kategória és a Szín, külön lekérdezést igényel:
SELECT pc.ProductCategoryID, pc.Name, COUNT(1) FROM Production.Product p
  INNER JOIN Production.ProductSubcategory ps ON p.ProductSubcategoryID = ps.ProductSubcategoryID
  INNER JOIN Production.ProductCategory pc ON ps.ProductCategoryID = pc.ProductCategoryID
WHERE p.Color = 'Black'
GROUP BY pc.ProductCategoryID, pc.Name
ORDER BY COUNT(1) DESC
SELECT Color, COUNT(1) FROM Production.Product p
  INNER JOIN Production.ProductSubcategory ps ON p.ProductSubcategoryID = ps.ProductSubcategoryID
WHERE ps.ProductCategoryID = 1 --Bikes
GROUP BY Color
ORDER BY COUNT(1) DESC
Mi nem stimmel ezzel a megoldással? Nagyon egyszerű — nem skálázható jól. Minden szűrőrész kér külön lekérdezést a mennyiségek számolásához, és ezek a lekérdezések nem a legegyszerűbbek. Az online boltokban egyes kategóriákban akár több tucat szűrőrész is lehet, ami komoly problémát jelenthet a teljesítmény szempontjából.
Általában ezek után néhány megoldást javasolnak nekem, nevezetesen:
- Összevonni az összes mennyiségi számítást egy kérésbe. Technikai szempontból ez lehetséges az UNION kulcsszó segítségével, de teljesítmény szempontjából nem segít sokat – az adatbázisnak ugyanúgy "nulláról" kell végrehajtania az egyes darabokat.
- Mennyiségek gyorsítótárazása. Ezt gyakorlatilag minden alkalommal javasolják, amikor a problémámat ismertetem. A csavar az, hogy ez általános esetben lehetetlen. Tegyük fel, hogy van 10 "fókuszterület", amelyben 5 érték található. Ez egy nagyon "skromm" helyzet ahhoz képest, amit az online boltokban láthatunk. Egy fókuszterület elemének kiválasztása befolyásolja a másik 9 mennyiségét, más szavakkal, minden kritériumkombinációnál a mennyiségek különbözőek lehetnek. A mi példánkban összesen 50 kritérium áll rendelkezésre, amelyet a felhasználó választhat, ennek megfelelően lehetséges kombinációk száma 250. Az ilyen adathalmasztásra nem lesz elegendő sem a memória, sem az idő. Itt fel lehet lépni azzal, hogy nem minden kombináció valós, és a felhasználók ritkán választanak több mint 5-10 kritériumot. Igen, lehet lazy loading és gyorsítótár csak azokra a mennyiségekre, amiket valaha választottak, de minél több választási lehetőség van, annál kevésbé hatékony lesz az ilyen gyorsítótár, és annál szembetűnőbbek lesznek a válaszidő problémái (különösen, ha az adathalmaz rendszeresen változik).
Szerencsére az ilyen feladatoknak már régen léteznek meglehetősen hatékony megoldásai, amelyek előre láthatóan jól működnek nagy adatmennyiség esetén. Bármelyik esetben érdemes párhuzamosan szétválasztani a fókuszterületek újraszámítását és az eredményoldal lekérését, és úgy szervezni a felhasználói felületet, hogy a fókuszterületek adatainak betöltése "ne zavarja" a keresési eredmények megjelenítését.
- A teljes szűrőszámítást a lehető legritkábban kell elvégezni. Például ne számítsuk újra az összeset a keresési feltételek megváltoztatásakor, hanem keressük meg a megfelelő eredmények összesített számát, és ajánljuk fel a felhasználónak, hogy megjelenítse őket – "1425 találat, megjelenítjük?" A felhasználó vagy folytathatja a keresési feltételek módosítását, vagy rákattinthat a "megjelenítés" gombra. Csak az utóbbi esetben hajtódnak végre az összes lekérdezés az eredmények megszerzésére és a szűrők újraszámlálására. Meg kell említeni, hogy figyelembe kell venni az összesített találatok lekérdezését és annak optimalizálását. Ezt a módszert sok kis internetes boltban találkozhatunk. Nyilvánvaló, hogy ez nem csodaszer a problémára, de egyszerű esetekben jó kompromisszum lehet.
- Használjunk keresőmotorokat az eredmények keresésére és a szűrők számlálására, mint például a Solr, ElasticSearch, Sphinx és mások. Mindegyikük a szűrők létrehozására van optimalizálva, és ezt elég hatékonyan teszik a megfordított indexelés révén. Hogyan épülnek fel a keresőmotorok, miért hatékonyabbak ilyen esetekben, mint a hagyományos adatbázisok, mik a legjobb gyakorlatok és a buktatók – ezek mind külön téma. Itt szeretném kiemelni, hogy a keresőmotor nem helyettesítheti az alapvető adatbázist, kiegészítésként használják: az alapadatbázisban történt bármilyen, a keresés szempontjából fontos változást szinkronizálni kell a keresési indexszel; a keresési mechanizmus általában csak a keresőmotorral lép kapcsolatba, és nem fordul az alapadatbázishoz. Az egyik legfontosabb szempont itt az, hogyan szervezzük meg ezt a szinkronizálást megbízhatóan. Minden a válaszidő követelményeitől függ. Ha a változás az alapadatbázisban és a keresés "megnyilvánulása" közötti idő nem kritikus, létrehozhatunk egy szolgáltatást, amely néhány percenként keresi a nemrégiben módosított rekordokat és indexeli azokat. Ha a lehető legalacsonyabb válaszidő szükséges, valami hasonlót lehet megvalósítani, mint a a keresőszolgáltatás frissítéseinek küldésére.
Következtetések
- A szerveroldali paginálás megvalósítása komoly bonyodalmakat jelent, és csak olyan gyorsan növekvő, vagy egyszerűen csak nagy adathalmazok esetén érdemes alkalmazni. A "nagy" vagy "gyorsan növekvő" értékének meghatározásához nincs abszolút pontos recept, de az alábbi megközelítést javasolnám:
- Ha a teljes adatgyűjtemény szerveroldali időtartamot és hálózati átviteleket figyelembe véve normálisan belefér a teljesítmény követelményekbe, akkor nincs értelme szerveroldali paginálás megvalósításának.
- Előfordulhat, hogy a közeljövőben nem várható teljesítményprobléma, mivel az adatok száma kevés, de az adatok gyűjteménye folyamatosan nő. Ha egy adatgyűjtemény a jövőben valószínűleg már nem felel meg az előző pontnak — érdemes lenne azonnal beletenni a paginálást.
- Ha az üzleti oldalon nincs szigorú követelmény a teljes eredmény számának megjelenítésére vagy az oldalszámok megjelenítésére, és nem áll rendelkezésre keresőmotor a rendszerben — érdemes ezeket a szempontokat figyelmen kívül hagyni, és a 2. opciót mérlegelni.
- Ha világos követelmény van a faceted search-re, akkor két lehetőség áll rendelkezésre a teljesítmény feláldozása nélkül:
- Ne számolja újra az összes mennyiséget a keresési kritériumok minden megváltoztatásakor.
- Használjon olyan keresőmotorokat, mint a Solr, ElasticSearch, Sphinx és mások. De fontos érteni, hogy ez nem helyettesíti az alapadatbázist, és kiegészítésként kell használnia a fő tárolóra a keresési feladatok megoldására.
- A faceted search esetén érdemes a keresési eredmények oldalának lekérését és a mennyiségek számítását két párhuzamos lekérdezésre bontani. A mennyiségek számlálása tovább tarthat, mint az eredmények lekérése, míg az eredmények fontosabbak a felhasználó számára.
- Ha SQL adatbázist használ keresésre, bármilyen kódmódosítás, amely erre a részre vonatkozik, alaposan tesztelve kell legyen a teljesítmény szempontjából a megfelelő adatmennyiségen (meg kell haladnia a "éles" adatbázis méretét). Az is kívánatos, hogy az összes adatbázis példányon, különösen a "éles" adatbázison monitorozza a lekérdezések végrehajtási idejét. Még ha a fejlesztési szakaszban a lekérdezési tervek jól is voltak, az adatmennyiség növekedésével a helyzet jelentősen megváltozhat.
Forrás: habr.com
