

Javaslom, hogy ismerkedj meg Georgy Rylov 2020 eleji előadásának "WAL-G: új lehetőségek és a közösség bővítése" átiratával.
Az open-source karbantartók számos problémával szembesülnek növekedésük során. Hogyan írjuk meg a mindinkább szükséges funkciókat, javítsuk a folyamatosan növekvő hibajelentéseket és kövessük nyomon a bővítési kéréseket? A WAL-G (backup-tool for PostgreSQL) példáján keresztül elmondom, hogyan oldottuk meg ezeket a problémákat, amikor egy Open-source fejlesztési kurzust indítottunk az egyetemen, mit értünk el és merre tartunk tovább.
Mindenkinek üdvözlet ismét! Én egy fejlesztő vagyok a Yandexnél, Jekatyerinburgból. Ma a WAL-G-ról fogok beszélni.
Az előadás címében nem szerepelt, hogy ez valami a biztonsági mentésekről szól. Valaki nem tudja, mi az a WAL-G? Vagy mindenki tudja? Emeljétek fel a kezet, aki nem tudja. Hihetetlen, hogy eljöttetek az előadásra, és nem tudjátok, miről van szó.
Meséljünk arról, hogy mi lesz ma. Úgy néz ki, hogy a csapatunk már elég régóta foglalkozik a biztonsági mentésekkel. Ez egy újabb előadás a sorozatban, ahol arról beszélünk, hogy hogyan tároljuk az adatokat biztonságosan, megbízhatóan, kényelmesen és hatékonyan.
Az előző részekben sok előadás hangzott el Andrej Borodin és Vladimir Leskov részéről. Sokan voltunk. És már évek óta beszélünk a WAL-G-ról.
clck.ru/F8ioz —
clck.ru/Ln8Qw —
Ez az előadás egy kicsit eltér a többitől, mert itt inkább a közösség növekedésével kapcsolatos problémákkal foglalkozom. Elmondom, hogyan találtunk egy kis ötletet, ami segít nekünk ezekkel megbirkózni.
Néhány évvel ezelőtt a WAL-G egy viszonylag kicsi projekt volt, amelyet a Citus Data-tól örököltünk. Csak most vettük át. Ezt korábban egy ember fejlesztette.
És csak a WAL-G-ból hiányoztak:
- Replikáról történő biztonsági mentések.
- Nem voltak inkrementális biztonsági mentések.
- Nem voltak WAL-Delta biztonsági mentések.
- És még rengeteg minden hiányzott.
Az elmúlt néhány évben a WAL-G jelentősen megnőtt.
2020-ra már mindez megvalósult. Továbbá, ami most már van:
- Több mint 1 000 csillag a GitHubon.
- 150 fork.
- Körülbelül 15 nyitott PR.
- És még sok közreműködő.
- És folyamatosan nyitott problémák. És ez annak ellenére, hogy mi naponta betesszük oda, hogy foglalkozzunk vele.
Arra a következtetésre jutottunk, hogy ennek a projektnek több figyelmet kell szentelnünk, még akkor is, amikor nekünk magunknak nincs szükségünk arra, hogy valamit megvalósítsunk a Yandex Managed Databases szolgáltatásához.
2018 őszén egy ötlet ütötte fel a fejét. A csapatnak általában több módja van arra, hogy funkciókat hozzon létre vagy hibákat javítson, ha a kezek száma nem elegendő. Például felvehetnénk egy új fejlesztőt, akinek fizetnünk kell. Vagy esetleg egy gyakornokot is felvehetnénk egy időre, akinek szintén fizetnünk kell. De létezik egy viszonylag nagy réteg is, ahol néhányan már tudnak kódot írni. Csak éppen sosem tudhatod, hogy ez a kód milyen minőségű.
Gondolkodtunk, és úgy döntöttünk, hogy megpróbálunk diákokat bevonni. De a diákok nem fognak mindenben részt venni. Csak a munka egy részét fogják elvégezni. Például teszteket fognak írni, hibákat javítani, olyan funkciókat megvalósítani, amelyek nem érintik az alapvető funkcionalitást. Az alapvető funkcionalitás a biztonsági mentések létrehozása és visszaállítása. Ha hibát ejtünk a biztonsági mentés létrehozásánál, az adatvesztéshez vezethet. És ezt senki sem szeretné. Mindenki azt szeretné, hogy minden nagyon megbízható legyen. Ezért a kód, amelyben kevésbé bízunk, mint a sajátunkban, ott nem akarjuk alkalmazni. Tehát bármilyen nem kritikus kódot, amit kiegészítő munkatársaktól szeretnénk, örömmel látunk.
Milyen feltételek mellett fogadjuk el a diákok PR-ját
- Kötelező, hogy a kódjukat tesztekkel fedjék le. Mindennek át kell mennie a CI-n.
- Ezen kívül két felülvizsgálaton is átesik. Az egyik Andrej Borodinétól, a másik pedig az enyém.
- Továbbá, hogy ellenőrizzem, nem törik-e meg semmi a szolgáltatásunkban, külön feltöltöm a buildet ezzel a commit-tal. És ellenőrizzük az end-to-end tesztekben, hogy semmi nem dől össze.
Speciális tanfolyam az Open Source-ról
Egy kicsit arról, hogy miért van erre szükség és miért tartom ezt menő ötletnek.
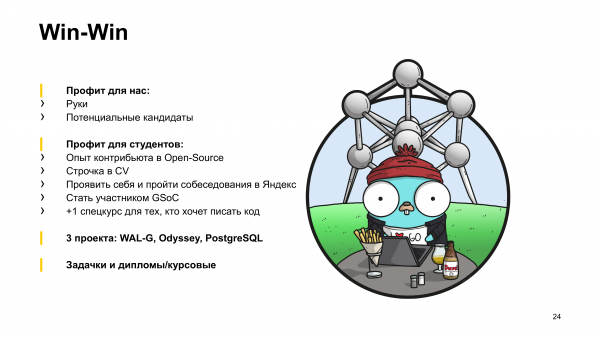
Számunkra a haszon nyilvánvaló:
- További kezeket kapunk.
- És keresünk csapattagokat ügyes diákok között, akik tudnak jól kódot írni.
Milyen haszont nyújt a diákoknak?
Ezek talán kevésbé nyilvánvalók, mert a diákok legalábbis nem kapnak pénzt a kódjukért, csak jegyeket a kreditkönyvükbe.
Megkérdeztem tőlük erről, és a következőket mondták:
- Open Source contributor tapasztalat.
- CV-be kerülő bejegyzés.
- Megmutatkozni és eljutni egy interjúra a Yandexhez.
- Részt venni a GSoC-ban.
- +1 speciális tanfolyam azok számára, akik kódot szeretnének írni.
Nem fogom mesélni, hogyan volt megszervezve a kurzus. Csak annyit mondok, hogy a WAL-G volt a fő projekt. A kurzusunkba olyan projekteket is belevettünk, mint az Odyssey, PostgreSQL és ClickHouse.
Feladatokat nemcsak ezen a kurzuson adtak, hanem diplomamunkákat és kurzusokat is kiadtak.
És mi a haszon a felhasználók számára?
Most térjünk át arra a részre, ami valószínűleg önöket jobban érdekli. Mi a hasznuk ebből? Az a haszon, hogy a hallgatók sok hibát kijavítottak. És megcsinálták azokat a funkciókéréseket, amelyeket kért tőlünk.
És hadd meséljek el dolgokat, amiket régóta szeretett volna, és amelyeket megvalósítottak.
Tablespace támogatás. A tablespace-ek a WAL-G-ban talán a WAL-G kiadása óta várakoztak, mivel a WAL-G a WAL-E nevű másik mentési eszköz utódja, ahol a tablespace-ekkel rendelkező adatbázisok biztonsági mentései voltak támogatva.
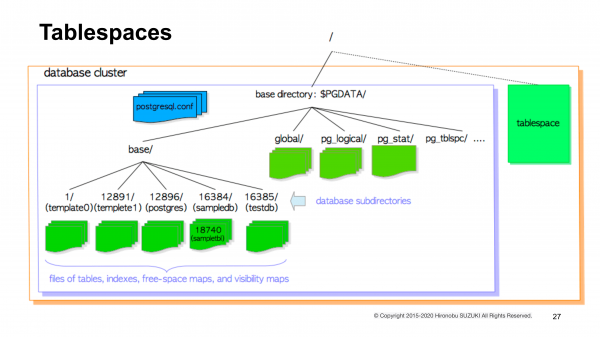
Röviden emlékeztetem, hogy mi ez és miért van szükség rá. Általában a Postgres összes adata egyetlen könyvtárban helyezkedik el a fájlrendszeren, amelyet alap könyvtárnak neveznek. Ez a könyvtár már tartalmazza az összes fájlt és almappát, amely a Postgres működéséhez szükséges.
A tablespace-ek olyan könyvtárak, ahol a Postgres adatai találhatók, de nem helyezkednek el az alap könyvtáron kívül. A dián látható, hogy a tablespace-ek az alap könyvtáron kívül találhatók.
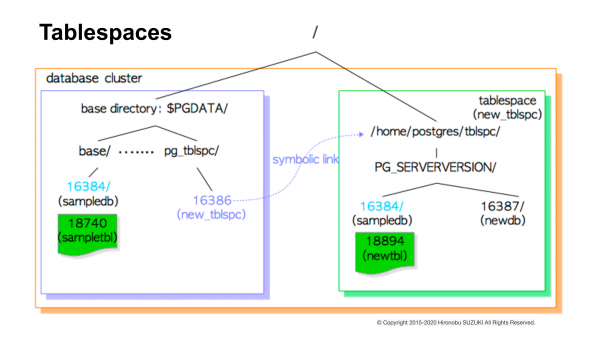
Hogyan néz ez ki magának a Postgres-nek? Az alap könyvtárban van egy külön almappa, a pg_tblspc. Itt szimbolikus linkek találhatók azoknak a könyvtáraknak a helyére, ahol a Postgres adatai ténylegesen helyezkednek el az alap könyvtáron kívül.
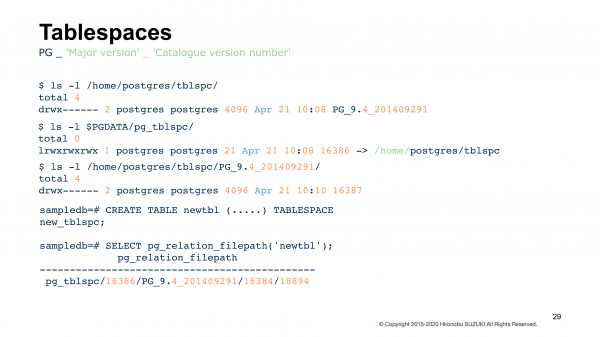
Amikor ezt használja, ezek a parancsok így nézhetnek ki. Tehát létrehoz egy táblát egy megadott tablespace-ben, és megnézi, hol helyezkedik el most. Az utolsó két sor, az utolsó két hívott parancsott. Ott látható, hogy van egy útvonal. De valójában ez nem a valós útvonal. Ez az alap könyvtárhoz tartozó prefixszel rendelkező útvonal a tablespace-hez. És onnan egy szimbolikus linken keresztül vezet valódi adataihoz.
Nálunk ez mindez nem használatos a csapatunkban, viszont sok más WAL-E felhasználónál használták, akik írtak nekünk, hogy szeretnének WAL-G-ra váltani, de ez hátráltatta őket. Most ez támogatott.
A másik funkció, amelyet a speciális kurzusunk hozott nekünk, a catchup. A catchupról azok tudnak, akik valószínűleg többet dolgoztak Oracle-lal, mint Postgres-szel.
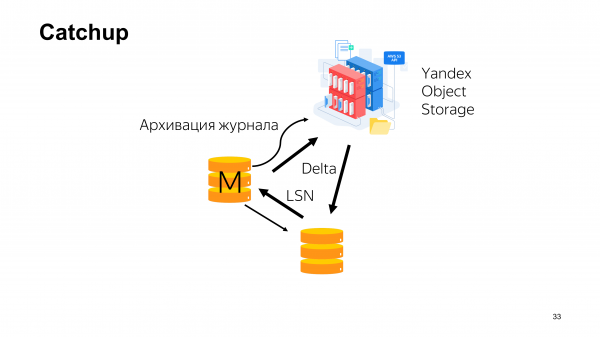
Röviden arról, hogy mi ez. Így általában kinézhet a cluster topológia a szolgáltatásunkban. Van egy mester. Van egy replikáció, ami streameli a write-ahead logot tőle. A replikáció tájékoztatja a mestert, hogy éppen milyen LSN-en van. Eközben párhuzamosan archiválható a napló. Ezen kívül a felhőbe készítünk biztonsági mentéseket. És delta-biztonsági másolatok is küldésre kerülnek.
Milyen probléma adódhat? Amikor elég nagy adatbázisod van, előfordulhat, hogy a replikáció jelentősen lemarad a mestertől. És olyannyira lemarad, hogy soha többé nem tudja utolérni. Ezt a problémát általában valahogy meg kell oldani.
A legegyszerűbb módja ennek az, hogy eltávolítod a replikációt és újra létrehozod, mert soha többé nem fog utolérni, a problémát pedig meg kell oldani. De ez elég időigényes, mert 10 TB-os teljes biztonsági mentés helyreállítása nagyon-nagyon hosszú. És azt akarjuk, hogy ez minél gyorsabban történjen, ha ilyen problémák merülnek fel. Erre való a catchup.
A catchup lehetővé teszi, hogy delta-biztonsági másolatokat használjunk, amelyek a felhőben vannak tárolva. Megmondod, hogy éppen milyen LSN-en van a lemaradó replikáció, és ezt megadod a catchup parancsban a delta-biztonsági másolat létrehozásához az adott LSN és a jelenlegi cluster LSN között. Ezután ezt a biztonsági másolatot helyreállítod a lemaradó replikáción.
Egyéb adatbázisok
Továbbá a diákok több funkciót is hoztak nekünk. Mivel a Yandexnél nemcsak Postgres-t használunk, hanem MySQL-t, MongoDB-t, Redis-t, ClickHouse-t is, egy időben szükségünk volt arra, hogy képesek legyünk point-in-time recovery biztonsági másolatokat készíteni MySQL-ből, és hogy lehetőség legyen azokat a felhőbe feltölteni.
Azt akartuk, hogy ezt hasonló módon valósítsuk meg, ahogy a WAL-G teszi. És úgy döntöttünk, hogy kísérletezünk, és megnézzük, hogyan néz ki mindez.
Kezdetben nem különválasztva ezt a logikát, forkban írtuk a kódot. Láthattuk, hogy van valami működő modellünk, és ez működhet. Aztán arra gondoltunk, hogy a fő közösségünk a Postgres felhasználók, ők használják a WAL-G-t. Ezért szükséges, hogy ezeket a részeket valahogy szétválasszuk. Azaz, amikor javítjuk a kódot a Postgreshez, nem zúzzuk le a MySQL-t, és amikor a MySQL-t javítjuk, akkor nem zúzzuk le a Postgres-t.
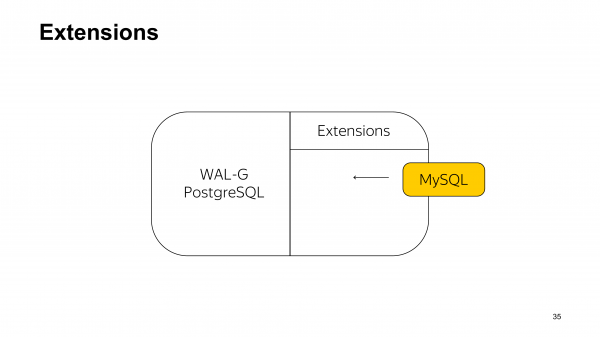
Az első ötlet arról, hogy hogyan lehet ezt szétválasztani, a PostgreSQL bővítményeknél használt megközelítés alkalmazása volt. Alapvetően ahhoz, hogy MySQL-t menthessünk, valamilyen dinamikus könyvtárat kellett telepíteni.
De itt azonnal látszik ennek a megközelítésnek az aszimmetriája. Amikor Postgres-t mentesz, egy normális mentőprogramot telepítesz rá, és minden jól működik. MySQL esetében viszont úgy tűnik, hogy egy Postgres mentőprogramot kell telepítened, és ehhez még egy dinamikus könyvtárat a MySQL-hez. Ez furcsán hangzik. Mi is így gondoltuk, és úgy döntöttünk, hogy ez nem az a megoldás, amire szükségünk van.
Különböző összesítések a Postgres, MySQL, MongoDB, Redis számára.
De úgy tűnik, ez lehetővé tette számunkra, hogy a helyes megoldáshoz jussunk – különböző összesítések kiemelése a különböző adatbázisokhoz. Ez lehetővé tette a különböző adatbázisok mentési logikájának elkülönítését, amelyek egy közös API-hoz fordulnak, amelyet a WAL-G valósít meg.
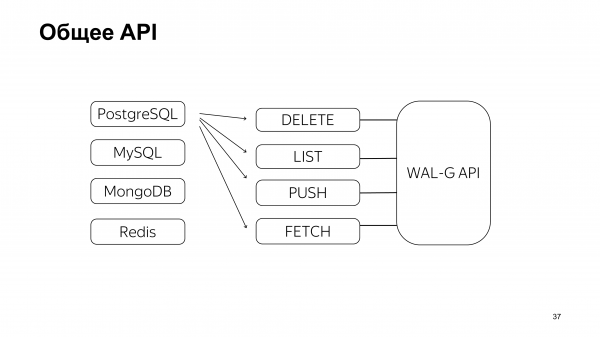
Ez az a rész, amit mi írtunk – mielőtt a diákoknak feladatokat adtunk. Tehát ez az a rész, ahol ők valószínűleg hibázni tudtak, ezért úgy döntöttünk, hogy inkább mi csinálunk valamit, és akkor minden rendben lesz.
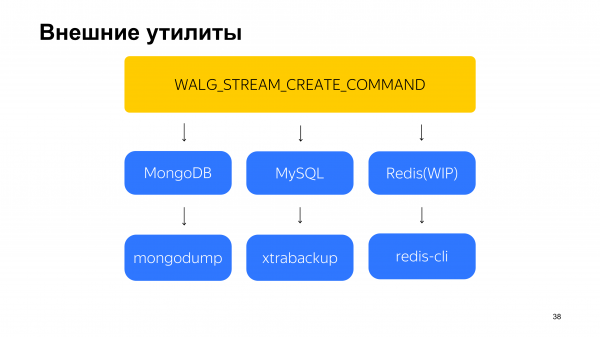
Ezután kiadtuk a feladatokat. Ezeket azonnal meg is oldották. A diákoktól azt vártuk el, hogy három adatbázist támogassanak.
Ez a MySQL, amelyet már több mint egy éve mentünk a WAL-G segítségével.
És most a MongoDB már a produkcióhoz közelít, ott apró javításokat végeznek. Alapvetően ezeknek a munkálatoknak a keretét mi írtuk. A diákok pedig írtak néhány működő dolgot. Ezután mi ezeket olyan állapotba hoztuk, hogy el tudjuk fogadni a produkciónkban.
Ezek a feladatok nem úgy néztek ki, hogy a diákoknak teljes backup eszközöket kellett volna írniuk minden egyes adatbázis számára. Ez a probléma nem állt fenn. A problémánk az volt, hogy point-in-time recovery-t akartunk, és azt, hogy a felhőbe mentsünk. Kértük a diákokat, hogy írjanak valamilyen kódot, amely ezt megoldja. A diákok a már meglévő backup eszközöket használták, amelyek valamilyen módon készítenek mentéseket, majd ezeket összeszerelték a WAL-G-vel, ami mindent felküld a felhőbe. Ezen kívül hozzáadták a point-in-time recovery-t is.
Mi mást hoztak a diákok? Hozzátették a WAL-G-hez a Libsodium titkosítási támogatást.
Illetve bevezetésre kerültek a mentések tárolásának politikái. Mostantól a mentések permanensnek jelölhetők. Így kényelmesebbé válik a szolgáltatásod számára a tárolási folyamat automatizálása.
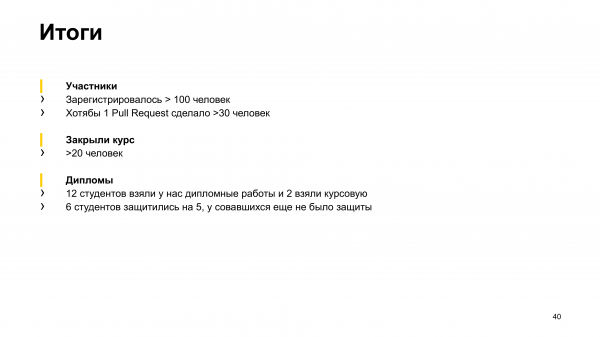
Mi lett a kísérlet eredménye?
Eredetileg több mint 100 fő regisztrált a tanfolyamra. Eleinte nem mondtam, hogy az egyetem Jekatyerinburgban az Ural Szövetségi Egyetem. Itt hirdettük meg. 100 fő regisztrált. Valójában sokkal kevesebben kezdtek el dolgozni, körülbelül 30 fő.
Még kevesebb ember fejezte be a kurzust, mert ott teszteket kellett írni a már meglévő kódokhoz. Emellett meg kellett javítani egy hibát, vagy készíteni egy új funkciót. Néhány diák mégis befejezte a kurzust.
Jelenleg a diákok körülbelül 14 problémát javítottak ki ezen a kurzuson, és 10 különböző méretű funkciót készítettek. Véleményem szerint ez egy-két fejlesztő teljes értékű helyettesítése.
Továbbá diplomákat és kurzusmunkákat adtunk ki. 12 diák vette át a diplomáját. 6 már „5”-ös osztályzatot kapott az államvizsgán. A többieknek még nem volt védésük, de úgy gondolom, hogy náluk is minden rendben lesz.
Jövőbeli tervek
Mik a jövőbeli terveink?
Legalábbis azok a funkciók, amelyeket már hallottunk a felhasználóktól, és amelyeket szeretnénk megvalósítani. Ezek a következők:
- A HA klaszter hátterének archívumában a timeline helyességének nyomon követése. Ezt a WAL-G segítségével meg lehet csinálni. És úgy gondolom, találunk diákokat, akik elvállalják ezt a feladatot.
- A felhők közötti biztonsági másolatok és WAL átvitelének felelőse már megvan.
- Nemrégiben közzétettük azt az ötletet, hogy a WAL-G-t még gyorsabbá tudjuk tenni az inkrementális biztonsági mentések kicsomagolásával anélkül, hogy felülírnánk az oldalakat, és az archívumok optimalizálásával, amelyeket oda küldünk.
Itt megoszthatod őket
Mi volt ennek a beszámolónak a célja? Az, hogy most, rajtunk kívül 4 ember, aki ezt a projektet támogatja, vannak további kezek, akiket elég könnyen elérhetsz. Különösen, ha személyesen írsz nekik. Ha biztonsági másolatot készítesz az adatokról, és ezt WAL-G segítségével teszed, vagy szeretnél a WAL-G-re áttérni, akkor a kívánságaidat viszonylag könnyen figyelembe tudjuk venni.
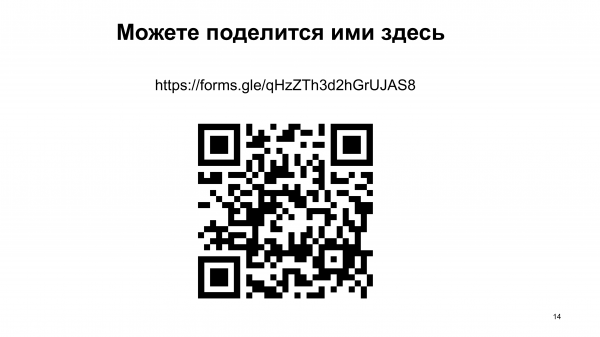
Ez a QR-kód és hivatkozás. Ezek segítségével át tudsz térni és meg tudod írni minden kívánságodat. Például, ha egy hibát nem javítunk ki. Vagy egy funkciót szeretnél, de valamiért még nincs a biztonsági másolatok között, beleértve a miénket is. Mindenképpen írd meg ezt.
Kérdések
Helló! Köszönöm a beszámolót! Kérdésem van a WAL-G-vel kapcsolatban, de nem a Postgresről. A WAL-G menti a MySQL-t, és extramentést kezdeményez. Ha a modern telepítéseket nézzük CentOS-on, és ha megcsinálja a yum install MySQL-t, akkor a MariaDB települ. A 10.3-as verziótól az extramentés nem támogatott, a MariaDB-mentés támogatott. Milyen a helyzet ezzel önöknél?
Jelenleg nem próbáltuk meg a MariaDB mentését. Volt kérésünk a FoundationDB támogatására, de összességében, ha van ilyen kérés, akkor találhatunk embereket, akik ezt megcsinálják. Nem olyan hosszú és nem olyan nehéz, mint nekem tűnik.
Jó napot! Köszönöm a beszámolót! Kérdésem van a potenciálisan új funkciókról. Készen állnak arra, hogy a WAL-G-t működésbe hozzák szalagokkal, hogy mentést végezhessünk szalagokra?
A szalagos tárolóról van szó, ugye?
Igen.
Ott van Andrej Borodin, aki erre a kérdésre jobban tud válaszolni nálam.
(Andrej) Igen, köszönöm a kérdést! Volt kérés a felhőből szalagra történő mentéshez. És ezért a felhők közötti átvitelt. Mert a felhők közötti átvitel egy bizonyos általános verziója a szalagra történő átvitelnek. Ezenkívül bővíthető architektúránk van a tárolók terén. Érdekes, hogy sok tárolót diákok írtak. Ha ír egy tárolót szalagra, akkor azt természetesen támogatni fogjuk. Készen állunk a pull requestek megfontolására. Fel kellene írni egy fájlt, el kellene olvasni egy fájlt. Ha ezeket Go-ra írják, akkor általában 50 sor kódot kapunk. És akkor a WAL-G támogatni fogja a szalagot.
Köszönöm a beszámolót! Érdekes fejlesztési folyamat. A mentés egy komoly funkció, amelynek jól kell teszteltnek lennie. Amikor új adatbázisokhoz valósították meg a funkciót, a teszteket is diákok írták, vagy önök maguk írták a teszteket, majd adták át a megvalósítást diákoknak?
A teszteket is diákok írták. De a diákok többet írtak az olyan funkciókhoz, mint az új adatbázisok. Írtak integrációs teszteket. És írtak unit-teszteket is. Ha az integrációs tesztek átmennek, azaz jelenleg ez egy forgatókönyv, amit manuálisan hajtanak végre vagy amit például a cron végez, akkor ez a forgatókönyv nagyon is érthető.
A diákoknak nem sok tapasztalatuk van. Mennyire sok időbe telik a felülvizsgálat?
Igen, a felülvizsgálat valóban sok időt igényel. Tehát általában, amikor egyszerre több elkövető érkezik, és azt mondják, hogy ezt tettem, azt tettem, akkor rá kell szánni egy fél napot, hogy megértsük, mit írtak. Mert a kódot alaposan kell olvasni. Ők nem vettek részt a interjún. Nem igazán ismerjük őket, ezért ez jelentős időt vesz igénybe.
Köszönöm a beszámolót! Korábban Andrej Borodin azt állította, hogy az archive_command-nak a WAL-G-ban közvetlenül kellene hívódnia. De valamilyen patron klaszter esetén szükségünk van további logikára a nodok meghatározásához, ahonnan az wal-kat küldeni kell. Hogyan oldják meg ezt a problémát?
Milyen problémába ütközik itt? Például van egy szinkron replikája, ahonnan biztonsági másolatot készít? Vagy mi?
(Andrej) Az a helyzet, hogy a WAL-G valóban shell-scriptek használatát feltételezi. Ha valami hiányzik, akkor írjunk egy logikát, ami a WAL-G-n belül kellene, hogy legyen. Ami azt illeti, hogy honnan kell a archiválás, úgy gondoljuk, hogy a archivációnak a jelenlegi masterből kell történnie a klaszterben. A replikáról történő archiválás rossz ötlet. Ott különféle problémákkal járhatnak. Különösen problémák lehetnek az archívum idővonalakkal és egyéb információkkal. Köszönöm a kérdést!
(Javítás: Megszabadultunk a shell-scriptek láncolásától )
Jó estét! Köszönöm a beszámolót! Érdekes volt a catchup funkció, amiről beszéltél. Találkoztunk olyan helyzettel, amikor a replikának nem sikerült utolérnie az eseményeket. A WAL-G-ban nem találtam a dokumentumban ennek a funkciónak a leírását.
A Catchup szó szerint 2020 január 20-a környékén jelent meg. A dokumentációt talán érdemes lenne jobban kidolgozni. Magunk írjuk, és nem igazán írtuk meg olyan szuper jól. És talán a diákoktól is meg kellene követelni, hogy őket írják.
Már a kiadásban van?
A pull request már össze lett fűzve, tehát ellenőriztem. Kipróbáltam ezt egy teszt klaszteren. Eddig nem volt olyan helyzet, amikor ezt éles példán tudtuk volna ellenőrizni.
Mikor lehet számítani rá?
Nem tudom. Várj egy hónapot, biztosan ellenőrizzük.
Forrás: habr.com
