

2019 óta Oroszországban kötelező termékbejegyzési törvény van érvényben. A törvény nem vonatkozik minden termékcsoportra, és a kötelező bejegyzés hatályba lépésének időpontjai a különböző termékcsoportra eltérőek. Az elsőként kötelező bejegyzés alá eső termékek közé tartozik a dohány, a lábbeli és a gyógyszerek, később más termékek, mint például a parfüm, textíliák és tej is hozzáadódnak. Ez a jogszabályi újítás új informatikai megoldások kifejlesztésére inspirálta a teljes termék életciklusának nyomon követésére, a gyártástól a végfelhasználó vásárlásáig, mind az állam, mind pedig a kötelező bejegyzés alá eső termékeket forgalmazó szervezetek számára.
Az X5-nél a termékek nyomon követésére és az állammal, valamint a beszállítókkal való adatcserére szolgáló rendszer neve „Markus”. Részletesen bemutatjuk, hogyan és ki fejlesztette ki, milyen technológiai stackkel rendelkezik, és miért lehetünk büszkék rá.
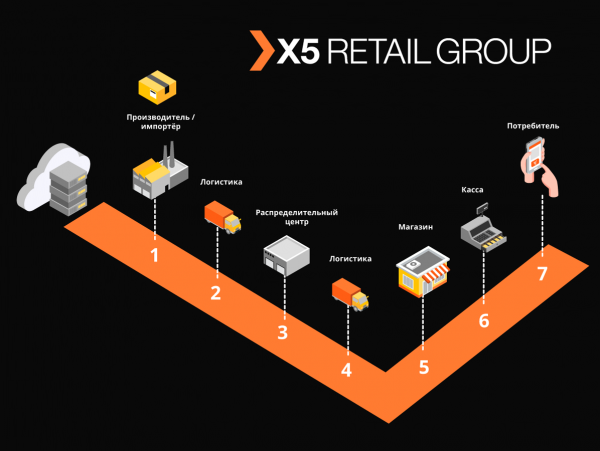
Igazi HighLoad
A „Markus” számos feladatot megold, ezek közül a legfontosabb az integrált együttműködés a X5 informatikai rendszerei és az állami nyilvántartás (GIS MP) között, amely a nyomon követésre szolgál. A platform tárolja az összes hozzánk beérkezett bejegyzési kódot és azok mozgásának történetét, valamint segít a bejegyzett termékek átsorolásának megszüntetésében. Például a dohánytermékek esetében, amelyek az első bejegyzett termékcsoportok közé tartoznak, egyetlen teherautó cigaretta körülbelül 600 000 dobozt tartalmaz, mindegyiknek saját egyedi kódja van. Rendszerünk feladata, hogy nyomon kövesse és ellenőrizze minden ilyen doboz legális mozgatását a raktárak és boltok között, és végső soron ellenőrizze azok értékesítésének lehetőségét a végfelhasználó számára. Egy órában körülbelül 125 000 pénztári tranzakciót regisztrálunk, és azt is rögzíteni kell, hogyan került be minden egyes doboz a boltba. Így, figyelembe véve az összes mozgást, évente több tízmilliárd bejegyzésre számítunk.
A csapat M
Bár a "Markus" az X5 keretein belül projektnek számít, termékmegközelítéssel valósul meg. A csapat Scrum módszertant alkalmaz. A projekt kezdete tavaly nyáron volt, de az első eredmények csak októberre érkeztek meg - teljes mértékben összegyűlt a saját csapat, kiépült a rendszer architektúrája és megvásároltuk a szükséges berendezéseket. Jelenleg a csapat 16 főből áll, közülük hatan foglalkoznak backend és frontend fejlesztéssel, hárman pedig rendszerszintű elemzéssel. A manuális, terhelési, automatizált tesztelés és a termék támogatása további hat embert érint. Emellett van egy SRE-specialistánk.
A csapatunkban nemcsak a fejlesztők programoznak, szinte mindenki tud programozni, ír automatikus teszteket, terhelési szkripteket és automatizálási szkripteket. Különös figyelmet fordítunk erre, mivel a terméktámogatás is magas szintű automatizálást igényel. A kollégáknak, akik korábban nem programoztak, mindig próbálunk segíteni és iránymutatást adni, hogy kisebb feladatokat kapjanak.
A koronavírus-járvány miatt teljes csapatunkat távoli munkavégzésre állítottuk át, a fejlesztés irányításához szükséges összes eszköz és a Jira és GitLab munkafolyamat-képzése lehetővé tette, hogy könnyen átmenjünk ezen a szakaszon. Az otthoni munka hónapjai bebizonyították, hogy a csapat teljesítménye nem szenvedett csorbát, sokak számára pedig kényelmesebbé vált a munkavégzés, az egyetlen dolog, ami hiányzik, a személyes interakció.
A csapat találkozója a távoli munkavégzés előtt
Találkozók távoli munkavégzés alatt
A megoldás technológiai stackje
Az X5 standard tárolója és CI/CD eszköze a GitLab. Ezt használjuk a kód tárolására, folyamatos tesztelésére, és a teszt- és éles szerverekre való telepítésére. Továbbá alkalmazzuk a kódellenőrzés gyakorlatát, amikor legalább 2 kollégának kell jóváhagynia a fejlesztő által végzett módosításokat. A SonarQube és a JaCoCo statikus kódelemzők segítenek a kód tisztán tartásában és a szükséges egységteszt-lefedettség biztosításában. Minden kódváltoztatásnak kötelezően át kell mennie ezeken az ellenőrzéseken. Az összes manuálisan végrehajtott tesztelési forgatókönyvet később automatizálni kell.
A "Markus" üzleti folyamatainak sikeres végrehajtásához számos technológiai feladatot kellett megoldanunk, amelyeket sorban fogunk bemutatni.
Feladat 1. A rendszer horizontális skálázhatóságának szükségessége
Ezen feladat megoldására mikro-szolgáltatási megközelítést választottunk az architektúrában. Ezenkívül nagyon fontos volt megérteni a szolgáltatások felelősségi körét. Igyekeztünk őket üzleti műveletek szerint szétválasztani, figyelembe véve a folyamatok sajátosságait. Például a raktárba érkezés nem gyakori, de nagyon nagy volumenű művelet, amely során maximálisan gyorsan kell megszereznünk az állami szabályozótól a fogadott árucikkek adatait, amelyek egy szállítmányn belül elérhetik a 600000 darabot, ellenőrizni kell a termék raktárba való fogadásának engedélyezhetőségét és átadni az összes szükséges információt a raktározási automatizáló rendszer részére. Ezzel szemben a raktárról való kiszállítás sokkal nagyobb intenzitással zajlik, de a folyamatban kisebb adatmennyiségekkel dolgozik.
Minden szolgáltatást stateless elv alapján valósítunk meg, és még a belső műveleteket is igyekszünk lépésekre bontani, önálló, úgynevezett self-témák használatával a Kafka rendszerén. Ez lehetővé teszi, hogy a mikro-szolgáltatás üzenetet küldjön saját magának, ami segít a nagyobb erőforrást igénylő műveletek terhelésének kiegyensúlyozásában és egyszerűsíti a termék karbantartását, de erről később.
Döntöttünk arról, hogy a külső rendszerekkel való kapcsolattartó modulokat külön szolgáltatásként valósítunk meg. Ez lehetővé tette a külső rendszerek gyakran változó API-jának problémáját szinte teljesen függetlenül kezelni az üzleti funkciókkal rendelkező szolgáltatásoktól.
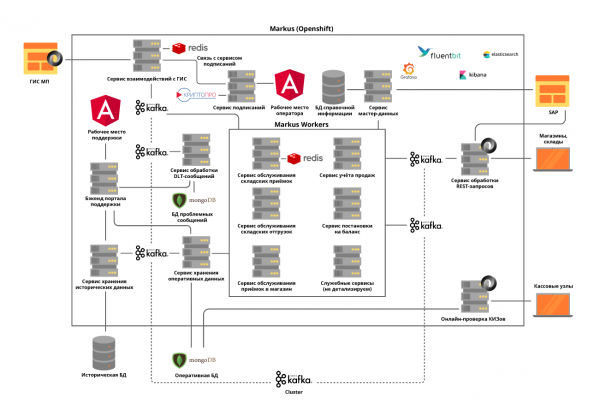
Minden mikro-szolgáltatás az OpenShift klaszterben fut, amely megoldja minden mikro-szolgáltatás skálázási problémáit, és lehetővé teszi számunkra, hogy ne használjunk külső Service Discovery eszközöket.
Feladat 2. A platformon belüli szolgáltatások közötti intenzív adatcsere és magas terhelés fenntartásának szükségessége: csak a projekt indítási fázisában körülbelül 600 műveletet hajtunk végre másodpercenként. Ezt a számot várhatóan 5000 művelet/másodpercre emeljük a kereskedelmi objektumok platformunkhoz történő csatlakozásával.
Ezt a feladatot a Kafka klaszter telepítésével és a platform mikroservizjei közötti szinkron interakciók gyakorlatilag teljes mellőzésével oldottuk meg. Ez nagyon alapos elemzést igényel a rendszer követelményeiről, mivel nem minden művelet lehet aszinkron. Emellett nem csupán eseményeket továbbítunk a bróker-en keresztül, hanem az összes szükséges üzleti információt is továbbítunk az üzenetben. Így az üzenet mérete akár több száz kilobátra is nőhet. A Kafka üzenetméretére vonatkozó korlátozások pontos előrejelzést követelnek meg az üzenetek méretéről, és szükség esetén felosztjuk őket, de ez a felosztás logikai, amely az üzleti műveletekhez kapcsolódik.
Például, a gépjárművel érkezett terméket ládákra bontjuk. A szinkron műveletekhez külön mikroservizeket állítunk fel, és alapos terheléses tesztelést végzünk. A Kafka használata egy új kihívást jelentett számunkra — a Kafka integráció figyelembevételével a szolgáltatásunk működésének ellenőrzése minden unit tesztünket aszinkronná tette. Ezt a feladatot saját hasznos segédfunkciók írásával oldottuk meg Embedded Kafka Broker használatával. Ez nem zárja ki az egyes metódusokra vonatkozó unit tesztelés szükségességét, de a bonyolult eseteket szívesebben teszteljük Kafka használatával.
Nagyon sok figyelmet fordítottunk a naplózás követésére, hogy a TraceId ne vesszen el, amikor kivételek merülnek fel a szolgáltatások működése során, vagy a Kafka batch használatakor. Az első esetben nem merült fel különösebb kérdés, de a második esetben kénytelenek voltunk naplózni az összes TraceId-t, amellyel a batch érkezett, és választani egyet a követés folytatásához. Így ha az eredeti TraceId alapján keresünk, a felhasználó könnyen megtalálja, hogy mivel folytatódott a követés.
3. feladat. Nagy mennyiségű adat tárolásának szükségessége: évente több mint 1 milliárd címkét hoz be az X5, csak a dohányra vonatkozóan. Ezekhez folyamatos és gyors hozzáférés szükséges. A rendszernek körülbelül 10 milliárd bejegyzést kell kezelnie a címkézett termékek adatainak mozgásáról.
A harmadik feladat megoldására a MongoDB NoSQL adatbázist választottuk. 5 nodból álló shardingot építettünk ki, és minden nodban 3 szerverből álló Replica Set található. Ez lehetővé teszi a rendszer horizontális skálázását, új új szervereket a klaszterbe, és biztosítania kell annak hibamentességét. Itt egy másik problémával szembesültünk — a tranzakcionalitás biztosítása a mongo klaszterben, figyelembe véve a vízszintesen skálázható mikroszolgáltatások használatát. Például a rendszerünk egyik feladata, hogy felfedje a termékek ajánlott kódú többszörös értékesítési kísérleteit. Itt problémák lépnek fel a hibás beolvasásokkal vagy a pénztárosok hibás műveleteivel. Felfedeztük, hogy az ilyen duplikációk egyetlen, feldolgozott Kafka batchen belül, valamint két párhuzamosan feldolgozott batchen is előfordulhatnak. Így a duplikációk észlelése az adatbázis lekérdezésével nem hozott eredményt. Minden egyes mikroszolgáltatásnál külön-külön oldottuk meg a problémát, figyelembe véve az adott szolgáltatás üzleti logikáját. Például a blokk mérésekhez belső batch ellenőrzést és külön feldolgozást adtunk a duplikátumok előfordulására a beszúrás során.
Annak érdekében, hogy a felhasználók műveleteik történetével való munkája ne befolyásolja a legfontosabbat — üzleti folyamataik működését, minden történeti adatot egy külön szolgáltatásba emeltünk egy külön adatbázissal, amely szintén kafka-n keresztül kap információt. Így a felhasználók egy elszigetelt szolgáltatással dolgoznak, amely nem befolyásolja a jelenlegi műveletek adatait feldolgozó szolgáltatásokat.
Feladat 4. Ismételt feldolgozás a sorokban és monitorozás:
A megosztott rendszerekben elkerülhetetlen, hogy problémák és adatbázisok, sorok, külső adatforrások hibái merüljenek fel. A "Markus" esetében ezeknek a hibáknak a forrása a külső rendszerekkel való integráció. Olyan megoldást kellett találni, amely lehetővé teszi a hibás válaszok ismételt lekérdezését valamilyen meghatározott időkorláttal, de e közben nem állítja le a sikeres lekérdezések feldolgozását a fő sorban. Ehhez választották az úgynevezett 'témaközpontú újrapróbálkozás' koncepciót. Minden fő témához egy vagy több újrapróbálkozási téma jön létre, ahová a hibás üzeneteket irányítják, és így megszüntetik a késlekedést a fő téma üzeneteinek feldolgozása során. Az együttműködés séma —
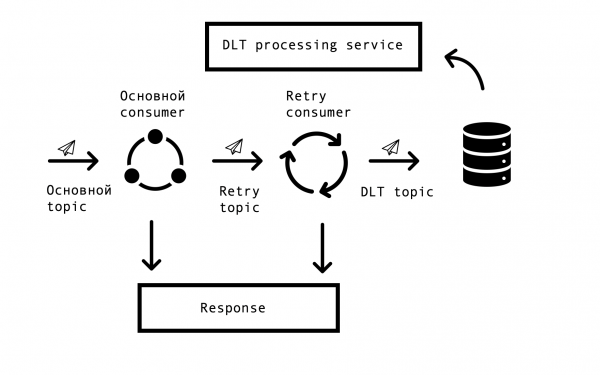
Egy ilyen rendszer megvalósításához szükségünk volt a következőkre – integrálni ezt a megoldást a Spring-el és elkerülni a kód duplikációt. Az interneten rábukkantunk egy hasonló megoldásra, amely a Spring BeanPostProcessor-ra alapult, de túlságosan bonyolultnak tűnt számunkra. Csapatunk egy egyszerűbb megoldást készített, amely lehetővé teszi a Spring fogyasztó létrehozási ciklusába való beépülést, valamint további Retry fogyasztók hozzáadását. A megoldásunk prototípusát bemutattuk a Spring csapatának, amit meg lehet nézni. . A Retry fogyasztók száma és az egyes fogyasztók kísérleteinek száma paramétereken keresztül állítható be, a üzleti folyamat igényei szerint, és hogy minden működjön, mindössze annyit kell tennünk, hogy elhelyezzük a jól ismert org.springframework.kafka.annotation.KafkaListener annotációt a Spring-fejlesztők számára.
Abban az esetben, ha az üzenetet nem sikerült feldolgozni minden retry próbálkozás után, a DLT-be (dead letter topic) kerül a Spring DeadLetterPublishingRecoverer segítségével. A támogatás kérésére ezt a funkciót kiterjesztettük, és külön szolgáltatást hoztunk létre, amely lehetővé teszi a DLT-be került üzenetek, stackTrace, traceId és más hasznos információk megtekintését. Ezen kívül monitorozásokat és riasztásokat is hozzáadtunk az összes DLT témához, és mostantól az üzenet megjelenése a DLT témában alkalmat ad a vizsgálatra és a hiba bejegyzésére. Ez nagyon kényelmes – a téma neve alapján azonnal tudjuk, hogy a folyamat mely lépésén merült fel a probléma, ami jelentősen felgyorsítja a gyökérok keresését.
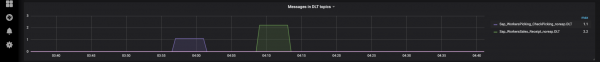
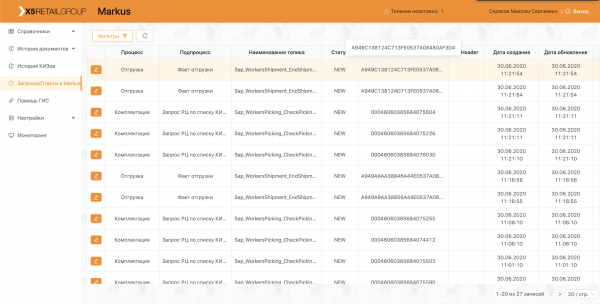
Nemrégiben megvalósítottunk egy felületet, amely lehetővé teszi az üzenetek újraküldését a támogatásunk segítségével, miután elhárították az okokat (például egy külső rendszer működésének helyreállítása) és természetesen a megfelelő hiba bejegyzése az elemzéshez. Itt jöttek jól a self-témáink, hogy ne kelljen újraindítani a hosszú feldolgozási láncot, lehetőség van újraindítani azt a megfelelő lépéstől.
A platform üzemeltetése
A platform már produktív használatban van, minden nap szállításokat végzünk, új elosztóközpontokat és üzleteket csatlakoztatunk. A pilot keretein belül a rendszer a "Dohány" és a "Lábbelik" termékcsoportokkal működik.
Csapatunk minden tagja részt vesz a pilotok lebonyolításában, elemzi a felmerülő problémákat és javaslatokat tesz a termékünk fejlesztésére, a naplók javításától kezdve a folyamatok megváltoztatásáig.
Annak érdekében, hogy elkerüljük a korábbi hibáinkat, minden pilóta során talált esetet automatikus tesztekben tükrözünk. A sok automatikus és egységteszt lehetővé teszi a regressziós tesztelést és a hotfixek telepítését szó szerint néhány órán belül.
Jelenleg továbbfejlesztjük és tökéletesítjük a platformunkat, és folyamatosan új kihívásokkal szembesülünk. Ha érdekli, szívesen mesélünk a megoldásainkról a következő cikkekben.
Forrás: habr.com
