

2019. május 27-én, a DevOpsConf 2019 főtermében, amely a fesztivál keretein belül zajlik, , a "Folyamatos szállítás" szekció keretében elhangzott a "werf — eszközünk a CI/CD számára Kubernetesben" című előadás. Ebben a Kubernetesbe történő telepítésekkel kapcsolatos problémákról és kihívásokról beszélünk,valamint azokról a finomságokról, amelyek nem mindig nyilvánvalóak. A lehetséges megoldások elemzésekor megmutatjuk, hogyan valósul meg ez az Open Source eszközben, .
Az előadás óta eszközünk (korábban dapp néven ismert) áttörte a 1000 csillagot a GitHub-on, és reméljük, hogy a növekvő felhasználói közösség sok DevOps mérnök életét megkönnyíti.
Tehát bemutatjuk a (kb. 47 perc, sokkal informatívabb, mint a cikk) és a főbb összefoglalót szöveges formában. Induljon!
Kód szállítása Kubernetesben
Az előadásban már nem a werf-ről lesz szó, hanem a CI/CD-ről Kubernetesben, feltételezve, hogy szoftverünk Docker konténerekbe van csomagolva. (erről a )beszéltem, és a K8s-t a produkciós környezetben történő futtatásához fogjuk használni, (erről - a ).
Hogyan néz ki a szállítás Kubernetesben?
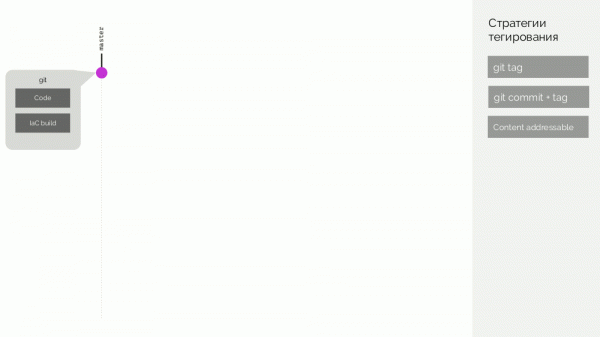
- Van egy Git-tárhely, amely tartalmazza a kódot és a build utasításokat. Az alkalmazás Docker képbe kerül, és közzéteszik a Docker Registry-n.
- Ugyanebben a tárhelyben vannak utasítások arra is, hogyan lehet az alkalmazást telepíteni és elindítani. A telepítési szakaszban ezek az utasítások a Kubernetesbe kerülnek, amely megkapja a szükséges képet a registry-ből és elindítja azt.
- Plusz általában vannak tesztek. Ezek közül néhányat a kép közzétételekor lehet végrehajtani. Az (ugyanazon utasítások alapján) az alkalmazás egy példányát is telepíthetjük (külön névtérben K8s-ben vagy külön klaszterben), és ott futtathatjuk a teszteket.
- Végül szükség van egy CI rendszerre, amely eseményeket kap a Git-ből (vagy gombnyomásokat) és végrehajtja az összes megjelölt szakaszt: build, publish, deploy, test.
Itt néhány fontos megjegyzés van:
- Mivel számunkra a megváltoztathatatlan infrastruktúra (immutable infrastructure),az alkalmazás képe, amit minden lépésben (staging, production stb.) használunk, egységes kell legyen.. Erről részletesebben és példákkal beszéltem, .
- Mivel követjük az infrastruktúra mint kód megközelítést (IaC),az alkalmazás kódját, a build és futtatási utasításokat ugyanabban a repo-ban kell tárolni.. Erről részletesebben lásd a .
- A szállítás lánca (delivery) Általában így látjuk: az alkalmazást összegyűjtöttük, teszteltük, kiadtuk (kiadási szakasz) és ennyi — a szállítás megtörtént. De valójában a felhasználó azt kapja, amit kiadtál, nem amikor azt a production környezetbe szállítottad, és amikor ő hozzáfért és ez a production működött. Ezért azt gondolom, hogy a szállítási lánc csak az üzemeltetési szakaszban ér véget (futás), sőt, ha pontosabbak akarunk lenni, akkor abban a pillanatban, amikor a kódot eltávolították a productionból (kicserélve egy újra).
Visszatérve a fent említett szállítási sémára Kubernetesben: ezt nemcsak mi találtuk ki, hanem gyakorlatilag mindenki, aki foglalkozott ezzel a problémával. Tulajdonképpen ezt a mintát most GitOps-nak nevezik (több információt a kifejezésről és az azt körülvevő ötletekről itt olvashatsz ). Nézzük meg a sémák lépéseit.
Összegyűjtési szakasz
Azt hinné az ember, hogy mit lehet mondani 2019-ben a Docker-képek összegyűjtéséről, amikor mindenki tud írni Dockerfile-okat és elindítani docker build?.. Вот нюансы, на которые хотелось бы обратить внимание:
- A kép mérete fontos, ezért használj , hogy csak a szükséges dolgokat hagyd a képen az alkalmazás működéséhez.
- A rétegek számát minimalizálni kell, egymással összefüggő parancsok láncolásával.
RUN-ban. - Ez azonban új problémákat generál a hibakeresés során, mert hiba esetén meg kell keresni azt a parancsot a láncban, amelyik a problémát okozta.
- Az összegyűjtés sebessége fontos, mert gyorsan szeretnénk kiadni a változtatásokat és látni az eredményt. Például nem szeretnénk minden alkalmazásépítésnél átkonfigurálni a könyvtárak függőségeit.
- Gyakran egy Git-repositóriumból sok kép szükséges, amit Dockerfile-ok készletével (vagy elnevezett szakaszokkal egy fájlban) és Bash-skripttel, azok sorozatos összegyűjtésével lehet megoldani.
Ez csak a jéghegy csúcsa, amellyel mindenki találkozik. De vannak más problémák is, különösen:
- Gyakran az összegyűjtési szakaszban szükségünk van valamire csatolásra (például egy külső könyvtárban cache-elni az apt ütközésének eredményét).
- Azt szeretnénk, hogy Ansible ahelyett, hogy shell-en írnánk.
- Azt szeretnénk, hogy nélkül építeni Dockerrel (miért lenne szükségünk egy plusz virtuális gépre, amit mindennek be kell állítani, amikor már létezik egy Kubernetes klaszter, amiben tárolókat futtathatunk?).
- Párhuzamos építés, amelyet különbözően lehet értelmezni: különböző parancsok a Dockerfile-ban (ha multi-stage-t használnak), egy repozitórium több commitja, több Dockerfile.
- Elosztott build: olyan dolgokat akarunk buildelni a podokban, amelyek „efemerek”, mivel elvesztik a cache-t, tehát azt valahol külön kell tárolni.
- Végül a kívánságok csúcsát megneveztem automágiának: tökéletes lenne belépni a repozitóriumába, beírni egy parancsot, és megkapni a kész képet, amelyet úgy állítottak össze, hogy tudja, hogyan és mit kell helyesen csinálni. Azonban személy szerint nem vagyok biztos abban, hogy minden árnyalatot így le lehet fedni.
És itt vannak a projektek:
- — a Docker Inc. buildere (már integrálva a legfrissebb Docker verziókba), amely próbálja megoldani ezeket a problémákat;
- — a Google buildere, amely lehetővé teszi a buildelést Docker nélkül;
- — a CNCF kísérlete az automágiával, különösen egy érdekes megoldás a layer rebase-hez;
- és még sok más hasznos eszköz, mint például , …
… és nézd meg, hány csillagjuk van GitHub-on. Tehát, egyrészt, docker build van, és tud valamit csinálni, de a valóságban a kérdés nem megoldott teljesen — ezt bizonyítja a párhuzamosan fejlődő alternatív builderek létezése, amelyek mindegyike egy bizonyos részét próbálja megoldani a problémáknak.
Buildelés a werf-ben
Így eljutottunk (korábban mint dapp) — a „Flant” cég Open Source eszköze, amelyet már évek óta fejlesztünk. Minden öt évvel ezelőtt kezdődött Bash-szkriptek írásával, amelyek optimalizálták a Dockerfile-ok buildelését, és az utolsó három évben teljes körű fejlesztés folyik egy projekten belül, saját Git-repozitóriummal (először Ruby-ban, majd Go-ra, és egyúttal átneveztük). Milyen buildelési kérdéseket old meg a werf?
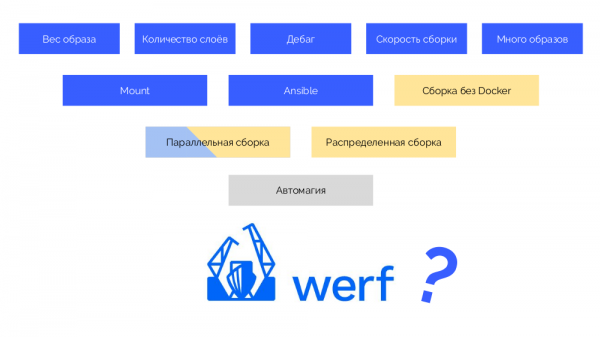
A kékkel jelölt problémák már megvalósultak, a párhuzamos build egy hoszton belül megvalósult, a sárgával kiemelt kérdéseket pedig a nyár végére tervezzük befejezni.
Registry-be való publikálás szakasza
Megadtuk docker push… — mi lehet olyan bonyolult abban, hogy feltöltsük a képet a registry-be? És itt felmerül a kérdés: „Milyen címkét adjunk a képnek?” Ez a kérdés abból fakad, hogy van nekünk Gitflow (vagy más Git-stratégia) és Kubernetes, és az iparág arra törekszik, hogy ami a Kubernetes-ben történik, az kövesse azt, amit Git-ben csinálunk. Hiszen a Git a mi egyetlen valóságbesorolásunk.
Mi ebben a nehéz? A reprodukálhatóság garantálása: a GIT commit, which is inherently immutable (immutable), to a Docker image that must be preserved in the same way.
It is also important for us to determine the origin, because we want to understand which commit the application running in Kubernetes was built from (then we can make diffs and similar things).
Tagging Strategies
The first is a simple git tag. We have a registry with an image tagged as 1.0. In Kubernetes there is a stage and production where this image is deployed. In Git we make commits and at some point we put a tag 2.0. We build it according to the instructions from the repository and place it in the registry with the tag 2.0. We roll it out to stage and, if everything is fine, then to production.
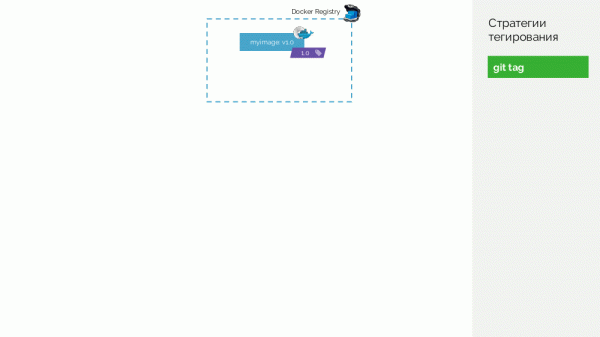
The problem with this approach is that we tagged first, and only then tested and rolled out. Why? First, it is just illogical: we issue a version of the software that we haven’t even checked yet (we can’t do otherwise, as a tag needs to be applied to verify). Second, this approach doesn’t align with Gitflow.
The second option is git commit + tag. In the master branch there is a tag 1.0; for it in the registry is the image deployed in production. In addition, there are preview and staging environments in the Kubernetes cluster. Then we follow Gitflow: in the main branch for development (develop) we create new features, resulting in a commit with the ID #c1. We build it and publish it in the registry using this ID (#c1). With the same ID we roll it out to preview. Similarly, we do with the commits #c2 és #c3.
Once we understand that there are enough features, we start stabilizing everything. In Git, we create a branch release_1.1 (based on #c3 a develop). This release doesn’t need to be built, as it was done in the previous step. Therefore, we can just roll it out to staging. We fix bugs in #c4 and similarly roll it out to staging. Meanwhile, development is taking place in develop, where changes from release_1.1are periodically merged. At some point, we obtain a built and deployed commit on staging that we are satisfied with (#c25).
Then we merge (with a fast-forward) the release branch (release_1.1) into master. We put a tag with the new version on this commit (1.1). But this image has already been built in the registry, so to avoid building it again, we simply add a second tag to the existing image (now it has tags #c25 és 1.1). After this, we roll it out to production.
There is a downside that one image is deployed on staging (#c25), while production has another one (1.1), de tudjuk, hogy fizikailag ez ugyanaz a kép a registryből.
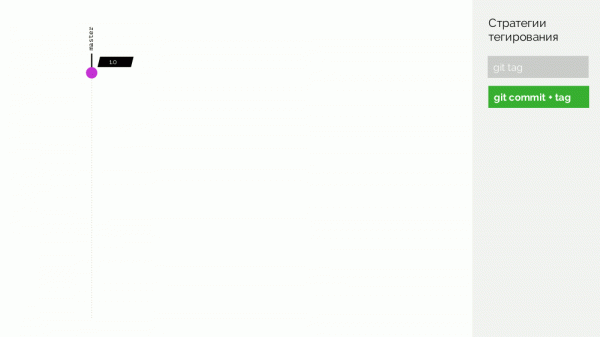
Az igazi hátrány viszont az, hogy nincs támogatás a merge commitokhoz, fast-forwardot kell csinálni.
Elmehetünk tovább, és megcsinálhatunk egy trükköt… Nézzünk meg egy egyszerű Dockerfile-t:
FROM ruby:2.3 as assets
RUN mkdir -p /app
WORKDIR /app
COPY . ./
RUN gem install bundler && bundle install
RUN bundle exec rake assets:precompile
CMD bundle exec puma -C config/puma.rb

FROM nginx:alpine
COPY --from=assets /app/public /usr/share/nginx/www/public
Létrehozunk egy fájlt az alábbi elv alapján, hogy veszünk:
- SHA256-ot az használt képek azonosítóiból (
ruby:2.3ésnginx:alpine), amelyek az tartalom ellenőrző összegei; - minden parancs (
RUN,CMDigazság szerint. - SHA256-ot a hozzáadott fájlokról.
… és vegyük az ellenőrző összeget (ismét SHA256) erről a fájlról. Ez egy aláírás minden, ami a Docker-kép tartalmát meghatározza.
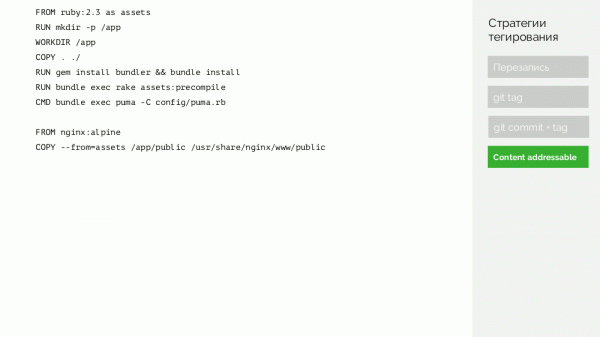
Térjünk vissza a sémához, és a commitok helyett használjunk ilyen aláírásokat,, azaz az aláírásokkal címkézzük a képeket.
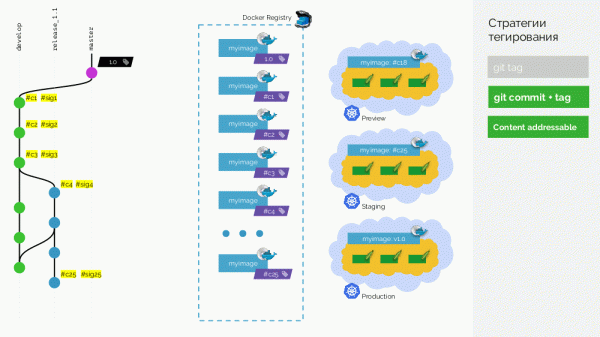
Most, amikor szükség lesz például a változások 'merge'-elésére a release-ből a masterbe, valódi merge commitot csinálhatunk: más azonosítója lesz, de ugyanaz az aláírás. Ugyanazzal az azonosítóval kiadjuk a képet a production-re.
A hátránya, hogy most már nem tudjuk meghatározni, hogy melyik commit került a production-ra — az ellenőrző összegek csak egy irányba működnek. Ezt a problémát egy kiegészítő réteggel oldjuk meg metadatákkal — erről később részletesebben beszélek.
Címkézés a werf-ben
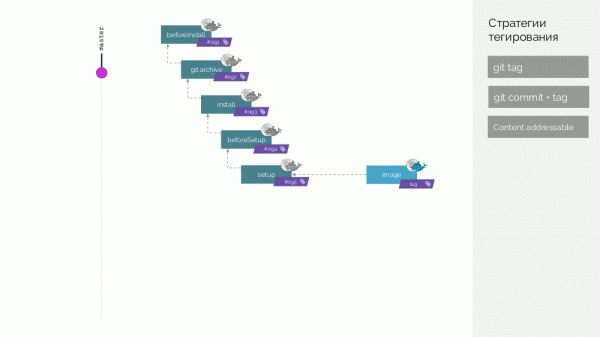
A werf-ben még tovább mentünk, és készülünk egy elosztott építésre úgy, hogy a cache nem egy gépen tárolódik… Tehát, kétféle Docker-képet készítünk, amelyeket stage és kép.
A werf Git-tárolójában specifikus építési utasítások találhatók, amelyek a különböző építési lépéseket írják le (beforeInstall, install, beforeSetup, setup). Az első stage-képet azzal az aláírással készítjük el, amelyet az első lépések ellenőrző összegeként határozunk meg. Ezután hozzáadjuk a forrást, az új stage-képhez kiszámítjuk a kontrollt… Ezek a műveletek minden egyes lépésnél megismétlődnek, aminek eredményeként egy stage-képekből álló halmazt kapunk. Ezután létrehozzuk az utolsó image-képet, amely tartalmazza az eredetéről szóló metadatákat is. Ezt a képet különböző módokon címkézzük (részletek később).
Hadd el jön egy új commit, amelyben csak az alkalmazás kódját módosították. Mi történik? A kódmódosításokhoz patch készül, amihez új stage-image jön létre. Ennek az aláírása az oldószer kép (stage-image) régi ellenőrzőösszeg és az új patch ellenőrzőösszegének összegzésére lesz meghatározva. Ebből az image-ből fog formálódni az új végső image.
Így a stage-images olyan cache, amelyet elosztva lehet tárolni, és az abból létrejövő image-ek a Docker Registry-be kerülnek.
A registry tisztítása
Nem a régi tagek után megmaradt rétegek eltávolításáról van szó — ez a Docker Registry alapértelmezett képessége. Azzal a helyzettel fogunk foglalkozni, amikor rengeteg Docker-taget halmozunk fel, és felmerül, hogy ezek egy része már nem szükséges, és helyet foglal (és/vagy ezért fizetünk).
Milyen tisztítási stratégiák léteznek?
- Egyszerűen nem csinálni semmit nem tisztítani. Néha valóban egyszerűbb egy kicsit többet fizetni a felesleges helyért, mint kibogozni egy hatalmas gubancot a tagekből. De ez csak egy bizonyos pontig működik.
- Teljes reset. Ha minden képet törlünk, és csak az aktuálisakat építjük újra a CI-rendszerben, akkor problémák merülhetnek fel. Ha a production-on újraindul egy konténer, akkor új kép fog betöltődni, amelyet még senki sem tesztelt. Ez megöli az immutable infrastructure ötletét.
- Blue-green. Ha az egyik registry kezd megtelni — képeket töltünk fel a másikba. Ugyanez a probléma a korábbi módszerrel: mikor tisztíthatjuk meg a registry-t, ami megtelt?
- Időben. Töröljük az összes 1 hónapnál régebbi képet? De biztosan lesz egy szolgáltatás, ami már egy hónapja nem frissült...
- Kézi meghatározni, mi az, ami már eltávolítható.
Valójában két életképes lehetőség van: nem tisztítani, vagy egy blue-green + kézi kombinációt alkalmazni. Az utóbbi esetben arról van szó, hogy amikor tudjuk, hogy itt az idő a registry tisztítására, új registry-t hozunk létre, és minden új képet hozzáadunk a következő, például egy hónap során. A hónap végén megnézzük, hogy mely podok a Kubernetes-ben még mindig az öreg registry-t használják, és azokat is átkonvertáljuk az új registry-be.
Hova jutottunk werf? Мы собираем:
- Git head: minden tag, minden ágon, — feltételezve, hogy amit Git-ben megjelöltünk, arra szükség van az image-ekben (ha nem, akkor törölni kell a Git-ben);
- minden pod, amelyeket most kihúznak a Kubernetesből;
- régi ReplicaSetek (amit nemrégiben húztak ki), valamint a Helm-kiadásokat tervezzük beolvasni és kiválasztani a legújabb képeket ott.
… és ebből a készletből whitelistet készítünk - azoknak a képeknek a listája, amelyeket nem fogunk törölni. Minden más, amely nem szerepel a listában, törlésre kerül, majd megtaláljuk az árván maradt stage-képeket és azokat is eltávolítjuk.
Kibocsátási szakasz (deploy)
Megbízható deklarativitás
Az első dolog, amit figyelembe kell venni a kibocsátás során, az a frissített erőforrás-konfiguráció kiadása, amelyet deklaratívan hirdetnek. Az eredeti YAML-dokumentum, amely a Kubernetes-erőforrásokat írja le, mindig jelentősen eltér a klaszterben való tényleges működéstől. Mivel a Kubernetes hozzáad a konfigurációhoz:
- azonosítók;
- segédinformációk;
- számos alapértelmezett érték;
- szakasz a jelenlegi státuszról;
- változtatások, amelyeket az admission webhook használatakor hajtottak végre;
- különböző vezérlők (és ütemezők) munkájának eredménye.
Ezért, amikor új erőforrás-konfiguráció jelenik meg (new), nem tudjuk egyszerűen felülírni a jelenlegi, „élethű” konfigurációt (live). Ehhez össze kell hasonlítanunk new a múltban alkalmazott konfigurációval (last-applied) és alkalmaznunk kell live a kapott javítást.
Ezt a megközelítést 2-way merge-nak hívják. Például a Helm használja.
Van egy másik is, 3-way merge, amely abban különbözik, hogy:
- a hasonlítás során megnézzük, mi lett eltávolítva; last-applied és newmegnézzük, mi lett hozzáadva vagy megváltoztatva;
- a hasonlítás során megnézzük, mi lett eltávolítva; new és livea szintetizált javítást a megfelelő helyre alkalmazzuk.
- Több mint 1000 alkalmazást telepítünk Helm használatával, ezért valójában élethosszig 2-way merge módszerrel élünk. Azonban ennek számos problémája van, amelyeket saját javításainkkal oldottunk meg, hogy a Helm megfelelően működjön. live.
A kiadás valódi állapota
Miután a CI-rendszerünk egy új konfigurációt generált a Kubernetes számára, azt alkalmazásra küldi
(apply) a klaszterre - Helm segítségével vagy . Ezután már a már leírt N-way merge zajlik, amire a Kubernetes API jóváhagyólag válaszol a CI-rendszernek, amely ezután a felhasználójának. kubectl applyDe van egy hatalmas probléma: a
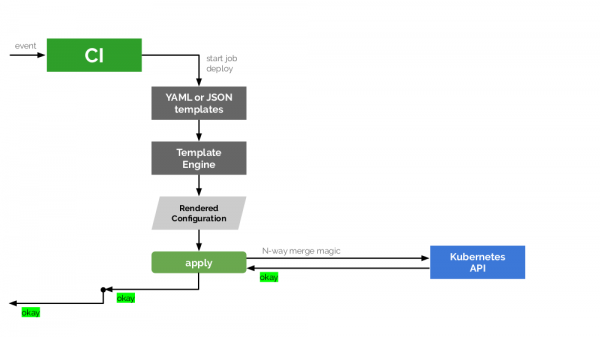
sikeres alkalmazás nem jelenti azt, hogy a kiadás is sikeres . Ha a Kubernetes megértette, hogy milyen változtatásokat kell alkalmazni, alkalmazza őket - még mindig nem tudjuk, mi lesz ennek az eredménye. Például a frontenden a podok frissítése és újraindítása sikeresen végbemegy, de a backendben nem, és eltérő verziókat kapunk az indított alkalmazáskép verziókból..
Ahhoz, hogy mindent helyesen csináljunk, ebbe a sémába egy további láncszem szükséges – egy speciális tracker, amely a Kubernetes API-tól kap információt az állapotról és azt továbbítja a valós helyzet további elemzésére. Létrehoztunk egy Open Source könyvtárat Go nyelven – (lásd a bejelentését ), – amely ezt a problémát megoldja, és beépítve van a werf-be.
Ennek a trackernek a működése a werf szintjén annotációk segítségével konfigurálható, amelyeket a Deploymentekre vagy StatefulSetekre helyeznek el. A fő annotáció – fail-mode – a következő értékeket érti:
-
IgnoreAndContinueDeployProcess– figyelmen kívül hagyjuk a komponens telepítési problémáit, és folytatjuk a telepítést; -
FailWholeDeployProcessImmediately– egy hiba ebben a komponensben leállítja a telepítési folyamatot; -
HopeUntilEndOfDeployProcess– reméljük, hogy ez a komponens működni fog a telepítés végére.
Például, egy ilyen kombináció a források és annotációk értékeiből fail-mode:
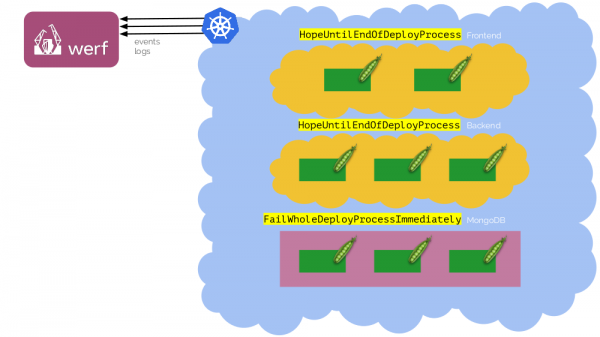
Amikor először telepítünk, lehet, hogy az adatbázis (MongoDB) még nem áll készen – a Deploymentek leállnak. De meg lehet várni a pillanatot, amikor elindul, és a telepítés mégis sikerül.
Van még két annotáció a kubedog számára a werf-ben:
-
failures-allowed-per-replica– az egyes replikákra engedélyezett bukások száma; -
show-logs-until– szabályozza azt a pillanatot, ameddig a werf megjeleníti (stdout-ban) a naplókat az összes telepített podból. Alapértelmezés szerint ezPodIsReady(hogy figyelmen kívül hagyjuk az üzeneteket, amelyek valószínűleg nem szükségesek, amikor a pod elkezd traffikot kapni), azonban megengedettek az alábbi értékek is:ControllerIsReadyésEndOfDeploy.
Mit szeretnénk még a telepítéstől?
A már említett két ponton kívül szeretnénk:
- látni naplókat – csak a szükségeseket, nem mindent;
- nyomon követni a haladást,mert ha a feladat "csendben" lóg néhány percig, fontos megérteni, mi történik ott;
- rendelkezni automatikus visszagörgetéssel arra az esetre, ha valami rosszul sülne el (ezért kritikus tudni a telepítés valós állapotát). A telepítésnek atomárisnak kell lennie: vagy végigmegy, vagy minden visszatér az előző állapotba.
Összegzés
Cégként, hogy megvalósítsuk az összes említett részletet a különböző szállítási fázisokban (build, publish, deploy), elegendő egy CI-rendszer és egy eszköz. .
Összegzésül:
A werf segítségével jelentős előrelépést tettünk a DevOps mérnökök számos problémájának megoldásában, és örülnénk, ha egy szélesebb közösség legalább kipróbálná ezt az eszközt a gyakorlatban. Közösen könnyebb jó eredményeket elérni.
Videók és diák
Előadás videó (~47 perc):
Előadás bemutatása:
P.S.
További előadások a Kubernetesről blogunkban:
- «» (Dmitrij Stoljarov; 2019. április 27. a „Stachki” rendezvényen);
- «» (Andrej Polovov; 2019. április 8. a Saint HighLoad++ rendezvényen);
- «» (Dmitrij Stoljarov; 2018. november 8. a HighLoad++ rendezvényen);
- «» (Dmitrij Stoljarov; 2018. május 28. a RootConf rendezvényen);
- «» (Dmitrij Stoljarov; 2017. november 7. a HighLoad++ rendezvényen);
- «» (Dmitrij Stoljarov; 2017. június 6. a RootConf rendezvényen).
Forrás: habr.com
