

A naplók a rendszer fontos részét képezik, lehetővé téve, hogy megértsük, működik-e (vagy sem) az elvárásoknak megfelelően. A mikroszervíz architektúra körülményei között a naplók kezelése külön diszciplínává válik, amely különös kihívások elé állít minket.
- hogyan írjunk naplókat az alkalmazásból;
- hová írjunk naplókat;
- hogyan szállítsuk a naplókat tárolásra és feldolgozásra;
- hogyan dolgozzuk fel és tároljuk a naplókat.
A korszerű konténerizációs technológiák alkalmazása még több nehézséget jelent a megoldás keresésében.
Erről szól Yuri Bushmelev előadása, a "Naplógyűjtés és -szállítás nehézségei"
Akiket érdekel, azokat kérem, hogy tartsanak velem.
A nevem Yuri Bushmelev. A Lazadánál dolgozom. Ma arról fogok beszélni, hogyan készítjük el a naplóinkat, hogyan gyűjtjük őket, és mit írunk beléjük.
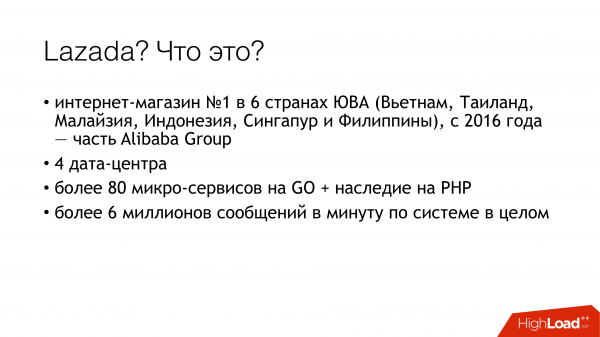
Honnan jövünk? Kik vagyunk? A Lazada a legnagyobb online bolt a Délkelet-Ázsia hat országában. Ezek az országok adatközpontokra vannak elosztva. Jelenleg négy adatközpontunk van. Miért fontos ez? Mert néhány megoldásunkat az indokolta, hogy az adatközpontok között gyenge kapcsolatok vannak. Mikroszervíz architektúránk van, és meglepetten tapasztaltam, hogy már 80 mikroszervizünk van. Amikor elkezdtem a naplókkal foglalkozni, csak 20 volt belőlük. Ezen kívül van elég sok régi PHP kódunk, amivel szintén foglalkozni kell. Mindez jelenleg több mint 6 millió üzenetet generál percenként az egész rendszerben. Most megmutatom, hogyan élünk ezzel együtt, és miért fontos ez.
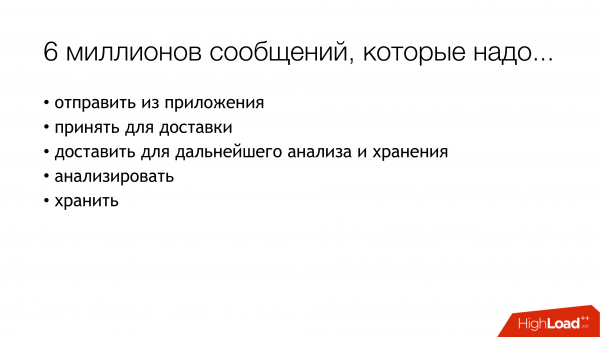
Ezekkel a 6 millió üzenettel valahogy élnünk kell. Mit kell tennünk velük? 6 millió üzenetet kell:
- el küldeni az alkalmazásból
- átvenni a szállításhoz
- szállítani az elemzéshez és tároláshoz.
- elemezni
- valahogy tárolni.
Amikor hárommillió üzenet jött létre, körülbelül így néztem ki. Mert néhány fillérrel kezdtünk. Nyilvánvaló, hogy erre alkalmazási naplókat írnak. Például nem tudott csatlakozni az adatbázishoz, csatlakozott az adatbázishoz, de nem tudott valamit olvasni. De ezen kívül minden mikroszolgáltatásunk ír egy access-naplót is. Minden egyes kérés, ami a mikroszolgáltatáshoz érkezik, bekerül a naplóba. Miért csináljuk ezt? A fejlesztők szeretnék nyomon követni az eseményeket. Minden access-naplóban van egy traceid mező, amellyel egy speciális interfész visszafejti az összes láncot, és szépen megjeleníti a trace-t. A trace mutatja, hogyan zajlott a kérés, és ez segít a fejlesztőinknek gyorsabban megbirkózni a fura dolgokkal.
Hogyan éljünk ezzel? Most dióhéjban elmondom az opciók mezőjét – hogyan oldják meg egyáltalán ezt a problémát. Hogyan lehet megoldani a naplók gyűjtésének, továbbításának és tárolásának feladatát.
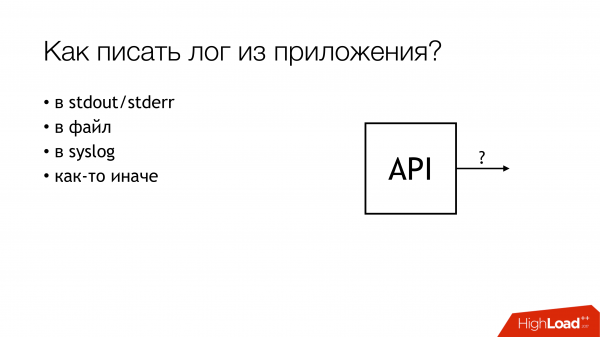
Hogyan írjunk az alkalmazásból? Nyilvánvaló, hogy különböző módszerek léteznek. Különösen létezik best practice, ahogy a divatos ismerősök mondják. Van old school, kétféle változatban, ahogy a nagyapák mesélték. Vannak más módszerek is.
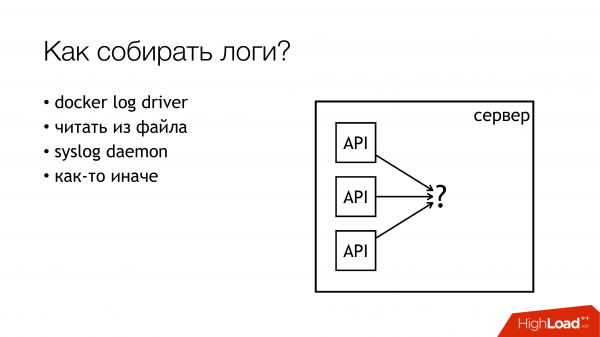
A naplók gyűjtésével körülbelül hasonló a helyzet. Ennek a konkrét részének a megoldási lehetőségei nem túl sokan vannak. Több van már, de még nem túl sok.
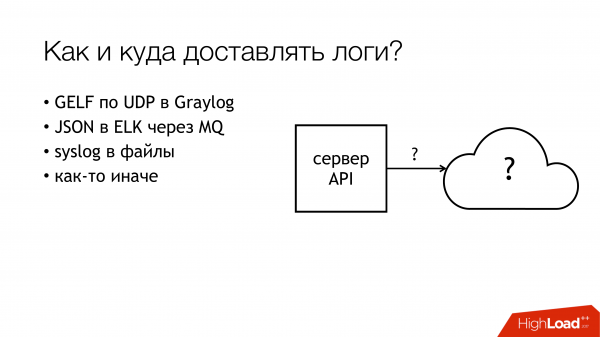
De a szállítással és a további elemzéssel kapcsolatban – a variációk száma kezd elszabadulni. Most nem fogom részletezni minden lehetőséget. Azt hiszem, az alapvető opciók mindenki számára ismertek, aki érdeklődött a téma iránt.
Megmutatom, hogyan csináltuk ezt a Lazadánál, és hogy valójában hogyan indult az egész.
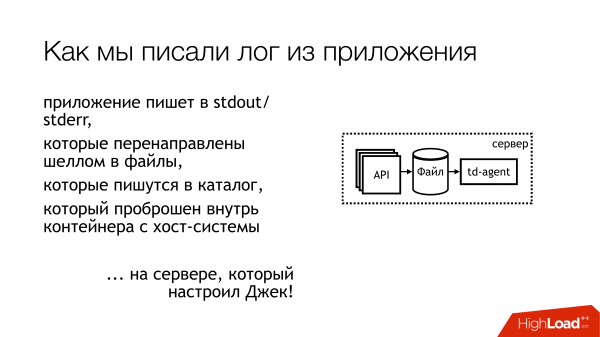
Egy évvel ezelőtt érkeztem a Lazadához, és elküldtek egy projektre, ami a naplókkal foglalkozott. Körülbelül így nézett ki. A napló az alkalmazásból stdout-ra és stderr-re íródott. Minden divatosan készült. De aztán a fejlesztők kiszórták a standard folyamokból, és azt mondták, hogy majd az infrastruktúra-specialisták kezelik. Az infrastruktúra-specialisták és a fejlesztők között még voltak kiadásért felelősök, akik azt mondták: „ööö… hát jó, dobtuk őket csak simán egy fájlba shell-el, és kész”. Mivel ez mind konténerben volt, ezért közvetlenül a konténerben zárták be, átmapelték belső mappát, és oda tették. Azt gondolom, hogy mindenkinek körülbelül nyilvánvaló, hogy mi lett belőle.
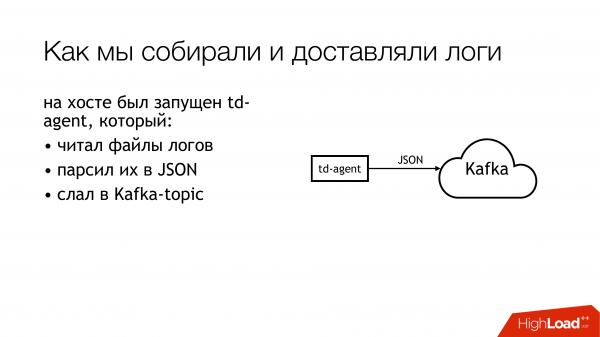
Nézzük meg egy kicsit távolabbról. Hogyan szállítottuk ezeket a naplókat. Valaki a td-agentet választotta, ami valójában a fluentd, de nem teljesen fluentd. Soha nem értettem meg e két projekt viszonyát, de úgy tűnik, egy és ugyanaz. A Rubyban írt fluentd a naplófájlokat olvasta, JSON-ba parse-olta őket valamilyen reguláris kifejezések alapján. Aztán elküldte őket a Kafka-ba. Ráadásul a Kafka-ban minden API-hoz négy különböző topikunk volt. Miért négy? Mert van élő (live), van teszt (staging), és mert van stdout és stderr. A fejlesztők szaporítják őket, az infrastruktúráért felelősöknek pedig létre kell hozniuk őket a Kafka-ban. Ráadásul a Kafka-t egy másik osztály irányította. Ezért jegyet kellett nyitni, hogy ők létrehozzák ott a négy topikot minden API-ra. Mindenki elfelejtette ezt. Általában tök káosz volt.
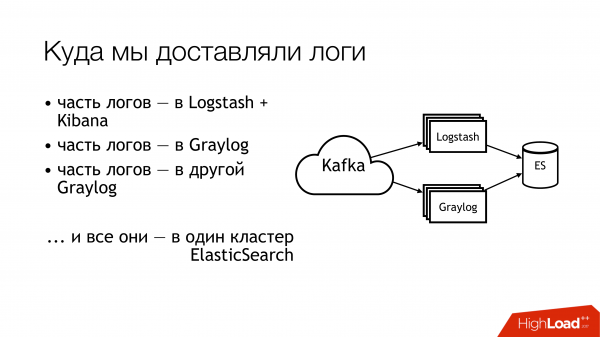
Mit csináltunk ezután? Ezt elküldtük a Kafkába. A Kafkából a naplók fele a Logstash-be ment. A naplók másik fele megoszlott. Egy része az egyik Graylogba, a másik egy másik Graylogba ment. Végül ez az egész egy Elasticsearch klaszterbe került. Tehát az egész ez a káosz végül oda esett. Ezt nem így kell csinálni!
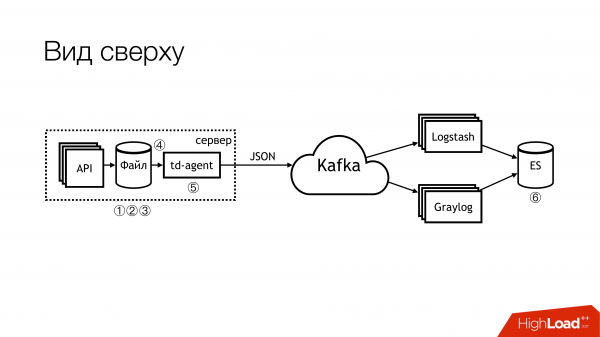
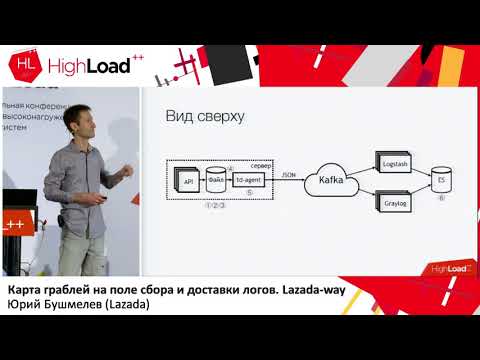
Így néz ki, ha távolról felülről nézzük. Ezt ne csináld! Itt számokkal azonnal meg vannak jelölve a problémás helyek. Valójában több van, de 6 közvetlenül problémás, amivel valamit kell csinálni. Ezekről most külön mesélek.
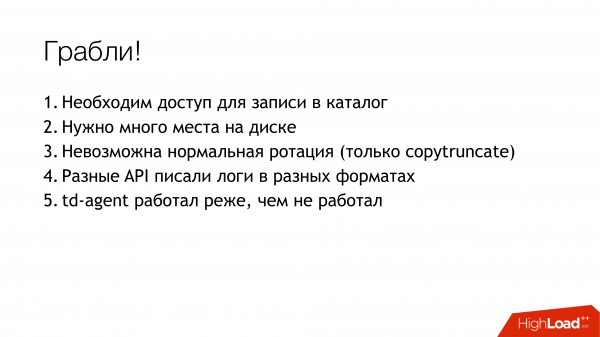
Itt (1,2,3) fájlokat írunk és ennek megfelelően itt azonnal három csapda van.
Az első (1) az, hogy valahova írniuk kell. Nem mindig szeretnénk hagyni, hogy az API közvetlenül fájlba írjon. Jobb, ha az API egy konténerben van izolálva, és még jobb, ha csak olvasható (read-only). Én rendszergazda vagyok, ezért egy kicsit alternatívabban látom ezeket a dolgokat.
A második pont (2,3) — sok kérés érkezik az API-nkba. Az API sok adatot ír egy fájlba. A fájlok növekednek. Őket rotálnunk kell. Mert különben nem lesz elég lemezterület. Rotálni őket nehéz, mert átirányítással készülnek shellen keresztül a könyvtárban. Nem tudjuk rotálni. Nem lehet megmondani az alkalmazásnak, hogy nyissa meg újra a leírókat. Mert a fejlesztők úgy néznek rád, mint egy bolondra: "Milyen leírókról beszélsz? Mi a stdout-ba írunk." Az infrastruktúra csapat létrehozta a copytruncate funkciót a logrotate-ban, ami egyszerűen másolatot készít a fájlról és átrendezi az eredetit. Ennek megfelelően, a másolás közben általában elfogy a lemezterület.
(4) Különböző formátumok voltak különböző API-inkban. Kicsit eltértek egymástól, de különböző regexp-eket kellett írni. Mivel ezt az egészet a Puppet irányította, ott volt egy nagy csomó osztály saját bogaraival. Plusz a td-agent a legtöbb időt memóriát ehettett, akadozhatott, és csak úgy tehetett, mintha működne, de valójában semmit sem csinált. Kívülről lehetetlen volt megérteni, hogy nem csinál semmit. A legjobb esetben összeomlott, és valaki majd feléleszti. Pontosabban, érkezett egy figyelmeztetés, és valaki majd manuálisan újraindítja.
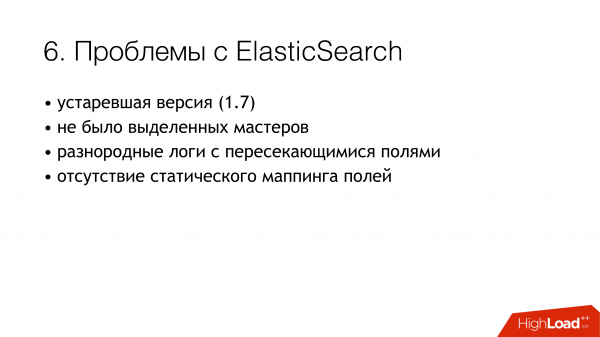
(6) És a legrosszabb pont az elasticsearch volt. Mert ez egy régi verzió volt. Mert ebben az időben nem voltak dedikált mesterek. Különböző naplóink voltak, ahol a mezők átfedésben lehettek. Különböző alkalmazások naplói azonos mezőnevekkel íródtak, de belül különböző adatokkal. Tehát, egy napló például Integer-t kap a level mezőbe. Egy másik napló Stringet kap a level mezőbe. Statikus térképezés nélkül egy csodálatos probléma születik. Ha az elasticsearch index rotálása után az első üzenet Stringgel érkezett, akkor rendben vagyunk. De ha az első Integer-rel érkezett, akkor minden következő üzenet, amely Stringgel érkezett, egyszerűen el lesz vetve. Mert a mező típusa nem egyezik.
Kezdtünk foglalkozni ezekkel a kérdésekkel. Úgy döntöttünk, hogy nem keresünk bűnbakokat.
Valamit tennünk kell! Nyilvánvaló dolog, hogy szabványokat kell bevezetni. Néhány szabványunk már volt. Néhányat később vezettünk be. Szerencsére a logok egységes formátumát minden API számára már annak idején jóváhagyták. Ez benne van a szolgáltatások közötti együttműködés szabványaiban. Tehát, aki logokat akar kapni, annak ebben a formátumban kell írnia őket. Ha valaki nem ír logokat ebben a formátumban, akkor nem garantálunk semmit.
Ezután szeretnénk bevezetni egy egységes szabványt a logok írásának, szállításának és gyűjtésének módjaira. Tulajdonképpen arról van szó, hova írjuk őket, és mivel szállítjuk. Az ideális helyzet az, amikor a projektekben ugyanazt a könyvtárat használják. Van egy külön logolási könyvtár a Go-hoz, van egy külön könyvtár a PHP-hoz. Akik nálunk vannak – mindenkinek ezt kell használnia. Jelenleg azt mondanám, hogy ennek 80%-át teljesítjük. De néhányan továbbra is kaktuszokat esznek.
És ott (a dián) alig-alig kezd megjelenni a „logok szállítására vonatkozó SLA”. Még nincs, de dolgozunk rajta. Mert nagyon kényelmes, amikor az infrastruktúra azt mondja, hogy ha ilyen formátumban írsz egy adott helyre, és nem több N üzenetet másodpercenként, akkor ezt egy bizonyos valószínűséggel odajuttatjuk. Ez rengeteg fejfájást megkönnyít. Ha van SLA, az nagyszerű!
Hogyan kezdtük el megoldani a problémát? A fő probléma a td-agent volt. Nem volt világos, hová tűnnek a logok. Megérkeznek? Gyűjtődnek? Hol vannak egyáltalán? Ezért az első lépés az volt, hogy a td-agentet cseréljük le. Röviden összefoglalva, itt néhány lehetőség van, amire lecserélhetjük.
Fluentd. Először is, már találkoztam vele korábbi munkahelyemen, és ott is időnként leállt. Másodszor, ez is ugyanaz, csak más irányból.
Filebeat. Mivel volt kényelmes számunkra? Azért, mert Go nyelven készült, nekünk pedig nagy tapasztalatunk van a Go-ban. Tehát ha szükség van rá, valami módon át tudtuk írni. Ezért nem választottuk. Hogy még csak kísértést se érezzünk, hogy elkezdjük átdolgozni magunknak.
Nyilvánvaló megoldás a rendszergazdák számára a különböző rendszernaplók (syslog-ng/rsyslog/nxlog) ilyen mennyiségben.
Vagy írni valamit saját kezűleg, de ezt elvetettük, akárcsak a filebeatot. Ha valamit írni, akkor inkább valami hasznosat az üzlet számára. A logok szállításához jobb, ha valami kész megoldást veszünk.
Így a választás lényegében az syslog-ng és az rsyslog közötti választásra szűkült. Az rsyslog mellett döntöttem, egyszerűen azért, mert a Puppet-ben már voltak az rsyslog-hoz osztályaink, és nem találtam nyilvánvaló különbséget a kettő között. Itt is syslog, ott is syslog. Igen, valakinek a dokumentációja rosszabb, valakinek jobb. Az egyik így tud, a másik pedig úgy.
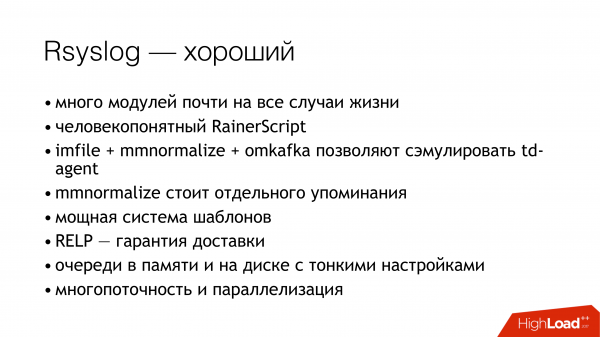
És egy kicsit az rsyslog-ról. Először is, klassz, mert sok modulja van. Az ember számára érthető RainerScript-jével (modern konfigurációs nyelv) rendelkezik. Nagy előny, hogy a beépített eszközökkel szimulálni tudtuk a td-agent viselkedését, és az alkalmazások számára semmi nem változott. Tehát, a td-agent-et átváltottuk rsyslog-ra, míg minden más érintetlen maradt. És azonnal működő szállítást kapunk. Továbbá, az mmnormalize — ez egy fantasztikus dolog az rsyslog-ban. Lehetővé teszi, hogy naplókat elemezzünk, de nem Grok és regexp segítségével. Absztrakt szintaxisfát készít. A naplókat körülbelül úgy elemzi, ahogyan a fordító az forráskódot. Ez nagyon gyors munkát tesz lehetővé, kevés CPU-t fogyaszt, és igazából egy nagyon klassz dolog. Sok más előny is van, de ezen nem állnék meg.
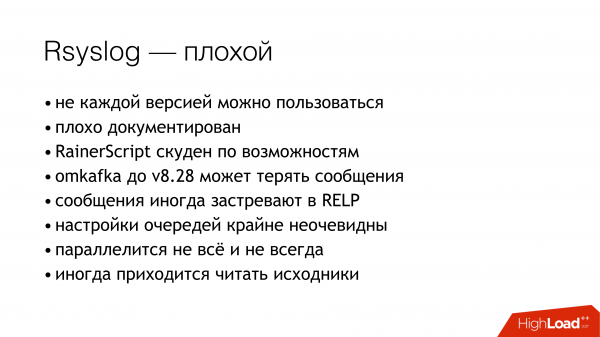
Az rsyslog-nak sok hátránya is van. Ezek nagyjából ugyanazok, mint az előnyök. A fő problémák — tudni kell, hogyan kell elkészíteni, és a megfelelő verziót kell választani.
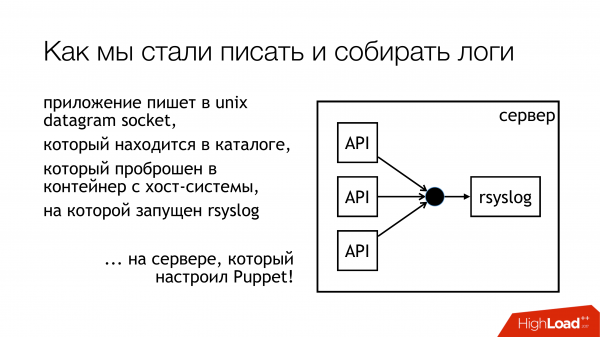
Úgy döntöttünk, hogy unix socket-ba írjuk a naplókat. Ráadásul nem a /dev/log-ba, mert ott egy kaosz van a rendszer naplókból, ott a journald is benne van ebben a folyamatban. Tehát írjunk egy egyedi socket-ba. Csak egy külön szabálykészlettel kötjük hozzá. Nem keverjük össze semmivel. Minden átlátható és érthető lesz. Ezt valójában meg is valósítottuk. A socket-ekhez tartozó könyvtár szabványosított, és minden konténernek elérhető. A konténerek láthatják a szükséges socket-et, megnyithatják és írhatnak rá.
Miért nem fájl? Mert mindenki olvasta , amely megpróbálta átkonfigurálni a fájlt docker-ben, és kiderült, hogy a rsyslog újraindítása után a fájl leírója megváltozik, és a docker elveszíti ezt a fájlt. Valami mást tart nyitva, de már nem azt a socket-et, ahová írnak. Úgy döntöttünk, hogy megkerüljük ezt a problémát, és egyúttal a blokkolás problémáját is.
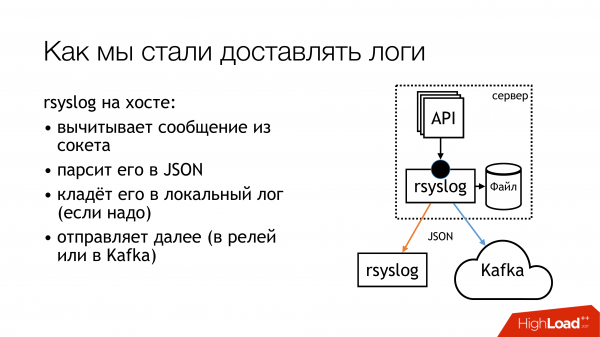
Az rsyslog végrehajtja a dián szereplő műveleteket, és elküldi a naplókat vagy egy relay-be, vagy a Kafka-ba. A Kafka a régi módszernek felel meg. A relay — ez arra irányult, hogy tisztán az rsyslog-ot próbáltam használni a naplók szállítására. Message Queue nélkül, az rsyslog beépített eszközeivel. Elvileg ez működik.
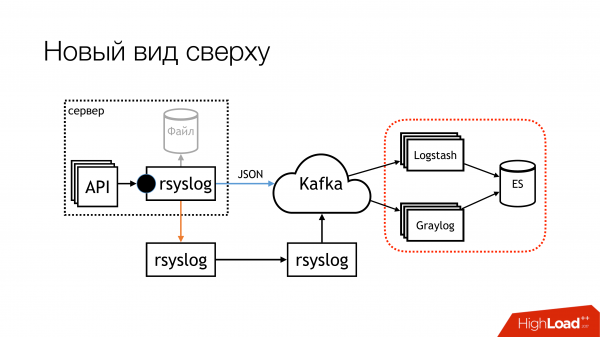
De van néhány árnyalat azzal kapcsolatban, hogyan lehet őket betenni ebbe a részbe (Logstash/Graylog/ES). Ez a rész (rsyslog-rsyslog) a data center-ek között használatos. Itt van egy tömörített TCP link, amely lehetővé teszi a sávszélesség megtakarítását, és így növeli annak valószínűségét, hogy kapunk valamilyen naplót egy másik data center-ből, amikor a csatorna túlterhelt. Mert van Indonézia, ahol minden rossz. Ott ez egy folyamatos probléma.
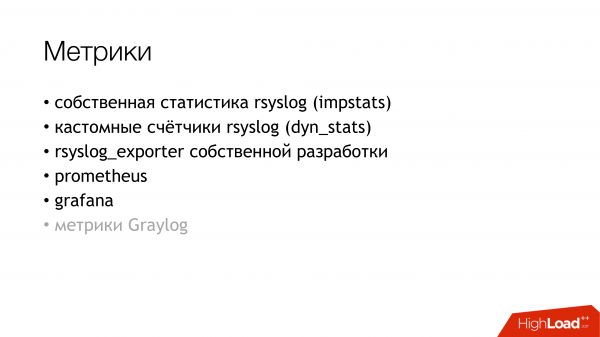
Elgondolkodtunk azon, hogyan tudjuk nyomon követni, hogy a naplók, amelyeket az alkalmazásból rögzítettünk, valóban eljutnak-e a célhoz? Úgy döntöttünk, hogy metrikákat állítunk be. Az rsyslognak van egy statisztikai gyűjtő modulja, amelyben vannak különböző számlálók. Például meg tudja mutatni a sor méretét, vagy hogy hány üzenet érkezett egy bizonyos cselekvés során. Ezekből már lehet valamit levonni. Ezenkívül vannak egyedi számlálók, amelyeket be lehet állítani, és például meg tudja mutatni, hogy egy adott API mennyi üzenetet rögzített. Továbbá, írtam egy rsyslog_exportert Pythonban, és mindezt elküldtük a Prometheusnak, ahol grafikonokat építettünk. Nagyon vágytunk a Graylog metrikáira, de még nem tudtuk beállítani őket.
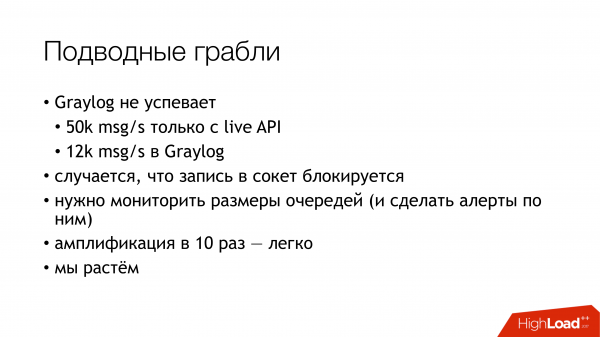
Milyen problémák merültek fel? Problémák adódtak abból, hogy váratlanul felfedeztük, hogy a Live API-jaink másodpercenként 50 ezer üzenetet írnak. Ez csak a Live API, a staging nélkül. A Graylog csak 12 ezer üzenetet mutat másodpercenként. És felmerült a jogos kérdés, hogy hol vannak a többiek? ebből arra következtettünk, hogy a Graylog egyszerűen nem képes kezelni. Megnéztük, és valóban, a Graylog és az Elasticsearch nem tudta elviselni ezt a terhelést.
Következő felfedezések, amelyeket a folyamat során tettünk.
A socketbe írás leáll. Hogyan történt ez? Amikor rsyslogot használtam a kézbesítéshez, egy idő után megszakadt a kapcsolat a data center-ek között. A kézbesítés leállt egy helyen, majd a másikban is. Mindez eljutott az API géphez, amely az rsyslog socketbe ír. Ott kitelt a sor. A UNIX socketbe való írás sor is megtelt, amely alapértelmezés szerint 128 csomagot támogat. A következő write() a programunkban blokkolva lett. Amikor megnéztük a könyvtárat, amelyet a Go alkalmazásokban használunk, azt írták, hogy a socketbe való írás nem blokkoló módban történik. Meg voltunk győződve róla, hogy semmi nem blokkolódik. Mert olvastuk. , amely erről írt. De van egy dolog. Ez a hívás körül egy végtelen ciklus is volt, amely folyamatosan megpróbálta a üzenetet beszúrni a socketbe. Ezt mi nem észleltük. Újra kellett írni a könyvtárat. Azóta többször is változott, de most már megszabadultunk a blokkoktól minden alrendszerben. Ezért le lehet állítani az rsyslogot, és semmi nem fog leállni.
Figyelni kell a sorok méretét, ami segít elkerülni ezeket a buktatókat. Először is, monitorozhatjuk, amikor elkezdünk üzeneteket elveszíteni. Másodszor, figyelhetjük, hogy alapvetően problémáink vannak a kézbesítéssel.
És egy még kellemetlenebb dolog — a mikroszolgáltatásos architektúrában a 10-szeres amplifikáció nagyon könnyen megvalósítható. Nálunk nem sok bejövő kérés érkezik, de a graf alapján, amin ezek az üzenetek futnak, az access naplók miatt valóban körülbelül tízszeresére növeljük a naplók terhelését. Sajnos nem volt időm pontos számokat számítani, de a mikroszolgáltatások ilyenek. Ezt figyelembe kell venni. Jelenleg a naplogyűjtő alrendszer a legterheltebb a Lazadánál.
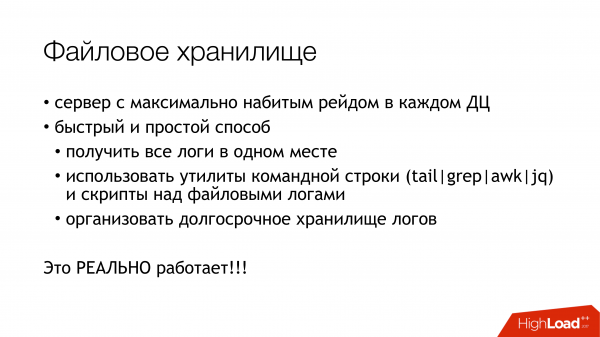
Hogyan lehet megoldani az elasticsearch problémát? Ha gyorsan szeretné megkapni a naplókat egy helyen, hogy ne kelljen kódolás közben az összes gépen keresni, használjon fájltárolót. Ez garantáltan működik. Bármely szerverből elkészíthető. Csak le kell valahogy teríteni a lemezeket és beállítani a syslogot. Utána garantáltan minden napló egy helyen lesz. Aztán nyugodtan beállíthatja az elasticsearch-t, graylog-ot, valami mást. De már meg lesznek az összes naplója, és tárolhatja őket annyira, ameddig a lemezmeghajtók engedik.
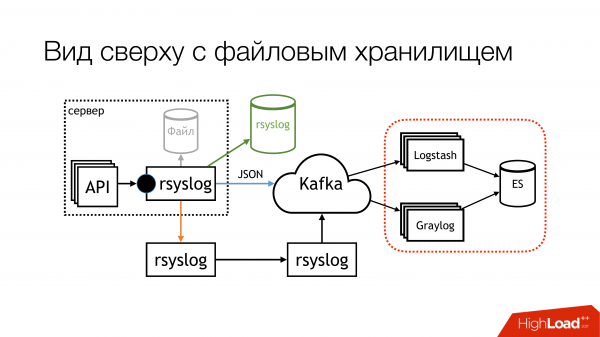
Előadásom időpontjában a séma így nézett ki. Szinte teljesen abbahagytuk a fájlok írását. Jelenleg valószínűleg lekapcsoljuk a maradékokat. A lokális gépeken, ahol az API fut, nem leszünk képesek fájlokat írni. Egyrészt van egy fájltároló, ami nagyon jól működik. Másrészt, ezeken a gépeken folyamatosan elfogy a hely, azt folyamatosan figyelni kell.
Ez a rész a Logstash-sal és Graylog-gal egy kicsit zavaró. Tehát meg kell szabadulnunk tőle. Válasszunk ki valami egyet.
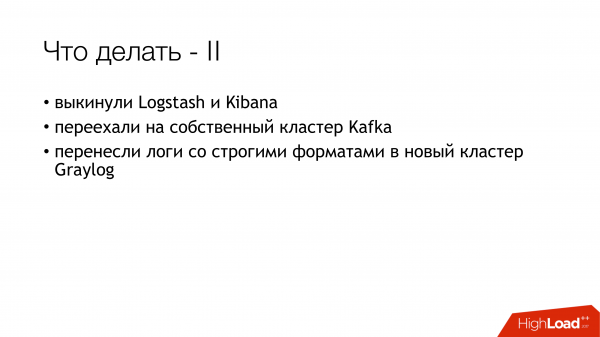
Úgy döntöttünk, hogy elhagyjuk a Logstash-t és a Kibana-t. Mert van biztonsági osztályunk. Mi a kapcsolat? A kapcsolat az, hogy a Kibana X-Pack és Shield nélkül nem teszi lehetővé a naplókhoz való hozzáférési jogok elkülönítését. Ezért választottuk a Graylog-ot. Minden benne van. Nekem nem tetszik, de működik. Új hardvert vásároltunk, friss Graylog-ot állítottunk be rá, és az összes szigorú formátumú naplót külön Graylog-ba helyeztük át. Megoldottuk a problémát az azonos mezők különböző típusaival szervezetileg.
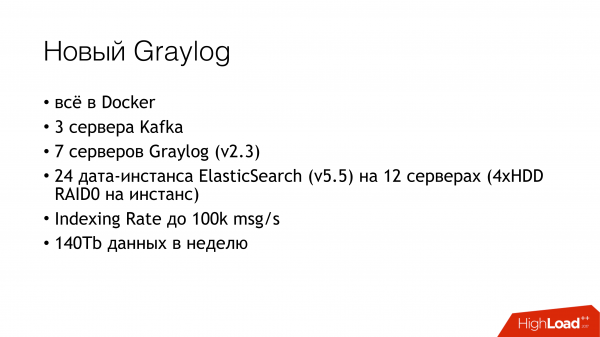
Mit is tartalmaz a new Graylog? Egyszerűen csak mindent megírtunk Dockerbe. Sok szervert vettünk, három Kafka példányt telepítettünk, 7 Graylog szervert 2.3-as verzióval (mivel az Elasticsearch 5-öt akartunk). Az egészet HDD RAID-re telepítettük. 100 ezer üzenet/másodperces indexing rate-et láttunk. Láttunk egy számot, ami 140 terabyte adatot jelentett hetente.
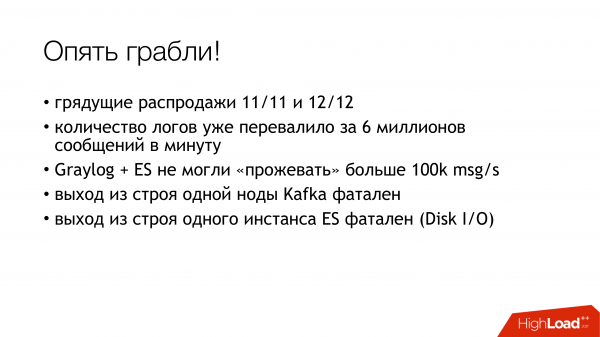
És megint a buktatók! Két leértékelés közelít. Átköltöztünk 6 millió üzenethez. A Graylog-unk nem bírt vele. Valahogy megint túl kell élnünk.
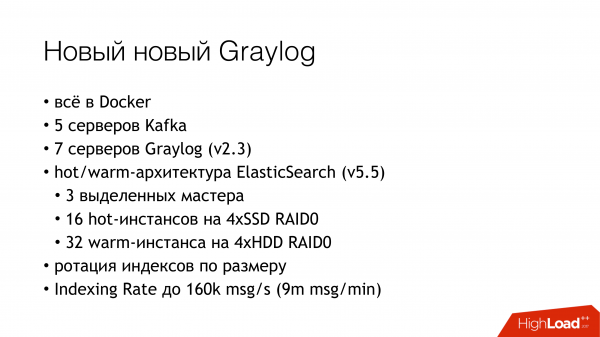
Így túléltünk. Még néhány szervert és SSD-t adtunk hozzá. Jelenleg így élünk. Most már 160 ezer üzenetet dolgozunk fel másodpercenként. Még nem ütköztünk a határba, ezért egyelőre nem világos, hogy valójában mennyit tudunk kihúzni ebből.
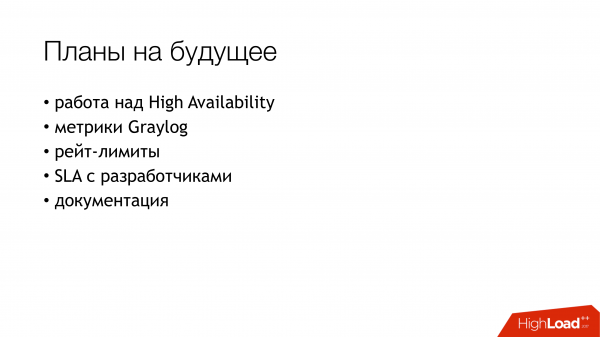
Ilyenek a jövőbeli terveink. Ezek közül talán a legfontosabb a magas rendelkezésre állás. Jelenleg nincs. Néhány gépet azonosan állítottunk be, de az összes adat egy gépen keresztül megy. Időt kellene szánni arra, hogy beállítsuk a failover-t közöttük.
Metrikák gyűjtése a Graylogból.
Rate limit beállítása, hogy egy, megőrült API ne öljön meg minket sávszélességben és minden egyébben.
És végül, aláírni valamilyen SLA-t a fejlesztőkkel, hogy mennyit tudunk kezelni. Ha többet írtok, akkor sajnálom.
És dokumentációt írni.
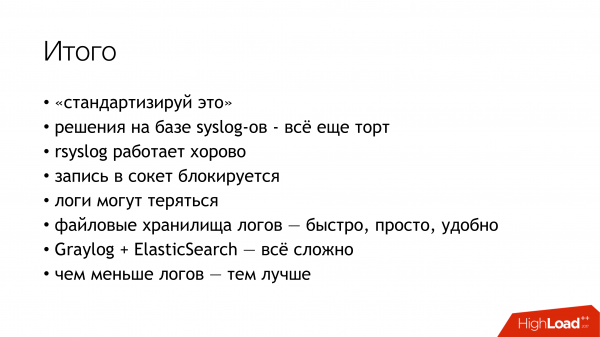
Röviden összefoglalva mindent, amit átéltünk. Először is, szabványok. Másodszor, a syslog — egy torta. Harmadszor, az rsyslog pontosan úgy működik, ahogy a dián van írva. És most térjünk át a kérdésekre.
Kérdések.
Kérdés: Miért döntöttünk úgy, hogy mégsem használjuk... (filebeat?)
Válasz: Fájlt kell írni. Nagyon nem akartam. Amikor az API-d másodpercenként ezer üzenetet ír, még ha óránként forgatsz is, az még mindig nem megoldás. Írhatunk pipe-ba is. Amire a fejlesztők megkérdezték tőlem: „Mi történik, ha a folyamat, ahová írunk, összeomlik?” Egyszerűen nem tudtam mit válaszolni, és azt mondtam: „Hát rendben, akkor ne csináljuk így.”
Kérdés: Miért nem írjátok a naplókat egyszerűen HDFS-be?
Válasz: Ez a következő lépés. Gondoltunk rá a legelső pillanattól kezdve, de mivel jelenleg nincsenek erőforrásaink ezzel foglalkozni, emiatt hosszú távú megoldásként lóg a levegőben.
Kérdés: Az oszlopformátum jobban megfelelne.
Válasz: Mindent értek. Mindkét kezünkkel ezért vagyunk.
Kérdés: A rsyslog-ba írtok. Ott használható TCP és UDP is. De ha UDP-t használtok, hogyan garantáljátok a kézbesítést?
Válasz: Két dolog van. Először is, azonnal mindenkinek mondom, hogy nem garantáljuk a naplók kézbesítését. Mert amikor a fejlesztők jönnek és azt mondják: „Hogyha elkezdünk pénzügyi adatokat írni, akkor ti ezeket valahogy tároljátok, ha történik valami”, mi azt mondjuk: „Remek! Akkor kezdjétek el blokkolni a socketbe írást, és csináljátok ezt tranzakciókban, hogy biztos legyetek benne, hogy megkaptuk a socket-en, és megbizonyosodtok róla, hogy azt átvettük.” És ebben a pillanatban mindenkinek azonnal nem lesz szüksége rá. Ha pedig nem szükséges, akkor miért kérdezősködnek? Ha nem akarjátok garantálni a socket írást, miért garantáljuk a kézbesítést? Mi „best effort”-ot csinálunk. Valóban próbáljuk meg minél többet és minél jobban eljuttatni, de nem adunk 100%-os garanciát. Ezért pénzügyi adatokat nem kell oda írni. Erre ott vannak a tranzakciós adatbázisok.
Kérdés: Amikor az API generál egy üzenetet a naplóban és átadja a vezérlést a mikroszolgáltatásoknak, találkoztatok-e már azzal a problémával, hogy a különböző mikroszolgáltatásokból érkező üzenetek nem a megfelelő sorrendben érkeznek? Ebből zűrzavar adódik.
Válasz: Normális, hogy különböző sorrendben érkeznek. Ezzel számolni kell. Mert bármilyen hálózati kézbesítés nem garantálja a sorrendet, vagy külön erőforrásokat kell ráfordítani. Ha a fájltárolókat nézzük, minden API a saját fájljába menti a naplókat. Helyesebben a rsyslog ott rendszerezi őket mappákba. Minden API-nak megvan a saját naplója, ahová el lehet menni és megnézni, majd a timestamp alapján párosítani őket. Ha a Graylog-ba mennek, akkor ott időrendben lesznek rendezve. Ott minden rendben lesz.
Kérdés: A timestamp milliszekundumos eltéréseket mutathat.
Válasz: A timestamp-ot magának az API-nak kell generálnia. Ez igazából az egész lényeg. Van NTP-ünk. Az API már magában az üzenetben generálja a timestamp-ot. A rsyslog nem ad hozzá.
Kérdés: Nem nagyon érthető, hogyan működik az interakció az adatközpontok között. Az adatközponton belül világos, hogyan gyűjtik és dolgozzák fel a naplókat. Hogyan történik az interakció az adatközpontok között? Vagy minden adatközpont a saját életét éli?
Válasz: Majdnem. Minden országunk egy adott adatközpontban található. Jelenleg nincs arra példa, hogy egy ország különböző adatközpontokban legyen elhelyezve. Ezért nincs szükség az egyesítésükre. Minden központban van Log Relay. Ez egy Rsyslog szerver. Valójában két menedzsment gép van. Mindkettő ugyanúgy van beállítva. De egyelőre a forgalom csak az egyiken megy keresztül. Ez aggregálja a naplókat. Van egy lemezes sor a biztonság kedvéért. Összenyomja a naplókat, és elküldi őket a központi adatközpontba (Szingapúrba), ahol már Graylogba jutnak. Minden adatközpontban van saját fájltárolója. Ha megszűnik a kapcsolatunk, minden naplót ott tartunk. Azok ott maradnak. Azok ott lesznek mentve.
Kérdés: Vészhelyzetekben onnan kaptok naplókat?
Válasz: El lehet menni oda (a fájltárolóhoz) és megnézni.
Kérdés: Hogyan ellenőrizzétek, hogy nem veszítettek el naplókat?
Válasz: Valójában veszítünk el naplókat, és ezt figyeljük. A monitorozás egy hónapja indult el. A Go API által használt könyvtárban vannak metrikák. Képes számolni, hányszor nem tudott írni a socketbe. Jelenleg van egy okos heurisztika. Van egy puffer. Próbál üzenetet írni a socketbe a pufferből. Ha a puffer megtelik, elkezdi eldobni őket. És számolja, hogy mennyit dobott el. Ha elkezdik túllépni a számlálókat, akkor tudunk róla. Ezek most a Prometheusba is ellátogatnak, és a Grafanában meg lehet nézni a grafikonokat. Be lehet állítani a figyelmeztetéseket. De egyelőre nem világos, kinek küldjük azokat.
Kérdés: Az Elasticsearch-ben tartotok naplókat replikációval. Hány replikátok van?
Válasz: Egy replika.
Kérdés: Ez csak egy replika?
Válasz: Ez a mester és replika. Két példányban tárolják az adatokat.
Kérdés: A rsyslog pufferének méretét valahogy állítottátok?
Válasz: Egyedi unix socketbe írjuk a datagramokat. Ez azonnal 128 kilobájt korlátot szab számunkra. Nem tudunk többet írni belőle. Ezt a szabványban rögzítettük. Akik a tárolókhoz akarnak jutni, azok 128 kilobájtot írnak. A könyvtárak egyébként levágják, és jelzik, hogy az üzenet levágásra került. Az üzenet szabványában van egy speciális mező, amely megmutatja, hogy az írás közben levágásra került-e vagy sem. Tehát van lehetőségünk ezt a pontot nyomon követni.
Kérdés: Ír-e törött JSON-t?
Válasz: A törött JSON-t vagy a relay során, mert túl nagy csomag, dobják el. Vagy a Graylog dobja el, mert nem tudja a JSON-t elemezni. De itt vannak olyan árnyalatok, amelyeket javítani kell, és ezek döntően az rsyslog-hoz kapcsolódnak. Már kitöltöttem néhány problémát, amelyeken még dolgozni kell.
Kérdés: Miért a Kafka? Próbálták már a RabbitMQ-t? A Graylog nem működik ilyen terhelések mellett?
Válasz: Nálunk a Graylog nem működik jól. A Graylogunk működik, de vele valóban problémás. Egy különös dolog. Igazából nincs is szükség rá. Inkább a rsyslog-ból közvetlenül az elasticsearch-ba írnám, és utána a Kibana-t nézném. De el kell rendezni a kérdést a biztonságiakkal. Ez egy lehetséges fejlesztési irányunk, amikor kidobjuk a Graylogot, és csak a Kibana-t használjuk. A Logstash használatának nincs értelme, mert ugyanazt meg tudom csinálni az rsyslog-gal. És van modulja az elasticsearch-ba való írásra. A Graylog-gal próbálunk valahogy együtt élni. Még kicsit tuningoltuk is. De ott van még tere a fejlesztéseknek.
A Kafka kapcsán. Így alakult ez történetileg. Amikor érkeztem, már létezett, és logokat már írtak bele. Csak felállítottuk a klasztert, és a logokat átköltöztettük. Mi menedzseljük, tudjuk, hogy áll. A RabbitMQ-val kapcsolatban… nem jön össze a RabbitMQ. De a RabbitMQ-unk működik. Van a produkciós környezetünkben, és voltak vele problémák. Mostanra, a leárazás előtt, ügyesebbé tettük, és jól működik. De addig nem voltam felkészülve, hogy kiadjam a produkciós környezetbe. Van még egy szempont. A Graylog tudja olvasni az AMQP 0.9 verziót, míg az rsyslog tudja írni az AMQP 1.0 verziót. Nincs egy megoldás sem, ami mindkettőt tudja. Csak az egyik vagy a másik. Így jelenleg csak a Kafka működik. De ott is vannak saját árnyoldalai. Mert az omkafka, amely az rsyslog azon verzióját használja, amit mi használunk, elveszítheti az összes üzenetbufferét, amelyet kiszedett az rsyslog-ból. Egyelőre megbarátkoztunk ezzel.
Kérdés: Azt használjátok, mert már volt nektek? Más célra nem használjátok?
Válasz: Az a Kafka, ami volt, a Data Science csapat által van használva. Ez egy teljesen külön projekt, amiről sajnos nem tudok nyilatkozni. Nem vagyok tisztában vele. A Data Science csapat irányítása alatt volt. Amikor a logokat beindították, úgy döntöttek, hogy azt használják, hogy ne kelljen még egy sajátot felállítani. Most frissítettük a Graylog-ot, és elveszítettük a kompatibilitást, mert ott egy régi Kafka verzió van. Muszáj volt egy sajátot bevezetnünk. Ráadásul megszabadultunk a négy témtől minden API-ra. Készítettünk egy széles témát minden élő rendszerhez, és egy széles témát az összes staging-hez, és csak mindent oda küldünk. A Graylog mindezt párhuzamosan kigyűjti.
Kérdés: Miért szükséges ez a varázslás a socketekkel? Próbáltátok a syslog log driver használatát a konténerekhez?
Válasz: Abban az időszakban, amikor ezzel a kérdéssel foglalkoztunk, a Dockerrel való kapcsoltunk feszültté vált. Ez a Docker 1.0 vagy 0.9 volt. A Docker önmagában furcsa volt. Másrészt, ha a naplókat is bele kell tenni... Van egy ellenőrizetlen gyanúm, hogy minden naplót átenged a kapcsolati démonján. Ha van egy API, ami megőrül, akkor a többi API beleütközik abba, hogy nem tudja elküldeni a stdout-ot és stderr-t. Nem tudom, hogy ez hová vezet. Van egy érzésem, hogy ebben a helyzetben nem kellene használni a Docker syslog-illesztőjét. A funkcionális tesztelő osztályunknak van egy saját kis Graylog klasztere a naplókkal. Ők használják a Docker napló-illesztőit, és úgy tűnik, hogy náluk minden rendben van. De ők közvetlenül a GELF-t írják a Graylogba. Abban az időszakban, amikor mindez elkezdődött, csak azt akartuk, hogy működjön. Lehet, hogy később, amikor valaki azt mondja, hogy ez már régóta jól működik, akkor megpróbáljuk.
Kérdés: A szállítást a datacenter-ek között rsyslog-on végezzük. Miért nem Kafka-val?
Válasz: Tényleg mindkét módot használjuk. Két okból. Ha a csatorna teljesen megvan gyilkolva, akkor még tömörített formában sem mennek át a naplók. A Kafka azonban lehetővé teszi, hogy egyszerűen elveszítjük őket a folyamat során. Ezzel a módszerrel elkerüljük a naplók elakadását. Ilyen esetben egyszerűen közvetlenül használjuk a Kafka-t. Ha a csatornánk jó, és szeretnénk felszabadítani, akkor rsyslog-ot használunk. De valójában be lehet állítani, hogy automatikusan dobja ki azt, ami nem ment át. Jelenleg valahol közvetlenül az rsyslog szállítást használjuk, valahol pedig Kafka-t.
Forrás: habr.com
