

Személyes tapasztalataim alapján elmondom, hogy hol, mikor és mire lehetett szükség. Áttekintően és vázlatosan, hogy világos legyen, mit és hova lehet tovább kutatni - de itt kizárólag a szubjektív tapasztalataimról van szó, nálad lehet, hogy minden egészen más.
Miért fontos ismerni és tudni használni a lekérdezési nyelveket? A Data Science-ben lényegében több fontos szakasz van, és az első és legfontosabb (hiszen nélküle semmi sem működik!) - az adatok megnyerése vagy kinyerése. Legtöbbször az adatok valamilyen formában valahol megtalálhatók, és ezeket onnan kell 'előbányászni'.
A lekérdezési nyelvek éppen az adatok kinyerésére szolgálnak! Ma pedig bemutatom azokat a lekérdezési nyelveket, amelyeket hasznosnak találtam, és megmutatom, hogy pontosan hol és hogyan lehet őket alkalmazni - miért fontosak a tanulmányozás szempontjából.
Összesen három fő blokkot fogunk áttekinteni az adatlekérdezési típusokról ebben a cikkben:
- A „standard” lekérdezési nyelvek – ami általában eszünkbe jut, amikor a lekérdezési nyelvekről beszélünk, mint például a relációs algebra vagy az SQL.
- Script nyelvek: például Python nyelvi eszközök, mint a pandas, numpy vagy shell scripting.
- Lekérdezési nyelvek tudásgrafikonokhoz és grafadatbázisokhoz.
Minden, amit itt leírtam, csak a személyes tapasztalatom, ami hasznos volt, helyzetek leírásával és az 'amiért szükség volt rá' – mindenki átgondolhatja, mennyire találkozhat hasonló helyzetekkel, és próbálhat felkészülni rájuk előre, azokkal a nyelvekkel foglalkozva, mielőtt sürgősen alkalmaznia kellene őket egy projektben, vagy egyáltalán találkozna egy projekttel, ahol szükség van rájuk.
„Standard” lekérdezési nyelvek
A standard lekérdezési nyelvek, pontosan abban az értelemben, hogy általában ezek jutnak eszünkbe, amikor a lekérdezésekről beszélünk.
Relációs algebra
Miért van ma szükség relációs algebrára? Ahhoz, hogy jól megértsük, miért vannak a lekérdezési nyelvek így megalkotva, és tudatosan képesek legyünk használni őket, érdemes átgondolnunk az alapvető magot, amely mögötte áll.
Mi az a relációs algebra?
A formai meghatározás a következő: a relációs algebra – zárt műveletek rendszere a relációs adatmodellben. Ha kicsit érthetőbben szeretnénk fogalmazni, ez egy műveletek rendszere táblázatokon, úgy, hogy az eredmény is mindig egy tábla.
Nézd meg az összes relációs műveletet a Habr cikkében — itt azt is leírjuk, miért fontos tudni és hol használható.
Miért?
Elkezded megérteni, hogyan állnak össze egyáltalán a lekérdezési nyelvek és milyen műveletek állnak a különböző lekérdezési nyelvek kifejezései mögött — ez gyakran mélyebb megértést ad arról, hogy mi és hogyan működik a lekérdezési nyelvekben.
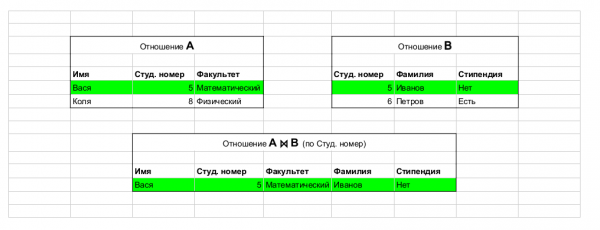
Forrás: cikk. Egy példa művelet: join, amely táblákat egyesít.
Tanulmányozásra ajánlott anyagok:
. Egyébként rengeteg anyag áll rendelkezésre a relációs algebráról és a teóriáról — Coursera, Udacity. Számos online anyag is létezik, köztük jó . Személyes tanácsom: a relációs algebrát nagyon jól kell érteni — ez az alapok alapja.
SQL
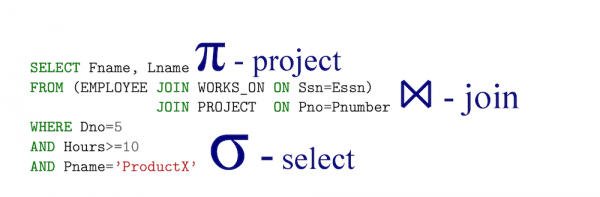
Forrás: cikkek.
Az SQL lényegében a relációs algebra megvalósítása — fontos megjegyzéssel: az SQL deklaratív! Tehát amikor relációs algebra nyelvén írsz lekérdést, valójában azt mondod, hogyan kell számolni — az SQL-nél viszont azt adod meg, mit szeretnél kinyerni, a DBMS pedig már generálja (hatékony) kifejezéseket a relációs algebra nyelvén (ekvivalenciájukat ismerjük mint ).
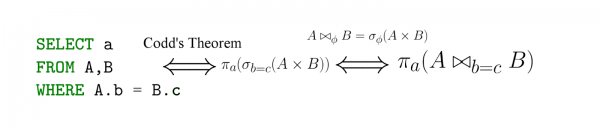
Forrás: cikkek.
Miért?
Relációs DBMS-ek: Oracle, Postgres, SQL Server stb. — továbbra is gyakorlatilag mindenhol jelen vannak, és hihetetlenül nagy a valószínűsége, hogy kölcsönhatásba kell lépned velük, ami azt jelenti, hogy vagy SQL-t kell olvasnod (ami nagyon valószínű), vagy SQL-ben kell írnod (az is nem elhanyagolható).
Mit olvass és tanulmányozz
Ugyanezeken a hivatkozásokon (a relációs algebráról) hihetetlen mennyiségű anyag található, például .
Egyébként, mi az a NoSQL?
"Még egyszer hangsúlyozni kell, hogy a 'NoSQL' kifejezés abszolút spontán eredetű, és nincs közismert definíciója vagy tudományos intézmény mögötte." A megfelelő a Habr-nál.
Lényegében az emberek megértették, hogy a teljes relációs modell nem szükséges sok feladat megoldásához, különösen azoknál, ahol például a teljesítmény alapvetően fontos és bizonyos egyszerű lekérdezések dominálnak — kritikus, hogy gyorsan számolják a metrikákat és írják be őket az adatbázisba, míg a relációs megoldások többsége nemcsak hogy nem szükséges, de káros is — miért normalizáljunk valamit, ha ez rontja a legfontosabbat számunkra (egy konkrét feladat esetén) — a teljesítményt?
Gyakran szükségesek a rugalmas sémák a klasszikus relációs modell rögzített matematikai sémái helyett — ez hihetetlenül megkönnyíti az alkalmazások fejlesztését, amikor kritikus fontosságú a rendszer gyors telepítése és működésbe állítása az eredmények feldolgozása közben — vagy a séma és a tárolt adatok típusa nem is olyan fontos.
Például létrehozunk egy szakértői rendszert, és szeretnénk információkat tárolni egy adott domain körében némi meta-információval együtt — lehet, hogy nem is tudjuk az összes mezőt, és triviálisan JSON-t tárolunk minden bejegyzéshez — ez nagyon rugalmas környezetet biztosít az adatminta bővítésére és a gyors iterálásra — ezért ilyen esetekben a NoSQL még előnyösebb is lehet és olvashatóbb.
{"en_wikipedia_url":"https://en.wikipedia.org/wiki/Johnny_Cash",
"ru_wikipedia_url":"https://ru.wikipedia.org/wiki/?curid=301643",
"ru_wiki_pagecount":149616,
"entity":[42775,"Johnny Cash","ru"],
"en_wiki_pagecount":2338861}
További részleteket itt olvashatsz a NoSQL-ról.
Mit érdemes tanulmányozni?
Itt inkább jól meg kellene elemezni a feladatot, milyen tulajdonságai vannak, és milyen NoSQL rendszerek felelnek meg ennek a leírásnak — és már foglalkozni a tanulmányozásával.
Lekérdező nyelvek
Először is, úgy tűnik, miért is van egyáltalán itt Python — ez egy programozási nyelv, nem pedig lekérdezésekről szól.
- A Pandas a Data Science svájci bicskája, rengeteg adattranszformáció, aggregáció stb. történik benne.
- A Numpy vektoros számításokat, mátrixokat és lineáris algebrát tartalmaz.
- A Scipy sok matematikát tartalmaz, különösen statisztikát.
- A Jupyter lab sok felfedezői adatelemzés jól illeszkedik a notebookokba — hasznos tudni.
- A Requests – a hálózati munkához.
- A Pyspark – nagyon népszerű az adatbányászok körében, valószínűleg kölcsönhatásba kell lépnie ezzel, vagy a Sparkkal, egyszerűen a népszerűségük miatt.
- *A Selenium – nagyon hasznos az adatgyűjtéshez weboldalakról és forrásokból, néha más módon egyszerűen nem lehet megszerezni az adatokat.
A fő tanácsom: tanuld meg a Pythont!
Pandas
Vegyük példaként a következő kódot:
import pandas as pd
df = pd.read_csv(“data/dataset.csv”)
# Összegezd és nevezz át aggregációkat
all_together = (df[df[‘trip_type’] == “return”]
    .groupby(['start_station_name','end_station_name'])
                            .agg({'trip_duration_seconds': [np.size, np.mean, np.min, np.max]})
                           .rename(columns={'size': 'num_trips',
           'mean': 'avg_duration_seconds',
           'amin': min_duration_seconds',
           ‘amax': 'max_duration_seconds'}))
Lényegében azt látjuk, hogy a kód illeszkedik a klasszikus SQL mintához.
SELECT start_station_name, end_station_name, count(trip_duration_seconds) as size, …..
FROM dataset
WHERE trip_type = 'return'
GROUP BY start_station_name, end_station_name
De a fontos rész az, hogy ez a kód egy szkript és a pipeline része, lényegében beágyazzuk a lekérdezéseket a Python pipeline-ba. Ebben a helyzetben a lekérdezés nyelve olyan könyvtárakból származik, mint a Pandas vagy a pySpark.
Összességében a pySpark-ban hasonló típusú adattranszformációt látunk a lekérdezési nyelven keresztül, amolyan:
df.filter(df.trip_type = 'return')
  .groupby('day')
  .agg({duration: 'mean'})
  .sort()
Hol és mit olvassunk
Pythonról általában anyagot találni a tanulmányozáshoz. Az interneten hatalmas mennyiségű oktatóanyag található , és kurzusok a (valamint magáról ). Összességében itt az anyagok nagyszerűen kereshetők, és ha egy csomagot kellene választanom, amire érdemes fókuszálni, az a pandas lenne, természetesen. A DS+Python összefüggésében is .
A Shell mint lekérdezési nyelv
Számos adatfeldolgozási és elemzési projekt, amivel dolgoztam — lényegében shell szkriptek, amelyek Python kódot, Java-t hívnak meg, és magukat a shell parancsokat. Tehát összességében a bash/zsh/stb. pipeline-ok magasabb szintű lekérdezésként tekinthetők (persze lehet bennük ciklusokat is tenni, de ez nem jellemző a shell nyelveken való DS kódra), itt egy egyszerű példát hozok — mappolnom kellett a QID Wikidata és a teljes linket az orosz és angol wikihez, ezért írtam egy egyszerű parancsot bash-ben, és az outputhoz írtam egy egyszerű Python szkriptet, amelyet így összeállítottam:
pv 'data/latest-all.json.gz' |
unpigz -c  |
jq --stream $JQ_QUERY |
python3 scripts/post_process.py 'output.csv'
ahol
JQ_QUERY = 'select((.[0][1] == "sitelinks" and (.[0][2]=="enwiki" or .[0][2] =="ruwiki") and .[0][3] =="title") or .[0][1] == "id")' Ez lényegében az egész pipeline volt, amely létrehozta a szükséges mappolást, ahogy látjuk, minden áramlási módban működött:
- pv filepath — egy előrehaladási sávot ad a fájl mérete alapján, és továbbítja a tartalmát
- unpigz -c olvasta a tömörített fájl egy részét és továbbította a jq-nek
- jq stream kulccsal azonnal eredményeket adott, és átadta a postprocesszornak (ahogyan az első példánál is) a Pythonra
- a postprocesszor belsejében — ez egy egyszerű állapotgép, amely formázta a kimenetet
Összességében egy bonyolult pipeline, amely nagy adatokkal (0,5 TB) működik folyamatos üzemmódban, jelentős erőforrások nélkül, és egy egyszerű pipeline és néhány eszköz kombinációjából készült.
Egy másik fontos tanács: tudjon jól és hatékonyan dolgozni a terminálban, és írjon bash/zsh/egyéb nyelveken.
Hol jön ez jól? Szinte mindenütt — az interneten nagyon sok tananyag érhető el. Különösen itt van az előző cikkem.
R scripting
Ismételten a kedves olvasó felkiálthat — hiszen ez egy egész programozási nyelv! És természetesen igaza van. Azonban általában R-rel mindig olyan összefüggésben találkoztam, ami lényegében nagyon hasonló volt a lekérdezések nyelvéhez.
Az R egy statisztikai számításokra és adatvizualizációra szolgáló környezet és nyelv (szerintem ).
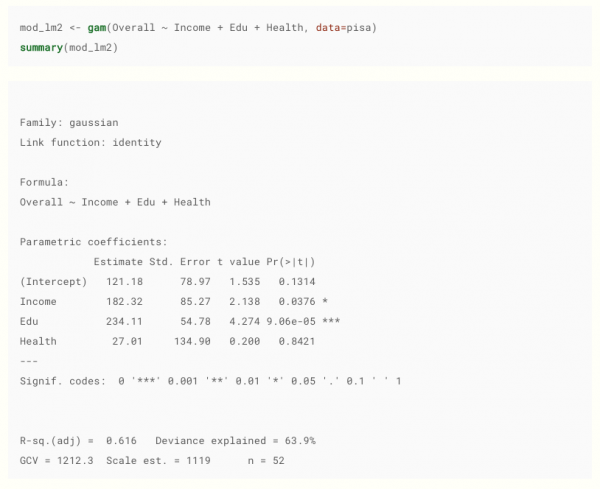
került figyelembe vételre. . Egyébként ajánlom, nem rossz anyag.
Miért fontos egy adatkutatónak ismernie az R-t? Legalábbis azért, mert hatalmas mennyiségű olyan ember van az IT-n kívül, aki R-en végzi az adatelemzést. Én az alábbi területeken találkoztam vele:
- Gyógyszeripar.
- Biológusok.
- Pénzügyi szektor.
- Azok az emberek, akik tisztán matematikai végzettséggel bírnak, és statisztikákkal foglalkoznak.
- Speciális statisztikai modellek és gépi tanulási modellek (amelyek gyakran csak a szerzői verzióban találhatók R csomagként).
Miért számít ez lényegében lekérdezések nyelvének? Abban a formában, ahogyan gyakran találkozik vele — ez lényegében egy modell létrehozására irányuló lekérdezés, beleértve az adatok beolvasását és a lekérdezési paraméterek (modellek) rögzítését, valamint az adatok vizualizációját olyan csomagokban, mint a ggplot2 — ez is a lekérdezések írásának egy formája.
Példa vizualizációs lekérdezésekre
ggplot(data = beav,
       aes(x = id, y = temp,
           group = activ, color = activ)) +
  geom_line() +
  geom_point() +
  scale_color_manual(values = c("red", "blue"))
Összességében sok ötlet az R-ből átkerült a Python csomagokba, például a pandasba, numpyba vagy scipy-ba, mint adatkeretek és adatok vektorizálása — ezért sok dolog az R-ben ismerős és kényelmes lesz az Ön számára.
Sok tanulmányi forrás létezik, például .
Tudásgrafok (Knowledge graph)
Itt kissé szokatlan tapasztalatom van, mert gyakran dolgozom tudásgrafokkal és lekérdezési nyelvekkel. Ezért csak röviden végigmegyünk az alapokon, mivel ez a rész kicsit egzotikusabb.
A klasszikus relációs adatbázisokban a séma rögzített — itt azonban a séma rugalmas, minden predikátum valójában egy "oszlop", és még ennél is több.
Képzelje el, hogy egy embert modellezne, és a legfontosabb dolgok leírására törekedne; például vegyünk egy konkrét embert, Douglas Adams-t, és erre az leírásra alapozzunk.
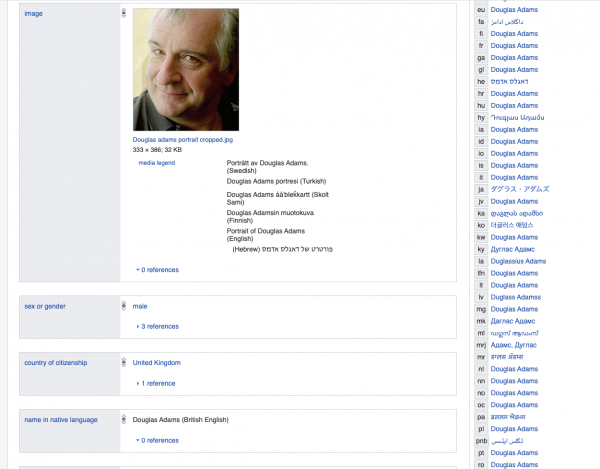
Ha relációs adatbázist használnánk, hatalmas táblákat vagy táblákat kellene létrehoznunk, melyek rengeteg oszlopot tartalmaznak, amelyek legnagyobb része NULL vagy valamilyen alapértelmezett hamis értékkel lenne kitöltve. Például, valószínűleg nem sokunknak van bejegyzése a koreai nemzeti könyvtárban — természetesen külön táblákba is kivehetnénk őket, de ez végül is egy rugalmas logikai séma, predikátumokkal, rögzített relációs módszerekkel való modellezésének lenne a kísérlete.
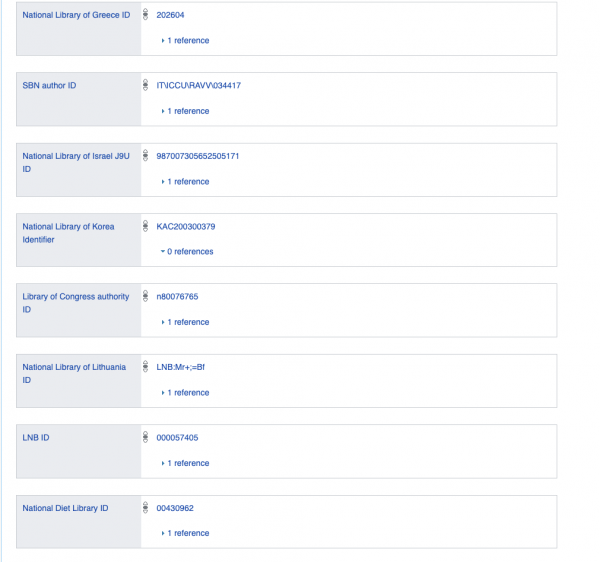
Ezért képzelje el, hogy az összes adat gráfként, vagy bináris és unáris logikai kifejezések formájában van tárolva.
Hol találkozhat ilyennel? Először is, amikor dolgozik a -val, valamint bármilyen gráf alapú adatbázissal vagy összekapcsolt adatokkal.
Ezután következnek azok a lekérdezési nyelvek, amelyeket használnom kellett és amelyekkel dolgoznom kellett.
SPARQL
Wiki:
SPARQL ( tól SPARQL Protokoll és RDF Lekérdezési Nyelv) — , amelyek az , valamint modellben kerülnek bemutatásra ezen lekérdezések és válaszok átadására. A SPARQL a ajánlása, és az egyik technológia a .
számára. Valójában ez egy lekérdezési nyelv logikai unáris és bináris predikátumokhoz. Csak feltételezhetően meg van határozva, hogy mi az, ami rögzített a logikai kifejezésben és mi nem (nagyon leegyszerűsítve).
Az RDF (Resource Description Framework) alapja, amelyen a SPARQL lekérdezések végrehajtódnak, egy háromság: objektum, predikátum, alany — és a lekérdezés a megadott korlátozások mentén választja ki a szükséges hármasokat, a mint: találni egy olyan X-et, amelyre a p_55(X, q_33) igaz — ahol természetesen a p_55 egy 55-ös ID-jú reláció, a q_33 pedig a 33-as ID-jú objektum (ez a lényeg, ismét kihagyva a különböző részleteket).
Adatok bemutatásának példája:
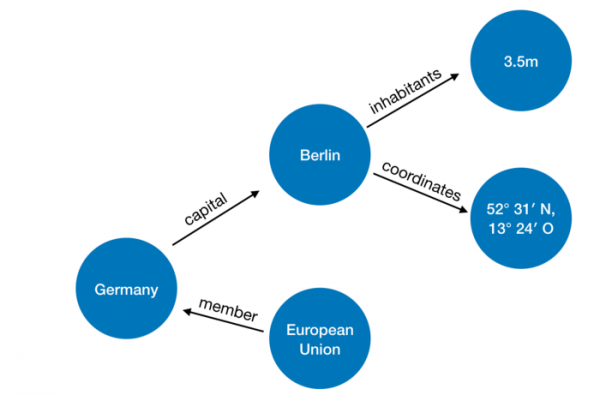
Képek és példák az országokról itt .
Példa egy alaplekérdezésre
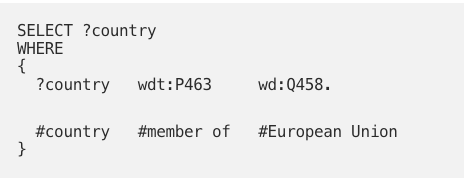
Valójában azt szeretnénk megtalálni, hogy a ?country változó értéke, amelyre a member_of predikátum igaz, hogy member_of(?country, q458), ahol q458 az Európai Unió ID-ja.
member_of, igaz, hogy member_of(?country,q458), ahol q458 — az Európai Unió azonosítója.
SPARQL valódi lekérdezése python motorban:
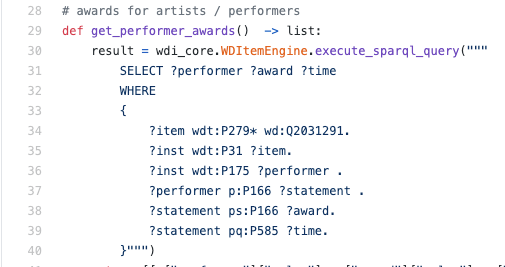
Általában SPARQL-t olvasnom kellett, nem pedig írnom — ilyen helyzetben valószínűleg hasznos készség megérteni a nyelvet legalább alapvető szinten, hogy megértsük, hogyan történik az adatok lekérése.
Online sok anyag áll rendelkezésre a tanuláshoz: például itt van és . Én általában konkrét szerkezeteket és példákat google-ozok, és eddig elég volt.
Logikai lekérdező nyelvek
Témában többet olvashatsz a cikkemben . Itt csak röviden átbeszéljük, hogy miért alkalmasak a logikai nyelvek a lekérdezések írására. Lényegében az RDF csak logikai állítások csoportját jelenti, mint p(X) és h(X,Y), míg a logikai lekérdezés a következőképpen néz ki:
output(X) :- country(X), member_of(X, "EU").
Itt egy új predikátumot hozunk létre output/1 (a /1 jelentése egyértelmű), abban a feltételben, hogy X-re igaz, hogy country(X) — azaz X egy ország, és szintén member_of(X, "EU").
Ez azt jelenti, hogy az adatok és a szabályok ilyen esetben lényegében egyformán vannak reprezentálva, ami lehetővé teszi a problémák nagyon egyszerű és hatékony modellezését.
Hol találkoztunk az iparban: egy nagy projekt egy olyan céggel, amely ilyen nyelven ír lekérdezéseket, valamint a jelenlegi projektben a rendszer magjában — ez egy meglehetősen egzotikus dolognak tűnik, de néha előfordul.
Logikai nyelven írt kód példa, amely a wikidata-t dolgozza fel:
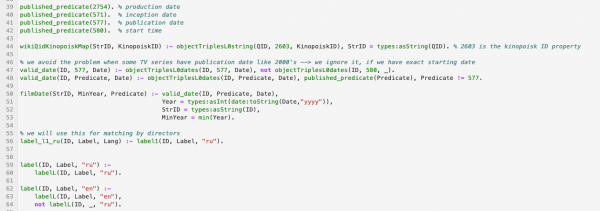
Anyagok: itt adok pár hivatkozást a modern logikai programozási nyelvre, az Answer Set Programming-re — pontosan ezt ajánlom tanulmányozni:
Forrás: habr.com
