

Kedves olvasók, jó napot kívánok. Ma egy kicsit az Apache Sparkról és annak fejlődési kilátásairól fogunk beszélni.
A Big Data korszakában az Apache Spark de facto szabvány a batch adatfeldolgozó feladatok fejlesztésében. Ezen kívül streamelt alkalmazások létrehozására is használják, amelyek a micro batch koncepcióban működnek, és kis adagokban dolgozzák fel és továbbítják az adatokat (Spark Structured Streaming). Hagyományosan a Hadoop általános architektúrájának része volt, YARN (vagy bizonyos esetekben Apache Mesos) erőforráskezelőként való használatával. 2020-ra a hagyományos értelemben vett használata a legtöbb vállalat számára sok kérdést felvet, mivel megfelelő Hadoop disztribúciók hiányában komoly aggodalmak merültek fel — az HDP és CDH fejlesztése megállt, a CDH nem eléggé kidolgozott és magas költséggel jár, míg a többi Hadoop szolgáltató vagy megszűnt, vagy bizonytalan jövő elé néz. Emiatt a közösség és a nagyobb cégek egyre inkább érdeklődnek az Apache Spark Kubernetes általi indítása iránt — mivel ez lett a konténer-orkesztáció és erőforráskezelés standardja a magán- és nyilvános felhőkben, így megoldja a Spark feladatok YARN-on való indításának kényelmetlen tervezési problémáit, és stabilan fejlődő platformot biztosít, számos kereskedelmi és nyílt forráskódú disztribúcióval minden méretű és iparágú vállalat számára. Ezen kívül a népszerűségi hullám következtében a legtöbben már rendelkeznek pár saját telepítéssel és növelték a szakértelmüket a használatában, ami megkönnyíti a migrációt.
A 2.3.0-ás verziótól kezdve az Apache Spark hivatalos támogatást kapott a Kubernetes klaszterben futó feladatok indítására, és ma a megoldás aktuális érettségéről, különféle felhasználási lehetőségeiről és a bevezetés során felmerülő buktatókról fogunk beszélni.
Először is nézzük meg az Apache Spark-alapú feladatok és alkalmazások fejlesztési folyamatát, és emeljük ki azokat a tipikus eseteket, amikor feladatot kell indítani egy Kubernetes klaszteren. E bejegyzés elkészítésekor az OpenShift disztribúciót használtuk, és az oc parancssori eszközéhez megfelelő parancsokat fogunk közölni. Más Kubernetes disztribúciók esetében a Kubernetes alapértelmezett parancssori eszközéhez (kubectl) tartozó megfelelő parancsok, vagy azok megfelelői (például oc adm policy) használhatóak.
Az első használati lehetőség a spark-submit.
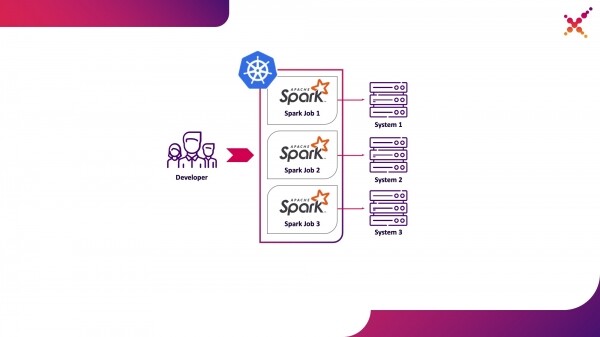
A feladatok és alkalmazások fejlesztése során a fejlesztőnek futtatnia kell a feladatokat az adatok transzformációjának hibakereséséhez. Elméletileg ezekre a célokra használhatóak lenne a stubok, de a valós (még ha teszt) végső rendszerek bevonásával végzett fejlesztés gyorsabb és jobb eredményeket mutatott ezen feladatkörökben. Abban az esetben, amikor valós végső rendszerek példányain végzünk hibakeresést, két munkahelyzet lehetséges:
- a fejlesztő helyben, standalone módban futtatja a Spark feladatot;

- a fejlesztő a Kubernetes klaszteren tesztkörnyezetben futtatja a Spark feladatot.
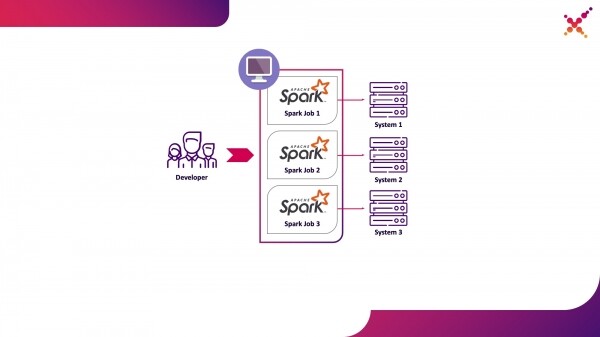
Az első lehetőségnek van létjogosultsága, de számos hátránya van:
- minden fejlesztőnek biztosítania kell a hozzáférést a végső rendszerek összes szükséges példányához a munkahelyéről;
- a munkahelyi gépen elegendő erőforrásnak kell lennie a fejlesztett feladat futtatásához.
A második lehetőség mentes e hátrányoktól, mivel a Kubernetes klaszter használata lehetővé teszi a szükséges erőforrások kiemelését a feladatok futtatásához, és biztosítja a szükséges hozzáféréseket a végső rendszerek példányaihoz, rugalmasan biztosítva a hozzáférést a Kubernetes szerepalapú modellje segítségével a fejlesztőcsapat minden tagja számára. Ezt kiemeljük, mint az első használati lehetőséget - Spark feladatok futtatása a fejlesztő helyi gépéről a Kubernetes klaszteren a tesztkörnyezetben.
Bővebben beszéljünk a Spark helyi futtatásának beállítási folyamatáról. A Spark használatához szükséges annak telepítése:
mkdir /opt/spark
cd /opt/spark
wget http://mirror.linux-ia64.org/apache/spark/spark-2.4.5/spark-2.4.5.tgz
tar zxvf spark-2.4.5.tgz
rm -f spark-2.4.5.tgz
Összegyűjtjük a Kubernetes működéséhez szükséges csomagokat:
cd spark-2.4.5/
./build/mvn -Pkubernetes -DskipTests clean package
A teljes fordítás hosszú időt vesz igénybe, és a Docker képek készítéséhez és azok futtatásához a Kubernetes klaszteren valójában csak az "assembly/" könyvtárból származó jar fájlokra van szükség, így csak ezt az alprojeketet tudjuk felépíteni:
./build/mvn -f ./assembly/pom.xml -Pkubernetes -DskipTests clean package
A Spark feladatok Kubernetesben való futtatásához Docker képet kell létrehozni, amely alapként szolgál. Két megközelítés lehetséges:
- A létrehozott Docker kép tartalmazza a Spark feladat futtatható kódját.
- A létrehozott kép csak a Spark-ot és a szükséges függőségeket tartalmazza, a végrehajtható kód távolról kerül elhelyezésre (például HDFS-ben).
Először készítsünk el egy Docker képet, amely tartalmazza a Spark feladat tesztpéldáját. A Docker képek létrehozásához a Spark rendelkezik egy megfelelő eszközzel, amelynek neve „docker-image-tool”. Nézzük meg a súgóját:
.\/bin\/docker-image-tool.sh --help
Ezzel a segítségével Docker képeket lehet létrehozni és azokat távoli tárolókba feltölteni, de alapértelmezés szerint számos hátránya van:
- kötelezően 3 Docker képet hoz létre — a Spark, PySpark és R számára;
- nem engedi meg a kép nevét megadni.
Ezért használni fogjuk a fenti eszköz módosított változatát:
vi bin\/docker-image-tool-upd.sh
#!/usr/bin/env bash

function error {
  echo "$@" 1>&2
  exit 1
}

if [ -z "${SPARK_HOME}" ]; then
  SPARK_HOME="$(cd "`dirname "$0"`"/..; pwd)"
fi
. "${SPARK_HOME}/bin/load-spark-env.sh"

function image_ref {
  local image="$1"
  local add_repo="${2:-1}"
  if [ $add_repo = 1 ] && [ -n "$REPO" ]; then
    image="$REPO/$image"
  fi
  if [ -n "$TAG" ]; then
    image="$image:$TAG"
  fi
  echo "$image"
}

function build {
  local BUILD_ARGS
  local IMG_PATH

  if [ ! -f "$SPARK_HOME/RELEASE" ]; then
    IMG_PATH=$BASEDOCKERFILE
    BUILD_ARGS=(
      ${BUILD_PARAMS}
      --build-arg
      img_path=$IMG_PATH
      --build-arg
      datagram_jars=datagram/runtimelibs
      --build-arg
      spark_jars=assembly/target/scala-$SPARK_SCALA_VERSION/jars
    )
  else
    IMG_PATH="kubernetes/dockerfiles"
    BUILD_ARGS=(${BUILD_PARAMS})
  fi

  if [ -z "$IMG_PATH" ]; then
    error "Cannot find docker image. This script must be run from a runnable distribution of Apache Spark."
  fi

  if [ -z "$IMAGE_REF" ]; then
    error "Cannot find docker image reference. Please add -i arg."
  fi

  local BINDING_BUILD_ARGS=(
    ${BUILD_PARAMS}
    --build-arg
    base_img=$(image_ref $IMAGE_REF)
  )
  local BASEDOCKERFILE=${BASEDOCKERFILE:-"$IMG_PATH/spark/docker/Dockerfile"}

  docker build $NOCACHEARG "${BUILD_ARGS[@]}"
    -t $(image_ref $IMAGE_REF)
    -f "$BASEDOCKERFILE" .
}

function push {
  docker push "$(image_ref $IMAGE_REF)"
}

function usage {
  cat <<EOF
Usage: $0 [options] [command]
Builds or pushes the built-in Spark Docker image.

Commands:
  build       Build image. Requires a repository address to be provided if the image will be
              pushed to a different registry.
  push        Push a pre-built image to a registry. Requires a repository address to be provided.

Options:
  -f file               Dockerfile to build for JVM based Jobs. By default builds the Dockerfile shipped with Spark.
  -p file               Dockerfile to build for PySpark Jobs. Builds Python dependencies and ships with Spark.
  -R file               Dockerfile to build for SparkR Jobs. Builds R dependencies and ships with Spark.
  -r repo               Repository address.
  -i name               Image name to apply to the built image, or to identify the image to be pushed.
  -t tag                Tag to apply to the built image, or to identify the image to be pushed.
  -m                    Use minikube's Docker daemon.
  -n                    Build docker image with --no-cache
  -b arg      Build arg to build or push the image. For multiple build args, this option needs to
              be used separately for each build arg.

Using minikube when building images will do so directly into minikube's Docker daemon.
There is no need to push the images into minikube in that case, they'll be automatically
available when running applications inside the minikube cluster.

Check the following documentation for more information on using the minikube Docker daemon:

  https://kubernetes.io/docs/getting-started-guides/minikube/#reusing-the-docker-daemon

Examples:
  - Build image in minikube with tag "testing"
    $0 -m -t testing build

  - Build and push image with tag "v2.3.0" to docker.io/myrepo
    $0 -r docker.io/myrepo -t v2.3.0 build
    $0 -r docker.io/myrepo -t v2.3.0 push
EOF
}

if [[ "$@" = *--help ]] || [[ "$@" = *-h ]]; then
  usage
  exit 0
fi

REPO=
TAG=
BASEDOCKERFILE=
NOCACHEARG=
BUILD_PARAMS=
IMAGE_REF=
while getopts f:mr:t:nb:i: option
do
 case "${option}"
 in
 f) BASEDOCKERFILE=${OPTARG};;
 r) REPO=${OPTARG};;
 t) TAG=${OPTARG};;
 n) NOCACHEARG="--no-cache";;
 i) IMAGE_REF=${OPTARG};;
 b) BUILD_PARAMS=${BUILD_PARAMS}" --build-arg "${OPTARG};;
 esac
done

case "${@: -1}" in
  build)
    build
    ;;
  push)
    if [ -z "$REPO" ]; then
      usage
      exit 1
    fi
    push
    ;;
  *)
    usage
    exit 1
    ;;
esac
Ezen keresztül összeállítjuk a Spark alapértelmezett képét, amely tartalmaz egy tesztfeladatot a Pi számítására Spark segítségével (itt {docker-registry-url} — a Docker képtároló URL-je, {repo} — a tároló neve a tárolón belül, amely megegyezik az OpenShift projektjével, {image-name} — a kép neve (ha háromszintű képmegosztást alkalmaznak, például a Red Hat OpenShift integrált képtárolójában), {tag} — a kép adott verziójának címkéje):
.\/bin\/docker-image-tool-upd.sh -f resource-managers\/kubernetes\/docker\/src\/main\/dockerfiles\/spark\/Dockerfile -r {docker-registry-url}\/ {repo} -i {image-name} -t {tag} build
Bejelentkezünk az OKD klaszterbe a konzolos eszköz segítségével (itt {OKD-API-URL} — az OKD klaszter API URL-je):
oc login {OKD-API-URL}
Megkapjuk a jelenlegi felhasználó tokenjét a Docker Registry hitelesítéséhez:
oc whoami -t
Bejelentkezünk az OKD klaszter belső Docker Registry-jébe (a jelszóként használjuk a korábban kapott tokent):
docker login {docker-registry-url}
Feltöltjük a létrehozott Docker képet az OKD Docker Registry-be:
.\/bin\/docker-image-tool-upd.sh -r {docker-registry-url}\/ {repo} -i {image-name} -t {tag} push
Ellenőrizzük, hogy a létrehozott kép elérhető-e OKD-ben. Ehhez nyissuk meg a böngészőben a megfelelő projekt kép-összesítő URL-jét (itt {project} — a projekt neve az OpenShift klaszterben, {OKD-WEBUI-URL} — az OpenShift webes konzol URL-je) — https:\/{OKD-WEBUI-URL}\/console\/project\/ {project}\/browse\/images\/ {image-name}.
A feladatok futtatásához ügyfélfiókot kell létrehozni, amelynek jogai vannak podok root jogosultsággal való futtatására (ezt később megbeszéljük):
oc create sa spark -n {project}
oc adm policy add-scc-to-user anyuid -z spark -n {project}
Végrehajtjuk a spark-submit parancsot a Spark feladat közzétételéhez az OKD klaszterben, megadva a létrehozott ügyfélfiókot és a Docker képet:
/opt/spark/bin/spark-submit --name spark-test --class org.apache.spark.examples.SparkPi --conf spark.executor.instances=3 --conf spark.kubernetes.authenticate.driver.serviceAccountName=spark --conf spark.kubernetes.namespace={project} --conf spark.submit.deployMode=cluster --conf spark.kubernetes.container.image={docker-registry-url}/{repo}/{image-name}:{tag} --conf spark.master=k8s://https://{OKD-API-URL} local:///opt/spark/examples/target/scala-2.11/jars/spark-examples_2.11-2.4.5.jar
Itt:
—name — a feladat neve, amely részt vesz a Kubernetes podok nevének kialakításában;
—class — a futtatható fájl osztálya, amely a feladat indításakor kerül meghívásra;
—conf — a Spark konfigurációs paraméterei;
spark.executor.instances — a futtatott Spark executorok száma;
spark.kubernetes.authenticate.driver.serviceAccountName — a Kubernetes szolgáltatói fiók neve, amelyet a podok indításakor használnak (a Kubernetes API-val való interakció biztonsági kontextusának és képességeinek meghatározásához);
spark.kubernetes.namespace — a Kubernetes névtér, amelyben a vezérlő és az executor podok futni fognak;
spark.submit.deployMode — a Spark indítási módja (a szabványos spark-submit esetén a „cluster”, a Spark Operator és újabb Spark verzióknál a „client”);
spark.kubernetes.container.image — a podok indításához használt Docker kép;
spark.master — a Kubernetes API URL-je (a külső hívás történik helyi gépről);
local:// — a Spark futtatható fájl elérési útja a Docker képen belül.
Lépjünk a megfelelő OKD projekthez, és nézzük meg a létrehozott podokat — https://{OKD-WEBUI-URL}/console/project/{project}/browse/pods.
A fejlesztési folyamat egyszerűsítése érdekében egy másik megoldás is használható, amelyben egy közös alap Spark képet hoznak létre, amelyet minden feladat indítására használnak, míg a futtatható fájlok pillanatképei egy külső tárolóba (például Hadoop) vannak publikálva, és a spark-submit hívásakor hivatkozásként meg vannak adva. Ebben az esetben különböző Spark feladat verziókat indíthatunk a Docker képek újraépítése nélkül, a képek publikálásához például WebHDFS-t használva. Kérelmet küldünk a fájl létrehozására (itt {host} a WebHDFS szolgáltatás hosztja, {port} a WebHDFS szolgáltatás portja, {path-to-file-on-hdfs} - a kívánt fájl elérési útja HDFS-en):
curl -i -X PUT "http://{host}:{port}/webhdfs/v1/{path-to-file-on-hdfs}?op=CREATE
Ennek során egy ilyen választ kapunk (itt {location} az az URL, amelyet a fájl feltöltésére kell használni):
HTTP/1.1 307 TEMPORARY_REDIRECT
Location: {location}
Content-Length: 0
Feltöltjük a Spark futtatható fájlt HDFS-be (itt {path-to-local-file} a Spark futtatható fájl elérési útja a jelenlegi hoszton):
curl -i -X PUT -T {path-to-local-file} "{location}"
Ezt követően elvégezhetjük a spark-submit-et a HDFS-be feltöltött Spark fájl felhasználásával (itt {class-name} a futtatandó feladat osztályának neve):
/opt/spark/bin/spark-submit --name spark-test --class {class-name} --conf spark.executor.instances=3 --conf spark.kubernetes.authenticate.driver.serviceAccountName=spark --conf spark.kubernetes.namespace={project} --conf spark.submit.deployMode=cluster --conf spark.kubernetes.container.image={docker-registry-url}/{repo}/{image-name}:{tag} --conf spark.master=k8s://https://{OKD-API-URL} hdfs://{host}:{port}/{path-to-file-on-hdfs}
Meg kell jegyezni, hogy a HDFS-hez való hozzáférés és a feladat végrehajtása érdekében szükség lehet a Dockerfile és az entrypoint.sh script módosítására — a Dockerfile-ba be kell illeszteni egy direktívát a függő könyvtárak másolásához a /opt/spark/jars könyvtárba, és a HDFS konfigurációs fájlt a SPARK_CLASSPATH-ba kell illeszteni az entrypoint.sh fájlban.
A második használati eset — Apache Livy
Amikor a feladat elkészült, és szükséges a kapott eredmény tesztelése, felmerül a kérdés annak végrehajtásáról a CI/CD folyamaton belül és a végrehajtás állapotának nyomon követéséről. Természetesen elindíthatjuk a helyi spark-submit hívásával is, de ez bonyolítja a CI/CD infrastruktúrát, mivel Spark telepítést és konfigurációt igényel a CI szerver ügynökein/futtatóin, valamint a Kubernetes API-hoz való hozzáférés beállítását. Ebben az esetben a célzott megoldás az Apache Livy használata REST API-ként Spark feladatok indítására, amely a Kubernetes klaszterén belül helyezkedik el. Ezzel a segítségével Spark feladatokat indíthatunk a Kubernetes klaszteren keresztül a megszokott cURL kéréseken, ami könnyen megvalósítható bármilyen CI megoldásban, és a Kubernetes klaszterén belüli elhelyezés megoldja az autentikálást a Kubernetes API-val való interakciónál.
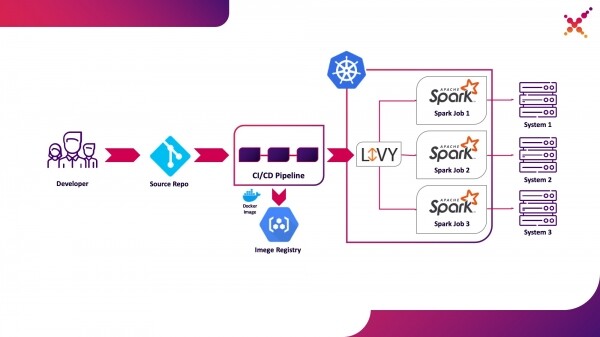
Emeljük ki a második használati esetet — Spark feladatok indítása a CI/CD folyamat keretében a Kubernetes klaszterén belül a tesztkörnyezetben.
Néhány szó az Apache Livy-ról — HTTP szerverként működik, webes felületet és RESTful API-t biztosít, amely lehetővé teszi a spark-submit távoli indítását a szükséges paraméterek átadásával. Hagyományosan a HDP disztribúció részeként szállították, de az OKD vagy bármilyen más Kubernetes telepítésén is elérhető a megfelelő manifest és Docker képek segítségével, például ez alapján — . A mi esetünkben egy hasonló Docker képet állítottunk össze, amely tartalmazza a Spark 2.4.5-öt a következő Dockerfile alapján:
FROM java:8-alpine

ENV SPARK_HOME=/opt/spark
ENV LIVY_HOME=/opt/livy
ENV HADOOP_CONF_DIR=/etc/hadoop/conf
ENV SPARK_USER=spark

WORKDIR /opt

RUN apk add --update openssl wget bash &&
    wget -P /opt https://downloads.apache.org/spark/spark-2.4.5/spark-2.4.5-bin-hadoop2.7.tgz &&
    tar xvzf spark-2.4.5-bin-hadoop2.7.tgz &&
    rm spark-2.4.5-bin-hadoop2.7.tgz &&
    ln -s /opt/spark-2.4.5-bin-hadoop2.7 /opt/spark

RUN wget http://mirror.its.dal.ca/apache/incubator/livy/0.7.0-incubating/apache-livy-0.7.0-incubating-bin.zip &&
    unzip apache-livy-0.7.0-incubating-bin.zip &&
    rm apache-livy-0.7.0-incubating-bin.zip &&
    ln -s /opt/apache-livy-0.7.0-incubating-bin /opt/livy &&
    mkdir /var/log/livy &&
    ln -s /var/log/livy /opt/livy/logs &&
    cp /opt/livy/conf/log4j.properties.template /opt/livy/conf/log4j.properties

ADD livy.conf /opt/livy/conf
ADD spark-defaults.conf /opt/spark/conf/spark-defaults.conf
ADD entrypoint.sh /entrypoint.sh

ENV PATH="/opt/livy/bin:${PATH}"

EXPOSE 8998

ENTRYPOINT ["/entrypoint.sh"]
CMD ["livy-server"]
A létrehozott kép összegyűjthető és feltölthető a meglévő Docker tárolójába, például az OKD belső tárolójába. A telepítéshez a következő manifeszt használható ({registry-url} — a Docker képek tárolójának URL-je, {image-name} — a Docker kép neve, {tag} — a Docker kép tagje, {livy-url} — a kívánt URL, ahol a Livy szerver elérhető lesz; a 'Route' manifesztum használata ajánlott, ha a Kubernetes disztribúció Red Hat OpenShift, egyébként a megfelelő Ingress vagy NodePort típusú Service manifesztum használatos):
---
apiVersion: apps/v1
kind: Deployment
metadata:
  labels:
    component: livy
  name: livy
spec:
  progressDeadlineSeconds: 600
  replicas: 1
  revisionHistoryLimit: 10
  selector:
    matchLabels:
      component: livy
  strategy:
    rollingUpdate:
      maxSurge: 25%
      maxUnavailable: 25%
    type: RollingUpdate
  template:
    metadata:
      creationTimestamp: null
      labels:
        component: livy
    spec:
      containers:
        - command:
            - livy-server
          env:
            - name: K8S_API_HOST
              value: localhost
            - name: SPARK_KUBERNETES_IMAGE
              value: 'gnut3ll4/spark:v1.0.14'
          image: '{registry-url}/{image-name}:{tag}'
          imagePullPolicy: Always
          name: livy
          ports:
            - containerPort: 8998
              name: livy-rest
              protocol: TCP
          resources: {}
          terminationMessagePath: /dev/termination-log
          terminationMessagePolicy: File
          volumeMounts:
            - mountPath: /var/log/livy
              name: livy-log
            - mountPath: /opt/.livy-sessions/
              name: livy-sessions
            - mountPath: /opt/livy/conf/livy.conf
              name: livy-config
              subPath: livy.conf
            - mountPath: /opt/spark/conf/spark-defaults.conf
              name: spark-config
              subPath: spark-defaults.conf
        - command:
            - /usr/local/bin/kubectl
            - proxy
            - '--port'
            - '8443'
          image: 'gnut3ll4/kubectl-sidecar:latest'
          imagePullPolicy: Always
          name: kubectl
          ports:
            - containerPort: 8443
              name: k8s-api
              protocol: TCP
          resources: {}
          terminationMessagePath: /dev/termination-log
          terminationMessagePolicy: File
      dnsPolicy: ClusterFirst
      restartPolicy: Always
      schedulerName: default-scheduler
      securityContext: {}
      serviceAccount: spark
      serviceAccountName: spark
      terminationGracePeriodSeconds: 30
      volumes:
        - emptyDir: {}
          name: livy-log
        - emptyDir: {}
          name: livy-sessions
        - configMap:
            defaultMode: 420
            items:
              - key: livy.conf
                path: livy.conf
            name: livy-config
          name: livy-config
        - configMap:
            defaultMode: 420
            items:
              - key: spark-defaults.conf
                path: spark-defaults.conf
            name: livy-config
          name: spark-config
---
apiVersion: v1
kind: ConfigMap
metadata:
  name: livy-config
data:
  livy.conf: |-
    livy.spark.deploy-mode=cluster
    livy.file.local-dir-whitelist=/opt/.livy-sessions/
    livy.spark.master=k8s://http://localhost:8443
    livy.server.session.state-retain.sec = 8h
  spark-defaults.conf: 'spark.kubernetes.container.image        "gnut3ll4/spark:v1.0.14"'
---
apiVersion: v1
kind: Service
metadata:
  labels:
    app: livy
  name: livy
spec:
  ports:
    - name: livy-rest
      port: 8998
      protocol: TCP
      targetPort: 8998
  selector:
    component: livy
  sessionAffinity: None
  type: ClusterIP
---
apiVersion: route.openshift.io/v1
kind: Route
metadata:
  labels:
    app: livy
  name: livy
spec:
  host: {livy-url}
  port:
    targetPort: livy-rest
  to:
    kind: Service
    name: livy
    weight: 100
  wildcardPolicy: None
A Livy grafikus felülete az alkalmazás befejezése és a pod sikeres elindítása után az alábbi linken érhető el: http://{livy-url}/ui. A Livy segítségével a Spark feladatunkat REST kérés formájában közzétehetjük, például a Postman használatával. Az alábbiakban bemutatunk egy példakollekciót a kérésekről (az «args» tömbben konfigurációs argumentumokat és a futtatáshoz szükséges változókat adhatunk meg):
{
    "info": {
        "_postman_id": "be135198-d2ff-47b6-a33e-0d27b9dba4c8",
        "name": "Spark Livy",
        "schema": "https://schema.getpostman.com/json/collection/v2.1.0/collection.json"
    },
    "item": [
        {
            "name": "1 Küldjünk el munkát jar fájllal",
            "request": {
                "method": "POST",
                "header": [
                    {
                        "key": "Content-Type",
                        "value": "application/json"
                    }
                ],
                "body": {
                    "mode": "raw",
                    "raw": "{nt"file": "local:///opt/spark/examples/target/scala-2.11/jars/spark-examples_2.11-2.4.5.jar", nt"className": "org.apache.spark.examples.SparkPi",nt"numExecutors":1,nt"name": "spark-test-1",nt"conf": {ntt"spark.jars.ivy": "/tmp/.ivy",ntt"spark.kubernetes.authenticate.driver.serviceAccountName": "spark",ntt"spark.kubernetes.namespace": "{project}",ntt"spark.kubernetes.container.image": "{docker-registry-url}/{repo}/{image-name}:{tag}"nt}n}"
                },
                "url": {
                    "raw": "http://{livy-url}/batches",
                    "protocol": "http",
                    "host": [
                        "{livy-url}"
                    ],
                    "path": [
                        "batches"
                    ]
                }
            },
            "response": []
        },
        {
            "name": "2 Küldjünk el munkát jar fájl nélkül",
            "request": {
                "method": "POST",
                "header": [
                    {
                        "key": "Content-Type",
                        "value": "application/json"
                    }
                ],
                "body": {
                    "mode": "raw",
                    "raw": "{nt"file": "hdfs://{host}:{port}/{path-to-file-on-hdfs}", nt"className": "{class-name}",nt"numExecutors":1,nt"name": "spark-test-2",nt"proxyUser": "0",nt"conf": {ntt"spark.jars.ivy": "/tmp/.ivy",ntt"spark.kubernetes.authenticate.driver.serviceAccountName": "spark",ntt"spark.kubernetes.namespace": "{project}",ntt"spark.kubernetes.container.image": "{docker-registry-url}/{repo}/{image-name}:{tag}"nt},nt"args": [ntt"HADOOP_CONF_DIR=/opt/spark/hadoop-conf",ntt"MASTER=k8s://https://kubernetes.default.svc:8443"nt]n}"
                },
                "url": {
                    "raw": "http://{livy-url}/batches",
                    "protocol": "http",
                    "host": [
                        "{livy-url}"
                    ],
                    "path": [
                        "batches"
                    ]
                }
            },
            "response": []
        }
    ],
    "event": [
        {
            "listen": "prerequest",
            "script": {
                "id": "41bea1d0-278c-40c9-ad42-bf2e6268897d",
                "type": "text/javascript",
                "exec": [
                    ""
                ]
            }
        },
        {
            "listen": "test",
            "script": {
                "id": "3cdd7736-a885-4a2d-9668-bd75798f4560",
                "type": "text/javascript",
                "exec": [
                    ""
                ]
            }
        }
    ],
    "protocolProfileBehavior": {}
}
Futtassuk le az első kérést a gyűjteményből, lépjünk be az OKD felületére, és ellenőrizzük, hogy a feladat sikeresen elindult — https://{OKD-WEBUI-URL}/console/project/{project}/browse/pods. Ekkor a Livy felületén (http://{livy-url}/ui) megjelenik egy session, amelynek keretein belül a Livy API-n keresztül vagy grafikus felületen nyomon követhetjük a feladat végrehajtásának menetét, és a session logjait tanulmányozhatjuk.
Most bemutatjuk a Livy működési mechanizmusát. Ehhez megvizsgáljuk a Livy konténer naplóit a Livy szervert tartalmazó podban — https://{OKD-WEBUI-URL}/console/project/{project}/browse/pods/{livy-pod-name}?tab=logs. Ebből látható, hogy a Livy REST API meghívásakor a 'livy' nevű konténerben spark-submit fut, hasonlóan ahhoz, amit fentebb használtunk (itt {livy-pod-name} a Livy szervert tartalmazó pod neve). A gyűjteményben egy második kérés is szerepel, amely lehetővé teszi a Spark végrehajtható fájl távoli helyreállítását a Livy szerver segítségével.
A harmadik felhasználási lehetőség — Spark Operator
Most, hogy a feladatot teszteltük, felmerül a kérdés a rendszeres indításáról. A Kubernetes fürtön belüli feladatok rendszeres indításának natív módja a CronJob entitás, amely használható, de jelenleg nagyobb népszerűségnek örvend a Kubernetes alkalmazások kezelésére szolgáló operátorok használata, és a Spark számára létezik egy jól megvalósított operátor, amelyet többek között vállalati megoldásokban is használnak (például a Lightbend FastData Platformban). Javasoljuk ennek használatát — a jelenlegi stabil Spark verzió (2.4.5) meglehetősen korlátozott lehetőségeket kínál a Spark feladatok Kubernetesben való indításának konfigurálására, miközben a következő fő verzió (3.0.0) teljes Kubernetes támogatást ígér, de a megjelenésének dátuma továbbra is ismeretlen. A Spark Operator kompenzálja ezt a hiányosságot, fontos konfigurációs paramétereket adva hozzá (például a Hadoop hozzáférési konfigurációval kapcsolatos ConfigMap mappálása a Spark podokba) és a feladatok ütemezett rendszeres indításának lehetőségével.
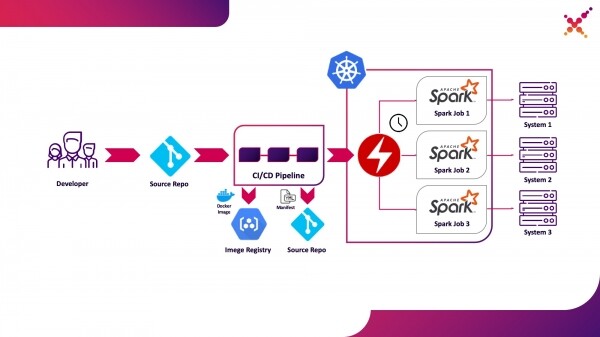
Harmadik felhasználási lehetőségként kiemeljük — a Spark feladatok rendszeres indítása a Kubernetes fürtön belül a termelési környezetben.
A Spark Operator nyílt forráskódú és a Google Cloud Platform keretein belül fejlesztik — . Telepítése háromféleképpen végezhető el:
- A Lightbend FastData Platform/Cloudflow telepítése keretében;
- Helm segítségével:
helm repo add incubator http://storage.googleapis.com/kubernetes-charts-incubator helm install incubator/sparkoperator --namespace spark-operator - Применением манифестов из официального репозитория (https://github.com/GoogleCloudPlatform/spark-on-k8s-operator/tree/master/manifest). При этом стоит отметить следующее — в состав Cloudflow входит оператор с версией API v1beta1. Если используется данный тип установки, то описания манифестов приложений Spark должны строиться на основе примеров из тегов в Git с соответствующей версией API, например, «v1beta1-0.9.0-2.4.0». Версию оператора можно посмотреть в описании CRD, входящего в состав оператора в словаре «versions»:
oc get crd sparkapplications.sparkoperator.k8s.io -o yaml
Если оператор установлен корректно, то в соответствующем проекте появится активный под с оператором Spark (например, cloudflow-fdp-sparkoperator в пространстве Cloudflow для установки Cloudflow) и появится соответствующий тип ресурсов Kubernetes с именем «sparkapplications». Изучить имеющиеся приложений Spark можно следующей командой:
oc get sparkapplications -n {project}
Для запуска задач с помощью Spark Operator требуется сделать 3 вещи:
- создать образ Docker, включающий в себя все необходимые библиотеки, а также конфигурационные и исполняемые файлы. В целевой картине это образ, созданный на этапе CI/CD и протестированный на тестовом кластере;
- опубликовать образ Docker в реестр, доступный из кластера Kubernetes;
- сформировать манифест с типом «SparkApplication» и описанием запускаемой задачи. Примеры манифестов доступны в официальном репозитории (например, ). Стоит отметить важные моменты касательно манифеста:
- в словаре «apiVersion» должна быть указана версия API, соответствующая версии оператора;
- в словаре «metadata.namespace» должно быть указано пространство имён, в котором будет запущено приложение;
- в словаре «spec.image» должен быть указан адрес созданного образа Docker в доступном реестре;
- в словаре «spec.mainClass» должен быть указан класс задачи Spark, который требуется запустить при запуске процесса;
- в словаре «spec.mainApplicationFile» должен быть указан путь к исполняемому jar файлу;
- в словаре «spec.sparkVersion» должна быть указана используемая версия Spark;
- в словаре «spec.driver.serviceAccount» должна быть указана сервисная учётная запись внутри соответствующего пространства имён Kubernetes, которая будет использована для запуска приложения;
- в словаре «spec.executor» должно быть указано количество ресурсов, выделяемых приложению;
- A "spec.volumeMounts" szótárban meg kell adni a helyi könyvtárat, ahol a Spark feladat helyi fájljai létrejönnek.
Példa a manifestus kialakítására (itt {spark-service-account} a Kubernetes klaszterben található szolgáltatási fiók, amely a Spark feladatok futtatásáért felel):
apiVersion: "sparkoperator.k8s.io/v1beta1"
kind: SparkApplication
metadata:
  name: spark-pi
  namespace: {project}
spec:
  type: Scala
  mode: cluster
  image: "gcr.io/spark-operator/spark:v2.4.0"
  imagePullPolicy: Always
  mainClass: org.apache.spark.examples.SparkPi
  mainApplicationFile: "local:///opt/spark/examples/jars/spark-examples_2.11-2.4.0.jar"
  sparkVersion: "2.4.0"
  restartPolicy:
    type: Never
  volumes:
    - name: "test-volume"
      hostPath:
        path: "/tmp"
        type: Directory
  driver:
    cores: 0.1
    coreLimit: "200m"
    memory: "512m"
    labels:
      version: 2.4.0
    serviceAccount: {spark-service-account}
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
  executor:
    cores: 1
    instances: 1
    memory: "512m"
    labels:
      version: 2.4.0
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
Ebben a manifestusban szerepel egy szolgáltatási fiók, amelyhez a manifestus közzététele előtt létre kell hozni a szükséges szerepkötéseket, hogy a Spark alkalmazás hozzáférjen a Kubernetes API-hoz (ha szükséges). Ebben az esetben az alkalmazásnak jogokra van szüksége a Pod-ok létrehozásához. Hozzuk létre a szükséges szerepkötést:
oc adm policy add-role-to-user edit system:serviceaccount:{project}:{spark-service-account} -n {project}
Érdemes megjegyezni, hogy a manifestus specifikációjában megadható a "hadoopConfigMap" paraméter, amely lehetővé teszi a Hadoop konfigurációs ConfigMap megadását anélkül, hogy a megfelelő fájlt előre a Docker képbe kellene helyezni. Ez a feladatok rendszeres ütemezésére is alkalmas — a "schedule" paraméter segítségével megadható a feladat végrehajtásának ütemezése.
Ezt követően mentjük a manifestusunkat a spark-pi.yaml fájlba, és alkalmazzuk a Kubernetes klaszterünkre:
oc apply -f spark-pi.yaml
Ezáltal létrejön egy "sparkapplications" típusú objektum:
oc get sparkapplications -n {project}
> NAME       AGE
> spark-pi   22h
Egy Pod is létrejön az alkalmazással, amelynek státusza megjelenik a létrehozott "sparkapplications"-ben. Ezt a következő parancs egyikével ellenőrizhetjük:
oc get sparkapplications spark-pi -o yaml -n {project}
A feladat befejeztével a POD állapota "Completed"-ra változik, ami a "sparkapplications"-ban is frissül. Az alkalmazás naplói a böngészőben vagy a következő parancs segítségével megtekinthetők (itt {sparkapplications-pod-name} a futó feladat podjának neve):
oc logs {sparkapplications-pod-name} -n {project}
A Spark feladatok kezelése a sparkctl speciális segédeszközével is elvégezhető. A telepítéséhez klónozzuk a forrástározót, telepítsük a Go-t, és állítsuk össze ezt a segédprogramot:
git clone https://github.com/GoogleCloudPlatform/spark-on-k8s-operator.git
cd spark-on-k8s-operator/
wget https://dl.google.com/go/go1.13.3.linux-amd64.tar.gz
tar -xzf go1.13.3.linux-amd64.tar.gz
sudo mv go /usr/local
mkdir $HOME/Projects
export GOROOT=/usr/local/go
export GOPATH=$HOME/Projects
export PATH=$GOPATH/bin:$GOROOT/bin:$PATH
go -version
cd sparkctl
go build -o sparkctl
sudo mv sparkctl /usr/local/bin
Nézzük meg az aktív Spark feladatok listáját:
sparkctl list -n {project}
Hozzunk létre egy leírást a Spark feladathoz:
vi spark-app.yaml
apiVersion: "sparkoperator.k8s.io/v1beta1"
kind: SparkApplication
metadata:
  name: spark-pi
  namespace: {project}
spec:
  type: Scala
  mode: cluster
  image: "gcr.io/spark-operator/spark:v2.4.0"
  imagePullPolicy: Always
  mainClass: org.apache.spark.examples.SparkPi
  mainApplicationFile: "local:///opt/spark/examples/jars/spark-examples_2.11-2.4.0.jar"
  sparkVersion: "2.4.0"
  restartPolicy:
    type: Never
  volumes:
    - name: "test-volume"
      hostPath:
        path: "/tmp"
        type: Directory
  driver:
    cores: 1
    coreLimit: "1000m"
    memory: "512m"
    labels:
      version: 2.4.0
    serviceAccount: spark
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
  executor:
    cores: 1
    instances: 1
    memory: "512m"
    labels:
      version: 2.4.0
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
Indítsuk el a leírt feladatot a sparkctl segítségével:
sparkctl create spark-app.yaml -n {project}
Nézzük meg az aktív Spark feladatok listáját:
sparkctl list -n {project}
Nézzük meg az elindított Spark feladat eseményeinek listáját:
sparkctl event spark-pi -n {project} -f
Nézzük meg az elindított Spark feladat állapotát:
sparkctl status spark-pi -n {project}
Végezetül nézzük meg a jelenlegi stabil Spark (2.4.5) Kubernetes alatt való használatának hátrányait:
- Az első és talán legfontosabb hátrány a Data Locality hiánya. Habár a YARN használatának számos hátránya volt, előnyei is akadtak, például a kód adatokhoz való eljuttatásának elve (nem pedig az adatok kódhoz való eljuttatása). Ennek köszönhetően a Spark feladatok a számításokban részt vevő adatok helyén futottak, ezzel jelentősen csökkentve az adatok hálózaton történő továbbításához szükséges időt. Kubernetes használata során azonban elkerülhetetlen a számításokhoz kapcsolódó adatok hálózaton történő mozgatása. Amennyiben ezek az adatok elég nagyok, a feladat végrehajtása jelentősen megnyúlhat, és elegendő mennyiségű lemezterület is szükséges a Spark feladatpéldányok ideiglenes tárolásához. Ez a hátrány csökkenthető specializált szoftverek, például az Alluxio alkalmazásával, amelyek biztosítják az adatok lokalitását Kubernetes esetén, de ez lényegében azt jelenti, hogy a Kubernetes klaszter csomópontjain teljes másolatot kell tárolni az adatokról.
- A második fontos hátrány a biztonság. Alapértelmezés szerint a Spark feladatok futtatásának biztonsági vonatkozásai ki vannak kapcsolva, a Kerberos használatára vonatkozó lehetőségek az hivatalos dokumentációban nem szerepelnek (bár a megfelelő paraméterek a 3.0.0 verzióban megjelentek, ami további kidolgozást igényel), és a Spark használata során a biztonsági irányelvek dokumentációjában (https://spark.apache.org/docs/2.4.5/security.html) a kulcs tárolók között csak a YARN, Mesos és Standalone Cluster szerepel. Ezenkívül a felhasználó, aki a Spark feladatokat futtatja, nem határozható meg közvetlenül — csupán egy szolgáltatói fiókot állítunk be, amely alatt a pod működni fog, a felhasználóról pedig a beállított biztonsági irányelvek alapján történik a választás. Ennek következtében vagy a root felhasználóval dolgozunk, ami nem biztonságos termelési környezetben, vagy egy véletlenszerű UID-vel rendelkező felhasználót használunk, ami nem praktikus az adatokhoz való hozzáférés jogainak elosztásakor (megoldható PodSecurityPolicies létrehozásával és azok hozzárendelésével a megfelelő szolgáltatói fiókokhoz). Jelenleg a szükséges fájlok közvetlenül a Docker képbe való elhelyezésével, vagy a Spark elindító scriptjének módosításával próbálják megoldani a helyzetet, hogy a szervezetének megfelelő titkos tárolási és megszerzési mechanizmust használják.
- A Spark feladatok Kubernetes általi indítása hivatalosan még mindig kísérleti módban van, és a jövőben jelentős változások várhatóak az alkalmazott artefaktokban (konfigurációs fájlok, alap Docker képek és indító szkriptek). Valóban - a jelenlegi anyag elkészítésekor a 2.3.0 és 2.4.5 verziók kerültek tesztelésre, és a viselkedés jelentősen eltért.
Várjuk az frissítéseket - nemrégiben kiadták a Spark legújabb verzióját (3.0.0), amely érzékelhető változásokat hozott a Spark Kubernetes alatti működésében, de továbbra is megőrizte a kísérleti támogatás státuszát ezen erőforrás-kezelő számára. Lehetséges, hogy a következő frissítések valójában lehetővé teszik, hogy teljes mértékben ajánljuk a YARN elhagyását, és Spark feladatokat indítsunk Kubernetes alatt, anélkül hogy a rendszer biztonságáért kellene aggódnunk, és anélkül hogy saját fejlesztést igényelnénk a funkcionális komponensekhez.
Fin.
Forrás: habr.com
