

Helló, Habr.
A nevem Misha Butrimov, és szeretnék egy kicsit mesélni a Cassandráról. A történetem hasznos lesz azok számára, akik soha nem találkoztak NoSQL adatbázisokkal — rengeteg megvalósítási sajátossága és buktatója van, amiről tudni érdemes. Ha csak az Oracle-lal vagy bármilyen más relációs adatbázissal ismerkedtél meg, ezek a dolgok megmenthetik az életed.
Miben jó a Cassandra? Ez egy NoSQL adatbázis, amelyet úgy terveztek, hogy ne legyen egyetlen hibapontja, és jól skálázható. Ha pár terabájtot szeretnél hozzáadni az adatbázishoz, egyszerűen csak új csomópontokat adsz a gyűrűhöz. Szeretnéd egy új adatközponttal bővíteni? Csomópontokat adsz a klaszterhez. Növelni akarod a feldolgozható RPS-t? Új csomópontokat adsz a klaszterhez. Visszafelé is működik.
Miben még jó? Abban, hogy rengeteg kérést tud kezelni. De mennyi az sok? 10, 20, 30, 40 ezer kérés másodpercenként — ez még nem sok. 100 ezer kérés másodpercenként íráskor — szintén. Vannak cégek, amelyek azt állítják, hogy 2 millió kérést tartanak másodpercenként. Nos, nekik talán el kellene hinni.
Alapvetően a Cassandra-nak van egy nagy különbsége a relációs adatoktól — hogy egyáltalán nem hasonlít rájuk. Ezt fontos mindig észben tartani.
Nem minden, ami egyformának tűnik, működik is egyformán.
Egyszer egy kollégám hozzám jött, és megkérdezte: „Itt van az SQL Cassandra lekérdező nyelv, van benne select utasítás, van benne where, van benne and. Írom a betűket, és nem működik. Miért?”. Ha a Cassandrát relációs adatbázisként kezeled, akkor ez a legjobb módja annak, hogy brutális öngyilkosságot kövess el. És nem népszerűsítem, ez Oroszországban tilos. Csak egyszerűen valamit rosszul fogsz tervezni.
Például, ha egy ügyfél azt mondja nekünk: „Építsünk egy adatbázist sorozatok számára, vagy egy adatbázist receptkönyvhöz. Lesznek benne ételek hozzávalókkal vagy sorozatok és színészek listája.” Mi örömmel mondjuk: „Tökéletes!”. Ez két bájt átkonvertálni, pár tábla, és már kész is van, minden nagyon gyorsan és megbízhatóan fog működni. És minden csodálatos, amíg az ügyfelek meg nem jelennek, és nem mondják, hogy a háziasszonyok a visszafordított feladatot akarják megoldani: van egy hozzávalóik listájuk, és szeretnék tudni, milyen ételt akarnak főzni. Megölted magad.
Mindez azért van, mert a Cassandra hibrid adatbázis: egyszerre key-value és széles oszlopokban tárolja az adatokat. Java vagy Kotlin nyelven ezt így lehetne leírni:
Map<RowKey, SortedMap<ColumnKey, ColumnValue>>
Tehát egy térkép, amely belül még egy rendezett térképet tartalmaz. Ennek a térképnek az első kulcsa a Row key vagy Partition key — a partícionálási kulcs. A második kulcs, amely a már rendezett térképre vonatkozik, a Clustering key.
A bázisadatok eloszlásának szemléltetésére rajzoljunk három csomópontot. Most meg kell értenünk, hogyan oszthatjuk el az adatokat a csomópontok között. Mert ha mindent egybe nyomunk (amiből, mellesleg, lehet ezer, kétezer, öt — akármennyi), az nem nagyon a megosztásról szól. Ezért szükségünk van egy matematikai funkcióra, amely visszaad egy számot. Csak egy szám, egy hosszú int, ami egy adott tartományba esik. Az egyik csomópontunk felel egy tartományért, a második egy másikért, az n-edik pedig az n-edikért.
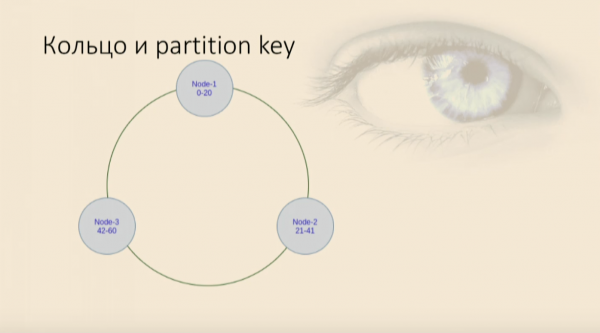
Ez a szám egy hash funkció segítségével kerül meghatározásra, amely éppen arra vonatkozik, amit Partition key-nek nevezünk. Ez az oszlop szerepel az alapkulcs (Primary key) direktívájában, és ez az oszlop lesz a mappa első és legfontosabb kulcsa. Meghatározza, hogy mely adatok kerüljön a csomópontokra. A táblázat néhányahoz hasonló szintaxissal jön létre a Cassandraban, mint az SQL-ben:
CREATE TABLE users (
	user_id uuid,
	name text,
	year int,
	salary float,
	PRIMARY KEY(user_id)

)
Az alapkulcs ebben az esetben egyetlen oszlopból áll, és ez az oszlop is egyben a partícionálási kulcs.
Hogyan oszlanak el a felhasználók? Egy részük egy csomópontba kerül, egy részük egy másikba, és egy részük a harmadikba. Ez egy hagyományos hash-táblát eredményez, amely egy térkép, Pythonban egy szótár, és egy egyszerű key-value struktúra, amelyből minden értéket olvashatunk, olvashatunk és írhatunk a kulcs alapján.
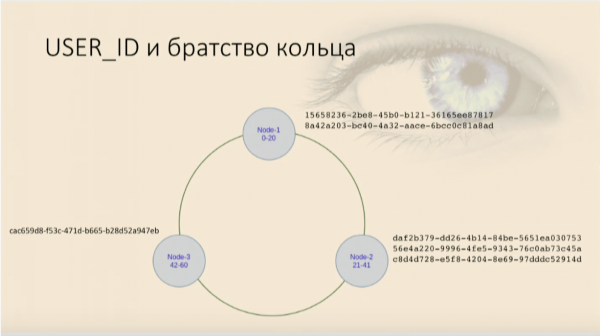
Select: amikor az allow filtering teljes kereséssé alakul, vagy hogyan ne csináljuk
Írjunk valamilyen select utasítást: select * from users where userid = . Úgy tűnik, mint az Oracle-ban: írunk egy select-et, megadjuk a feltételeket, és minden működik, a felhasználók megjelennek. De ha például egy konkrét születési évű felhasználót választunk ki, a Cassandra panaszkodik, hogy nem tudja végrehajtani a lekérdezést. Mert nem tud semmit arról, hogyan oszlanak meg az adataink a születési évről - csak egy oszlop van megadva kulcsként. Aztán azt mondja: „Rendben, még mindig végrehajthatom ezt a lekérdezést. Adjon hozzá engedélyezett szűrést.” Hozzáadjuk a direktívát, minden működik. És ebben a pillanatban valami szörnyű történik.
Amikor tesztadatokkal dolgozunk, minden szuper. De amikor egy lekérdezést hajtunk végre a termelésben, ahol például 4 millió rekordunk van, akkor nem áll minden jól. Mert az engedélyezett szűrés egy direktíva, amely lehetővé teszi, hogy a Cassandra összegyűjtse az összes adatot ebből a táblából minden node-ról, minden adatközpontok (ha sok van ebből a klaszterben), és csak ezután szűrhetjük le. Ez egy Full Scan analógiája, és valószínűleg senki sem lelkesedik érte.
Ha csak az azonosítók alapján lenne szükségünk a felhasználókra, az megfelelne nekünk. De néha más lekérdezéseket kell írnunk, és más korlátozásokat kell alkalmaznunk a kiválasztásra. Ezért emlékezünk: ez mind egy térkép, amelynek van egy partíciós kulcsa, de belül egy rendezett térkép van.
És ennek is van egy kulcsa, amit Kluszterezési Kulcsnak nevezünk. Ez a kulcs, amely viszont oszlopokból áll, amelyeket kiválasztunk, és amelynek segítségével a Cassandra megérti, hogyan rendelje fizikai szempontból az adatokat, és hol lesznek ezek minden node-on. Tehát egy adott Partíció kulcs esetén a Kluszterezési kulcs elmondja, hogyan kell az adatokat beilleszteni ebbe a fába, és hol fognak elhelyezkedni.
Ez valóban egy fa, ahol csak hívjuk a komparátort, amelybe átadunk egy bizonyos oszlopcsoportot objektum formájában, és azt is oszlopok felsorolásaként határozzuk meg.
CREATE TABLE users_by_year_salary_id (
	user_id uuid,
	name text,
	year int,
	salary float,
	PRIMARY KEY((year), salary, user_id)
Figyeljen a Primary key direktívára, amelynek első argumentuma (jelen esetben az év) mindig Partition key. Ennek egy vagy több oszlopból kell állnia, ez nem számít. Ha több oszlop van, akkor azt még egyszer zárójelbe kell tenni, hogy a nyelv pre-processzora megértse, hogy ez valóban Primary key, utána jönnek a többi oszlop — Clustering key. Ezek a komparátorban abban a sorrendben fognak átkerülni, ahogy állnak. Tehát az első oszlop fontosabb, a második — kevésbé fontos és így tovább. Ahogyan a data class-okban írjuk, például az equals mezőket: felsoroljuk a mezőket, és megadjuk, hogy melyik az erősebb, és melyik a gyengébb. A Cassandraban ezek, mondhatni, a data class mezők, amelyekhez az equals műveletet alkalmazni fogják.
Beállítjuk a rendezést, korlátozásokat alkalmazunk.
Fontos megjegyezni, hogy a rendezési sorrendet (csökkenő, növekvő, mindegy) abban a pillanatban határozzuk meg, amikor a kulcsot létrehozzuk, és ezt később már nem tudjuk megváltoztatni. Ez fizikailag meghatározza, hogy hogyan fognak a adatok rendeződni és hogyan fognak elhelyezkedni. Ha változtatni kell a Clustering key-n vagy a rendezési sorrenden, új táblát kell létrehozni és az adatok átöntése szükséges. A már létezőkkel ez nem fog menni.
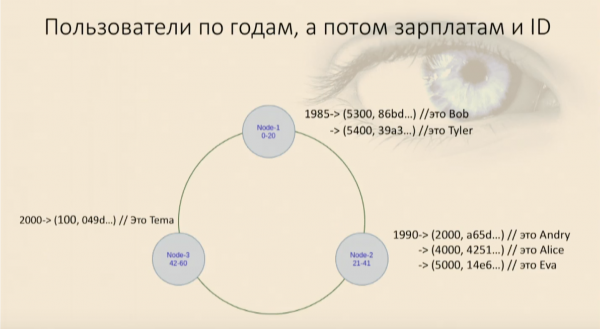
Kitöltöttük a táblázatunkat felhasználókkal, és láttuk, hogy először évszám szerint, majd minden noden belül bér és felhasználói azonosító szerint helyezkednek el. Most már kérhetjük az adatokat, korlátozások beállításával.
Újra megjelenik a működőnk. hol, és, és a felhasználóink megkapják, és minden újra jól van. De ha csak a Clustering key egy részét próbáljuk használni, ráadásul a kevésbé fontos részét, akkor a Cassandra azonnal kifogásolja, hogy nem találja a térképen azt a helyet, ahol ennek az objektumnak, amelynek ezek a mezői a komparátorban nullak, és ennek, amit most adtunk meg — hol található. Újra fel kell emelnem az összes adatot erről a nodáról és szűrni kell őket. Ez a node keretén belüli Full Scan hasonlata, ami rossz.
Bármilyen zavaros helyzetben hozz létre új táblát.
Ha lehetőségünk van felhasználókat ID, életkor vagy bér alapján elérni, mit tegyünk? Semmit. Csak használjunk két táblát. Ha három különböző módon kell felhasználókat elérni — három táblára lesz szükség. Elmúltak azok az idők, amikor helyet spóroltunk a merevlemezen. Ez a legolcsóbb erőforrás. Sokkal olcsóbb, mint a válaszidő, ami a felhasználónak romboló lehet. Sokkal kellemesebb a felhasználónak, ha valamit másodpercek alatt megkap, mint 10 perc alatt.
Kicseréljük a felesleges helyet, denormalizált adatokat a jó skálázhatóság és megbízható működés lehetőségére. Valójában egy három adatközpontból álló klaszter, amelyben öt csomópont van mindegyikben, megfelelő adatmegtartási szint mellett (amikor biztosan semmi nem veszhet el) képes túlélni egy teljes adatközpont halálát. Ráadásul még két csomópont is megmarad a két fennmaradó adatközpontban. Csak ezt követően kezdődnek a problémák. Ez egy meglehetősen jó tartalék, ami néhány extra SSD-tárolót és processzort igényel. Ezért, hogy használhassuk a Cassandra-t, amely egyáltalán nem SQL, és ahol nincsenek kapcsolatok, külső kulcsok, tudnunk kell néhány egyszerű szabályt.
Mindig a lekérdezésből tervezzük a dolgokat. Nem az adatok a legfontosabbak, hanem az, hogy az alkalmazás hogyan fog velük dolgozni. Ha különböző módon kell megszereznünk különböző adatokat, vagy ugyanazokat az adatokat különböző módokon, úgy kell elhelyeznünk őket, hogy az kényelmes legyen az alkalmazás számára. Ellenkező esetben a Full Scan-be csúszunk, és a Cassandra semmilyen előnyt nem fog adni.
A denormalizált adatok normának számítanak. Elfelejtjük a normál formákat, mert már nincsenek relációs adatbázisaink. Tegyünk valamit 100-szor, azt 100-szor tároljuk. Ez még mindig olcsóbb, mint lassítani a rendszert.
A partícionálási kulcsokat úgy választjuk meg, hogy normálisan eloszoljanak. Nincs szükség arra, hogy a kulcsaink hash-értéke egy szűk tartományba essen. Vagyis a születési év a fenti példában — rossz példa. Helyes, ha a felhasználóink a születési évük alapján normálisan eloszlanak, és rossz, ha ötödikes diákokról van szó — ott nem lesz túl jó a partícionálás.
A rendezés a Clustering Key létrehozásának szakaszában egyszer választható. Ha módosítani kell, át kell töltenünk a táblázatunkat egy másik kulccsal.
És a legfontosabb: ha száz különböző módon kell lekérdeznünk ugyanazokat az adatokat, akkor száz különböző táblánk lesz.
Forrás: habr.com
