

Bármely nagy adatkezelés jelentős számítási kapacitást igényel. Az adatok normál áthelyezése egy Hadoop adatbázisból hetekig tarthat, vagy annyiba kerül, mint egy repülőgép szárnya. Nem szeretne várni és költségesen költekezni? Egyensúlyozza a terhelést különböző platformok között. Az egyik módja a pushdown-optimalizálás.
Megkértem Oroszország vezető Informatica termékfejlesztési és adminisztrációs edzőjét, Alexej Ananyevot, hogy meséljen a pushdown-optimalizálás funkciójáról az Informatica Big Data Management (BDM) rendszerében. Tanult valaha Informatica termékek használatáról? Valószínűleg Alexej mutatta be Önnek a PowerCenter alapjait, és magyarázta el, hogyan kell térképezéseket készíteni.
Alexej Ananyev, a DIS Group képzési osztályának vezetője
Mi az a pushdown?
Sokan már ismerik az Informatica Big Data Management (BDM) rendszert. A termék képes integrálni a nagy adatokat különböző forrásokból, áthelyezni azokat különböző rendszerek között, könnyű hozzáférést biztosítani, profilozni őket és még sok mást.
Ügyes kezekben a BDM csodákra képes: a feladatok gyorsan és minimális számítási erőforrással valósulnak meg.
Ön is így szeretné? Tanulja meg a pushdown funkció használatát a BDM-ben a számítási terhelés különböző platformok közötti elosztásához. A pushdown technológia lehetővé teszi, hogy a térképezést szkriptté alakítsuk, és válasszunk egy környezetet, amelyben ez a szkript fut. Az ilyen választás lehetősége lehetővé teszi különböző platformok erősségeinek kombinálását és maximális teljesítmény elérését.
A szkript futtatási környezetének beállításához ki kell választania a pushdown típusát. A szkript teljes mértékben futtatható Hadoop-on vagy részben elosztható a forrás és a fogadó között. Négyféle pushdown típus létezik. A térképezést nem kell szkriptté alakítani (natív). A térképezés maximálisan futtatható a forráson (forrás) vagy teljes egészében a forráson (teljes). A térképezés átalakítható Hadoop szkriptté is (nincs).
Pushdown-optimalizálás
A felsorolt négy típust különböző módon lehet kombinálni – optimalizálni a pushdown-t a rendszer konkrét igényeihez. Például gyakran indokoltabb az adatokat az adatbázisból kinyerni, saját képességeit felhasználva. Ezen adatok átalakítását pedig Hadoop-ra bízni, hogy ne terheljük túl magát az adatbázist.
Nézzük meg azt az esetet, amikor mind a forrás, mind a fogadó az adatbázisban található, és a végrehajtás platformját választhatjuk: a beállításoktól függően ez lehet Informatica, egy adatbázis szerver vagy Hadoop. Ez a példa lehetővé teszi a mechanizmus technikai oldalának legpontosabb megértését. Természetesen a valós életben ilyen helyzet nem fordul elő, de a funkció bemutatására ez a lehető legjobban megfelel.
Vegyük a leképezést, amely két táblát olvas egy egységes Oracle adatbázisból. Az olvasási eredmények pedig legyenek rögzítve ugyanezen adatbázis egy táblájába. A leképezés sémája a következő lesz:
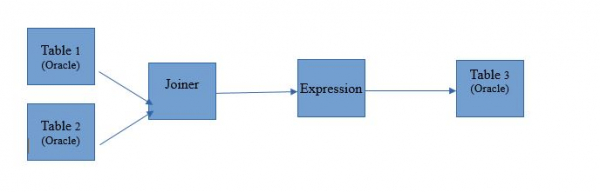
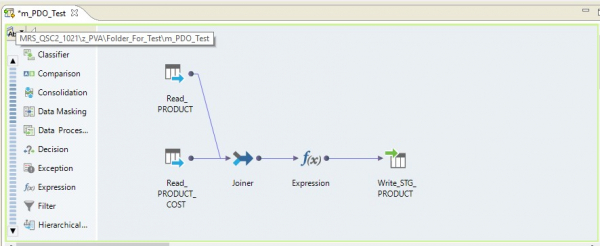
Informatica BDM 10.2.1 formájában ez így néz ki:
Pushdown típus – natív
Ha a natív pushdown típusát választjuk, akkor a leképezés Informatica-n kerül végrehajtásra. szerveren Az adatok az Oracle szerverről lesznek olvasva, átkerülnek az Informatica szerverére, ott átalakulnak, majd átkerülnek a Hadoop-ra. Más szavakkal, egy hagyományos ETL folyamatot kapunk.
Pushdown típus – forrás
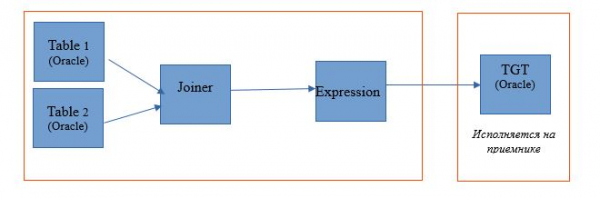
A forrás típusának választásával lehetőségünk van a folyamatunkat elosztani szerverrel az adatbázisok (DB) és a Hadoop között. Ezzel a beállítással végrehajtott folyamat során a táblákból adatok lekérésére irányuló lekérdezések fognak indulni az adatbázisba. A többi lépés pedig Hadoop-on valósul meg.
A végrehajtás sémája a következőképpen fog kinézni:
Lent található egy példa a végrehajtási környezet beállítására.
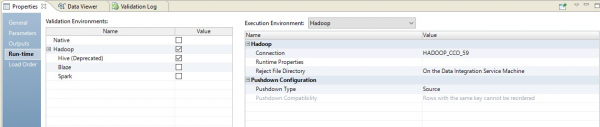
Ebben az esetben a leképezés két lépésben fog végrehajtásra kerülni. A beállításaiban azt fogjuk látni, hogy scriptként alakul, amely a forrásra kerül elküldésre. A táblák egyesítése és az adatok átalakítása pedig egy felülírt lekérdezés formájában fog megtörténni a forráson.
Az alábbi képen a BDM optimalizált leképezését látjuk, miközben a forráson egy felülírt lekérdezés található.
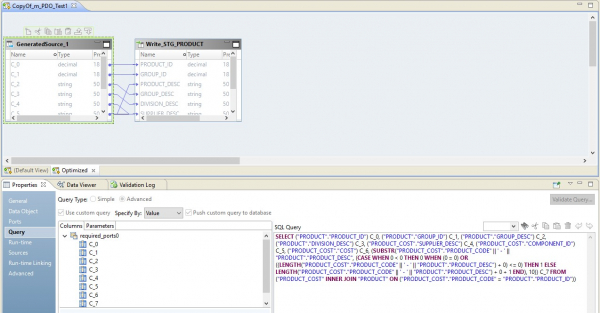
Hadoop szerepe ebben a konfigurációban a adatfolyam kezelésére – azok irányítására – korlátozódik. A lekérdezés eredménye a Hadoop-ra kerül. Az olvasás befejezése után a fájl a Hadoop-ból a fogadóhoz lesz rögzítve.
Pushdown típus – teljes
A teljes pushdown típusának választásával a leképezés teljesen lekérdezéssé alakul az adatbázison. A lekérdezés eredménye Hadoop-ra kerül. Ennek a folyamatnak a sémája alább látható.
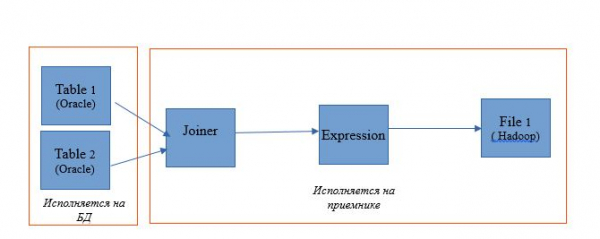
A beállítás példa lent található.
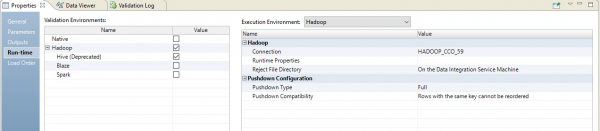
Ennek eredményeként egy optimalizált leképezést kapunk, amely hasonlít az előzőre. A különbség mindössze annyi, hogy a logika teljes mértékben átkerül a fogadóhoz, mint felülírás formájában. Az optimalizált leképezés példája lent látható.
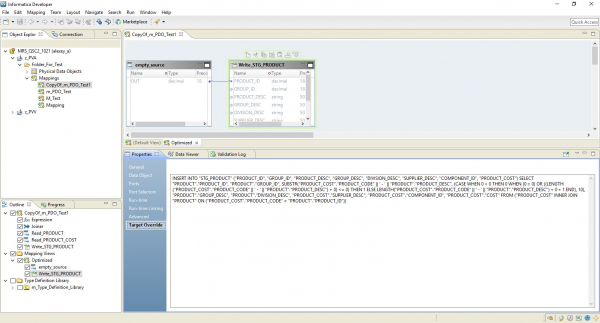
Itt, ahogy az előző esetben is, a Hadoop dirigens szerepét tölti be. De itt az adatforrást teljes egészében olvassák be, majd a feldolgozás logikája a vevő oldalon valósul meg.
Pushdown típus – null
A legutolsó lehetőség egy pushdown típus, amelynek keretein belül a térképünk Hadoop szkriptté alakul.
Az optimalizált térkép most így fog kinézni:
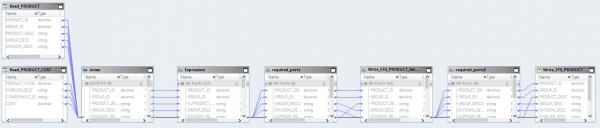
Itt az adatokat először fájlokból olvassák be a Hadoop rendszerén. Ezután ezzel a rendszerrel egyesítik a két fájlt. Ezt követően az adatokat átalakítják és betöltik az adatbázisba.
A pushdown optimalizáció elveinek megértésével nagyon hatékonyan szervezhetjük a nagy adatokkal végzett műveleteket. Nemrégiben egy nagyvállalat mindössze néhány hét alatt ki tudta exportálni a Hadoop-ból azokat a nagy adatokat, amelyeket addig évekig gyűjtöttek.
Forrás: habr.com
