

Helló, Habr! Örömmel mutatom be az írás fordítását.
.
Amikor a relációs adatbázisokra gondolok, nem tudom nem észrevenni, hogy valami hiányzik. Mindenhol használják őket. Számos különböző adatbázis létezik: a kis hasznos SQLite-tól a nagy teljesítményű Teradata-ig. De csak néhány cikk magyarázza el, hogyan működik egy adatbázis. Kereshet a "howdoesarelationaldatabasework" ("hogyan működnek a relációs adatbázisok") kifejezésre, hogy lássa, mennyire kevés az eredmény. Ezen kívül ezek a cikkek általában rövidek. Ha pedig a legújabb divatos technológiákat keresed (BigData, NoSQL vagy JavaScript), több részletes cikket találsz, amelyek elmagyarázzák, hogyan működnek.
Túl régiek és unalmasak a relációs adatbázisok ahhoz, hogy azokat egyetemi kurzusokon, kutatási munka keretein belül vagy könyvekben magyarázzák el?
Fejlesztőként utálom használni azt, amit nem értek. És ha az adatbázisokat több mint 40 éve használják, annak oka kell, hogy legyen. Az évek során több száz órát fordítottam arra, hogy igazán megértsem ezeket a furcsa fekete dobozokat, amelyeket nap mint nap használok. Relációs adatbázisok nagyon érdekesek, mert hasznos és többször felhasználható koncepciókra alapoznak.Ha érdekel az adatbázisok megértése, de soha nem volt időd vagy kedved belemerülni ebbe a széles témába, tetszeni fog ez a cikk.
Bár a cikk címének egyértelműnek kell lennie, a cikk célja nem az, hogy megértsd, hogyan kell használni egy adatbázist.Ezért már tudnod kell, hogyan kell egyszerű csatlakozási lekérdezéseket és alaplekérdezéseket írni. CRUD; különben nem tudod követni ezt a cikket. Ez az egyetlen, amit tudnod kell, a többit elmagyarázom.
Kezdjük néhány alapvető számítástechnikai fogalommal, mint például az algoritmusok időbeli komplexitása (BigO). Tudom, hogy néhányan utáljátok ezt a fogalmat, de nélküle nem fogjátok tudni megérteni az adatbázison belüli finomságokat. Mivel ez hatalmas téma, a fontos dolgokra fogok összpontosítani, amit fontosnak tartok: hogyan dolgozza fel az adatbázis SQL kérelmet. Csak az adatbázis alapvető koncepcióit fogom bemutatni,hogy a cikk végére képet kapj arról, mi zajlik a háttérben.
Mivel ez egy hosszú és technikai cikk, amely számos algoritmust és adatstruktúrát tartalmaz, ne sietjen az olvasással. Egyes fogalmak nehezen érthetők lehetnek; kihagyhatja őket, és mégis általános képet kaphat.
Azok számára, akik jobban tájékozottak, ez a cikk három részre oszlik:
- Az alacsony és magas szintű adatbázis-komponensek áttekintése
- A lekérdezések optimalizálási folyamatának áttekintése
- A tranzakciókezelés és a pufferpool áttekintése
Visszatérés az alapokhoz
Sok évvel ezelőtt (egy messzi-messzi galaxisban...) a fejlesztőknek pontosan tudniuk kellett, hány műveletet kódolnak. Fejből kellett ismerniük algoritmusaikat és adatstruktúráikat, mert nem engedhették meg maguknak, hogy pazarolják a lassú számítógépeik CPU-ját és memóriáját.
Ebben a részben emlékeztetni fogom Önöket néhány ezekre a fogalmakra, mivel szükségesek az adatbázis megértéséhez. Be fogom mutatni a adatbázis-index fogalmát.
O(1) vs O(n2)
Manapság sok fejlesztő nem törődik az algoritmusok időbeli összetettségével... és igazuk van!
De amikor nagy mennyiségű adatokkal dolgozik (nem csak ezrek), vagy ha egy milliszekundumért küzd, kritikus fontosságú megérteni ezt a fogalmat. És ahogy érti, az adatbázisoknak mindkét helyzettel foglalkozniuk kell! Nem akarom, hogy több időt pazaroljon, mint ami szükséges az alapok megértéséhez. Ez segíteni fog később a költségalapú optimalizálás fogalmának megértésében (cost based optimization).
Koncepció
Az algoritmus időbeli összetettsége arra szolgál, hogy lássa, mennyi időt vesz igénybe az algoritmus végrehajtása egy adott mennyiségű adat esetén.E komplexitás leírására a nagy O matematikai jelöléseket használják. Ez a jelölés egy olyan függvénnyel használatos, amely leírja, hány műveletet igényel az algoritmus egy adott mennyiségű bemeneti adat esetén.
Például, amikor azt mondom, hogy "ez az algoritmus O (some_function()) komplexitással rendelkezik", az azt jelenti, hogy egy bizonyos mennyiségű adatok feldolgozásához az algoritmusnak some_function(a_certain_amount_of_data) műveletre van szüksége.
Ez idő alatt fontos, hogy nem az adatok mennyisége**, hanem az, ** hogyan növekszik a műveletek száma az adatmennyiség növekedésével. Az időbeli összetettség nem ad pontos műveletmennyiséget, de jó módja a végrehajtási idő becslésének.
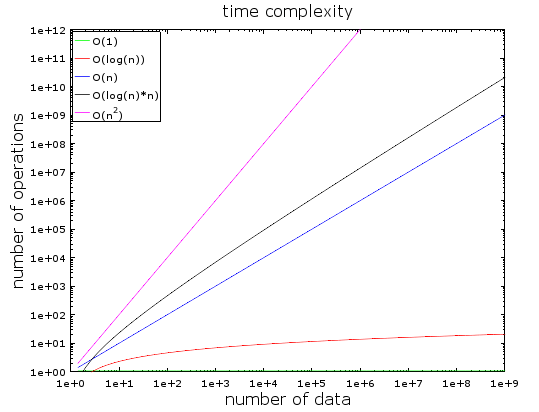
Ez a grafikon azt mutatja, hogy a műveletek száma hogyan függ az input adatok mennyiségétől különböző algoritmikus időkomplexitások esetében. Logaritmikus skálát használtam ennek ábrázolására. Más szavakkal, az adatok mennyisége gyorsan növekszik 1-től 1 milliárdig. Az alábbiakat láthatjuk:
- O(1) vagy állandó komplexitás állandó marad (különben nem neveznénk állandónak).
- O(naplózás(n)) marad alacsony még milliárdnyi adat esetén is.
- A legrosszabb eset komplexitása — O(n2), ahol a műveletek száma gyorsan növekszik.
- Két másik komplexitás szintén gyorsan növekszik.
Példák
Kis adatmennyiségnél az O(1) és O(n2) közötti különbség elhanyagolható. Például feltételezzük, hogy van egy algoritmus, amely 2000 elemet kell feldolgoznia.
- Az O(1) algoritmus 1 műveletet igényel
- Az O(log(n)) algoritmus 7 műveletbe kerül
- Az O(n) algoritmus 2000 műveletbe kerül
- Az O(n * log(n)) algoritmus 14 000 műveletbe kerül
- Az O(n2) algoritmus 4 000 000 műveletet igényel
A különbség az O(1) és O(n2) között nagyobbnak tűnik (4 millió művelet), de maximum 2 ms-t veszítesz, ami körülbelül a szemhéj villanásának ideje. Valójában a modern processzorok képesek . Ezért a teljesítmény és az optimalizálás nem probléma sok IT-projektben.
Ahogy már említettem, még mindig fontos tudni ezt a koncepciót hatalmas adatmennyiségek kezelésekor. Ha ez alkalommal az algoritmusnak 1 000 000 elemet kell feldolgoznia (ami nem olyan sok egy adatbázis számára):
- Az O(1) algoritmus 1 műveletet igényel
- Az O(log(n)) algoritmus 14 műveletbe kerül
- Az O(n) algoritmus 1 000 000 műveletbe kerül
- Az O(n * log(n)) algoritmus 14 000 000 műveletbe kerül
- Az O(n2) algoritmus 1 000 000 000 000 műveletet igényel
Nem végeztem számításokat, de azt mondanám, hogy az O(n2) algoritmussal van időd megunni a kávédat (sőt akár kettőt is!). Ha még egy nullát adsz az adatmennyiséghez, lesz időd egy szundira.
Nézzük mélyebben
Tatkozat:
- Jó hash-táblában az elem O(1) idő alatt megtalálható.
- A jól kiegyensúlyozott fában az eredményt O(log(n)) idő alatt kapjuk.
- Tömbben az eredmény O(n) idő alatt érhető el.
- A legjobb rendezési algoritmusok O(n * log(n)) komplexitással rendelkeznek.
- A rossz rendezési algoritmus O(n2) komplexitású.
Megjegyzés: a következő részekben ezeket az algoritmusokat és adatstruktúrákat fogjuk látni.
Többféle algoritmus időbeli összetettsége létezik:
- átlagos eset szcenárió
- legjobban alakuló eset
- és legrosszabb szcenárió
Az időbeli összetettség gyakran a legrosszabb forgatókönyvet jelenti.
Csak az algoritmus időbeli összetettségéről beszéltem, de az összetettség a következőkre is vonatkozik:
- az algoritmus memóriafogyasztására
- az algoritmus lemez I/O fogyasztására
Természetesen léteznek olyan összetettségek, amelyek rosszabbak, mint n2, például:
- n4: ez szörnyű! Néhány a megnevezett algoritmusok közül ilyen összetettséggel rendelkezik.
- 3n: ez még rosszabb! Az egyik algoritmus, amelyet a cikk közepén látni fogunk, ilyen összetettséggel bír (és valóban sok adatbázisban használják).
- n faktoriál: soha nem fogja megkapni az eredményeit, még kis adatmennyiség mellett sem.
- nn: ha ilyen összetettséggel találkozik, akkor meg kell kérdeznie magától, hogy valóban ez a területe …
Megjegyzés: csak egy ötletet adtam a „nagy O” jelölés valós definíciójáról. Valódi (aszimptotikus) definíciót olvashat itt a tényleges meghatározás érdekében.
MergeSort (Összevonásos rendezés)
Mit tesz, amikor szüksége van egy gyűjtemény rendezésére? Mit? Hívja a sort() függvényt… Oké, jó válasz… De az adatbázisok esetében meg kell értenie, hogyan működik ez a sort() függvény.
Több jó rendezési algoritmus létezik, ezért a legfontosabbra fogok összpontosítani: összevonásos rendezés. Talán most nem érti, hogy miért hasznos az adatok rendezése, de majd megérti, miután a lekérdezések optimalizálására vonatkozó rész következik. Ráadásul az összevonásos rendezés megértése segít megérteni az adatbázisok általános join műveletét, ami merge join (összevonásos egyesítés).
Merge (Egyesítés)
Mint sok hasznos algoritmus, az összevonásos rendezés is egy trükkre épül: két rendezett, N/2 méretű tömb egyesítése egy N elemű rendezett tömbbé mindössze N műveletbe kerül. Ezt az operációt egyesítésnek hívják.
Nézzük meg, mit jelent ez egy egyszerű példával:
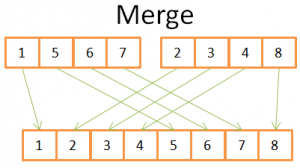
A képen látható, hogy a végső 8 elemű rendezett tömb felépítéséhez elegendő csak egyszer iterálni a két, 4 elemű tömbön. Mivel mindkét 4 elemű tömb már rendezett:
- 1) összehasonlítja a két aktuális elemet a két tömbben (az elején a jelenlegi = az elsőhöz)
- 2) ezután vedd el a legkisebb elemet, hogy az egy 8 elemű tömbbe kerüljön
- 3) és menj a következő elemhez a tömbben, ahol a legkisebb elemet vetted
- és ismételd a 1, 2, 3 lépéseket, amíg el nem érsz a tömbök egyike utolsó eleméhez.
- Ezután az egy másik tömb többi elemét veszed, hogy az egy 8 elemű tömbbe kerüljön.
Ez működik, mert mindkét 4 elemű tömb rendezett, így nem kell 'visszamenni' ezekben a tömbökben.
Most, hogy megértettük ezt a trükköt, itt van a merge pszeudokódja:
array mergeSort(array a)
   if(length(a)==1)
      return a[0];
   end if

   //rekurzív hívások
   [left_array right_array] := split_into_2_equally_sized_arrays(a);
   array new_left_array := mergeSort(left_array);
   array new_right_array := mergeSort(right_array);

   //az 2 kis rendezett tömb egyesítése egy nagyba
   array result := merge(new_left_array,new_right_array);
   return result;
A merge sort felosztja a feladatot kisebb feladatokra, majd megtalálja a kisebb feladatok eredményeit, hogy megkapja a kiindulási feladat eredményét (megjegyzés: ezt a fajta algoritmust oszd és uralkodj algoritmusnak hívják). Ha nem érted ezt az algoritmust, ne aggódj; én sem értettem elsőre, amikor láttam. Ha segíthet, úgy látom ezt az algoritmust, mint egy kétfázisú algoritmust:
- A felosztás fázisa, ahol a tömb kisebb tömbökre oszlik
- A rendezési fázis, ahol a kis tömbök összeolvadnak (junózással), hogy egy nagyobb tömböt alkossanak.
Felosztási fázis
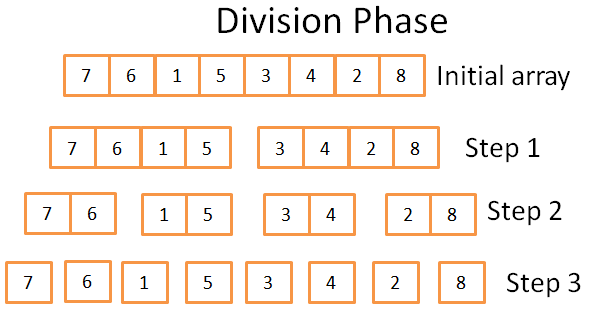
A felosztási szakaszban a tömb 3 lépésben oszlik egységes tömbökre. A lépések formális száma log(N) (mivel N=8, log(N) = 3).
Honnan tudom ezt?
Géniusz vagyok! Egy szóban - matematika. Az ötlet az, hogy minden lépés felosztja az eredeti tömb méretét 2-gel. A lépések száma az a szám, ahányszor az eredeti tömböt ketté tudod osztani. Ez a logaritmus pontos definíciója (alapja 2-vel).
Rendezési fázis
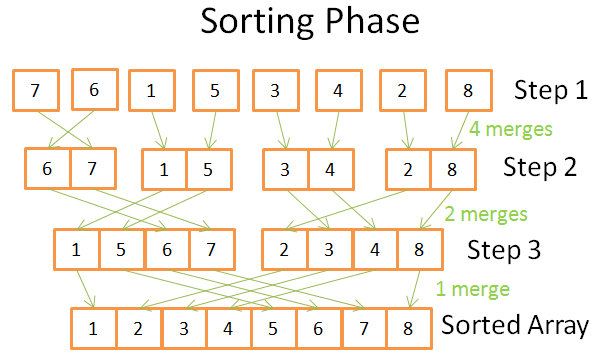
A rendezési fázisban egységes (egy elemű) tömbökkel kezded. Minden lépésben több egyesítési műveletet alkalmazol, és az összköltség N = 8 műveletet jelent:
- Az első lépésben 4 egyesítésed van, amelyek mindegyike 2 műveletbe kerül
- A második lépésben 2 egyesítésed van, amelyek mindegyike 4 műveletbe kerül
- A harmadik lépésben 1 egyesítésed van, amely 8 műveletet igényel
Mivel log (N) lépés van, az összköltség N * log(N) művelet.
A merge sort előnyei
Miért olyan erős ez az algoritmus?
Mert:
- Módosíthatja úgy, hogy csökkentse a memóriahasználatot, így nem új tömböket hoz létre, hanem közvetlenül a bemeneti tömböt módosítja.
Megjegyzés: ezt a fajta algoritmust hívják (többlet memória nélküli rendezés).
- Módosíthatja úgy is, hogy egyszerre használjon lemezterületet és minimális memóriaigényt, jelentős lemezbe- és kiírási költségek nélkül. Az ötlet az, hogy csak azokat a részeket töltsük be a memóriába, amelyeket épp feldolgozunk. Ez fontos, amikor egy több gigabaytos táblázatot kell rendeznünk, mindössze 100 megabájt memóriával.
Megjegyzés: ezt a fajta algoritmust hívják .
- Módosíthatja úgy is, hogy több folyamatban / szálban / szerveren fusson.
Például a disztribúciós egyesített rendezés az egyik kulcsfontosságú eleme (ami egy struktúra a nagy adatokban).
- Ez az algoritmus képes ólomot arannyá változtatni (igazán!).
Ez a rendezési algoritmus a legtöbb (ha nem az összes) adatbázisban használatos, de nem ez az egyetlen. Ha többet szeretne tudni, elolvashatja ezt a , amely az adatbázisok általános rendezési algoritmusainak előnyeit és hátrányait tárgyalja.
Tömb, Fa és Hash-tábla
Most, hogy megértettük az időbeli összetettség és a rendezés ötletét, mesélnem kell három adatstruktúráról. Ez fontos, mert ezek a modern adatbázisok alapját képezik. Bevezetem a fogalmat is adatbázis-index fogalmát.
Tömb
A kétdimenziós tömb a legegyszerűbb adatstruktúra. A táblázatot tömbként is tekinthetjük. Példa:
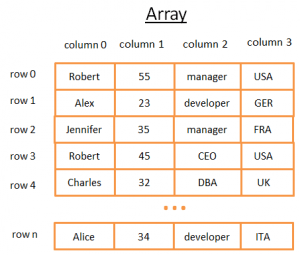
Ez a 2 dimenziós tömb egy sorokká és oszlopokká rendezett táblázatot képvisel:
- Minden sor egy entitást képvisel
- Az oszlopok tárolják az entitás jellemzőit.
- Minden oszlop egy adott típusú adatot tárol (egész szám, szöveg, dátum stb.).
Ez kényelmes módja az adatok tárolásának és megjelenítésének, azonban amikor meg kell találni egy bizonyos értéket, ez nem ideális.
Például, ha meg szeretné találni az összes brit dolgozót, minden sort át kell néznie, hogy megállapítsa, az adott sor Nagy-Britanniához tartozik-e. Ez N műveletet fog jelenteni, ahol N — sorok, ami nem rossz, de lehetne-e gyorsabb út? Itt az ideje, hogy megismerkedjünk a fákkal.
Megjegyzés: a legtöbb modern adatbázis kibővített tömböket kínál a táblák hatékony tárolásához: heap-organizált táblák és index-alapú táblák. De ez nem változtat a gyors keresés problémáján egy adott feltétel szerint az oszlopcsoportban.
Adatbázisfa és index
A bináris keresőfa egy bináris fa, amelynek van egy különleges tulajdonsága, minden csomópont kulcsa:
- nagyobb, mint a bal almappa összes kulcsa
- kisebb, mint a jobb almappa összes kulcsa
Nézzük meg, mit jelent ez vizuálisan
Ötlet
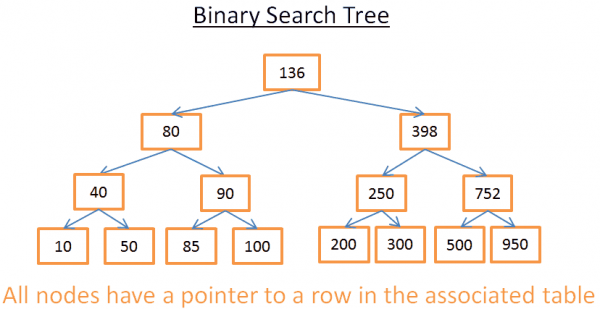
Ez a fa N = 15 elemet tartalmaz. Tegyük fel, hogy a 208-as számot keresem:
- A gyökérrel kezdem, amelynek kulcsa 136. Mivel 136<208, a 136-os csomópont jobb almappájára nézek.
- 398>208, ezért a 398 csomópont bal almappájára nézek
- 250>208, ezért a 250 csomópont bal almappájára nézek
- 200<208, ezért a 200 csomópont jobb almappájára nézek. De 200-nak nincs jobb almappája, az érték nem létezik (mert ha létezne, akkor a 200 jobb almappájában lenne).
Most, mondjuk, 40-et keresek
- A gyökérrel kezdem, amelynek kulcsa 136. Mivel 136 > 40, a 136 csomópont bal almappájára nézek.
- 80 > 40, ezért a 80 csomópont bal almappájára nézek
- 40= 40, a csomópont létezik. Kinyerem a csomópont belső azonosítóját (ez nem látható a képen), és a megfelelő azonosító alapján megnézem a táblában.
- Az azonosító ismerete lehetővé teszi számomra, hogy pontosan tudjam, hol találhatók az adatok a táblában, így azokat azonnal megkaphatom.
Végül mindkét keresés annyiba kerül, mint a fa belső szintjei. Ha figyelmesen elolvastad a merge sort részét, látnod kell, hogy itt log(N) szint van. Tehát, a keresés költsége log(N), nem rossz!
Térjünk vissza a problémánkhoz
De ez nagyon elvont, ezért térjünk vissza a problémánkhoz. Ahelyett, hogy egy egyszerű egész számot használnánk, képzelj el egy szöveget, amely valakinek az országát képviseli az előző táblázatban. Tegyük fel, hogy van egy fája, amely tartalmazza a "country" mezőt (3. oszlop) a táblázatból:
- Ha tudni szeretnéd, ki dolgozik az Egyesült Királyságban
- a fára nézel, hogy megtudd, melyik csomópont képviseli az Egyesült Királyságot
- az "UKnode"-ban találod az Egyesült Királyságban dolgozók nyilvántartásának helyét.
Ez a keresés log(N) műveletet fog igényel az N művelet helyett, ha közvetlenül tömböt használ. Amit most bemutattál — az volt adatbázis index.
Több mező (szöveg, szám, 2 szöveg, szám és szöveg, dátum ...) indexfa felépítése lehetséges, amennyiben van egy kulcsok összehasonlító funkciód (azaz mezőcsoportok), így be tudod állítani a kulcsok sorrendjét (ami minden alapvető típus esetén érvényes az adatbázisban).
B+FaIndex
Bár ez a fa jól működik egy adott érték megkeresésére, létezik egy NAGY probléma, ha szükséged van arra, hogy több elemet kapj két érték között. Ez O(N)-t fog költségednek, mivel a fa minden csomópontját meg kell nézned és ellenőrizned, hogy az ezek között az értékek között van-e (például a fa rendezett bejárásával). Ráadásul ez a művelet nem kedvező lemezbe-/kimenetre, mert az egész fát olvasnod kell. Találnunk kell egy hatékony módszert a tartomány lekérdezésénekmegvalósítására. E probléma megoldására a modern adatbázisok egy módosított verzióját használják az előző fának, amelyet B+Fának neveznek. A B+Fában:
- csak a legalsó csomópontok (levelek) tartják az információt (a sorok elhelyezkedése a kapcsolódó táblában)
- a többi csomópont itt van az útvonal irányításához a megfelelő csomóponthoz keresés közben.
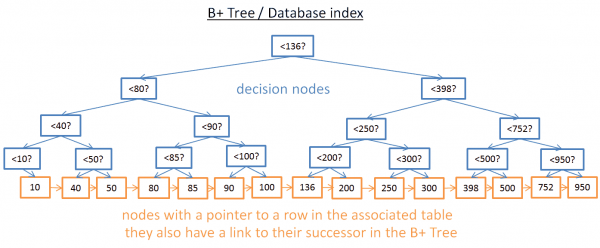
Ahogy látod, itt több csomópont van (kétszer annyi). Valóban, további csomópontjaid vannak, a „döntéshozó csomópontok”, amelyek segítenek megtalálni a helyes csomópontot (amely a kapcsolódó táblában tárolja a sorok elhelyezkedését). De a keresés bonyolultsága továbbra is O(log(N)), mivel csak egy további szint van. A nagy különbség az, hogy az alsó szint csomópontjai kapcsolódnak az utódjaikhoz.
Ezzel a B+Fával, ha a 40 és 100 közötti értékeket keresed:
- Csak a 40-et (vagy a legközelebbi értéket 40 után, ha 40 nem létezik) kell keresned, ahogy az előző fával is tetted.
- Ezután gyűjtsd össze a 40 utódait, közvetlen hivatkozásokkal az utódokra, amíg el nem éred a 100-at.
Tegyük fel, hogy M utódot találtál, és a fa N csomópontot tartalmaz. Egy adott csomópont keresése log(N) költséges, akárcsak az előző fával. De, miután megkaptad ezt a csomópontot, M utódot kapsz M művelettel az utódjaikra mutató hivatkozással. Ez a keresés csak M+log(N) költséges. az N műveletek összehasonlításakor az előző fával. Ráadásul nem kell az egész fát olvasnia (csak M + log (N) csomópontot), ami kevesebb lemezhasználatot jelent. Ha M kicsi (például 200 sor) és N nagy (1 000 000 sor), akkor ez NAGY különbség lesz.
De itt új problémák merülnek fel (ismét!). Ha sort ad hozzá vagy töröl az adatbázisból (és így a kapcsolódó B+Fa indexből):
- akkor fenn kell tartania a rendet a B+Fa csomópontjai között, különben nem találhatja meg a csomópontokat a rendezetlen fában.
- meg kell tartania a lehető legkevesebb szintet a B+Fában, különben az O(log(N)) időbeli bonyolultság O(N) lesz.
Más szavakkal, a B+Fának önrendezettnek és kiegyensúlyozottnak kell lennie. Szerencsére ez okos törlési és beszúrási műveletekkel lehetséges. De ez drága: egy B+Fába való beszúrás és törlés O(log(N)) költséget jelent. Ezért hallottátok már, hogy a túl sok index használata nem a legjobb ötlet.Valóban, lassítja a sor gyors beszúrását / frissítését / törlését a táblázatban,mivel az adatbázisnak frissítenie kell a táblázat indexeit a költséges O(log(N)) művelettel minden index esetében. Ráadásul az indexek hozzáadása nagyobb terhelést jelent a tranzakciókezelő számára, (amelyet a cikk végén ismertetünk).
További információkért megnézheti a Wikipédián található cikket az Ha szeretne egy példát a B+Fa adatbázisban való megvalósítására, nézze meg és a MySQL vezető fejlesztőitől. Mindkettő fókuszál arra, hogyan kezeli az indexeket az InnoDB (MySQL motor).
Megjegyzés: egy olvasó azt mondta, hogy az alacsony szintű optimalizálások miatt a B+Fa teljesen kiegyensúlyozott kell, hogy legyen.
Hash tábla
Az utolsó fontos adatstruktúránk a hash tábla. Ez nagyon hasznos, amikor gyorsan szeretne értékeket keresni. Ráadásul a hash tábla megértése segít nekünk később megérteni egy közös adatbázis-összekapcsolási műveletet, amelyet hash-összekapcsolásnak neveznek ( hash join). Ezt az adatstruktúrát az adatbázis néhány belső dolog tárolására is használja (például, zárak táblája vagy buffer pool, mindkét fogalmat később látni fogjuk).
A hash table is a data structure that quickly finds an element by its key. To build a hash table, you need to determine:
- the key for your elements
- the hash function for the keys. The computed hashes of the keys give the location of the elements (called segments ).
- a function to compare keys.. Once you find the correct segment, you need to find the element you're looking for within the segment, using this comparison.
A simple example
Let's take a visual example:
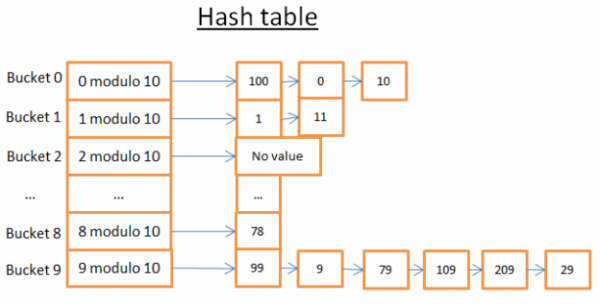
This hash table has 10 segments. Since I am lazy, I only depicted 5 segments, but I know you're smart, so I’ll let you imagine the other 5 yourself. I used a hash function modulo 10 of the key. In other words, I only keep the last digit of the key to find its segment:
- if the last digit is 0, the element goes to segment 0,
- if the last digit is 1, the element goes to segment 1,
- if the last digit is 2, the element goes to segment 2,
- …
The comparison function I used is simply equality between two integers.
Suppose you want to get the element 78:
- The hash table calculates the hash code for 78, which is 8.
- The hash table looks in segment 8, and the first element it finds is 78.
- It returns the element 78
- The search costs only 2 operations (one for calculating the hash function value and the other for finding the element within the segment).
Now, suppose you want to get the element 59:
- The hash table calculates the hash code for 59, which is 9.
- The hash table searches in segment 9, the first found element is 99. Since 99!=59, element 99 is not the correct element.
- Using the same logic, the second element (9), third (79), …, last (29) are taken.
- Element not found.
- The search cost 7 operations.
A good hash function
As you can see, depending on the value you are looking for, the cost is not the same!
If I now change the hash function to modulo 1,000,000 of the key (i.e., taking the last 6 digits), the second search will cost only 1 operation because there are no elements in segment 000059. The real challenge is to find a good hash function that will create segments containing very few elements..
A jó hash függvény megtalálása egyszerű az én példámban. De ez egy egyszerű példa, a jó hash függvény megtalálása nehezebb, amikor a kulcs:
- szöveg (például - vezetéknév)
- 2 szöveg (például - vezetéknév és keresztnév)
- 2 szöveg és egy dátum (például - vezetéknév, keresztnév és születési dátum)
- …
Jó hash függvénnyel a hash táblázatban a keresés O(1)-be kerül..
Tömb vs hash táblázat
Miért ne használjunk tömböt?
Hmm, jó kérdés.
- A hash táblázat lehet részben betöltve a memóriába,, míg a többi szegmens a lemezen maradhat.
- Tömb esetén folyamatos memóriaterületet kell használnod. Ha egy nagy táblázatot töltesz be, nagyon nehéz elegendő folyamatos területet találni..
- Hash táblázat esetén kiválaszthatod a szükséges kulcsot (például az országot és az egyén vezetéknévét).
További információkért elolvashatod a cikket a , amely a hash táblázat hatékony megvalósítása; nem szükséges ismerned a Javát ahhoz, hogy megértsd a cikkben bemutatott koncepciókat.
Forrás: habr.com
