

Helló, Habr!
Az ünnepek után újraindítottuk a katasztrófamentes felhőnket két helyszínen. Ma bemutatjuk, hogyan működik ez, és megmutatjuk, mi történik az ügyfél virtuális gépeivel, amikor a klaszter egyes elemei meghibásodnak vagy az egész helyszín leáll (spoiler – minden rendben van velük).
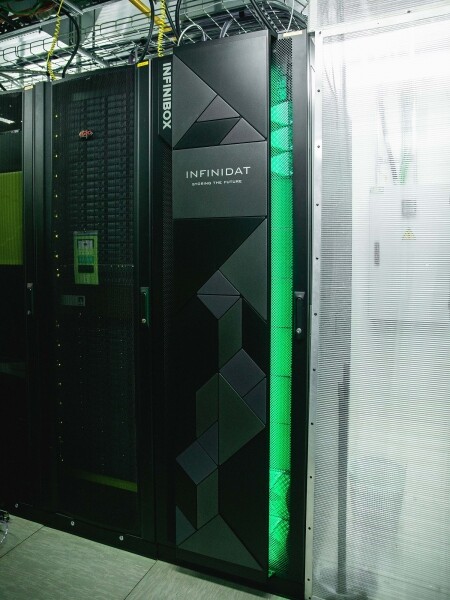
A katasztrófamentes felhő tárolórendszere az OST helyszínen.
Mi van a motorháztető alatt
A klaszterben Cisco UCS szerverek találhatók VMware ESXi hipervizorral, két INFINIDAT InfiniBox F2240 tárolórendszer, Cisco Nexus hálózati berendezések, valamint Brocade SAN switchek. A klaszter két helyszínre van elosztva – OST és NORD, tehát minden adatközpontban azonos hardver konfiguráció van. Ez teszi lehetővé a katasztrófamentességet.
Egy helyszínen a fő elemek is duplikálva vannak (hosztok, SAN switchek, hálózat).
A két helyszínt dedikált optikai szálas vonalak kötik össze, amelyek szintén rezerváltak.
Néhány szó a tárolórendszerről. Az első verziót katasztrófamentes felhőnknek NetApp-on építettük. Itt az INFINIDAT-ot választottuk, és íme, miért:
- Active-Active replikációs opció. Ez lehetővé teszi, hogy a virtuális gép működőképes maradjon, még akkor is, ha az egyik tárolórendszer teljesen leáll. A replikációról részletesebben később beszélek.
- Három lemezvezérlő a rendszer hibatűrésének növelése érdekében. Általában kettő szokott lenni.
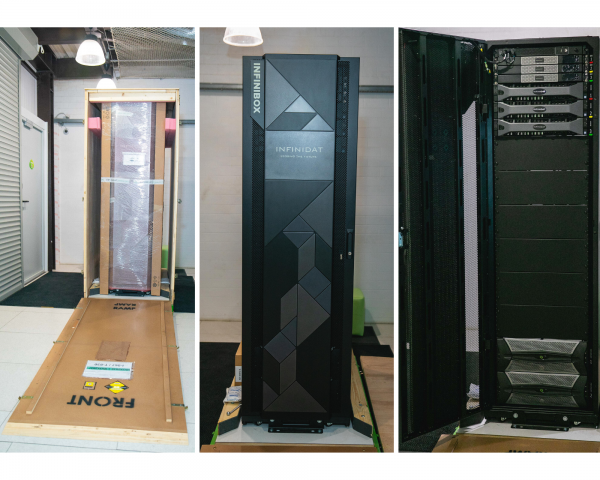
- Kész megoldás. Már összeszerelt állvány érkezett hozzánk, amelyet csak csatlakoztatni kell a hálózathoz és be kell állítani.
- Figyelmes technikai támogatás. Az INFINIDAT mérnökei folyamatosan elemzik a naplókat és az eseményeket, új verziókat telepítenek a firmware-be, és segítenek a beállításban.
Itt van néhány fotó a kibontásról:
Hogyan működik
A felhő már önmagában is katasztrófamentes. Védi az ügyfelet az egyedi hardver- és szoftverhibáktól. A katasztrófamentes megoldás pedig segít megvédeni a tömeges leállásoktól egy helyszínen belül: például a tárolórendszer (vagy SDS klaszter) leállása, hálózati hibák stb. És ami a legfontosabb: az ilyen felhő megment, amikor egy egész helyszín elérhetetlenné válik tűz, áramszünet, fosztogatás vagy földönkívüliek inváziója miatt.
Minden ilyen esetben az ügyfél virtuális gépei folytatják a működést, és íme, miért.
A klaszter schemájának kialakítása olyan, hogy bármely ESXi-hoszt, amely kliens virtuális gépekkel rendelkezik, hozzáférhet a két tároló egyikéhez. Ha az OST helyszínen található tároló meghibásodik, a virtuális gépek továbbra is működnek: azok a hosztok, amelyekkel futnak, az NORD tárolón keresztül keresnek adatokat.
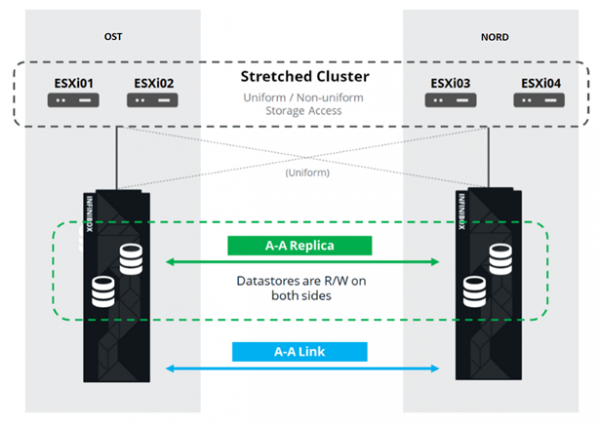
Így néz ki a csatlakozás sémája a klaszterben.
Ez lehetséges annak köszönhetően, hogy a két helyszín SAN-fabrikái között Inter-Switch Link van beállítva: az OST Fabric A SAN kapcsolója csatlakozik a NORD Fabric A SAN kapcsolójához, és ugyanez vonatkozik a B fabrikák SAN kapcsolóira is.
Annak érdekében, hogy a SAN-fabrikák e bonyolult kapcsolatai értelmet nyerjenek, a két tároló között aktív-aktív replikáció van beállítva: az információ szinte egyidejűleg kerül rögzítésre a helyi és a távoli tárolóba, RPO=0. Így az egyik tárolón az adatok eredeti másolata, a másikon pedig a replikája található. Az adatok a tárolók szintjén kerülnek replikálásra, és ezeken tárolódnak a virtuális gépek adatai (meghajtóik, konfigurációs fájl, swap fájl stb.).
Az ESXi-hoszt az alapértelmezett meghajtót és annak replikáját egyetlen tárolóeszközként (Storage Device) látja. Az ESXi-hosztól minden tárolóeszközhöz 24 útvonal vezet:
12 útvonal köti össze a lokális tárolóval (optimális útvonalak), míg a többi 12 a távoli tárolóhoz (nem optimális útvonalak). Normál körülmények között az ESXi a lokális tároló adatait az "optimális" útvonalakat használva éri el. Ha ez a tároló meghibásodik, az ESXi elveszíti az optimális útvonalakat és átkapcsol a „nem optimálisra”. Így néz ki mindez a sémán.
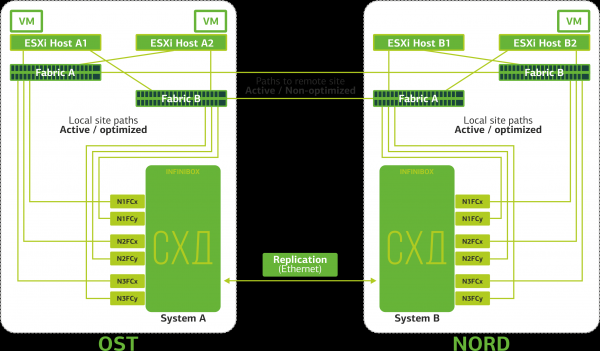
A katasztrófaelhárító klaszter sémája.
Minden kliens hálózat be van kötve mindkét helyszínre egy közös hálózati fabrikán keresztül. Mindkét helyszínen működik egy Provider Edge (PE), ahol a kliens hálózatai terminálódnak. A PE-k egy közös klaszterbe vannak összekapcsolva. Ha az egyik helyszínen a PE leáll, az összes forgalom a másik helyszínre irányul. Ennek köszönhetően a PE-től megfosztott helyszín virtuális gépei továbbra is elérhetők maradnak a kliens számára.
Most nézzük meg, mi történik a kliens virtuális gépeivel különböző hibák esetén. Kezdjük a legkevésbé súlyos esetekkel és fejezzük be a legsúlyosabbal – az egész helyszín leállásával. A példákban az alaphelyszín az OST, a biztonsági másolatot és az adatreplicákat tároló helyszín pedig a NORD lesz.
Mi történik a kliens virtuális gépével, ha…
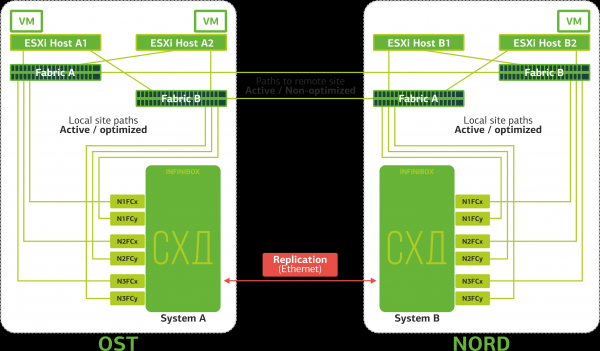
Megszakad a replikációs kapcsolat. A replikáció a két helyszín tárolói között megszűnik.
Az ESXi csak helyi lemezes eszközökkel működik (optimalizált utakon).
A virtuális gépek továbbra is működnek.
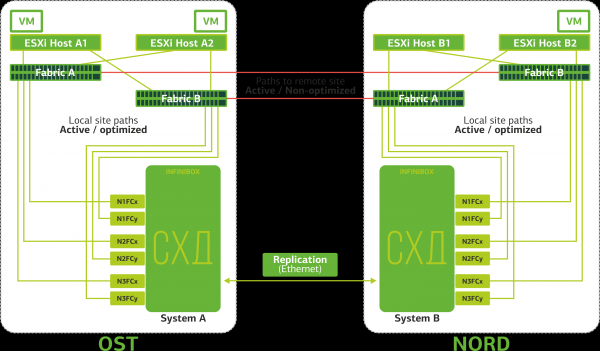
ISL (Inter-Switch Link) megszakad. Ritkán fordul elő. Legfeljebb egy őrült dózer átvághatja azonnal több optikai vonalat, amelyek független útvonalakon haladnak, és különböző bevezetőkön vannak csatlakoztatva a helyszínekhez. De mégis. Ebben az esetben az ESXi hosztok elveszítik az útvonalak felét, és csak a saját helyi tárolóikhoz férhetnek hozzá. A replikák összegyűlnek, de a hosztok nem tudják elérni őket.
A virtuális gépek normálisan működnek.
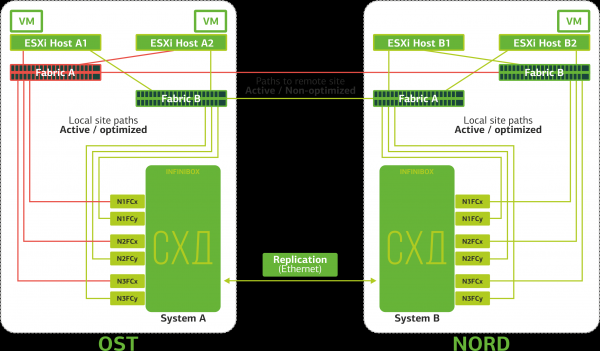
SAN switch hibásodik meg az egyik helyszínen. Az ESXi hosztok elveszítik a tárolókhoz vezető utak egy részét. Ebben az esetben azon a helyszínen, ahol a switch hibásodik, a hosztok csak egy saját HBA-n keresztül fognak működni.
A virtuális gépek eközben normálisan működnek.
Minden SAN switch hibásodik meg az egyik helyszínen. Tegyük fel, hogy ilyen probléma történik az OST helyszínen. Ebben az esetben az ESXi hosztok ezen a helyszínen elveszítik az összes útvonalukat a lemezes eszközeikhez. Belép a VMware vSphere HA standard mechanizmusa: az összes virtuális gépet, amely az OST helyszínen található, legfeljebb 140 másodperc alatt újraindítja a NORD helyszínen.
A NORD helyszínen dolgozó virtuális gépek normálisan működnek.
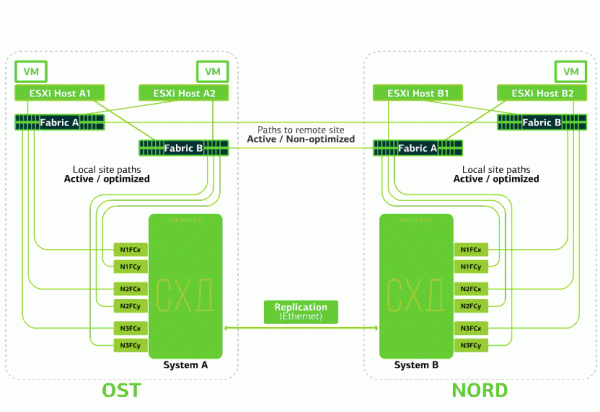
Az ESXi hoszt hibásodik meg az egyik helyszínén. Itt újra működésbe lép a vSphere HA mechanizmusa: a hibás hoszt virtuális gépei más hosztokon indulnak újra – ugyanazon vagy távoli helyszínen. A virtuális gép újraindítási ideje legfeljebb 1 perc.
Ha az OST helyszínen az összes ESXi hoszt hibásodik meg, akkor már nincs más választás: a VM-ek egy másikon indulnak újra. Az újraindítási idő ugyanez.
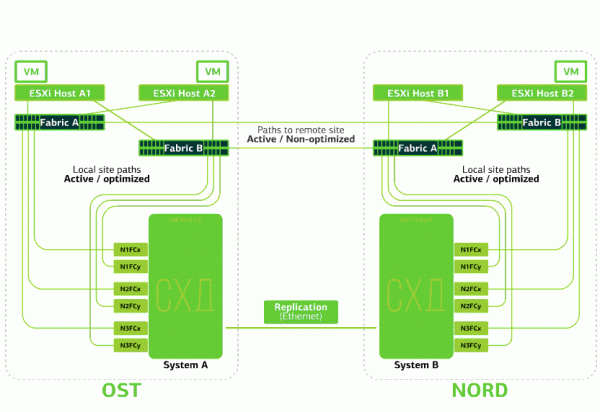
A tárolóhiba lép fel egy helyszínen. Tegyük fel, hogy a tárolóhibásodik meg az OST helyszínen. Ekkor az OST helyszín ESXi hosztjai a NORD rekonstrukcióval működnek. A hibás tároló újbóli üzembe helyezésével kényszerített replikáció történik, az OST ESXi hosztjai újra hozzáférnek a helyi tárolóhoz.
A virtuális gépek ez alatt az idő alatt normálisan működnek.
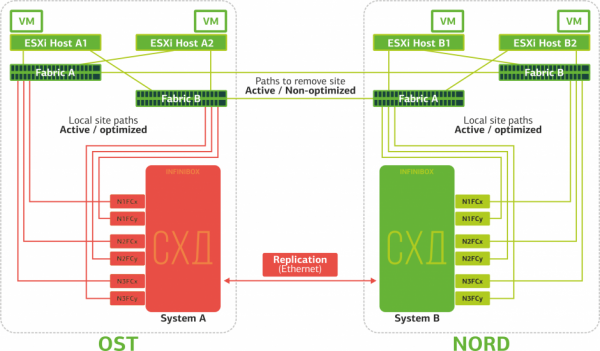
Megszűnik az egyik helyszín. Ebben az esetben az összes virtuális gép a vSphere HA mechanizmuson keresztül újraindul a tartaléklehelyszínen. A VM újraindítási ideje 140 másodperc. Eközben az összes hálózati beállítást megőrzi a virtuális gép, és a hálózaton keresztül elérhető marad az ügyfél számára.
A gépek újraindítása a tartalék helyszínen zökkenőmentes legyen, minden helyszínt csak félig töltenek fel. A másik fele – tartalék, arra az esetre, ha az összes virtuális gépet a második, károsodott helyszínre kellene áthelyezni.
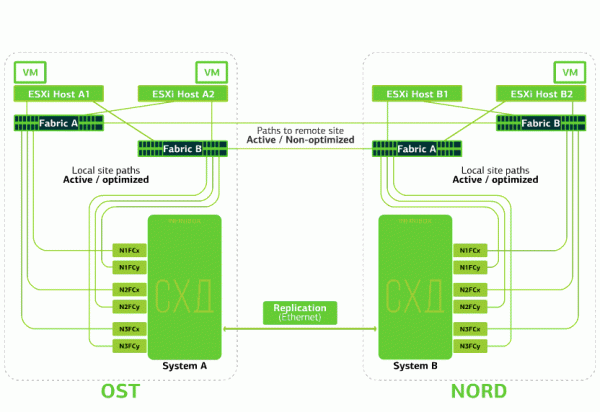
Az ilyen leállások ellenvéd a katasztrófaálló felhő, amely két adatközpont alapjain működik.
Ez nem olcsó szolgáltatás, mivel az alapvető erőforrások mellett szükség van egy tartalékra a második helyszínen is. Ezért helyeznek el ilyen felhőben üzletileg kritikus szolgáltatásokat, amelyek hosszú leállása jelentős pénzügyi és hírnévbeli veszteségeket okoz, vagy ha az informatikai rendszerrel szemben katasztrófaállósági követelményeket támasztanak a szabályozók vagy a vállalat belső szabályzatai.
Források:
Forrás: habr.com
