

Adat tudomány kezdőknek
1. Érzelem elemzés (Szövegből származó érzelem elemzés)
Nézze meg a Data Science projekt teljes megvalósítását a forráskód segítségével — .
Az érzelem elemzés a szavak elemzése a hangulatok és vélemények meghatározására, amelyek lehetnek pozitívak vagy negatívak. Ez egyfajta klasszifikáció, ahol a kategóriák lehetnek binárisak (pozitív és negatív) vagy többesek (boldog, dühös, szomorú, undok ...). Ezt a Data Science projektet R nyelven valósítjuk meg, és a „janeaustenR” csomag adathalmazát fogjuk használni. Használni fogjuk az általános célú szótárakat, mint az AFINN, bing és loughran, végrehajtunk belső összekapcsolást, és végül szótárfelhőt alkotunk az eredmények megjelenítésére.
Nyelv: R
Adathalmazon/ Csomag: janeaustenR
A cikket az EDISON Software támogatásával fordították, amely , valamint .
2. Álhírek észlelése
Fejlessze tudását egy új szintre a kezdőknek szóló Data Science projekt során — .
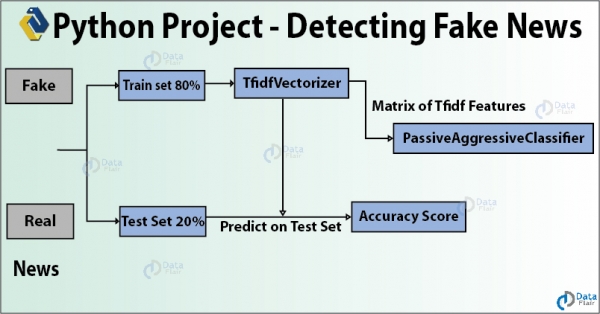
Az álhírek hamis információk, amelyeket a közösségi médián és más online forrásokon keresztül terjesztenek politikai célok elérése érdekében. Ebben a Data Science projekt ötletben Python-t fogunk használni egy olyan modell felépítésére, amely pontosan meg tudja állapítani, hogy egy hír valós vagy hamis. Létrehozunk egy TfidfVectorizer-t és a PassiveAggressiveClassifier-t fogjuk használni a hírek ‘valós’ és ‘hamis’ besorolására. Az adathalmazunk 7796 × 4 formátumú lesz, és mindent Jupyter Lab-ban fogunk végrehajtani.
Nyelv: Python
Adathalmazon/ Csomag: news.csv
3. Parkinson-kór észlelése
Haladjon előre a Data Science Project Idea ötlet kidolgozásában — .
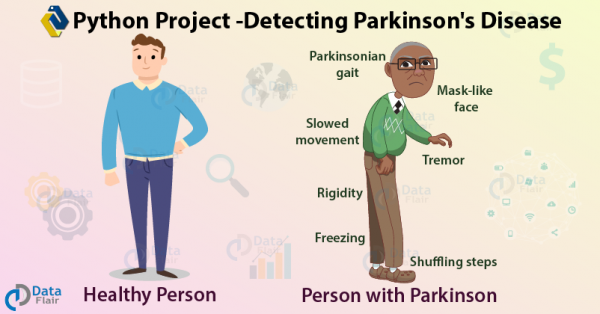
Kezdtük alkalmazni a Data Science-t az egészségügy és a szolgáltatások javítására — ha előre meg tudjuk jósolni a betegséget, számos előnyünk származik. Tehát ebben a Data Science projekt ötletben megtanuljuk a Parkinson-kór észlelését Python segítségével. Ez egy neurodegeneratív, progresszív központi idegrendszeri betegség, amely a mozgásra hat, remegést és merevséget okoz. Hatással van a dopamint termelő neuronokra az agyban, és évente több mint 1 millió embert érint Indiában.
Nyelv: Python
Adathalmazon/ Csomag: UCI ML Parkinsons adatbázis
Közepes nehézségű Data Science projektek
4. Beszédből származó érzelem felismerés
Ismerje meg a Data Science projekt példa teljes megvalósítását — .
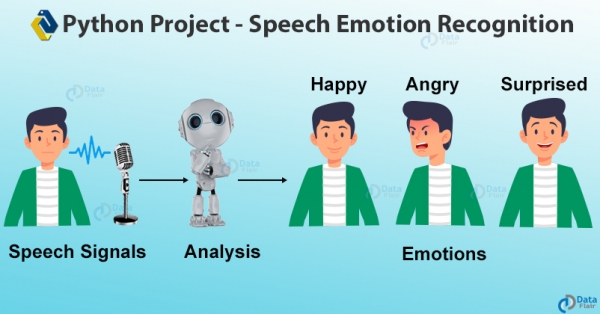
Most tanuljunk meg különböző könyvtárakat használni. Ez a Data Science projekt a librosát használja a beszédfelismeréshez. A SER egy folyamat, amely az emberi érzelmek és affektív állapotok meghatározása a beszéd alapján. Mivel az érzelmeket hangzással fejezzük ki, a SER releváns. De mivel az érzelmek szubjektívek, a hang annotálása nehéz feladat. Az mfcc, chroma és mel funkciókat fogjuk használni, és a RAVDESS adathalmazon fogjuk az érzelmeket felismerni. MLPC osztályozót fogunk létrehozni ehhez a modellhez.
Nyelv: Python
Adathalmazon/ Csomag: RAVDESS adathalmaz
5. Nem és életkor észlelés (Gender and Age Detection)
Büszkélkedjen a legújabb Data Science projekttel — .
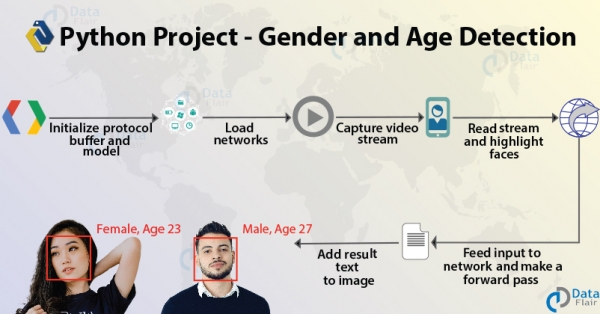
Ez egy érdekes Data Science projekt Pythonban. Csak egy képet használva megtanulja előre jelezni egy személy nemét és életkorát. Ebben megismertetjük Önt a Computer Visionnal és annak elveivel. Felépítünk egy és a Tal Hassner és Gil Levi által betanított modelleket használjuk az Adience adathalmazon. Út közben használni fogunk néhány .pb, .pbtxt, .prototxt és .caffemodel fájlt.
Nyelv: Python
Adathalmazon/ Csomag: Adience
6. Uber adatelemzés (Uber Data Analysis)
Nézze meg a Data Science projekt teljes megvalósítását forráskóddal — .
Ez egy adatelemző projekt a ggplot2-vel, amelyben az R-t és annak könyvtárait fogjuk használni, hogy különböző paramétereket elemezzünk. A New York-i Uber Pickup adathalmazon fogunk dolgozni, és vizualizációkat készítünk különböző időkeretekre. Ez azt mutatja meg, hogy az idő hogyan befolyásolja az utasok utazásait.
Nyelv: R
Adathalmazon/ Csomag: Uber Pickups in New York City adathalaz
7. Sofőr fáradtsági észlelés (Driver Drowsiness detection)
Fejlessze képességeit a Top Data Science Projekten — .
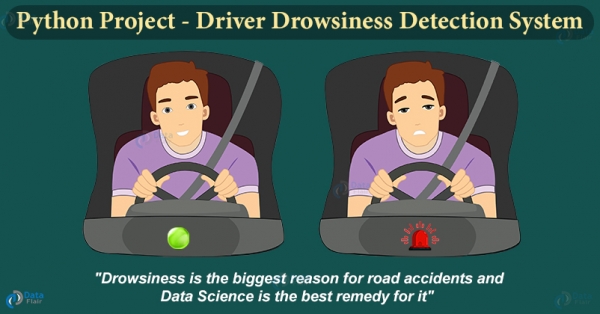
A fáradt vezetés rendkívül veszélyes, és évente körülbelül ezer baleset történik, mivel a sofőrök elalszanak vezetés közben. Ebben a Python projekteben létrehozunk egy rendszert, amely képes észlelni a fáradt sofőröket, és figyelmeztetni őket hangjelzéssel.
Ez a projekt a Keras és OpenCV használatával készült. Az OpenCV-t az arc- és szemészleléshez fogjuk használni, míg a Keras segítségével az eye state (nyitott vagy zárt) besorolására mély neurális hálózati módszereket alkalmazunk.
8. Chatbot
Hozzon létre chatbotot Python használatával, és lépjen egyet előre a karrierjében — .
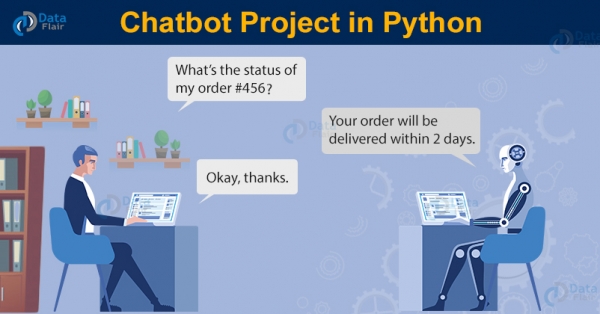
A chatbotok elengedhetetlen részei az üzletnek. Sok vállalatnak kell szolgáltatásokat nyújtania ügyfeleinek, amit sok munkaerőre, időre és erőfeszítésre van szükség. A chatbotok automatizálhatják az ügyfélkapcsolatok jelentős részét, válaszolva a gyakran feltett kérdések egy részére. Alapvetően kétféle chatbot létezik: domain-specifikus és nyílt domain. A domain-specifikus chatbotot gyakran használják konkrét problémák megoldására. Ezért azt hatékonyan kell testre szabni a szakterületén. A nyílt domain chatbotoknak bármilyen kérdést fel lehet tenni, így ezek kiképzéséhez hatalmas mennyiségű adatra van szükség.
Adatállomány: Intents json fájl
Nyelv: Python
Fejlett Data Science projektek
9. Kép Leíró Generátor
Nézze meg a teljes projekt megvalósítást forráskóddal — .
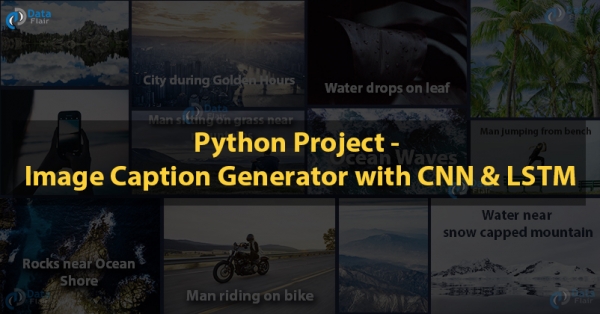
Ami a képen látható, az könnyű feladat az emberek számára, de a számítógépek számára a kép egyszerűen egy számgyűjtemény, amely a színértékek minden pixelhez tartozó értékét képviseli. Ez egy nehéz feladat a számítógépek számára. Megérteni, mi található a képen, majd természetes nyelven (például angolul) leírást készíteni, másik nehéz feladat. Ez a projekt mélytanulási módszereket alkalmaz, amelyekben egy Konvolúciós Neurális Hálózatot (CNN) valósítunk meg egy Rekurrens Neurális Hálózattal (LSTM) a kép leíró generátor létrehozásához.
Adatállomány: Flickr 8K
Nyelv: Python
Keretrendszer: , amely több interfészváltozatot biztosít a modellek felépítéséhez (Szekvenciális, Funkcionális, Alosztályozás), lehetővé téve azok
10. Hitelkártya Csalás Felismerése
Tegyen meg mindent az adat tudományos projekt ötletén dolgozva — .
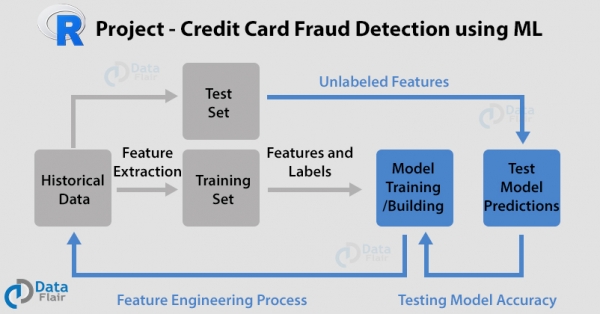
Eddig már kezdte megérteni a módszereket és a koncepciókat. Nézzünk át néhány fejlettebb projektet a data science területén. Ebben a projektben az R nyelvet fogjuk használni olyan algoritmusokkal, mint a , logisztikai regresszió, mesterséges neurális hálózatok és gradiensemelési klasszifikátor. Kártya tranzakciók adathalmazt fogunk használni a hitelkártyás tranzakciók csalásként és valósként való osztályozásához. Különböző modelleket fogunk alkalmazni és teljesítménygörbéket építünk.
Nyelv: R
Adathalmazon/ Csomag: Kártya tranzakciók adathalmaza
11. Filmajánló Rendszer
Fedezze fel a legjobb Data Science projekt megvalósítását a forráskóddal —
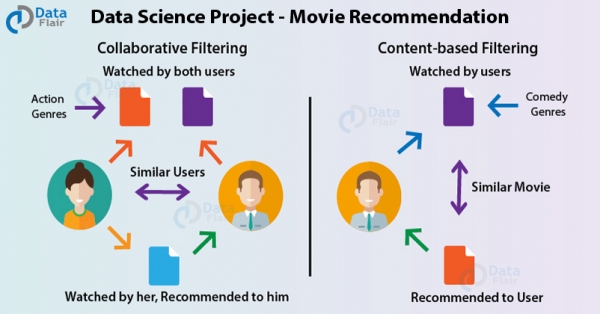
Ebben a Data Science projektben az R-t fogjuk használni a filmes ajánlások gépi tanulás révén történő végrehajtására. Az ajánló rendszer javaslatokat küld a felhasználóknak, egy olyan szűrési folyamat keretein belül, amely más felhasználók preferenciáin és nézési történetén alapul. Ha A és B szereti a Reszkessetek, betörők, és B szereti a Mean Girls-t, akkor A-nak ajánlható, hogy ő is kedvelheti. Ez lehetővé teszi a felhasználók számára, hogy interakcióba lépjenek a platformmal.
Nyelv: R
Adathalmazon/ Csomag: MovieLens adathalmoz
12. Vásárlói szegmentáció
Hagyjon benyomást a munkaadókra egy Data Science projekttel (forráskóddal együtt) — .
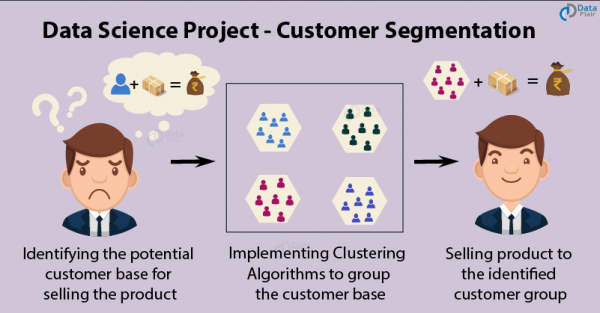
A vásárlók szegmentálása egy népszerű alkalmazás . A klaszterezés alkalmazásával a cégek ügyfélcsoportokat határoznak meg a potenciális felhasználói bázissal való munkára. Az ügyfeleket olyan közös jellemzők szerint csoportosítják, mint a nem, életkor, érdeklődés és költési szokások, hogy hatékonyan értékesíthessék termékeiket minden csoportnak. Mi a , valamint a nemek és életkorok eloszlásának vizualizálását fogjuk alkalmazni. Ezután elemezzük az éves jövedelmeiket és kiadási szintjüket.
Nyelv: R
Adathalmazon/ Csomag: Mall_Customers adathalmaz
13. Mellrák osztályozás
Nézze meg a Data Science projekt teljes megvalósítását Pythonban — .
Visszatérve az adatutalás orvosi hozzájárulásához, tanuljuk meg a mellrák észlelését Python segítségével. Az IDC_regular adatbázist fogjuk használni invazív ductalis karcinóma azonosítására, amely a leggyakoribb mellrák forma. Ez a tejcsatornákban alakul ki, behatolva a tejmirigy rostos vagy zsírszövetébe a csőből kifelé. Ebben az adathalászati tudományos projektötletben használni fogjuk és a Keras könyvtárat az osztályozáshoz.
Nyelv: Python
Adathalmazon/ Csomag: IDC_regular
14. Közlekedési táblák felismerése
A gépjármű önálló vezetésének pontosságának elérése egy Data Science projekten keresztül a nyílt forráskódú.
A közlekedési táblák és a közlekedési szabályok rendkívül fontosak minden vezető számára, hogy elkerülhessék a baleseteket. A szabály betartásához először is meg kell értenünk, hogyan néz ki egy közlekedési táblázat. Az embernek meg kell tanulnia minden közlekedési táblát, mielőtt jogosítványt kap a járművek vezetésére. De ma már növekszik az autonóm járművek száma, és a közeljövőben az emberek már nem fognak egyedül autót vezetni. A "Közlekedési táblák felismerése" projektben megtudhatja, hogyan ismerheti fel egy program a közlekedési táblák típusát, ha egy képet adunk bemenetként. A német közlekedési táblák adatbázisát (GTSRB) használjuk mély neurális hálózat kiépítéséhez a közlekedési tábla osztályának azonosítására. Emellett egyszerű grafikus felhasználói felületet is készítünk az alkalmazással való interakcióhoz.
Nyelv: Python
Adatállomány: GTSRB (Német Közlekedési Tábla Felismerési Benchmark)
További olvasás
Forrás: habr.com
