

A Beszéltünk az időbeli adatok előrejelzéséről. Logikus folytatásként jöhet egy cikk az anomáliák azonosításáról.
Alkalmazás
Az anomáliák azonosítása olyan területeken alkalmazható, mint:
1) Berendezések meghibásodásának előrejelzése
Például 2010-ben az iráni centrifugákat a Stuxnet vírus támadta meg, amely nem optimális működési módba állította a berendezéseket, és a fokozott kopás miatt részben tönkretette azokat.
Ha az eszközökön anomáliák keresésére alkalmas algoritmusok lettek volna, a meghibásodás elkerülhető lett volna.
Az anomáliák keresése nemcsak az atomiparban, hanem a fémfeldolgozásban és a repülőtéri turbinák működésében is használatos. Továbbá más területeken is, ahol a prediktív diagnosztika alkalmazása olcsóbb a nem tervezett meghibásodás okozta lehetséges veszteségeknél.
2) Csalás gyanús tevékenységek előrejelzése
Ha egy Podolskban használt kártyáról pénzt vesznek fel Albániában,可能 érdemes a tranzakciókat alaposabban ellenőrizni.
3) Anomális fogyasztói mintázatok azonosítása
Ha egyes ügyfelek anomális magatartást mutatnak, lehet, hogy van egy probléma, amiről nem tud.
4) Anomális kereslet és terhelés azonosítása
Ha az FMCG boltban a bevételek a prognózis megbízhatósági határértéke alatt csökkennek, érdemes megkeresni az okokat.
Az anomáliák azonosításának megközelítései
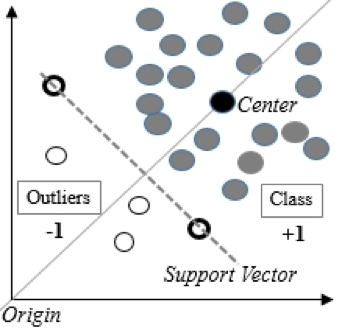
1) Egységes osztályú támogató vektorok módszere - One-Class SVM
Alkalmas, amikor a tanulási adathalmazon az adatok normál eloszlást követnek, és a tesztelés során anomáliák találhatók.
Az egységes osztályú támogató vektoros módszer nemlineáris felületet épít a koordináta-rendszer körül. Megadható a határérték, hogy mely adatokat tekintsük anomálisnak.
A DATA4 csapatunk tapasztalatai alapján a One-Class SVM a leggyakrabban használt algoritmus az anomáliák keresésére.
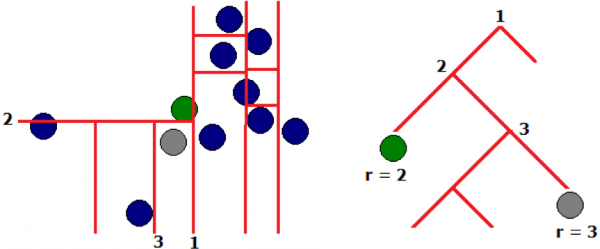
2) Izoláló erdő módszere - isolate forest
A 'véletlenszerű' faépítési módszer mellett az extrém értékek hamarabb elérik a leveleket (alacsony fa mélységén), tehát az extrém értékeket könnyebben 'izolálhatjuk'. Az anomális értékek kiemelése az algoritmus első iterációiban történik.
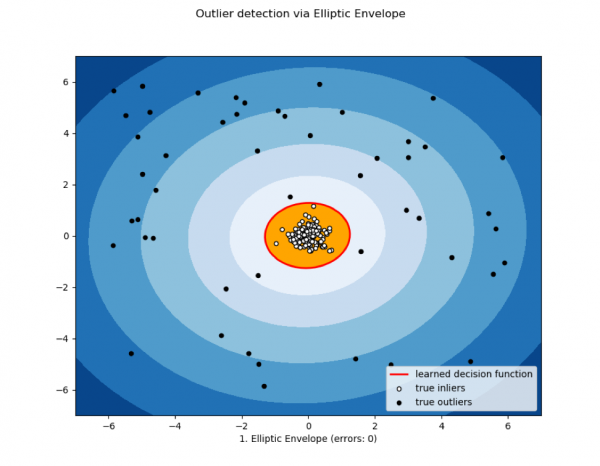
3) Elliptikus burkolat és statisztikai módszerek
Használatos, amikor az adatok normálisan oszlanak el. Minél közelebb áll a mérés az eloszlási keverék farkához, annál inkább anomális az érték.
Ebben a kategóriába más statisztikai módszerek is besorolhatók.
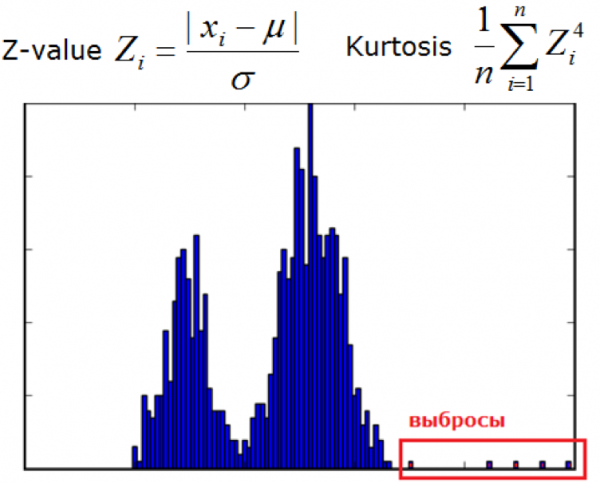
Kép a dyakonov.org weboldalról.
4) Metrikus módszerek
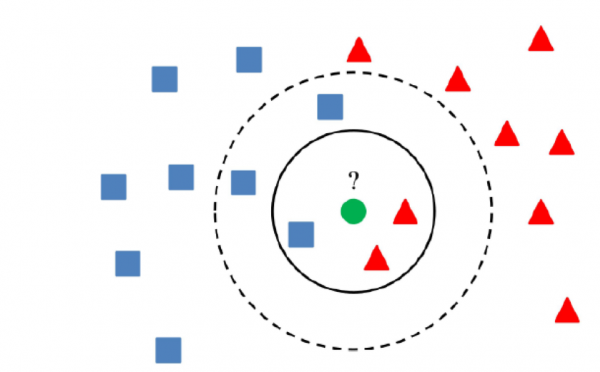
A módszerek közé tartoznak olyan algoritmusok, mint a k legközelebbi szomszéd, k-edik legközelebbi szomszéd, ABOD (szögalapú eltérés észlelés) vagy LOF (helyi eltérő tényező).
Akkor alkalmasak, ha a jellemzők közötti távolságok azonosak vagy normalizáltak (hogy ne mérjük a pitont papagájban).
A k legközelebbi szomszéd algoritmus azt feltételezi, hogy a normális értékek a többdimenziós tér egy adott területén helyezkednek el, míg az anomáliákhoz való távolság nagyobb lesz, mint a döntő hiperfelülethez.
5) Klaszterezési módszerek
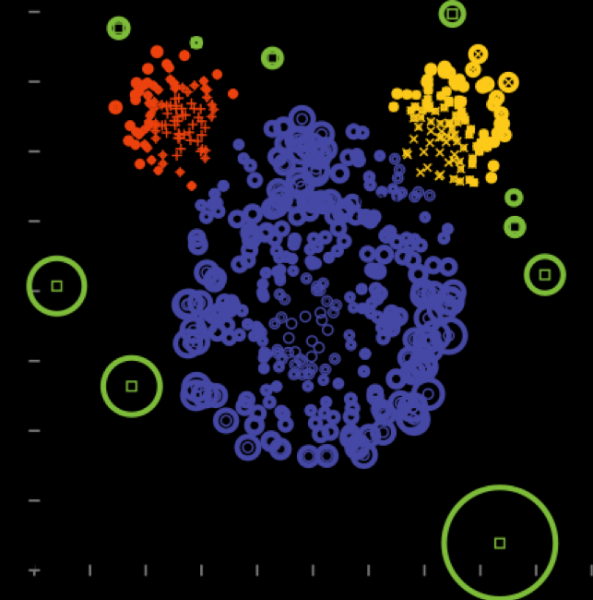
A klaszterezési módszerek lényege, hogy ha egy érték távolabb van a klaszterek középértékeitől, mint egy meghatározott nagyságrend, akkor az érték anomáliának számít.
A legfontosabb a megfelelően klaszterező algoritmus használata, ami a konkrét feladattól függ.
6) Főkomponens módszer
Ahol kiemelik a legnagyobb szórásváltozás irányait.
7) Idősoros előrejelző algoritmusok
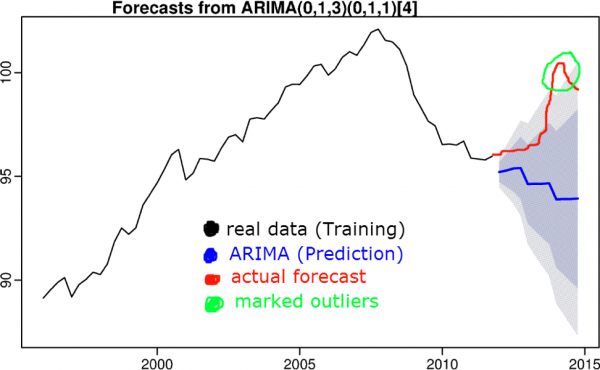
Az ötlet az, hogy ha egy érték kilóg a predikciós intervallumból, az érték anomáliának számít. Idősoros előrejelzéshez olyan algoritmusokat használnak, mint a tripla simítás, S(ARIMA), boosting stb.
Az időszoros előrejelzési algoritmusokról a korábbi cikkben volt szó.
8) Felügyelt tanulás (regresszió, klasszifikáció)
Ha az adatok lehetővé teszik, olyan algoritmusokat használunk, amelyek a lineáris regressziótól a visszatérő hálózatokig terjednek. Megmérjük a különbséget a predikció és a tényleges érték között, és levonunk egy következtetést arról, hogy az adatok mennyire lóg ki a normálisból. Fontos, hogy az algoritmusnak megfelelő általánosító képességgel rendelkezzen, és a tanulóhalmaz ne tartalmazzon anomális értékeket.
9) Modelltesztek
Az anomáliák keresését ajánlások kereséseként közelítjük meg. Az SVD vagy faktorálási gépek segítségével szétdaraboljuk a jellemző mátrixot, és az új mátrixban lévő, lényegesen eltérő értékeket anomáliának tekintjük.
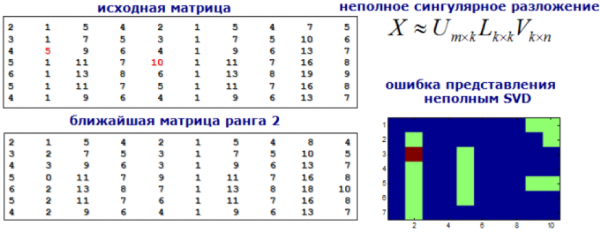
Kép a dyakonov.org weboldalról.
Zárás
Ebben a cikkben az anomáliák észlelésének főbb megközelítéseit vizsgáltuk.
Az anomáliák keresése sok tekintetben művészetnek nevezhető. Nincs tökéletes algoritmus vagy megközelítés, amely minden feladatot megoldana. Gyakrabban egy komplex módszert alkalmaznak a konkrét esetek megoldására. Az anomáliák keresése egyosztályos támogató vektorokkal, elszigetelt erdőkkel, metrikus és klaszterezési módszerekkel, valamint főkomponens-analízissel és időbeli sorozatok előrejelzésével történik.
Ha ismer más módszereket, írja meg őket a cikk alá kommentben.
Forrás: habr.com
