

Az Intel Foundry kiadott egy hirdetési dokumentumot, amely részletesen bemutatja a vállalat előremutató megoldásait a mesterséges intelligenciához és a nagy teljesítményű számítástechnikához kapcsolódó hardverek fejlesztésében és megvalósításában. Az Intel emellett bemutatta az "AI chip tesztpéldányát", amely a vállalat jelenlegi lehetőségeit tükrözi a chip csomagolás terén.
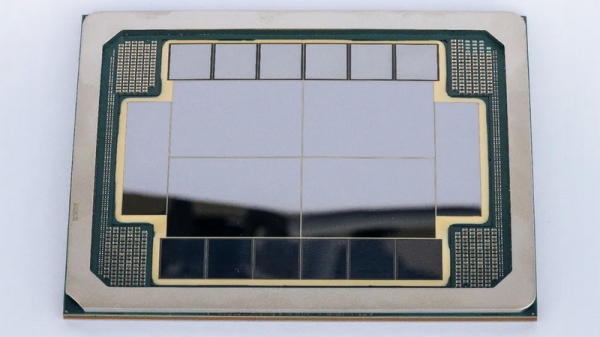
Az Intel megmutatott egy nyolc fotomintázat standard chip méretű SiP rendszerét, amely négy logikai blokkot, 12 HBM4 osztályú réteget és két bemeneti/kimeneti blokkot tartalmaz. A 16 logikai blokkot és 24 HBM5 réteget tartalmazó nagyszabású koncepcióval ellentétben, amit a cég a múlt hónapban bemutatott, ez a rendszer valóban gyártásra kész már ma.
Fontos megjegyezni, hogy az Intel Foundry nem egy működő AI gyorsítót mutatott be, hanem az "AI chip tesztpéldányát", amely azt demonstrálja, hogyan lehet fizikailag létrehozni (vagy inkább összeszerelni) a jövőbeli AI és nagy teljesítményű számítástechnikai processzorokat. Az Intel bemutatja az építési módszert, amely ötvözi a nagy számítási blokkokat, a nagy sebességű memória rétegeket, a rendkívül gyors chip közötti kapcsolatokat és az új táplálási technológiákat egy technológiai házban. Ez a ház jelentősen eltér attól, amit ma olyan cégek kínálnak, mint a TSMC. Az Intel azt szeretné megmutatni, hogy a következő generációs processzorok a nagy teljesítményű AI számára sokchipletes szerkezettel rendelkezhetnek, és az Intel Foundry már képes azokat előállítani.
A bemutatott platform alapja négy nagy logikai blokk, amely valószínűleg az Intel 18A technológiai folyamatára épül (ezért a körműtétű RibbonFET tranzisztorokkal és a hátoldali PowerVia tápegységgel rendelkezik), és amelyeket HBM4 osztályú memóriahalmok és I/O blokkok vesznek körül. Minden kulcsfontosságú elem valószínűleg EMIB-T 2.5D hidakkal van összekötve, amelyeket közvetlenül a tokozás alapjára építettek. Az Intel az EMIB-T chipek közötti interfész technológiáját használja, amely átvezető szilícium áttöréseket ad hozzá a hidakba, hogy az energia és a jelek függőlegesen és vízszintesen is áthaladhassanak, maximalizálva a kapcsolatok sűrűségét és az energiaellátást. A platform az UCIe chipek közötti interfészekre lett tervezve, amelyek 32 GT/s sebességen és felette működnek, és amelyek nyilvánvalóan szintén a C-HBM4E halmok csatlakoztatására szolgálnak.
A chip tesztpéldánya szintén demonstrálja az Intel áttérését a függőleges összeszerelésre. A vállalat technológiai folyamatainak útitervében szerepel az Intel 18A-PT technológia, amelyet kifejezetten a chiplet-ek számára fejlesztettek ki, ami a logikai kristályok vagy memória elhelyezését jelenti a tetején. Ennek megfelelően a chipleteknek hátoldali energiaellátással kell rendelkezniük, és átvezető és hibrid összeköttetéseket kell használniuk. A „mesterséges intelligencia processzor tesztpéldánya” esetében a 18A-PT alap kristályok a 18A/18A-P számítási kristályok alatt helyezkednek el, és vagy nagy cache memóriaként működnek, vagy más segédfunkciót látnak el. Az Intel a chipletek függőleges összekötésére a Foveros csomagolási technológiák családját használja — Foveros 2.5D, Foveros-R és Foveros Direct 3D. Ezek lehetővé teszik a vékony lépésű rézcsatlakozást az aktív kristályok között a felső kristályok maximális teljesítményének és energiahatékonyságának biztosítása érdekében. Az EMIB hidakkal együtt ezek a módszerek lehetővé teszik az Intel számára, hogy hibrid laterális-vertikális összeszerelést alakítson ki, amelyet a vállalat alternatívaként pozicionál nagyobb szilícium köztes rétegekhez, amelyeknél magasabb a lemez kihasználtsága és a piacképes termékek kimenete.
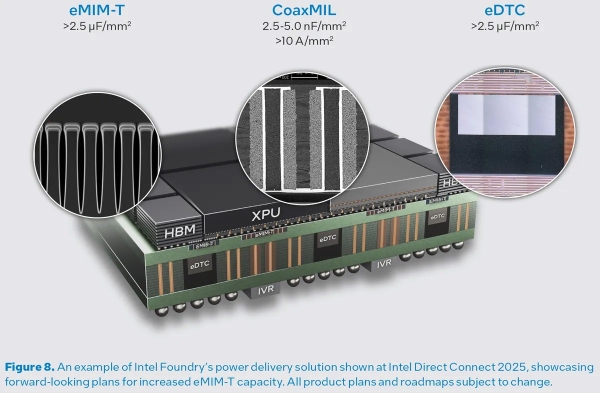
Az AI és a nagy teljesítményű számítástechnika számára készült többchipű gyorsítók fő tervezési korlátja az energiaellátás. E célból az Intel platformnak integrálnia kell az összes legújabb Intel innovációt az energiahatékonyság terén, beleértve a PowerVia-t, az Omni MIM beépített kondenzátorokat, a híd szintű leválasztást az EMIB-T-ben, az eDTC és eMIM-T kondenzátorokat az alap chipen, valamint a CoaxMIL beépített induktorokat a félintegrált feszültségszabályozók (IVR) támogatásához, amelyek minden egyes réteg alatt és a ház alatt helyezkednek el (ellentétben a TSMC CoWoS-L esetén alkalmazott IVR-rel, amelyek a közbenső réteg részét képezik). Ez a többszintű hálózat a generatív AI munkaterhelésein belüli stabil áramellátás támogatására szolgál, anélkül hogy csökkentené a feszültség szintjét.
Az Intel nyilvánvalóan próbálja vonzani az ügyfeleket a demonstrációjával. Jelenleg nem ismert, hogy a Jaguar Shores kódnevű új generációs AI-gyorsító, amelynek indulása 2027-re van tervezve, használni fogja-e azt az architektúrát, amelyet az Intel ma bemutat.
Forrás:
Forrás: 3dnews.ru
