

Rábukkantam egy érdekes anyagra a mesterséges intelligenciáról a játékokban. Az alapvető dolgok magyarázata egyszerű példákon keresztül, és emellett sok hasznos eszköz és módszer található a kényelmes fejlesztéséhez és tervezéséhez. Az is benne van, hogyan, hol és mikor kell őket használni.
A legtöbb példa pszeudokódban van megírva, ezért mély programozói tudásra nincs szükség. A kattintás után 35 oldalnyi szöveg képekkel és gifekkel, szóval készülj fel.
UPD. Elnézést, de már készült saját fordítás a cikkből a Habr-nál. . Az ő verzióját el lehet olvasni. , de valamiért a cikk elkerülte a figyelmemet (kerestem, de valami nem stimmelt). Mivel blogot írok a játékiparról, úgy döntöttem, hogy megosztom a saját fordításomat az előfizetőkkel (néhány dolog máshogy van megformálva nálam, más dolgok pedig szándékosan kihagyásra kerültek a fejlesztők tanácsára).
Mi az a mesterséges intelligencia?
A játékbeli mesterséges intelligencia azt vizsgálja, hogy milyen lépéseket kell az objektumnak végrehajtania az adott körülmények alapján. Ezt általában "intelligens ügynökök irányításának" nevezik, ahol az ügynök lehet egy játékfigura, egy jármű, egy bot, sőt néha valami elabráltabb: egy egész entitáscsoport vagy akár egy civilizáció. Minden esetben olyan dologról van szó, amelynek látnia kell a környezetét, döntéseket kell hoznia az alapján, és aszerint kell cselekednie. Ezt hívják Sense/Think/Act (Érzékelni/Gondolkodni/Cselekedni) ciklusnak:
- Érzékelni: az ügynök információt talál vagy kap a környezetében lévő dolgokról, amelyek befolyásolhatják a viselkedését (közelben lévő fenyegetések, gyűjthető tárgyak, érdekes helyek kutatásra).
- Gondolkodni: az ügynök eldönti, hogyan reagáljon (megvizsgálja, elég biztonságos-e gyűjteni a tárgyakat, vagy először harcolnia/eljárnia kell).
- Cselekedni: az ügynök végrehajtja a korábbi döntésének megfelelő lépéseket (megkezdi a mozgást az ellenfél vagy a tárgy felé).
- …most a helyzet megváltozott a karakterek cselekedetei miatt, ezért a ciklus új adatokkal ismétlődik.
A mesterséges intelligencia általában a Sense részre összpontosít a ciklusban. Például az önvezető autók fényképeket készítenek az útról, egyesítik azokat a radar és lidar adataival, és értelmezik azokat. Ezt általában a gépi tanulás végzi, amely feldolgozza a bejövő adatokat, és értelmet ad nekik, például úgy, hogy kinyeri a szemiotikus információt, mint például "van még egy autó 20 yardra előttetek". Ezek a klasszifikációs problémák.
A játékoknak nem szükséges bonyolult rendszer az információk kinyeréséhez, mivel a legtöbb adat már a játéknak szerves része. Nincs szükség képfelismerő algoritmusok futtatására, hogy meghatározzuk, van-e ellenség előttünk — a játék már tudja, és közvetíti az információt közvetlenül a döntéshozatali folyamat során. Ezért a Sense ciklusnak gyakran sokkal egyszerűbbnek kell lennie, mint a Think és Act.
A játékos mesterséges intelligencia korlátai
A mesterséges intelligenciának számos korlátozást kell figyelembe vennie:
- A mesterséges intelligenciát nem kell előre betanítani, mintha ez egy gépi tanulási algoritmus lenne. Értelmetlen neurális hálózatot írni a fejlesztés során, hogy megfigyeljük a tízezernyi játékost, és megtanuljuk a legjobb módszert arra, hogy velük szemben játsszunk. Miért? Mert a játék még nem jelent meg, és nincsenek játékosok.
- A játéknak szórakoztatnia és kihívások elé kell állítania, ezért az ügynökök nem találhatják meg a legjobb megközelítést az emberek ellen.
- Az ügynököknek valóságosnak kell tűnniük, hogy a játékosok azt érezzék, mintha valódi emberek ellen játszanának. Az AlphaGo program felülmúlta az embert, de a választott lépések jelentősen eltértek a játék hagyományos megértésétől. Ha a játék emberi ellenfelet imitál, ennek az érzésnek nem szabadna fennállnia. Az algoritmust módosítani kell, hogy hihető döntéseket hozzon, nem pedig tökéleteset.
- A mesterséges intelligenciának valós időben kell működnie. Ez azt jelenti, hogy az algoritmus nem monopolizálhatja a processzor használatát hosszú ideig a döntéshozatal során. Még 10 milliszekundum is túl hosszú ehhez, mivel a legtöbb játéknak elegendő 16–33 milliszekundum a teljes feldolgozáshoz és a következő grafikai képkocka eléréséhez.
- Ideális, ha a rendszer legalább egy része adatvezérelt, hogy a "nem programozók" is tudjanak módosításokat végezni, és hogy a korrekciók gyorsabban történhessenek.
Vizsgáljuk meg a mesterséges intelligencia megközelítéseit, amelyek átfogják a Sense/Think/Act ciklust.
Alapvető döntések meghozatala
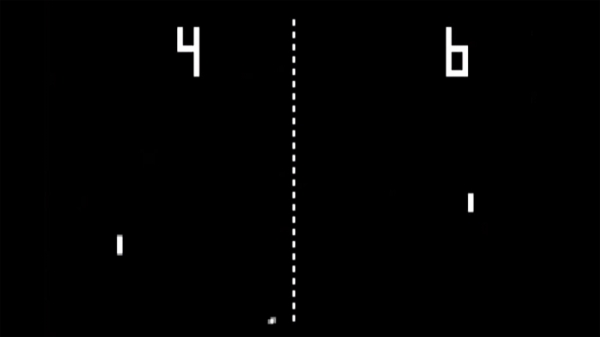
Kezdjük a legegyszerűbb játékkal — Pong. A cél: a paddlet úgy mozgatni, hogy a labda visszapattanjon róla, és ne szálljon el mellette. Olyan ez, mint a tenisz, ahol vereséget szenvedsz, ha nem sikerül visszaütni a labdát. Itt az MI viszonylag egyszerű feladatot kap — dönteni, hogy melyik irányba mozgassa a paddlet.
Feltételes operátorok
Az MI számára a Pong játékban a legnyilvánvalóbb megoldás — mindig próbálja meg a paddlet alá helyezni, ahol a labda van.
Egy egyszerű algoritmus ehhez, álnyelveken írva:
minden frame/update alatt, amíg a játék fut:
ha a labda a paddle bal oldalán van:
mozdítsd el a paddlet balra
máskülönben ha a labda a paddle jobb oldalán van:
mozdítsd el a paddlet jobbra
Ha a paddle ugyanazzal a sebességgel mozog, mint a labda, ez az ideális algoritmus az MI számára a Pong játékban. Nincs szükség bonyolításokra, ha az adatok és a lehetséges cselekvések az ügynök számára nem túl sokak.
Ez a megközelítés annyira egyszerű, hogy a Sense/Think/Act ciklus alig észlelhető. De van:
- A Sense része két if operátorban van. A játék tudja, hol van a labda és hol a paddle, ezért az MI ehhez az információhoz fordul.
- A Think része szintén két if operátorban található. Ezek a két megoldást testesítik meg, amelyek ebben az esetben kölcsönösen kizárják egymást. Ennek eredményeként egy a három cselekvés közül választunk — a paddlet balra mozgatni, jobbra mozgatni, vagy semmit sem tenni, ha már helyesen van elhelyezve.
- Az Act része a Move Paddle Left és Move Paddle Right operátorokban található. A játék tervezésétől függően azonnal vagy bizonyos sebességgel mozgathatják a paddlet.
Az ilyen megközelítéseket reagáló megoldásoknak nevezik — van egy egyszerű szabálykészlet (ebben az esetben az if operátorok a kódban), amelyek reagálnak a világ aktuális állapotára és cselekszenek.
Döntési fa
A Pong játékkal kapcsolatos példa valójában egy formális MI koncepcióra hasonlít, amelyet döntési fának neveznek. Az algoritmus végighalad rajta, hogy elérje a «levelet» — a döntést arról, hogy milyen lépést tegyen.
Készítsünk egy folyamatábrát a döntési fához a paddle algoritmusához:
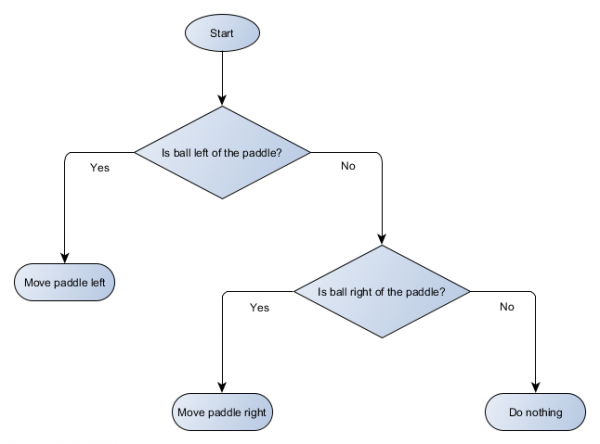
A fa minden része node-nak (csomópont) hívják – Az MI a gráfok elméletét használja az ilyen struktúrák leírására. Kétféle csomópont létezik:
- Döntési pontok: választás két alternatíva között egy adott feltétel ellenőrzése alapján, ahol minden alternatíva külön csomópontként jelenik meg.
- Végső csomópontok: végrehajtandó cselekvés, amely a végső döntést képviseli.
Az algoritmus a fa első csomópontjával (a "gyökérrel") kezdődik. Vagy eldönti, hogy melyik gyermekcsomópontra lépjen, vagy végrehajt egy műveletet, amely a csomópontban van, és befejeződik.
Mi a haszna, ha a döntési fa ugyanazt a munkát végzi, mint az if-utasítók az előző részben? Itt egy közös rendszer van, ahol minden döntésnek csak egy feltétele és két lehetséges kimenetele van. Ez lehetővé teszi a fejlesztő számára, hogy az adatokból, amelyek a fa döntéseit képviselik, mesterséges intelligenciát hozzon létre, elkerülve annak hardkódolását. Tekintsük ezt táblázatos formában:
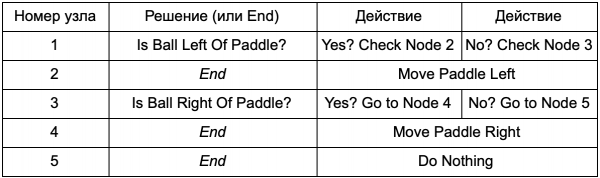
A kód oldalán egy sorok olvasására szolgáló rendszert kapsz. Hozz létre csomópontot mindegyik számára, és csatlakoztasd a döntési logikát a második oszlop alapján, valamint a harmadik és negyedik oszlop alapján a gyermekcsomópontokat. Még mindig programoznod kell a feltételeket és a műveleteket, de most a játékstrukturád bonyolultabbá válik. További döntéseket és műveleteket adsz hozzá, majd beállítod az egész AI-t, egyszerűen szerkesztve a fa definícióját tartalmazó szöveges fájlt. Ezt követően átadod a fájlt a játékkonceptőrnek, aki megváltoztathatja a viselkedést anélkül, hogy újra kellene fordítania a játékot vagy módosítania a kódot.
A döntési fák rendkívül hasznosak, amikor automatikusan építik őket egy nagy példakészlet alapján (például az ID3 algoritmus használatával). Ez hatékony és nagy teljesítményű eszközzé teszi őket a helyzetek osztályozására a kapott adatok alapján. Azonban túlmegyünk a puszta rendszeren, amelyet az ügynökök cselekvéseinek kiválasztására használunk.
Forgatókönyvek
Megvizsgáltuk a döntési fa rendszerét, amely előre elkészített feltételeket és műveleteket használt. Az AI-t tervező ember úgy szervezheti a fát, ahogy akarja, de még mindig a kódolóra kell támaszkodnia, aki mindezt programozta. Mi lenne, ha eszközöket tudnánk adni a tervezőnek saját feltételeik vagy műveleteik létrehozásához?
Annak érdekében, hogy a programozónak ne kelljen kódot írnia a 'Is Ball Left Of Paddle' és 'Is Ball Right Of Paddle' feltételekhez, olyan rendszert alkothat, ahol a tervező rögzítheti a feltételeket e értékek ellenőrzésére. Így a döntési fa adatai így néznének ki:
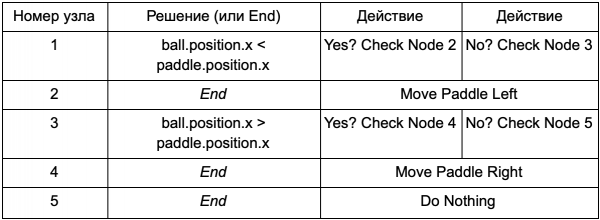
Alapvetően ugyanolyan, mint az első táblázatban, de a megoldások saját kóddal rendelkeznek, amely egy kicsit hasonlít az if-utasítás feltételes részére. A kód oldalán ez a második oszlopban olvasható a döntési csomópontok számára, de a konkrét feltétel keresése (Is Ball Left Of Paddle) helyett a feltételes kifejezést értékeli, és visszaadja az igaz vagy hamis értéket ennek megfelelően. Ezt a Lua vagy Angelscript script nyelv segítségével végzik. Ezekkel a fejlesztő képes saját játékának objektumait (labda és ütő) kezelni, és olyan változókat létrehozni, amelyek elérhetőek a scriptben (ball.position). Ezen kívül a scriptnyelv egyszerűbb, mint a C++. Nem igényel teljes fordítási szakaszt, így ideális a játék logikájának gyors módosításához, és lehetővé teszi a „nem programozók” számára, hogy saját funkciókat hozzanak létre.
A fenti példában a scriptnyelv általánosan csak a feltételes kifejezés értékelésére van használva, de tevékenységekre is alkalmazható. Például az Move Paddle Right adatok scriptutasítássá válhatnak (ball.position.x += 10). Így a tevékenység is a scriptben határozható meg, anélkül, hogy a Move Paddle Right programozása szükséges lenne.
Még tovább is mehetünk, és teljes döntési fákat írhatunk script nyelven. Ez kód lesz, amely mereven kódolt (hardcoded) feltételes operátorok formájában jelenik meg, de ezek külső scriptfájlokban találhatók, amelyek így módosíthatók anélkül, hogy az egész programot újra kellene fordítani. Gyakran módosíthatja a scriptfájlt közvetlenül a játék során, hogy gyorsan tesztelhessen különböző AI reakciókat.
Eseményekre reagálás
A fenti példák tökéletesen illeszkednek a Ponghoz. Folyamatosan futtatják a Sense/Think/Act ciklust, és az utolsó világ állapota alapján cselekszenek. De bonyolultabb játékokban külön eseményekre kell reagálni, nem pedig mindent egyszerre értékelni. A Pong ebből a szempontból már nem a legjobb példa. Válasszunk másikat.
Képzeljünk el egy lövöldözős játékot, ahol az ellenfelek mozdulatlanok, amíg észre nem veszik a játékost, ezután pedig a 'szakértelmük' alapján cselekednek: valaki rohamozni fog, valaki távolról támad. Ez még mindig egy alap reagáló rendszer - 'ha a játékos észlelve van, akkor csinálj valamit', - de logikailag felosztható Player Seen eseményre (játékos észlelve) és reakcióra (válasszon választ és hajtsa végre).
Ez visszavezeti minket a Sense/Tthink/Act ciklushoz. Meg tudjuk írni a Sense részt, amely minden egyes frame-nél ellenőrzi, hogy a mesterséges intelligencia látja-e a játékost. Ha nem, akkor semmi nem történik, de ha igen, akkor egy Player Seen esemény keletkezik. A kódnak lesz egy külön része, amely azt mondja: «amikor a Player Seen esemény történik, csinálj », ahol — a válasz, amelyre szükséged van a Think és Act részek hívásához. Így beállítod a Player Seen eseményre adott reakciókat: a „támadó” karakterre — ChargeAndAttack, a mesterlövészekre pedig — HideAndSnipe. Ezeket a kapcsolatokat adatfájlban is létrehozhatod, hogy gyorsan szerkeszthesd anélkül, hogy újra kellene fordítani. Itt is használhatod a szkriptnyelvet.
Bonyolult döntéshozatal
Bár az egyszerű reakciós rendszerek nagyon hatékonyak, sok olyan helyzet van, amikor nem elegendőek. Néha különböző döntéseket kell hozni, amelyek azon alapulnak, hogy az ügynök jelenleg mit csinál, de ezt nehezen lehet feltételként prezentálni. Néha túl sok feltétel létezik ahhoz, hogy hatékonyan ábrázolhassuk őket egy döntési fában vagy szkripten. Néha előre kell értékelni, hogyan változik a helyzet, mielőtt döntést hozunk a következő lépésről. Ezeknek a problémáknak a megoldásához bonyolultabb megközelítések szükségesek.
Végső állapotgép
A végső állapotgép vagy FSM (végső automata) egy módja annak, hogy elmondjuk, hogy ügynökünk éppen egy adott állapotban van a több lehetséges állapot közül, és hogy képes átmenni az egyik állapotból a másikba. Ezeknek az állapotoknak a száma meghatározott — ezért van a neve is. A legjobb példa az életből egy közlekedési lámpa. Különböző helyeken más és más fényelőírások vannak, de az elv ugyanaz — minden egyes állapot valamit reprezentál (állj, menj stb.). A közlekedési lámpa bármely pillanatban csak egy állapotban van, és egyszerű szabályok alapján léphet át egyik állapotból a másikba.
A játékok NPC-ivel hasonló a helyzet. Példaként vegyünk egy őrt a következő állapotokkal:
- Párhuzamosan (Patrolling).
- Támadó (Attacking).
- Menekül (Fleeing).
És ezek a feltételek az állapotának megváltoztatásához:
- Ha az őr látja az ellenfelet, megtámadja.
- Ha az őr támad, de már nem látja az ellenfelet, visszatér a párhuzamos járatba.
- Ha az őr támad, de súlyosan megsebesült, menekül.
A if-operators can also be written with a guard state variable and various checks: is there an enemy nearby, what is the NPC's health level, etc. Let's add a few more states:
- Tevékenység hiánya (Idling) - a járőrözések között.
- Keresés (Searching) - amikor a megfigyelt ellenség elbújt.
- Segítséget kérni (Finding Help) - amikor az ellenség észlelve van, de túl erős ahhoz, hogy egyedül harcoljunk vele.
Mindenkinek korlátozott választása van - például a őr nem megy el keresni a rejtőzködő ellenséget, ha alacsony az életereje.
Végül a hatalmas 'ha' lista <x и y, но не z>, akkor <p>, túl terjesszé válhat, ezért érdemes formális módszert kidolgozni, amely lehetővé teszi számunkra, hogy szem előtt tartsuk az állapotokat és az állapotok közötti átmeneteket. Ehhez vegyük figyelembe az összes állapotot, és minden állapot alá írjuk fel a többi állapotba való átmeneteket a szükséges feltételeikkel együtt.
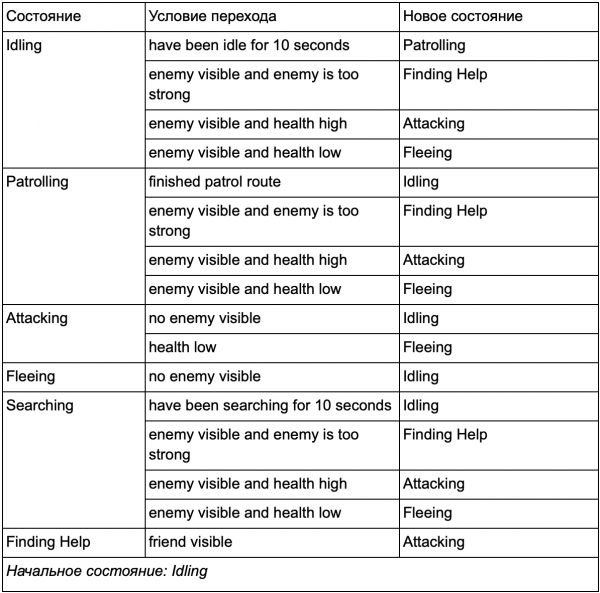
Ez az állapotátmenetek táblázata - egy összetett módja az FSM bemutatásának. Rajzoljunk egy diagramot, és teljes áttekintést kapunk arról, hogyan változik az NPC viselkedése.
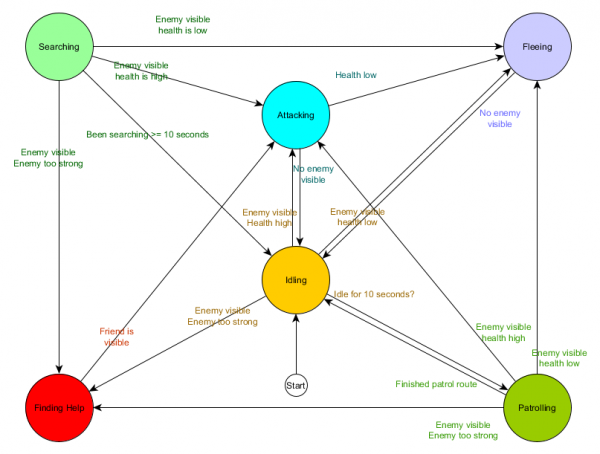
A diagram tükrözi ennek az ügynöknek a döntéshozatali lényegét a jelenlegi helyzet alapján. Minden nyíl az állapotok közötti átmenetet mutatja, ha a mellette lévő feltétel igaz.
Minden frissítésnél ellenőrizzük az ügynök aktuális állapotát, átnézzük az átmenetek listáját, és ha az átmenet feltételei teljesülnek, új állapotot vesz fel. Például minden egyes képkockában ellenőrizni kell, hogy letelt-e a 10 másodperces időzítő, és ha igen, az Idling állapotból az őr a Patrolling állapotba lép. Hasonlóképpen, az Attacking állapot ellenőrzi az ügynök egészségét - ha az alacsony, akkor a Fleeing állapotba lép.
Ez az állapotok közötti átmenetek kezelése, de mi a helyzet a konkrét állapotokkal kapcsolatos viselkedéssel? Ami a konkrét állapotok tényleges viselkedésének megvalósítását illeti, általában kétféle 'hook' létezik, ahol a műveleteket az FSM-hez rendeljük:
- Azok a tevékenységek, amelyeket időről időre végrehajtunk az aktuális állapot számára.
- Azok a tevékenységek, amelyeket az egyik állapotból a másikba való átlépéskor végzünk.
Példák az első típusra. A Patrolling állapot minden egyes képkockában mozgatja az ügynököt a járőrutvonal mentén. Az Attacking állapot minden egyes képkockában megpróbál támadást indítani, vagy átmenni egy olyan állapotba, amikor ez lehetséges.
A második típust tekintve vizsgáljuk meg az átváltást: "ha az ellenség látható és az ellenség túl erős, akkor kapcsolódjunk a Segítség Keresése állapotba. Az ügynöknek ki kell választania, hová menjen segítségért, és meg kell őriznie ezt az információt, hogy a Segítség Keresése állapot tudja, hová forduljon. Miután a segítség megtalálódott, az ügynök visszatér az Támadás állapotba. Ekkor szeretné tájékoztatni a szövetségest a fenyegetésről, így létrejöhet a Fenyegetés Bejelentése akció.
Újra megnézhetjük ezt a rendszert a Sense/Think/Act ciklus szemszögéből. A Sense az átváltási logikában használt adatokban ölt testet. A Think az egyes állapotokban elérhető átváltásokban. Az Act pedig a periodikusan, az állapotkeretein belül végzett akciókban valósul meg.
Néha a folyamatos átmeneti állapotok ellenőrzése költséges lehet. Például, ha minden ügynök bonyolult számításokat végez minden egyes képkockán, hogy meghatározza, lát-e ellenségeket és hogy áttérhet-e a Járőrözés állapotból a Támadás állapotba — ez rengeteg processzort igényel.
A világ állapotában bekövetkező fontos változásokat olyan eseményekként kell tekinteni, amelyeket a megjelenésükkor fognak feldolgozni. Ahelyett, hogy a FSM minden egyes képkockán ellenőrizné, hogy "látja-e az ügynök a játékost?", be lehet állítani egy külön rendszert, amely ritkábban végez ellenőrzéseket (például másodpercenként 5 alkalommal). Az eredmény pedig a Játékos Látva, amikor az ellenőrzés sikeres.
Ez átadódik a FSM-nek, amelynek most át kell térnie a Játékos Látva esemény megkapására és ennek megfelelően reagálni. Az összviszályi viselkedés ugyanaz, kivéve, hogy szinte észrevétlen késlekedés van a válaszadás előtt. De ezáltal a teljesítmény javult azáltal, hogy a Sense egy részét külön programrészbe elkülönítettük.
Hierarchikus véges állapotgép
Azonban nagy FSM-ekkel dolgozni nem mindig kényelmes. Ha ki szeretnénk bővíteni a támadási állapotot, külön MeleeAttacking (közelharc) és RangedAttacking (távoli harc) állapotokkal, meg kell változtatnunk azokat az átmeneteket, amelyek minden más állapotból az Támadás állapotba vezetnek (jelenlegi és jövőbeli).
Bizonyára észrevetted, hogy példánkban sok ismétlődő átmenet van. A legtöbb átmenet az Idling állapotban megegyezik a Patrolling állapotban lévőkkel. Jó lenne elkerülni a megismétlést, különösen, ha további hasonló állapotokat adunk hozzá. Érdemes lenne az Idling és Patrolling állapotokat egy közös „nem harci” címke alá csoportosítani, ahol csak egy közös átmeneti halmaz van a harci állapotokhoz. Ha ezt a címkét állapotként képzeljük el, akkor az Idling és Patrolling alsó állapotokká válnak. Példa egy külön átmeneti táblázat használatára az új nem harci alsó állapothoz:
Alapvető állapotok:
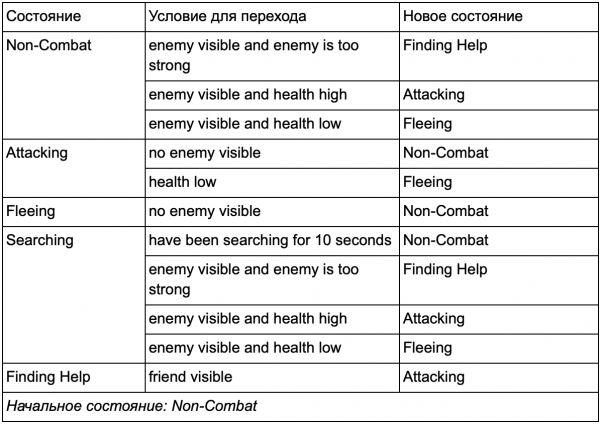
Nem harci állapot:
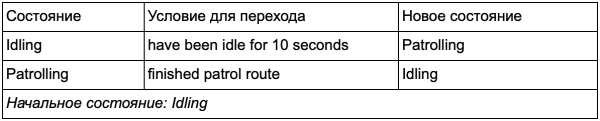
És diagram formájában:
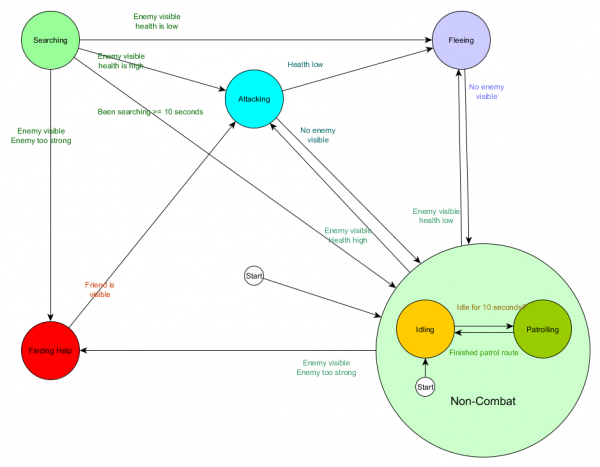
Ez ugyanaz a rendszer, de új nem harci állapottal, amely magában foglalja az Idling és Patrolling állapotokat. Mivel minden állapot tartalmaz egy FSM-t alsó állapotokkal (az alsó állapotok pedig saját FSM-mel rendelkeznek — és így tovább, ahogy szükséges), kapunk egy Hierarchical Finite State Machine-t vagy HFSM-t (hierarchikus végállapot gép). A nem harci állapot csoportosításával sok fölösleges átmenetet eltávolítottunk. Ugyanezt megtehetjük bármely új állapotra, amely közös átmeneteket tartalmaz. Például, ha a jövőben az Attacking állapotot MeleeAttacking és MissileAttacking állapotokra bővítjük, akkor ezek alsó állapotokká válnak, amelyek egymás között lépnek át az ellenség távolsága és a lőszer rendelkezésre állása alapján. Végül a bonyolult viselkedési modellek és az almodellek a lehető legkevesebb ismétlődő átmenettel ábrázolhatók.
Viselkedési fa
HFSM segítségével bonyolult viselkedési kombinációk hozhatók létre egyszerű módon. Mindazonáltal van egy kis nehézség, hogy a döntéshozatal átmeneti szabályok formájában szorosan kapcsolódik az aktuális állapothoz. És sok játékban ez pontosan az, amire szükség van. Az állapotok hierarchiájának gondos használata csökkentheti az átmenetek ismétlődését. De néha olyan szabályokra van szükség, amelyek függetlenül attól működnek, hogy melyik állapotban vagy, vagy amelyek szinte bármely állapotban alkalmazhatók. Például, ha az ügynök egészsége 25% alá csökkent, szeretnéd, ha menekülne, függetlenül attól, hogy harcban, tétlenül vagy beszélgetés közben van — ezt a feltételt minden állapotba be kell illesztened. Ha pedig később a terveződ meg akarja változtatni az alacsony egészség küszöbét 25%-ról 10%-ra, akkor ezt ismét kezelni kell.
Ideális esetben szükség van egy olyan rendszerre, amelyben a "milyen állapotban legyünk" döntések az állapotokon kívül helyezkednek el, így módosításokat csak egy helyen kell végezni, anélkül hogy a váltási feltételeket megérintenénk. Itt lépnek életbe a viselkedési fák.
Többféle megvalósítás létezik, de a lényeg minden esetben hasonló a döntési fához: az algoritmus a "gyökér" csomóponttal kezdődik, a fában pedig csomópontok találhatók, amelyek vagy döntéseket, vagy műveleteket képviselnek. Igaz, van néhány kulcsfontosságú különbség:
- Most a csomópontok három lehetséges eredményt adnak: Sikeres (ha a munka elvégezve), Sikertelen (ha nem tudja elindítani) vagy Folyamatban (ha még mindig fut és nincs végső eredmény).
- Nincs többé döntési csomópont a két alternatíva közötti választáshoz. Helyette Decorator csomópontok vannak, amelyeknek egyetlen gyermek csomópontja van. Ha azok Sikeresek, akkor végrehajtják egyetlen gyermek csomópontjukat.
- A műveleteket végrehajtó csomópontok Running értéket adnak vissza, ami a folyamatban lévő műveleteket reprezentálja.
Ez a kis csomópontkészlet sok bonyolult viselkedési modell létrehozására egyesíthető. Gondoljunk a korábbi példa HFSM őrére viselkedési fa formájában:
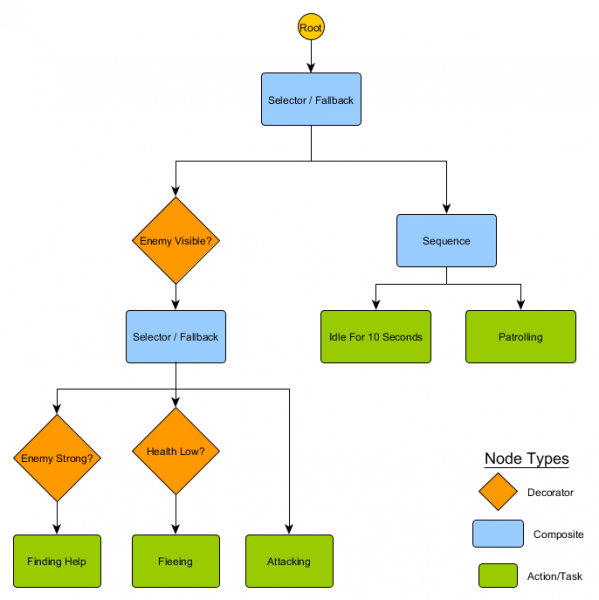
Ezzel a struktúrával nem lenne nyílt átmenet az Idling/Patrolling állapotokból az Attacking vagy bármely más állapotba. Ha az ellenség látható és a karakter élete alacsony, a végrehajtás megáll a Fleeing csomóponton, függetlenül attól, hogy korábban melyik csomópontot hajtotta végre — Patrolling, Idling, Attacking vagy bármely más.
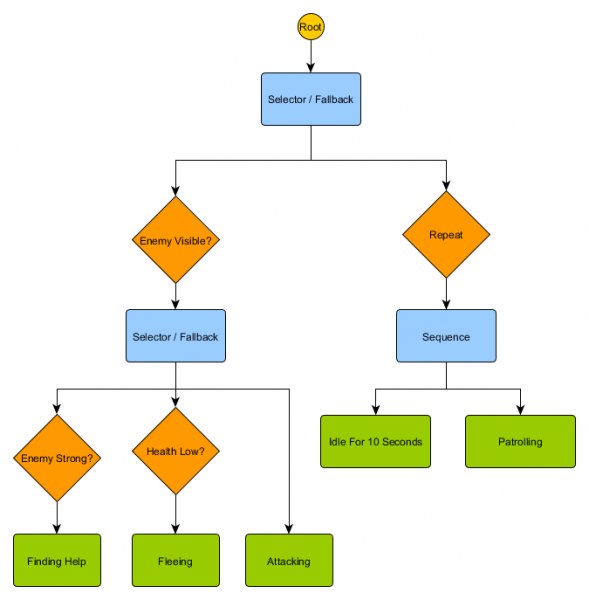
A viselkedési fák bonyolultak — sokféleképpen lehet őket összeállítani, és a dekorátorok és összetett csomópontok helyes kombinációjának megtalálása is problémás lehet. Felmerül a kérdés, hogy milyen gyakran ellenőrizzük a fát — minden részén végig kell menni, vagy csak akkor, amikor egy feltétel megváltozik? Hogyan tároljuk a csomópontokhoz kapcsolódó állapotokat — hogyan tudjuk, mikor voltunk Idling állapotban 10 másodpercig, vagy hogyan tudjuk, milyen csomópontokat hajtottunk végre legutóbb, hogy helyesen kezeljük a sorrendet?
Ez az oka annak, hogy számos megvalósítás létezik. Például egyes rendszerekben a dekorátor csomópontokat beépített dekorátorokkal helyettesítették. Ezek újraértékelik a fát a dekorátor feltételeinek megváltozása esetén, segítenek a csomópontok összekapcsolásában és időszakos frissítéseket biztosítanak.
Használati alapú rendszer
Néhány játéknak számos különféle mechanikája van. Előnyös, ha ezek mind élvezhetik az egyszerű és általános átmeneti szabályok előnyeit, de nem szükséges, hogy teljes viselkedési fát alkossanak. Ahelyett, hogy világos választási lehetőségekkel vagy lehetséges cselekvések fájával rendelkeznének, könnyebb minden cselekvést tanulmányozni és kiválasztani a legmegfelelőbbet a pillanatban.
A haszonelvű rendszer (utility-based system) ebben segít. Ez egy olyan rendszer, ahol az ügynöknek számos cselekedete van, és ő maga választja ki, hogy melyiket hajtja végre, a cselekvések relatív hasznossága alapján. A hasznosság egy önkényes mértéke annak, mennyire fontos vagy kívánatos egy adott cselekvés végrehajtása az ügynök számára.
A cselekvés hasznosságát, amelyet az aktuális állapot és környezet alapján számítanak ki, az ügynök bármikor ellenőrizheti, és választhat egy másik, leginkább megfelelő állapotot. Ez hasonlít az FSM-re, kivéve, hogy itt az átmenetek minden potenciális állapot, beleértve az aktuális állapot értékelése alapján kerülnek meghatározásra. Ne feledjük, hogy a leghasznosabb cselekvést választjuk a váltáshoz (vagy maradunk, ha már végrehajtottuk azt). A változatosság kedvéért ez lehet egy súlyozott, de véletlenszerű választás egy rövid listából.
A rendszer egy önkényes hasznossági értékintervallumot rendel a cselekvésekhez — például 0-tól (teljesen nem kívánatos) 100-ig (teljesen kívánatos). Minden cselekvéshez tartozik egy sor paraméter, amely befolyásolja ennek az értéknek a kiszámítását. Visszatérve az őr példájához:
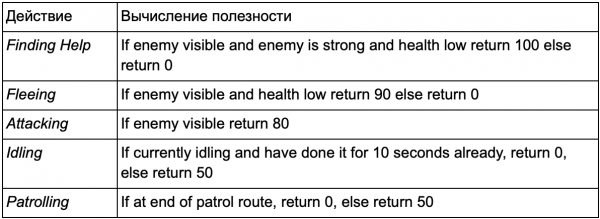
Az akciók közötti átmenetek nem egyértelműek — bármely állapot követheti bármely másikat. Az akciók prioritásai a hasznossági értékelésekben találhatóak. Ha az ellenség látható, és ez az ellenség erős, míg a karakter élete alacsony, akkor a Fleeing és a FindingHelp is magas, nem nulla értékeket fog visszaadni. Ugyanakkor a FindingHelp mindig magasabb lesz. Hasonlóképpen, a nem harci akciók soha nem adnak vissza 50-nél nagyobb értéket, ezért mindig alacsonyabbak a harci akcióknál. Ezt figyelembe kell venni az akciók létrehozásakor és hasznosságuk kiszámításakor.
Példánkban a tevékenységek vagy egy fix állandó értéket, vagy két rögzített érték egyikét adják vissza. Egy reálisabb rendszer folyamatos értéktartományból adna vissza értékelést. Például a Fleeing tevékenység magasabb hasznossági értékeket ad vissza, ha az ügynök egészségi állapota alacsony, míg az Attacking tevékenység alacsonyabb értékeket, ha az ellenség túl erős. Emiatt a Fleeing tevékenység prioritást élvez az Attacking tevékenységgel szemben bármilyen helyzetben, amikor az ügynök úgy érzi, hogy nincs elég egészsége ahhoz, hogy győzzön az ellenfelén. Ez lehetővé teszi a tevékenységek prioritásainak módosítását bármilyen számú kritérium alapján, ami rugalmasabbá és változatosabbá teszi ezt a megközelítést, mint a viselkedési fa vagy az FSM.
Minden tevékenység számos feltételt tartalmaz a program kiszámításához. Ezeket meg lehet írni szkriptnyelven vagy matematikai formulák sorozataként. A The Sims-ben, amely a karakter napi rutinját modellezi, egy további számítási szintet vezetnek be — az ügynök egy sor „motivációt” kap, amelyek hatással vannak a hasznossági értékekre. Ha a karakter éhes, akkor idővel egyre éhesebb lesz, és az EatFood tevékenység hasznossági eredménye egyre növekedni fog, amíg a karakter el nem végzi azt, csökkentve az éhség szintjét, és az EatFood értékét nullára visszaállítva.
Az a gondolat, hogy a tevékenységeket hasznossági értékek alapján választjuk ki, meglehetősen egyszerű, ezért a hasznossági alapú rendszert az AI döntéshozatali folyamatainak részévé lehet tenni, nem pedig teljes helyettesítésként. A döntési fa kérheti két gyermekcsomópont hasznossági értékének megállapítását, és a magasabbat választhatja. Hasonlóképpen, a viselkedési fa tartalmazhat egy összetett Utility csomópontot a tevékenységek hasznossági értékeinek értékelésére, hogy eldöntse, melyik gyermekelemet hajtson végre.
Mozgás és navigáció
A korábbi példákban volt egy platform, amelyet balra vagy jobbra mozgattunk, és egy őr, amely patrulált vagy támadott. De hogyan kezeljük pontosan az ügynök mozgását egy adott időtartamon belül? Hogyan állítjuk be a sebességet, hogyan kerülünk el akadályokat, és hogyan tervezzük meg az útvonalat, ha a célhoz jutás nehezebb, mint egyszerűen egyenesen haladni? Nézzük meg ezt.
Kezelés
A kezdeti szakaszban feltételezhetjük, hogy minden ügynöknek van egy sebessége, amely magában foglalja, hogy mennyire gyorsan mozog és melyik irányba. Ezt mérhetjük méter/másodperc, kilométer/óra, pixel/másodperc stb. Egyszerűen visszaemlékezve a Sense/Think/Act ciklusra, elképzelhetjük, hogy a Think rész kiválasztja a sebességet, míg az Act rész alkalmazza ezt a sebességet az ügynökre. Általában a játékokban van egy fizikai rendszer, amely elvégzi ezt a feladatot helyettünk, megvizsgálva minden objektum sebességét és szabályozva azt. Így az AI-nak csak az a feladata, hogy eldöntse, milyen sebességgel kell rendelkeznie az ügynöknek. Ha tudjuk, hová kellene az ügynöknek mennie, akkor azt a helyes irányba kell mozgatnunk a megadott sebességgel. Egy nagyon triviális egyenlet:
desired_travel = destination_position – agent_position
Képzeljünk el egy 2D világot. Az ügynök a (-2,-2) pontban helyezkedik el, a célpont pedig valahol északkeletre a (30, 20) koordinátán, és a szükséges út, amit az ügynöknek meg kell tennie, hogy ott legyen — (32, 22). Tegyük fel, hogy ezek a pozíciók méterben vannak mérve — ha az ügynök sebességét 5 méter/másodpercre állítjuk, akkor a mozgási vektorunkat skálázzuk, és körülbelül (4.12, 2.83) sebességet kapunk. Ezekkel a paraméterekkel az ügynök majdnem 8 másodperc múlva érkezne meg a célhoz.
Az értékeket bármikor újra lehet számolni. Ha az ügynök félúton van a cél felé, akkor a mozgás a fele hosszúságú lenne, de mivel az ügynök maximális sebessége 5 m/s (ahogy azt korábban megállapítottuk), a sebesség ugyanaz marad. Ez a mozgó célokra is működik, lehetővé téve az ügynök számára, hogy apró módosításokat végezzen a célok elmozdulása közben.
De több változatosságot szeretnénk — például lassan növelni a sebességet, hogy szimuláljuk egy karakter mozgását álló helyzetből futásra. Ugyanezt megtehetjük a megállás előtt. Ezeket a funkciókat steering behaviours néven ismerik, mindegyiknek konkrét nevei vannak: Seek (keresés), Flee (menekülés), Arrival (érkezés) stb. Az ötlet az, hogy gyorsulási erőket lehet alkalmazni az ügynök sebességére, a célpont pozíciójával és az aktuális sebességgel végzett összehasonlítás alapján, hogy különböző módokat alkalmazzunk a célhoz való eljutásra.
Minden viselkedésnek egy kicsit más célja van. A Seek és Arrival a módszerek, amellyel az ügynök eljut a célhelyre. Az Obstacle Avoidance (akadálykerülés) és a Separation (különválasztás) az ügynök mozgását korrigálja, hogy elkerülje az akadályokat a cél felé vezető úton. Az Alignment (összhang) és a Cohesion (összetartás) azt biztosítja, hogy az ügynökök együtt mozogjanak. Bármilyen számú különböző steering behaviours összegzésre kerülhet, hogy egyetlen útvektort kapjunk, figyelembe véve minden tényezőt. Az ügynök a Arrival, Separation és Obstacle Avoidance viselkedéseit használja, hogy távol tartsa magát a falaktól és más ügynököktől. Ez a megközelítés jól működik nyitott helyeken, ahol nincsenek felesleges részletek.
Nehéz körülmények között a különböző viselkedések összegzése gyengébben működik — például egy ügynök beszorulhat a falba az Arrival és az Obstacle Avoidance konfliktusa miatt. Ezért figyelembe kell venni bonyolultabb lehetőségeket, mint csupán az összes érték összeadását. Egy ilyen módszer: az egyes viselkedések eredményeinek összeadása helyett érdemes a különböző irányokban való mozgást megfontolni és a legjobb lehetőséget választani.
Bonyolult környezetben azonban, ahol zsákutcák és irányválasztás van, szükségünk lesz valamire, ami még fejlettebb.
Útvonaltervezés
A steering behaviours kiválóan alkalmas egyszerű mozgásra nyílt térben (futballpálya vagy aréna), ahol A-ból B-be jutni egyenes út kis eltérésekkel az akadályok mellett. Bonyolultabb útvonalakhoz pathfinding (útvonaltervezés) szükséges, ami egy módszer a világ felfedezésére és a rajta való navigálás döntésére.
A legegyszerűbb módszer, ha rácsot fektetsz minden négyzetre, ami az ügynök mellett van, és értékeled, melyekben megengedett a mozgás. Ha valamelyikük a célpont, kövesd a nyomot az előző négyzetek felé, míg vissza nem érsz a kezdőpontra. Ez az általad keresett út. Ha nem, ismételd meg a folyamatot a legközelebbi négyzetekkel, amíg meg nem találod a célpontot, vagy elfogynak a négyzetek (ez azt jelenti, hogy nincs lehetséges útvonal). Ezt hivatalosan Breadth-First Search-nak vagy BFS-nek nevezik (szélességi keresési algoritmus). Minden lépésnél minden irányba figyel, így hívják „szélesség”-nek. A keresési tér hasonló a hullámfronthoz, amely addig terjed, míg el nem éri a keresett helyet — a keresés területe minden lépésnél kitágul, amíg be nem kerül a célpont, ekkor pedig nyomon követhetjük az utat a kezdethez.
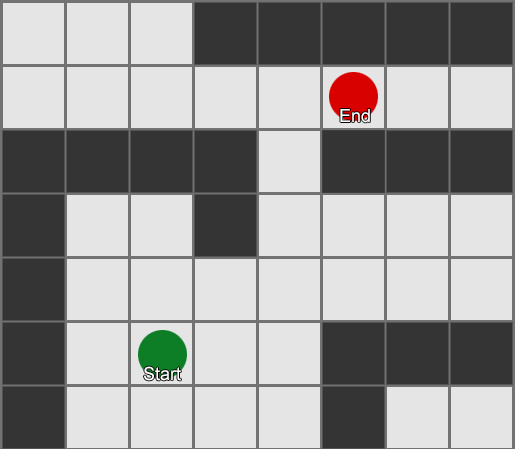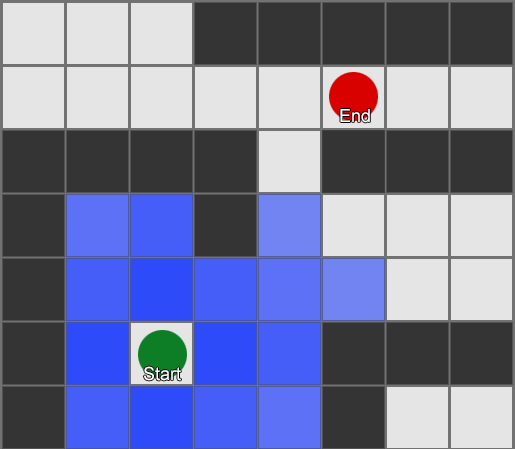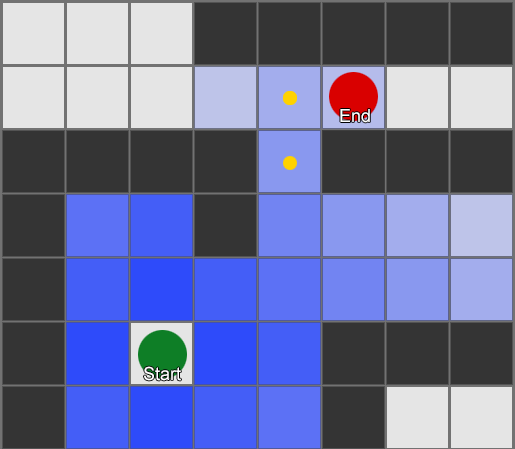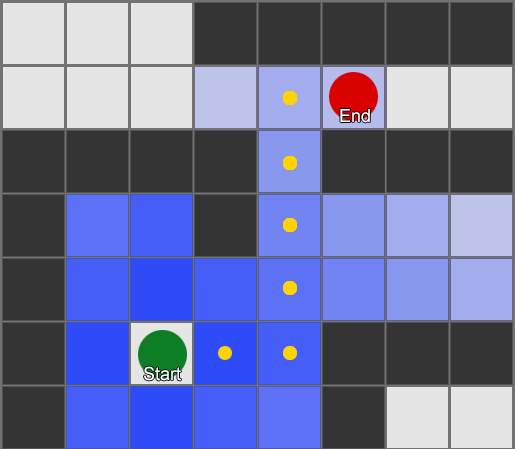
Ennek eredményeképpen kapsz egy négyzetekből álló listát, melyekből a szükséges útvonalat kialakítják. Ez az út (innen ered a pathfinding) — a helyek listája, amelyeket az ügynök meglátogat, miközben a célhoz tart.
Mivel tudjuk, hogy a világ minden négyzetének helyzete ismert, felhasználhatjuk a steering behaviours-t a mozgásra az úton — az 1. csomóponttól a 2. csomópontra, majd a 2. csomóponttól a 3. csomópontra és így tovább. A legegyszerűbb változat, ha a következő négyzet középpontjába tartasz, de még jobb, ha megállsz a szélén a jelenlegi négyzet és a következő között. Ennek köszönhetően az ügynök képes lesz levágni a sarkokat éles kanyarokban.
A BFS algoritmusnak vannak hátrányai is — annyira vizsgálja a négyzeteket „rossz” irányban, mint „jó” irányban. Itt lép be egy bonyolultabb algoritmus, az A* (A star). Ez is hasonlóan működik, de ahelyett, hogy vakon kutatná a szomszédos négyzeteket (majd a szomszédok szomszédait, és így tovább), egy listában gyűjti a csomópontokat, és úgy rendezi azokat, hogy a következő vizsgált csomópont mindig az legyen, ami a legrövidebb útvonalhoz vezet. A csomópontokat egy heurisztika alapján rangsorolják, amely figyelembe veszi két dolgot — a „költségét” a hipotetikus útvonalnak a szükséges négyzethez (beleértve a mozgás költségeit) és azt az értékelést, hogy mennyire van messze ez a négyzet a célponttól (irányítva a keresést a helyes irányba).
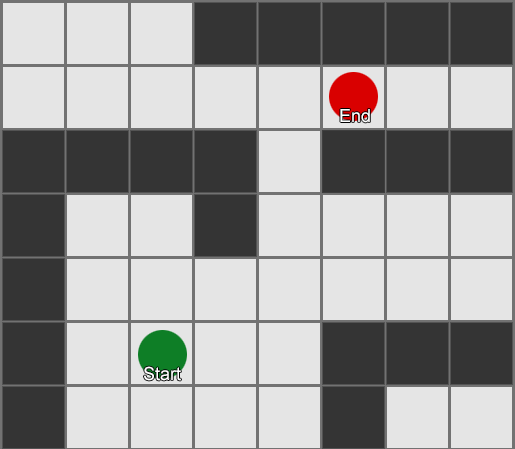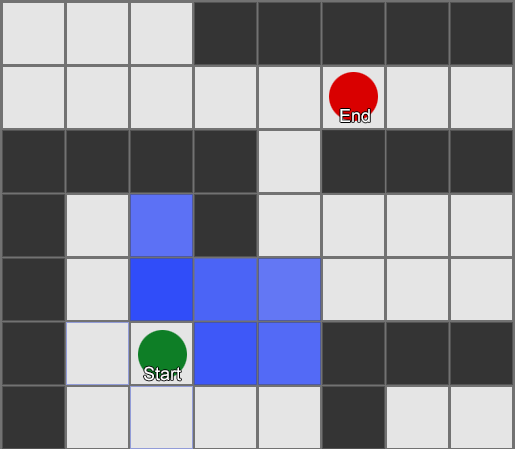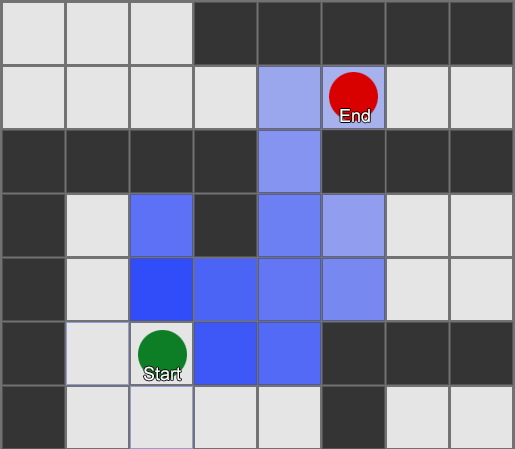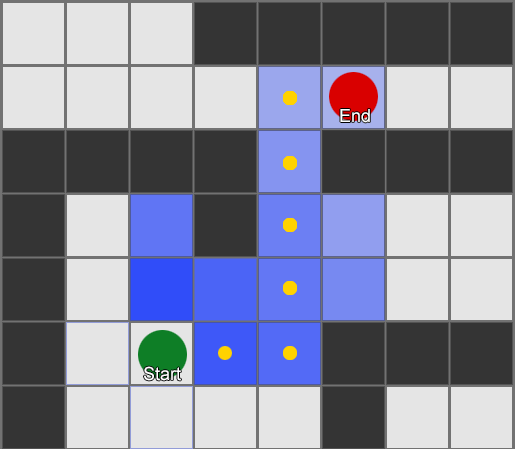
E példában látható, hogy az ügynök egy négyzetet vizsgál meg egyszerre, mindig a legígéretesebb szomszédot választva. Az elért út ugyanaz, mint a BFS esetében, de a folyamat során kevesebb négyzetet vizsgáltunk meg – ami jelentős hatással van a játék teljesítményére.
Rács nélküli mozgás
De a legtöbb játék nincs rácsra helyezve, és gyakran nem is lehet a realizmus rovására megoldani. Kompromisszumokra van szükség. Mekkora méretűek legyenek a négyzetek? Túl nagyok – és nem tudják megfelelően ábrázolni a kis folyosókat vagy kanyarokat, túl kicsik – túl sok négyzetet kell keresni, ami végső soron rengeteg időt igényel.
Először is meg kell értenünk, hogy a rács egy kapcsolt csomópontokból álló gráfot ad nekünk. Az A* és BFS algoritmusok valójában gráfokon működnek, és egyáltalán nem foglalkoznak a rácsunkkal. Bármelyik helyen elhelyezhetnénk a csomópontokat a játék világában: ha bármely két összekapcsolt csomópont között van kapcsolat, valamint a kezdő és végpont között és legalább az egyik csomóponttal – az algoritmus olyan jól fog működni, mint korábban. Ezt gyakran waypoint rendszernek nevezik, mivel minden csomópont jelentős helyet képvisel a világban, amely része lehet bármennyi hipotetikus útnak.
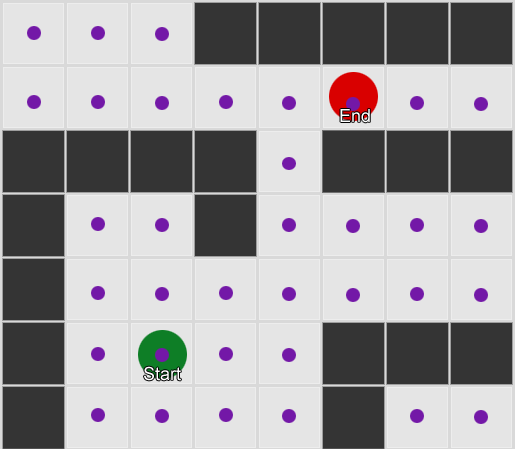
1. példa: csomópont minden négyzetben. A keresés abból a csomópontból indul, ahol az ügynök található, és a cél négyzet csomópontjában fejeződik be.
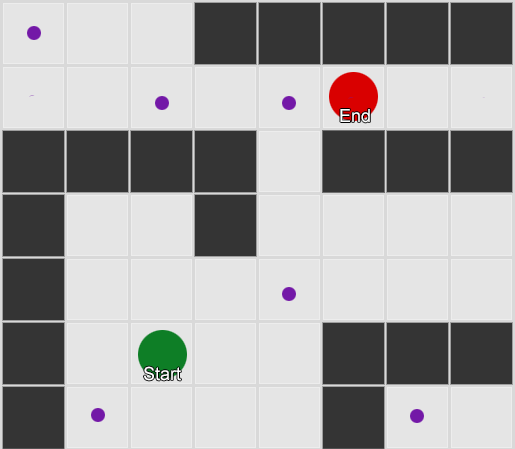
2. példa: kisebb csomópontkészlet (waypointok). A keresés a négyzetben kezdődik, ahol az ügynök található, áthalad a szükséges számú csomóponton, majd folytatódik a célállomásig.
Ez egy meglehetősen rugalmas és erőteljes rendszer. De némi óvatosság szükséges a döntésekben, hogy hol és hogyan helyezzük el a waypointokat, különben az ügynökök egyszerűen nem látják a legközelebbi pontot, és nem tudják megkezdeni az utat. Könnyebb lenne, ha automatikusan elhelyezhetnénk a waypointokat a világ geometriája alapján.
Itt lép életbe a navigation mesh, azaz navmesh (navigációs rács). Ez általában egy 2D-s háromszögháló, amely a világ geometriájára van rávetítve – mindenhol, ahol az ügynök szabadon járhat. A háló minden háromszöge csomóponttá válik a gráfban, és legfeljebb három szomszédos háromszöggel rendelkezhet, amelyek a gráf szomszédos csomópontjaivá válnak.
Ez a kép az Unity motor példája — elemezte a világ geometriáját, és létrehozta a navmesht (a képernyőképen világoskék színnel). Minden poligon a navmesh-en egy terület, ahol az ügynök állhat vagy egyik poligonból a másikba mozoghat. Ebben a példában a poligonok kisebbek, mint az általuk képviselt emeletek — ezt azért tették, hogy figyelembe vegyék az ügynök méreteit, amelyek túlléphetnek a nominális helyzetén.
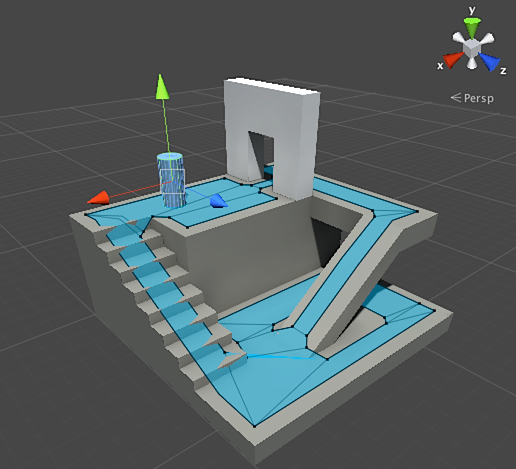
Képesek vagyunk keresni az útvonalat ezen a hálón, ismét az A* algoritmust használva. Ez szinte tökéletes útvonalat ad nekünk a világban, amely figyelembe veszi az összes geometriát, miközben nem igényel felesleges csomópontokat és útvonalpontok létrehozását.
Az útvonaltervezés — túl széles téma, amelyről egyetlen szakaszú cikk kevés. Ha szeretné jobban megismerni, akkor ebben segít .
Tervezés
Meggyőződtünk az útvonaltervezésről, hogy néha nem elég csak egy irányt választani és haladni — meg kell választanunk az útvonalat, és zsinórban néhány kanyart kell tennünk, hogy elérjük a kívánt célpontot. Ezt az elképzelést általánosíthatjuk: a cél elérése nem csupán a következő lépés, hanem egy egész sorozat, ahol néha előre kell néznünk néhány lépést, hogy megtudjuk, milyen legyen az első. Ezt tervezésnek nevezik. Az útvonaltervezés egyike lehet a tervezés kiegészítéseinek. A Sense / Think / Act ciklusunk szempontjából ez az a rész, ahol a Think része a jövőbeli Act részeit tervezi.
Nézzük meg az asztali játék példáján keresztül, a Magic: The Gathering játékban. Az alábbi kártyák készletével mi lépünk elsőként:
- Mocsár — 1 fekete manát biztosít (földkártya).
- Erdő — 1 zöld manát biztosít (földkártya).
- Fugitive Wizard — 1 kék manát igényel a megidézéshez.
- Elvish Mystic — 1 zöld manát igényel a megidézéshez.
A fennmaradó három kártyát figyelmen kívül hagyjuk, hogy egyszerűbb legyen. A szabályok szerint a játékosnak egy kártyát szabadna játszania egy körben, használhatja a 'tippelés' mechanizmust, hogy nyerjen belőle manát, majd varázslatokat (beleértve a lények megidézését) játszhat az elérhető mana mennyisége alapján. Ebben a helyzetben az emberi játékos tudja, hogy játszania kell az Erdőt, 'tippelnie' kell 1 zöld manát, majd megidézni az Elvish Mystic-et. De hogyan találja ki ezt a játék AI-ja?
Egyszerű tervezés
A triviális megközelítés az, hogy minden lépést egyenként próbálunk ki, amíg nem marad több megfelelő lehetőség. A kártyák nézegetése közben az AI látja, hogy játszhat a Swamp-mal. És játszik is vele. Maradtak-e más lépések ezen a körön? Nem tudja megidézni sem az Elvish Mystic-ot, sem a Fugitive Wizard-ot, mivel az idézésükhöz zöld és kék mana szükséges, míg a Swamp csak fekete manát ad. És már nem tudja játszani a Forest-ot se, mert már lejátszotta a Swamp-ot. Így a játékos AI betartotta a szabályokat, de nem jól tette ezt. Lehetne javítani.
A tervezés fel tudja térképezni azokat a lépéseket, amelyek a játékot a kívánt állapotba hozzák. Ahogyan minden négyzet az útvonalon rendelkezett szomszédokkal (a pályakeresés során), minden lépés a tervben is rendelkezik szomszédokkal vagy utódokkal. Ezeket a lépéseket és a következő lépéseket kereshetjük, amíg el nem érjük a kívánt állapotot.
A mi példánkban a kívánt eredmény az „idézz meg egy lényt, ha lehetséges”. A kör elején csak két lehetséges lépést látunk, amelyek a játék szabályai szerint megengedettek:
1. Játszd le a Swamp-ot (eredmény: Swamp a játékban)
2. Játszd le a Forest-ot (eredmény: Forest a játékban)
Minden elfogadott lépés további lépésekhez vezethet, és másokat zárhat be, ismételten a játék szabályaitól függően. Képzeljük el, hogy lejátszottuk a Swamp-ot — ez eltávolítja a Swamp-ot, mint következő lépést (mivel már lejátszottuk), és eltávolítja a Forest-ot is (mivel a szabályok szerint egy földkártyát csak egyszer lehet lejátszani egy körben). Ezt követően az AI mint következő lépést hozzáadja — 1 fekete mana szerzését, mivel más lehetőség nem áll rendelkezésre. Ha továbbmegy, és választja a Tap the Swamp-ot, akkor 1 egység fekete manát kap, és semmit sem tud kezdeni vele.
1. Játszd le a Swamp-ot (eredmény: Swamp a játékban)
1.1 „Teppej” a Swamp-ot (eredmény: Swamp „tapped”, +1 egység fekete mana)
Nincs elérhető lépés – VÉGE
2. Játszd le a Forest-ot (eredmény: Forest a játékban)
A lépések listája rövidre sikerült, zsákutcába kerültünk. Ismételjük meg a folyamatot a következő lépéshez. Játszunk a Forest-tel, megnyitjuk a „szerezz 1 zöld manát” lépést, ami viszont megnyit egy harmadik lépést — az Elvish Mystic idézését.
1. Játszd le a Swamp-ot (eredmény: Swamp a játékban)
1.1 „Teppej” a Swamp-ot (eredmény: Swamp „tapped”, +1 egység fekete mana)
Nincs elérhető lépés – VÉGE
2. Játszd le a Forest-ot (eredmény: Forest a játékban)
2.1 „Teppej” a Forest-ot (eredmény: Forest „tapped”, +1 egység zöld mana)
2.1.1 Idézd meg az Elvish Mystic-ot (eredmény: Elvish Mystic a játékban, -1 egység zöld mana)
Nincs elérhető lépés – VÉGE
Végül felfedeztük az összes lehetséges lépést, és megtaláltuk a tervet, amely egy lény idézésére irányul.
Ez egy nagyon leegyszerűsített példa. Ajánlott a legjobb lehetséges tervet választani, nem csak bármit, ami megfelel valamilyen kritériumnak. Általában a potenciális terveket a végső eredmény vagy az elvégzésükkel járó összes előny alapján lehet értékelni. Egy földkártya lejátszásáért 1 pontot, egy lény megidézéséért pedig 3 pontot kaphatunk. A Swamp lejátszása 1 pontot ad. Ha Forest → Tap the Forest → megidézzük az Elvish Mystic-ot, az azonnal 4 pontot ér.
Így működik a tervezés a Magic: The Gathering-ben, de ugyanezen logika más helyzetekben is alkalmazható. Például egy bábunak a mozgatásával helyet szabadítunk fel a bástya lépéséhez a sakkban. Vagy elbújunk a fal mögé, hogy biztonságosan lőhessünk az XCOM-ban. Szóval, értettek, miről van szó.
Fejlettebb tervezés
Néha túl sok potenciális lépés van, hogy minden lehetséges lehetőséget figyelembe vegyünk. Visszatérve a Magic: The Gathering példához: tegyük fel, hogy a játékban és a kezedben is több föld- és lénykártya van – a lehetséges lépéskombinációk száma akár tucatnyi is lehet. Van néhány megoldás a problémára.
Az első módszer a backwards chaining (visszafelé láncolás). Ahelyett, hogy minden kombinációt végigpróbálnánk, jobban járunk, ha a végső eredménnyel kezdünk, és megpróbálunk egy közvetlen útvonalat találni. Ahelyett, hogy a fa gyökerétől egy adott levélhez haladnánk, visszafelé megyünk – a levéltől a gyökérhez. Ez a módszer egyszerűbb és gyorsabb.
Ha az ellenfélnek 1 élete van, találhatunk egy tervet, ami "1 vagy több sebzést okoz". Ennek eléréséhez egy sor feltételt kell teljesíteni:
1. A sebzést egy varázslat okozhatja – annak a kezünkben kell lennie.
2. A varázslat kijátszásához mana szükséges.
3. A mana szerzéséhez földkártyát kell kijátszanunk.
4. A földkártya kijátszásához a kezünknél kell lennie.
A másik módszer a best-first search (legjobb első keresés). Ahelyett, hogy minden lehetőséget végignéznénk, a legmegfelelőbbet választjuk. Épp ezért ez a módszer gyakran optimális tervet ad a keresésre fordított felesleges költségek nélkül. Az A* a legjobb első keresés egy formája – a legígéretesebb útvonalakat kutatva a legelső lépéstől, már megtalálhatja a legjobbat anélkül, hogy a többi lehetőséget ellenőrizni kellene.
A Monte Carlo Tree Search, a fascinating and increasingly popular variant of best-first search, selects random successors at each step instead of guessing which plans are better during each subsequent action choice. The algorithm continues until it reaches an endpoint (when the plan results in a win or loss). The outcome is then used to adjust the "weight" evaluation of the previous options. By repeating this process multiple times, the algorithm provides a solid assessment of which next step is the best, even if the situation changes (if the opponent takes action to hinder the player).
When discussing action planning in games, one cannot overlook Goal-Oriented Action Planning, or GOAP. This widely used and discussed method is, at its core, a form of backwards chaining, with a few distinctive details. If the task is to "eliminate the player," and the player is behind cover, the plan may look like this: throw a grenade → retrieve it → throw it.
Typically, there are multiple goals, each with its own priority. If the highest-priority goal cannot be achieved (no combination of actions leads to a plan to "eliminate the player" because the player is not visible), the AI will revert to objectives with lower priority.
Learning and adaptation
We have already mentioned that game AI typically does not use machine learning, as it is not suitable for real-time agent control. However, that does not mean we cannot borrow something from this field. We want an opponent in a shooter from whom we can learn something. For example, to find out about the best positions on the map. Or an opponent in a fighting game who blocks frequently used player combos, encouraging the use of different ones. Therefore, machine learning can be quite beneficial in such situations.
Statistics and probabilities
Mielőtt bonyolult példákra térnénk, nézzük meg, milyen messzire juthatunk, ha néhány egyszerű mérést végzünk, és ezeket a döntéshozatalhoz használjuk. Például a valós idejű stratégia — hogyan határozhatjuk meg, hogy egy játékos képes-e támadást indítani a játék első néhány percében, és milyen védelmet kell ellene készítenünk? Megvizsgálhatjuk a játékos korábbi tapasztalatait, hogy megértsük, milyen lehet a jövőbeli reakciójuk. Kezdjük azzal, hogy nincsenek ilyen alapadataik, de ezeket össze tudjuk gyűjteni — minden alkalommal, amikor az AI emberek ellen játszik, rögzítheti az első támadás időpontját. Pár session után megkaphatjuk az átlagos időt, amelyen belül a játékos a jövőben támadni fog.
Az átlagoknak is van egy problémája: ha a játékos 20 alkalommal «rohamozott», és 20 alkalommal lassan játszott, akkor a szükséges értékek valahol a közepén lesznek, ami számunkra nem jelent hasznos információt. Az egyik megoldás az adatok korlátozása — figyelembe vehetjük az utolsó 20 alkalmat.
Hasonló megközelítést alkalmazunk a bizonyos cselekedetek valószínűségének értékelésében, feltételezve, hogy a játékos korábbi preferenciái a jövőben is hasonlóak lesznek. Ha a játékos ötször támadott minket tűzgömbbel, kétszer villámmal és egyszer közelharcban, nyilvánvaló, hogy a tűzgömböt preferálja. Kiterjesztjük, és látjuk a különböző fegyverek használatának valószínűségét: tűzgömb=62,5%, villám=25% és közelharc=12,5%. A játékunk AI-jának fel kell készülnie a tűz elleni védekezésre.
Egy másik érdekes módszer a Naive Bayes Classifier (naív Bayes-osztályozó) használata, amely nagy mennyiségű bemeneti adatot tanulmányoz, és osztályozza a helyzetet, hogy az AI megfelelő módon reagáljon. A Bayes-osztályozók legismertebbek az e-mail spam szűrőkben való használatukkal. Itt a szavakat elemzik, összehasonlítják azzal, hogy korábban hol fordultak elő ezek a szavak (spamként vagy nem), és következtetéseket vonnak le a bejövő levelekről. Ugyanezt megtehetjük még kevesebb bemeneti adatokkal is. Az AI számára rendelkezésre álló hasznos információk alapján (például milyen ellenséges egységeket állítottak elő, vagy milyen varázslatokat használnak, vagy mely technológiákat kutatták) és a végső eredmény (háború vagy béke, «rohamozni» vagy védekezni stb.) alapján kiválasztjuk az AI megfelelő viselkedését.
Mindezen tanulási mód elegendő, de ajánlott, hogy tesztelésből származó adatok alapján használjuk őket. Az AI megtanul alkalmazkodni a különböző stratégiákhoz, amelyeket a playtesterjeid használtak. Az a mesterséges intelligencia, amely a megjelenés után alkalmazkodik a játékoshoz, túlságosan kiszámítható vagy éppen ellenkezőleg, túlságosan nehéz lehet a győzelemhez.
Érték alapú alkalmazkodás
Figyelembe véve a játék világunk és szabályaink tartalmát, megváltoztathatjuk azokat az értékek halmazát, amelyek befolyásolják a döntéshozatalt, nem csupán a bemeneti adatokat használva. Ezt tesszük:
- Hagyjuk, hogy az AI adatokat gyűjtsön a világ állapotáról és a kulcsfontosságú eseményekről a játék során (ahogyan azt fentebb jeleztük).
- Megváltoztatjuk néhány fontos értéket (value) ezen adatok alapján.
- Megvalósítjuk a döntéseinket, amelyek ezeknek az értékeknek a feldolgozásán vagy kiértékelésén alapulnak.
Például, az ügynöknek van néhány szobája a harmadik személyű lövöldözős térképen. Minden szobának van egy saját értéke, amely meghatározza, mennyire kívánatos a látogatása. Az AI véletlenszerűen választja ki, melyik szobába menjen az érték alapján. Ezután az ügynök emlékezik arra, hogy melyik szobában ölték meg, és csökkenti annak az értékét (az esélyt, hogy visszatér oda). Hasonló a fordított helyzet — ha az ügynök sok ellenfelet megöl, a szoba értéke növekszik.
Markov-modell
Mi lenne, ha a gyűjtött adatokat előrejelzésre használnánk? Ha megjegyzünk minden szobát, ahol a játékost egy bizonyos időszak alatt láttuk, előre tudjuk jelezni, melyik szobába léphet a játékos. A játékos szobákba való mozgásának (értékek) nyomon követésével és rögzítésével képesek vagyunk előrejelezni azokat.
Vegyünk három szobát: piros, zöld és kék. És azokat a megfigyeléseket, amelyeket egy játékütemezés során rögzítettünk:
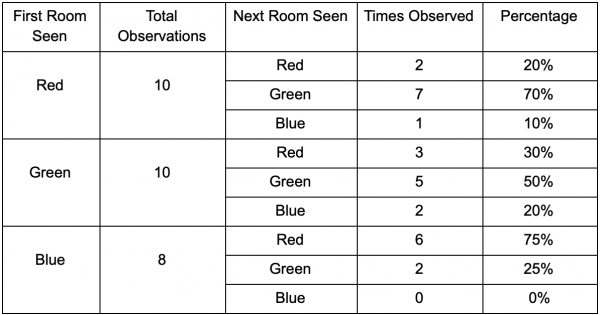
A megfigyelések száma minden szobáról majdnem egyenlő — hogy hol csináljunk egy jó rejtekhelyet, azt még nem tudjuk. A statisztikai adatok gyűjtését a játékosok újraélesztése is nehezíti, akik egyenletesen jelennek meg az egész térképen. De az adatok azonnali szobáról, ahová belépnek a térképre való megjelenés után — már hasznosak.
Látszik, hogy a zöld szoba kedvez a játékosoknak – a pirosból többen átlépnek ide, közülük 50% ott is marad. A kék szoba azonban nem népszerű, alig lépnek be, ha pedig igen, nem sokáig tartózkodnak benne.
De az adatok valami fontosabbat is elárulnak nekünk – amikor a játékos a kék szobában van, akkor a következő szoba, ahol valószínűleg látni fogjuk, a piros lesz, nem a zöld. Annak ellenére, hogy a zöld szoba népszerűbb a pirosnál, a helyzet megváltozik, ha a játékos a kéket használja. A következő állapot (azaz a szoba, ahová a játékos átmegy) a korábbi állapottól függ (azaz attól a szobától, ahol a játékos éppen tartózkodik). A függőségek vizsgálata révén pontosabb előrejelzéseket tudunk végezni, mint ha egyszerűen függetlenül számlálnánk a megfigyeléseket.
A jövőbeli állapot előrejelzése a múltbeli állapot adatai alapján markov-modellnek (Markov model) nevezzük, és az ilyen példák (szobákkal) markov-láncoknak hívják. Mivel a modellek a valószínűségét ábrázolják a következő állapotok közötti változásoknak, vizuálisan FSM-ként jelenítik meg őket, a valószínűség körülbelül a minden átmeneti változóra. Korábban az FSM-t arra használtuk, hogy ábrázoljuk az ügynök viselkedési állapotát, de ez a koncepció bármilyen állapotra vonatkozik, függetlenül attól, hogy kapcsolódik-e az ügynökhöz vagy sem. Ebben az esetben az állapotok képviselik azt a szobát, amelyet az ügynök elfoglal:
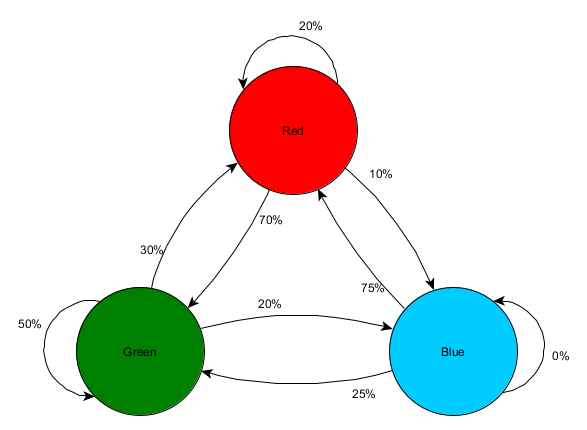
Ez egy egyszerű módja a változások relatív valószínűségének megjelenítésére, amely lehetővé teszi az AI számára, hogy jóslatokat tegyen a következő állapotra. Lehetséges, hogy több lépést is előre jelezzen.
Ha a játékos a zöld szobában van, akkor 50% esély van arra, hogy a következő megfigyelésnél ott marad. De mennyi az esélye, hogy még mindig ott lesz? Nemcsak az esély, hogy a játékos a zöld szobában marad, hanem az is, hogy elment és visszatért. Íme egy új táblázat figyelembe véve az új adatokat:
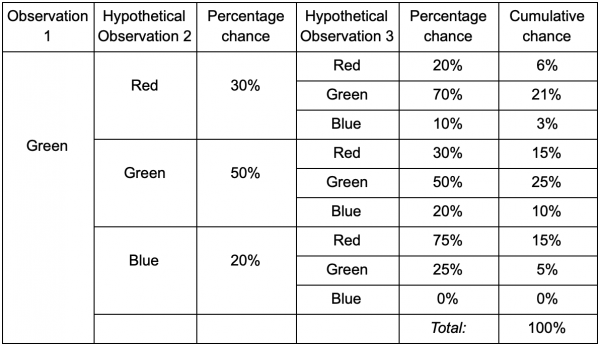
Ebből egyértelmű, hogy a valószínűsége annak, hogy a játékost a zöld szobában lássuk a két megfigyelés után 51% lesz — 21%, hogy a piros szobából érkezik, 5% arra, hogy a játékos a kék szobát is meglátogatja közben, és 25%, hogy a játékos egyáltalán nem hagyja el a zöld szobát.
A táblázat — egyszerű vizuális eszköz — a folyamat csak a valószínűségek szorzását igényli minden lépésnél. Ez azt jelenti, hogy messzire láthatsz a jövőbe, egy feltétellel: feltételezzük, hogy a szoba belépésének esélye teljesen a jelenlegi szobától függ. Ezt hívják Markov-tulajdonságnak (Markov Property) — a jövő állapota csak a jelenlegi állapottól függ. De ez nem száz százalékig pontos. A játékosok más tényezők, például az egészségi állapot vagy a lőszer mennyisége alapján is változtathatják a döntéseiket. Mivel ezeket az értékeket nem rögzítjük, a jóslataink kevésbé lesznek pontosak.
N-Gramok
De mi a helyzet a példával, amely a harci játékban a játékos kombinációs mozdulatait jósolja? Ugyanaz! De egyetlen állapot vagy esemény helyett egész sorozatokat fogunk megvizsgálni, amelyekből a kombinált ütés áll.
Az egyik módszer az, hogy minden bemenetet (például Kick, Punch vagy Block) egy puffertárolóban tárolunk, és az egész puffert egy eseményként rögzítjük. Tehát a játékos többször rákattint a Kick, Kick, Punch kombinációra, hogy aktiválja a SuperDeathFist támadást, az AI rendszere tárolja az összes bemenetet a puffertárolóban, és emlékezik az utolsó háromra, amelyet minden lépésnél használtak.
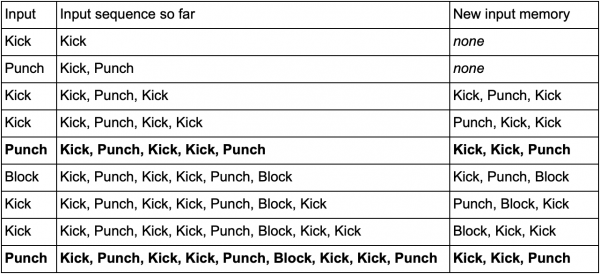
(A játékos SuperDeathFist támadásának aktiválásakor az alábbi sorok vastagon kiemelve jelennek meg.)
Az AI észlelni fogja az összes lehetőséget, amikor a játékos Kick-et választott, majd következik egy másik Kick, és aztán észreveszi, hogy a következő bemenet mindig Punch. Ez lehetővé teszi az ügynök számára, hogy előre jelezze a SuperDeathFist kombinációs mozdulatot, és blokkolja azt, ha lehetséges.
Ezeket az eseménysorozatokat N-gramoknak (N-grams) hívják, ahol N a tárolt elemek száma. A korábbi példában ez egy 3-gram volt (trigram), ami azt jelenti: az első két bejegyzés a harmadik előrejelzésére szolgál. Ennek megfelelően az 5-gramban az első négy bejegyzés az ötödik előrejelzésére szolgál, és így tovább.
A fejlesztőnek gondosan ki kell választania az N-gramok méretét. A kisebb N kevesebb memóriát igényel, de kisebb történetet is tárol. Például a 2-gram (bigram) a Kick, Kick vagy Kick, Punch bejegyzéseket tárolja, de nem tudja rögzíteni a Kick, Kick, Punch kombinációt, így az AI nem reagál a SuperDeathFist kombinációra.
Másrészt a nagyobb számok több memóriát igényelnek, és az AI-nak nehezebb lesz tanulnia, mivel sokkal több lehetséges variáció lesz. Ha három lehetséges bemenetünk volt, Kick, Punch vagy Block, és 10-gramot használtunk, akkor körülbelül 60 ezer különböző variációt kapunk.
A bigram model is a simple Markov chain — each pair of "previous state/current state" is a bigram, and you can predict the second state based on the first. Trigrams and larger N-grams can also be viewed as Markov chains, where all elements (except the last in the N-gram) together form the first state, while the last element is the second. An example with fighting shows the chance of transitioning from the state Kick and Kick to the state Kick and Punch. By treating several historical input records as a single unit, we essentially transform the input sequence into a part of a whole state. This gives us the Markov property, allowing the use of Markov chains to predict the next input and guess which combo move will come next.
Zárás
We discussed the most common tools and approaches in artificial intelligence development. We also covered situations in which to apply them and where they are particularly useful.
This should be enough to understand the basics of game AI. But, of course, this is far from all methods. Less popular, but no less effective include:
- optimization algorithms, including hill climbing, gradient descent, and genetic algorithms
- competitive search/planning algorithms (minimax and alpha-beta pruning)
- classification methods (perceptrons, neural networks, and support vector machines)
- systems for processing agents' perception and memory
- architectural approaches to AI (hybrid systems, subsets of architectures, and other ways of layering AI systems)
- animation tools (motion planning and coordination)
- performance factors (level of detail, anytime algorithms, and time slicing)
Online resources on the topic:
1. GameDev.net has , valamint .
2. contains many presentations and articles on a wide range of topics related to game AI development.
3. includes topics from the GDC AI summit, many of which are available for free.
4. Useful materials can also be found on the site .
5. Tommy Thompson, an AI researcher and game developer, makes videos on the YouTube channel explaining and exploring AI in commercial games.
Books on the topic:
1. A Game AI Pro könyvsorozat rövid cikkek gyűjteménye, amelyek magyarázzák, hogyan valósítsuk meg a konkrét funkciókat, vagy hogyan oldjunk meg konkrét problémákat.
2. Az AI Game Programming Wisdom sorozat a Game AI Pro sorozat elődje. Régebbi módszereket tartalmaz, de szinte mindegyik a mai napig aktuális.
3. — ez az egyik alapvető szöveg mindazok számára, akik szeretnék megérteni a mesterséges intelligencia általános területét. Ez a könyv nem a játékfejlesztésről szól — az AI alapjait tanítja.
Forrás: habr.com
