

Nemrégiben megjelent , amely jól mutatja az utóbbi évek gépi tanulásának tendenciáit. Röviden: az utóbbi két évben drámaian csökkent a gépi tanulás területén indult startupok száma.
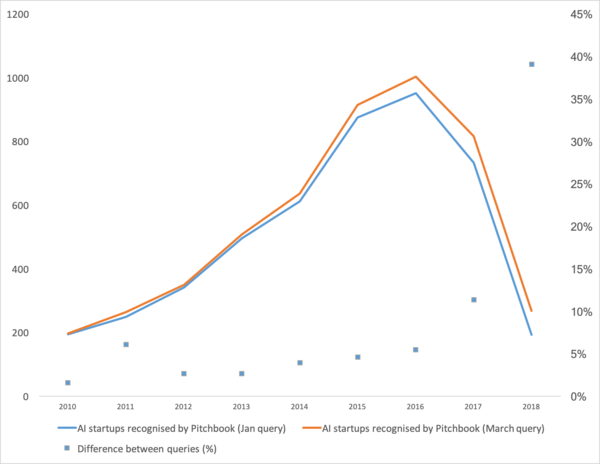
Nos. Nézzük meg, hogy "pattant-e el a buborék", "hogyan tovább" és beszélgessünk arról, hogy honnan jött ez a helyzet egyáltalán.
Kezdjük azzal, hogy mi volt ennek a görbének a fő hajtóereje. Honnan indult ez? Valószínűleg mindenki emlékszik a a gépi tanulásban 2012-ben az ImageNet versenyen. Végül is ez az első globális esemény! De a valóságban ez nem így van. A görbe növekedése ráadásul kicsit korábban kezdődik. Én ezt több szakaszra bontanám.
- 2008-ban megjelent a "big data" kifejezés. A valódi termékek 2010-től kezdődően valósultak meg. A big data közvetlen kapcsolatban áll a gépi tanulással. Nagy adatok nélkül nem lehetséges az addig létező algoritmusok stabil működése. És ez nem a neurális hálózatok ideje. 2012 előtt a neurális hálózatok a marginális kisebbség privilégiuma voltak. Ellenben ekkor kezdtek el működni teljesen más algoritmusok, amelyek már évek, sőt évtizedek óta léteztek: (1963, 1993), (1995), (2003),… Az akkori startupok elsősorban a strukturált adatok automatikus feldolgozásával foglalkoztak: pénztárgépek, felhasználók, reklám, sok más.
Ezen első hullám terméke a különféle keretrendszerek, mint például az XGBoost, CatBoost, LightGBM, stb.
- 2011-2012-ben számos versenyt nyertek a képfeldolgozás terén. A tényleges alkalmazásuk kicsit elhúzódott. Azt mondanám, hogy a tömegesen tudatos startupok és megoldások 2014-től kezdtek megjelenni. Két évre volt szükség, hogy feldolgozzák, hogy a neurális hálózatok valóban működnek, kényelmes keretrendszereket készítsenek, amelyeket ésszerű időn belül telepíteni és futtatni lehetett, és kifejlesszenek módszereket, amelyek stabilizálták és felgyorsították a konvergálási időt.
A konvolúciós hálózatok lehetővé tették a gépi látási feladatok megoldását: képek és tárgyak osztályozása, tárgyak és emberek észlelése, objektumok és emberek felismerése, képek javítása, stb.
- 2015-2017. A rekurrens hálózatokkal, vagy azok analógjaival (LSTM, GRU, TransformerNet stb.) kapcsolatos algoritmusok és projektek robbanása. Megjelentek a jól működő „beszéd-tesztre” algoritmusok és a gépi fordító rendszerek. Részben a konvolúciós hálózatok alap jellemzők kiemeléséhez alapozva, részben pedig azon, hogy sikerült igazi nagy és jó adatbázisokat összegyűjteni.
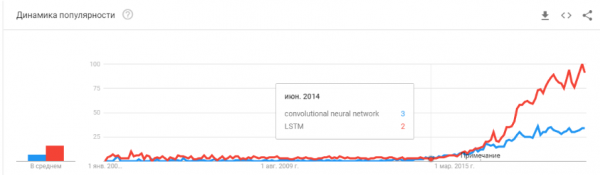
„Pukka kipukkadt? A hype túlmelegedett? Meghaltak, mint a blokklánc?”
Igen! Holnap a telefonodon leáll a Siri működése, és holnapután a Tesla nem fogja megkülönböztetni a kanyart a kenguruktól.
A neurális hálózatok már működnek. Tízesével vannak eszközökben. Valóban lehetővé teszik a pénzkeresést, megváltoztatják a piacot és a körülöttünk lévő világot. A hype kissé másképp néz ki:
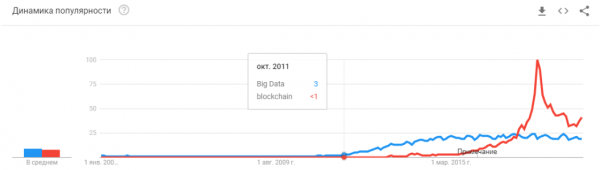
Egyszerűen fogalmazva, a neurális hálózatok már nem számítanak új dolognak. Igen, sok embernek túlzott elvárásai vannak. De nagy számú cég megtanulta alkalmazni a neurális hálózatokat, és termékeket készíteni az alapjukra. A neurális hálózatok új funkciókat kínálnak, lehetővé teszik a munkahelyek csökkentését, és csökkentik a szolgáltatások árát:
- A gyártó cégek algoritmusokat integrálnak a gyártási hibák elemzésére a szalagon.
- Az állattenyésztő gazdaságok rendszereket vásárolnak a tehenek ellenőrzésére.
- Automatikus kombájnok.
- Automatizált Call-centerek.
- Szűrők a SnapChatben. (legalább valami hasznos!)
De a legfőbb és nem a legnyilvánvalóbb: „Nincsenek új ötletek, vagy nem hoznak azonnali tőkét.” A neurális hálózatok tucatnyi problémát megoldottak. És még sokat fognak megoldani. Minden nyilvánvaló ötlet, ami felmerült — számtalan startupot indított. De mindaz, ami a felszínen volt — már összegyűjtötték. Az utolsó két évben nem találkoztam egyetlen új ötlettel a neurális hálózatok alkalmazására. Egy új megközelítéssel sem (na jó, ott van pár zűr a GAN-okkal).
És minden következő startup egyre nehezebb. Már nem elegendő két srác, akik nyílt adatokon tanítják a neurális hálózatot. Programozókra, szerverre, jelölőcsapatra, bonyolult támogatásra stb. van szükség.
Ennek eredményeként a startupok száma csökken. De a gyártási kapacitás nő. Autólicencek felismerésére van szüksége? A piacon számos szakember van releváns tapasztalattal. Fel lehet venni valakit, és pár hónap alatt elkészíti a rendszerét. Vagy meg lehet venni a kész megoldást. De új startupot indítani?.. Őrültség!
Létre kell hozni egy látogatókat követő rendszert - minek fizetni rengeteg licencért, amikor 3-4 hónap alatt elkészítheti a saját üzleti igényeire szabva.
Jelenleg a neurális hálózatok ugyanazon az úton haladnak, amelyet már számos más technológia bejárt.
Emlékszik, hogyan változott 1995 óta a "webfejlesztő" fogalma? Amíg a piac nem telítődött szakemberekkel, nagyon kevés a profi. De biztos vagyok benne, hogy 5-10 éven belül nem lesz különbség a Java programozó és a neurális hálózatok fejlesztője között. Mindkét területen elegendő szakember lesz a piacon.
Csak olyan feladatok lesznek, amelyekre a neurális hálózatok megoldást nyújtanak. Ha felmerül egy feladat - szakembert kell felvenni.
„És mi következik? Hol van a megígért mesterséges intelligencia?”
De itt van egy kis, de érdekes homályos rész :)
A technológiák összessége, ami ma rendelkezésünkre áll, úgy tűnik, hogy nem vezet el minket a mesterséges intelligenciához. Az ötletek, azok újdonsága - nagyrészt kimerültek. Beszéljünk arról, mi tartja fenn a jelenlegi fejlődési szintet.
Korlátozások
Kezdjük az önvezető autókkal. Úgy tűnik, világos, hogy teljesen autonóm autókat készíteni a mai technológiákkal - lehetséges. De hány év múlva fog ez megtörténni - nem világos. A Tesla szerint ez pár éven belül megtörténik -
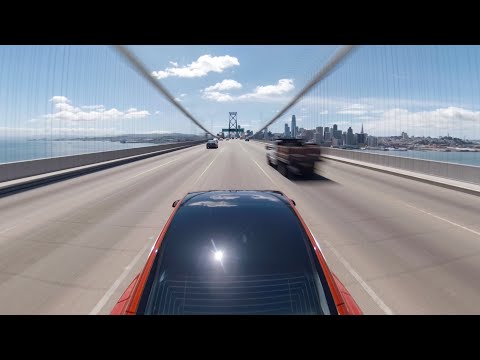
Sok más , akik ezt 5-10 évre becsülik.
Valószínűleg, véleményem szerint, 15 év múlva a városok infrastruktúrája meg fog változni, úgy, hogy az önvezető autók megjelenése elkerülhetetlenné válik, a város fejlődésének folytatásává. De ezt nem lehet intelligenciának nevezni. A mai Tesla egy nagyon bonyolult adatfilterező, kereső és újratanító rendszer. Ezek szabályok-szabályok-szabályok, adatok gyűjtése és szűrők felettük (itt erről kicsit részletesebben írtam, vagy nézd meg a megjegyzésnél).
Az első probléma
És itt látjuk az első alapvető problémát. Nagy adatok. Ez az, ami megalapozta a jelenlegi neurális hálózatok és a gépi tanulás hullámát. Manapság, hogy valami bonyolultat és automatizáltat készítsünk, rengeteg adat szükséges. Nem csak sok, hanem nagyon-nagyon sok. Automatizált algoritmusokra van szükség ezen adatok gyűjtésére, címkézésére, felhasználására. Ha azt akarjuk, hogy a gép lássa a teherautókat a napfényben, először elegendő számú járművet kell összegyűjtenünk. Ha azt akarjuk, hogy a gép ne zavarodjon meg a kerékpárral a csomagtartón, több mint ezer mintára van szükségünk.
Ráadásul egy példa nem elég. Száz? Ezrek?
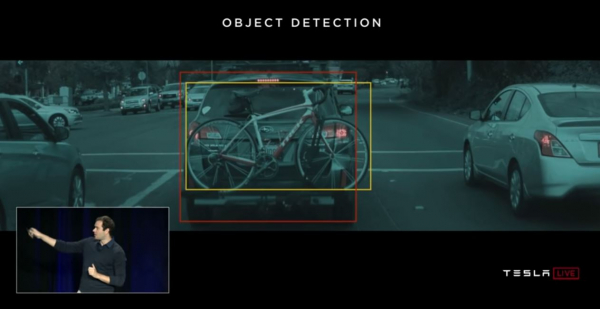
A második probléma
A második probléma — a vizualizáció, hogy mit értett meg a neurális hálózatunk. Ez egy nagyon összetett feladat. Eddig még kevesen értik, hogyan lehet ezt vizualizálni. Ezek a cikkek meglehetősen újak, csupán néhány példa, még ha távoli is:
a textúrákra való túlzott fókuszálás. Jól mutatja, hogy a neurális hálózat mivel hajlamos foglalkozni és mit érzékel információként.
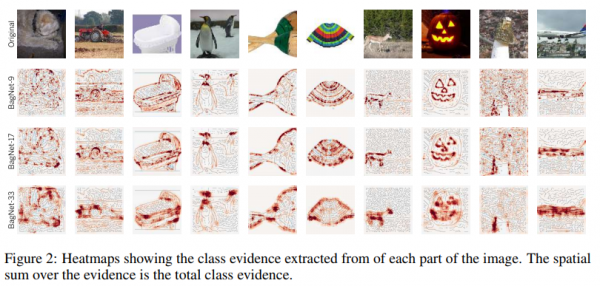
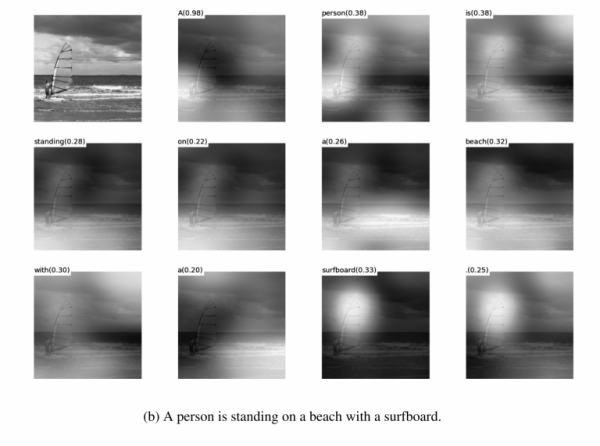
figyelem a . Valójában a figyelem gyakran használható arra, hogy megmutassa, mi váltotta ki ezt a reakciót a hálózatból. Találtam ilyen megoldásokat mind a hibakereséshez, mind a termékmegoldásokhoz. Erről nagyon sok írás született. De minél bonyolultabbak az adatok, annál nehezebb megérteni, hogyan lehet tartós vizualizációt elérni.
Nos, és igen, a régi jó csomag, hogy "nézd meg, mi van a háló belsejében a ". Ezek a képek 3-4 évvel ezelőtt népszerűek voltak, de mindenki gyorsan rájött, hogy a képek szépek, de sok értelmük nincs.
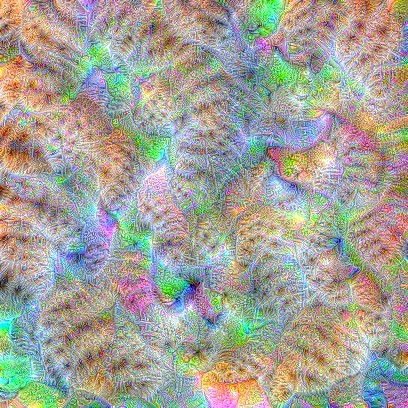
Nem említettem meg tucatnyi más trükköt, módszert, hack-et, kutatást arról, hogyan lehet a háló belsejét ábrázolni. Működnek ezek az eszközök? Segítenek gyorsan megérteni, mi a probléma és debugolni a hálózatot?.. Hogyan hozhatók ki az utolsó százalékok? Nos, nagyjából így:
Bármelyik Kaggle versenyt megtekintheted. És az, hogy az emberek mit csinálnak a végső megoldásokkal. Összegyűjtöttünk 100-500-800 millió modellt, és működött!
Természetesen túlozok. De ezek a megközelítések nem adnak gyors és közvetlen válaszokat.
Megfelelő tapasztalattal, különböző lehetőségek kipróbálásával véleményt lehet alkotni arról, hogy miért döntött a rendszer így. De a rendszer viselkedésének megváltoztatása nehéz lesz. Beállítani egy ideiglenes megoldást, átállítani a küszöböt, hozzáadni egy adathalmazt, vagy más háttér-hálózatot használni.
A harmadik probléma
A harmadik alapvető probléma — a hálózatok nem logikát, hanem statisztikát tanulnak. Statisztikai szempontból ez :
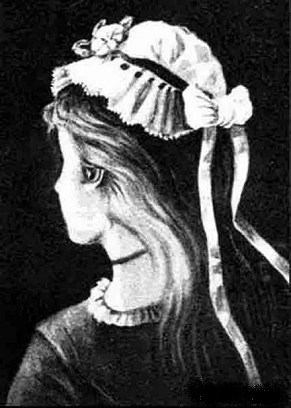
Logikailag — nem igazán hasonlít. A neurális hálózatok nem tanulnak meg nehéz dolgokat, hacsak nem kényszerítik őket. Mindig a lehető legegyszerűbb jellemzőket tanulják. Vannak szemek, orr, fej? Akkor ez egy arc! Vagy hozz példát, ahol a szemek nem jelentik az arcot. És újra — millió példa.
Van elég hely lentről
Azt mondanám, hogy ezek a három globális probléma ma korlátozza a neurális hálózatok és a gépi tanulás fejlődését. Ahol pedig ezek a problémák nem korlátozták — már aktívan használják őket.
Ez a vég? Megálltak a neurális hálózatok?
Nem tudható. De természetesen mindenki reméli, hogy nem.
Sok megközelítés és irány van a fent említett alapvető problémák megoldására. De eddig egyik megközelítés sem tudott valami alapvetően újat létrehozni, vagy megoldani valamit, ami eddig nem volt megoldva. Jelenleg minden alapvető projekt stabil megközelítések (Tesla) alapján készült, vagy intézmények vagy vállalatok (Google Brain, OpenAI) tesztprojektjei maradtak.
Ha durván beszélünk, az alapvető irány a bemeneti adatok valamilyen magas szintű reprezentációjának létrehozása. Egyfajta „emlékezet”. A legegyszerűbb példa az emlékezetre különféle „Embedding” — képareprezentációk. Például minden arcfelismerő rendszer. A hálózat megtanulja létrehozni az arcból egy stabil reprezentációt, amely nem függ a forgástól, világítástól vagy felbontástól. Lényegében a hálózat minimalizálja a „különböző arcok - messze” és „azonos - közel” metrikát.
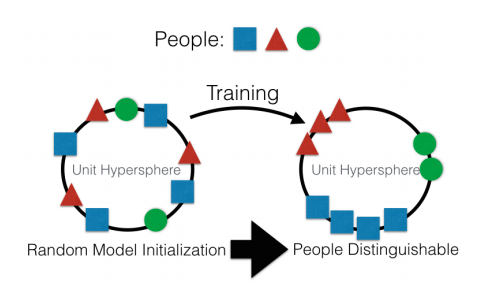
Ehhez a tanuláshoz tíz és százezernyi példa szükséges. Cserébe az eredmény tartalmaz némi kezdetét az „One-shot Learning”-nek. Most már nincs szükségünk száz arcre, hogy emlékezzünk egy személyre. Csak egy arc, és kész — mi !
Csak itt van egy kis probléma... A hálózat csak elég egyszerű objektumokat tud megtanulni. Ha megpróbáljuk megkülönböztetni nem az arcokat, hanem például az „embereket a ruháik alapján” (feladat ) — a minőség sokkal rosszabbra fordul. És a hálózat már nem tudja megtanulni a nyilvánvaló nézőpontváltásokat.
És az is elég kellemetlen, hogy milliók példányain tanulni — nem éppen szórakoztató.
Vannak munkák a választék jelentős csökkentésére. Például hirtelen eszembe jut egy a korai munkák közül OneShot Learning :
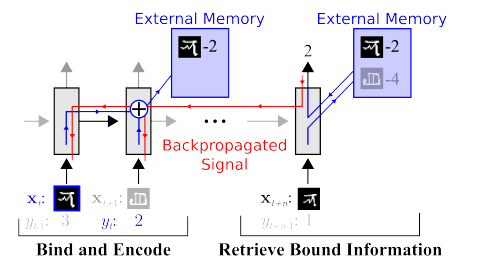
Sok ilyen munka létezik, például vagy vagy .
Az egyik hátrány, hogy a tanulás általában jól működik egyszerű, 'MNIST'-féle példákon. De a bonyolultabb feladatokhoz nagyobb adatbázisra, objektummodellekre vagy valami varázslatra van szükség.
Egyébként a One-Shot tanulás egy nagyon érdekes téma. Sok ötletet talál az ember. De nagyrészt azok a két probléma, amiket említettem (előzetes tanulás hatalmas adathalmazon / instabilitás bonyolult adatokon) nagyon megnehezítik a tanulást.
Másrészről az Embedding témához a GAN-ok — generatív ellentétes hálózatok is kapcsolódnak. Biztosan olvastál már sok cikket erről a témáról a Habr-on. (, ,)
A GAN sajátossága egyfajta belső állapotteret képez (valójában ugyanaz az Embedding), amely lehetővé teszi egy kép létrehozását. Ezek lehetnek , lehetnek .
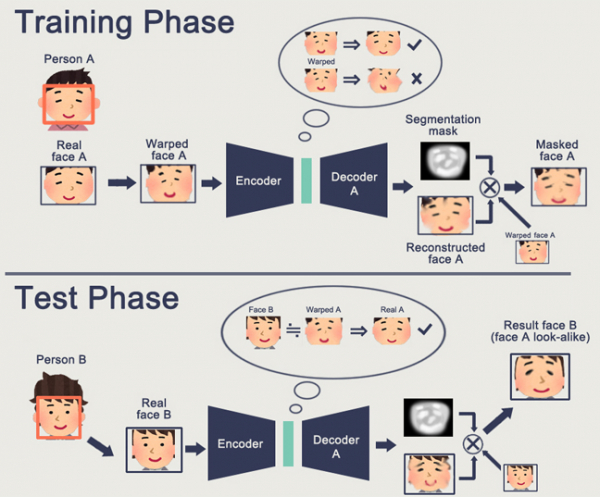
A GAN problémája — minél bonyolultabb a generált objektum, annál nehezebb leírni azt a "generáló-diszkriminátor" logikájában. Ennek eredményeként a GAN valódi alkalmazásai közül, amelyek ismertek, csak a DeepFake van, amely ismét manipulálja az arcok reprezentációját (amelyhez hatalmas adatbázis áll rendelkezésre).
Más hasznos alkalmazásokat nagyon kevés helyen láttam. Általában valamilyen szórakoztató trükkökről van szó képek kiegészítésével.
És megint. Senki sem érti, hogyan fogja ez lehetővé tenni, hogy előre lépjünk a fényes jövőbe. A logika/terület reprezentációja a neurális hálózatban — ez jó. De óriási számú példa szükséges, nem értjük, hogyan képzeli el mindezt a neurális háló, és azt sem, hogy hogyan kényszerítsük a neurális hálót arra, hogy megjegyezzen valami valósan bonyolult reprezentációt.
A megerősítéses tanulás teljesen más megközelítést jelent. Biztosan emlékszel, hogyan győzte le a Google mindenkit a Go játékban. A legutóbbi győzelmek a Starcraftban és a Dotában. De itt minden korántsem olyan rózsás és ígéretes. A legjobban a RL-ről és a nehézségeiről azt meséli .
Röviden összefoglalva, amit a szerző írt:
- A modellek dobozból nem alkalmasak/általában rosszul működnek.
- A gyakorlati feladatokat más módon egyszerűbb megoldani. A Boston Dynamics nem használ RL-t a bonyolultsága/megfontolatlansága/komplex számítással kapcsolatos nehézsége miatt.
- Ahhoz, hogy az RL működjön — bonyolult függvény szükséges. Gyakran nehéz létrehozni/megírni.
- Bonyolult modelleket tanítani. Rengeteg időt kell tölteni annak érdekében, hogy a modelleket megmozdítsuk és eltüntessük a helyi optimumokat.
- Ennek következményeként — nehéz a modellt megismételni, a modell instabilitása a legkisebb változásokra is.
- Gyakran túllép az olyan irreleváns mintákra, mint például a véletlenszám-generátor.
A kulcspont — a RL egyelőre nem működik a gyakorlatban. A Google-nak van néhány kísérlete ( , ). De nem láttam egyetlen termékrendszert sem.
Memória. A fent említett problémák hátránya az, hogy nem strukturáltak. Az egyik megközelítés, amellyel próbálják ezt kezelni, hogy hozzáférést biztosítanak a neurális hálónak egy külön memóriához. Így képes lenne rögzíteni és újraírni az eredményeit. Ekkor a neurális hálózat a memória aktuális állapotától függetlenedhet. Ez nagyon hasonlít a klasszikus processzorokra és számítógépekre.
A legismertebb és legnépszerűbb — a DeepMind-től:
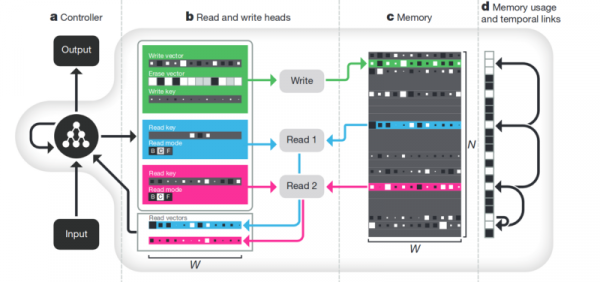
Úgy tűnik, hogy itt a kulcs az intelligencia megértéséhez? De valószínűleg nem. A rendszernek még mindig hatalmas mennyiségű adatra van szüksége a tanuláshoz. Főleg strukturált táblázatos adatokkal dolgozik. Eközben amikor a Facebook egy hasonló problémát, ők azt a megoldást választották, hogy "a fenébe a memóriával, csináljunk egy bonyolultabb neurális hálót, és több példát, és az majd megtanulja önállóan".
Disz-entanglement. A másik módszer a jelentős memória létrehozására az, hogy ugyanazokat az embeddingeket használják, de a tanulásnál további kritériumokat vezetnek be, amelyek lehetővé tennék a "jelentések" kiemelését. Például szeretnénk megtanítani a neurális hálónak megkülönböztetni az emberek viselkedését egy boltban. Ha a megszokott módon haladtunk volna, akkor tucatnyi hálót kellett volna létrehoznunk. Az egyik az embert keresi, a másik megállapítja, mit csinál, a harmadik az életkorát, a negyedik — a nemét. Egy külön logika figyeli a bolt azon részét, ahol ő van/oktatja ezt. A harmadik megállapítja az útvonalát, stb.
Vagy ha határtalan mennyiségű adat lenne, akkor egyetlen hálót lehetne tanítani a különféle kimenetekre (nyilvánvaló, hogy egy ilyen adathalmazt nem lehet összegyűjteni).
A disz-entanglement megközelítés azt mondja nekünk — miért ne tanítsuk a hálót úgy, hogy önállóan tudja megkülönböztetni a fogalmakat. Hogy a videó alapján egy embeddinget képezne, ahol egy terület a cselekvést, egy a padlón időben elfoglalt helyzetet, egy a növekedést, egy pedig a nemet határozná meg. A tanulás során szinte nem szeretnénk útmutatást adni a hálónak olyan kulcsfontosságú fogalmak tekintetében, hanem hogy önállóan kiemelje és csoportosítsa a területeket. Ilyen cikkekből elég kevés van (néhány közülük , , ) és összességében elég elméleti jellegűek.
De ez az irányvonal, legalábbis elméletileg, meg kellene oldja a felsorolt problémákat.
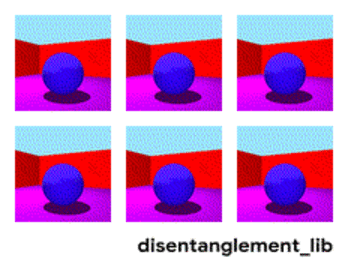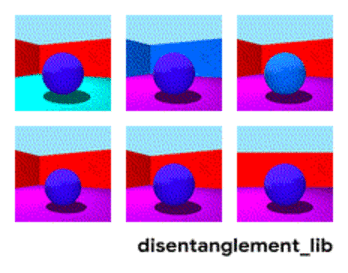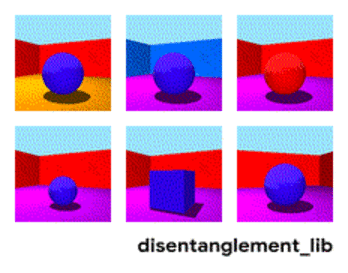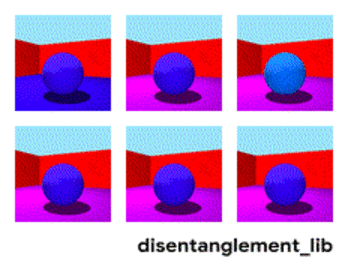
A képet a paraméterek szerint bontjuk le: "fal színe/föld színe/objektum formája/objektum színe/stb."
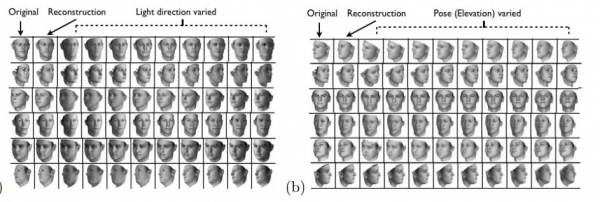
Az arcot a következő paraméterekre bontjuk: "méret, szemöldök, orientáció, bőrszín, stb."
Egyéb
Sok más, nem annyira globális irányvonal is létezik, amelyek lehetővé teszik az adatok csökkentését, heterogén adatokkal való munkát, stb.
Figyelem. Valószínűleg nincs értelme ezt külön módszerként kiemelni. Csak egy megközelítés, amely erősíti a többit. Sok cikk foglalkozik vele (,,). A figyelem lényege az, hogy a hálózat reagáljon a jelentős objektumokra a tanulás során. Gyakran valami külső célzott iránymutatással, vagy egy kis külső hálózattal.
3D-szimuláció. Ha jó 3D motor készült, akkor azt gyakran lehet használni a tanító adatok 90%-ának lefedésére (láttam már példát, amikor majdnem 99%-át lefedte egy jó motor). Sok ötlet és hack létezik, hogyan lehet a 3D motoron betanított hálózatot reális adatokon működőképessé tenni (finomhangolás, stílus transzfer, stb.). De gyakran egy jó motor elkészítése — több nagyságrenddel nehezebb, mint az adatok összegyűjtése. Példák, amikor motorokat csináltak:
Robotok tanítása (, )
Képzés boltban (de a két projektünkben, amelyet készítettünk — nyugodtan megúsztuk ezt).
Tanulás a Teslánál (ismét a fenti videó).
Következtetések
Az egész cikk valamilyen értelemben következtetések összessége. Valószínűleg az alapvető üzenet, amelyet szerettem volna közvetíteni — "a könnyű megoldások véget értek, a neurális hálózatok már nem kínálnak egyszerű megoldásokat." Most már keményen kell dolgozni, összetett megoldásokat építve. Vagy keményen dolgozni, bonyolult tudományos kutatásokat végezve.
Egyébként a téma vitatható. Lehet, hogy az olvasóknak vannak érdekesebb példáik?
Forrás: habr.com
