

A cikk két részből áll:
- Rövid leírás néhány architektúráról, amely a képek objektumfelismerésére és a képek szegmentálására vonatkozik, a számomra legérthetőbb hivatkozásokkal. Megpróbáltam videómagyarázatokat választani, lehetőleg orosz nyelven.
- A második rész azt próbálja megérteni, hogy merre fejlődnek a neurális hálózatok architektúrái és a rájuk épülő technológiák.
1. ábra – A neurális hálózatok architektúráinak megértése nem egyszerű
Minden azzal kezdődött, hogy két bemutatóalkalmazást készítettem képosztályozásra és objektumfelismerésre Android telefonon:
- , amikor az adatok a szerveren kerülnek feldolgozásra és átkerülnek a telefonra. Háromféle medve képosztályozása: barna, fekete és plüss.
- , amikor az adatok magán a telefonon kerülnek feldolgozásra. Háromféle objektumfelismerés: mogyoró, füge és datolya.
Különbség van a képosztályozási feladatok, a képeken történő objektumfelismerés és . Ezért felmerült az igény, hogy megtudjam, mely neurális hálózati architektúrák ismerik fel az objektumokat a képeken és melyek tudják szegmentálni. A következő architektúrák példáit találtam, a számomra legérthetőbb hivatkozásokkal:
- R-CNN alapú architektúrák sorozata (Regions with Convolution Neural Networks features): R-CNN, Fast R-CNN, , . A képeken történő objektumfelismeréshez a Region Proposal Network (RPN) mechanizmus segítségével korlátozott régiókat (bounding boxes) határoznak meg. Kezdetben lassabb Selective Search mechanizmust alkalmaztak az RPN helyett. Azután a kiemelt korlátozott régiókat egy hagyományos neurális hálózat bemenetére küldik osztályozásra. Az R-CNN architektúrában egyértelmű "for" ciklusok vannak az egyes korlátozott régiók átvizsgálására, összesen akár 2000 iteráció az AlexNet belső hálózaton. Az egyértelmű "for" ciklusok miatt csökken a képek feldolgozási sebessége. Minden új architektúra verzióval csökken az egyértelmű ciklusok, a belső neurális hálózaton való átmenetek száma, és sok egyéb változást végeznek a sebesség növelésére, valamint a tárgyak észlelésének feladatát a Mask R-CNN-ben történő objektum-szegmentációra történő átkonvertálásra.
- (You Only Look OA YOLO (You Only Look Once) – az első neurális hálózat, amely valós időben képes azonosítani a tárgyakat mobil eszközökön. Különleges jellemzője: a tárgyak egyetlen átfutással történő megkülönböztetése (elég egyszer ránézni). Ezért a YOLO architektúrában nincsenek kifejezett „for” ciklusok, ami gyors működést eredményez. Például, hasonló a NumPy-hoz, ahol a mátrix műveletek során sincsenek kifejezett „for” ciklusok, ezeket a NumPy alacsonyabb szintű architektúrájában a C programozási nyelv valósítja meg. A YOLO előre meghatározott ablakokból álló rácsot használ. Annak érdekében, hogy ugyanazt a tárgyat ne azonosítsák többször, átfedési együtthatót (IoU) alkalmaznak. Imetsződés ) között. Ezután használ egy operátort a jogosultságok hozzáadására vagy eltávolítására az aktuális módból, vagy abszolút jogokat állít be.unió. UEz az architektúra széles skálán működik és magas : a modell fényképeken tanulható, de jól működik rajzolt képeken is.
- (SEgységes SMultiBox Megelőző Ddetektor) – a YOLO architektúrájának legjobban sikerült „hackjeit” alkalmazzák, például a nem maximális visszaszorítást, és újakat adnak hozzá, hogy a neurális hálózat gyorsabban és pontosabban működjön. Különleges jellemzője: a tárgyak megkülönböztetése egy átfutással az előre meghatározott ablakok (default box) segítségével képkocka piramisokon. A képet piramisokban kódolják konvolúciós tenzorokkal a sorozatos konvolúciós és max-pooling műveletek során (max-pooling műveletnél a térbeli dimenzió csökken). Így egyszerre határozhatók meg a nagy és a kis tárgyak.
- MobileSSD (MobileNetV2 + SSD) – két neurális hálózat architektúrájának kombinációja. Az első hálózat gyorsan működik és növeli az azonosítás pontosságát. A MobileNetV2 a VGG-16-ot helyettesíti, amelyet eredetileg használtak a . A második hálózat az SSD határozza meg a tárgyak helyét a képen.
- – nagyon kicsi, de pontos neurális hálózat. Önmagában nem oldja meg a tárgyak azonosítását. De különböző architektúrák kombinálásával alkalmazható. Használható mobil eszközökben is. Különleges jellemzője, hogy először az adatokat négy 1×1-es konvolúciós szűrőre tömörítik, majd négy 1×1-es és négy 3×3-as konvolúciós szűrőre bővítik. Ezt a tömörítési-bővítési iterációt „Fire Module”-nak nevezik.
- (A mély konvolúciós hálózatokkal végzett szemantikus képszegmentálás) – objektumok szegmentálása a képen. Az architektúra jellegzetessége a ritkított (dilated convolution) convolúció, amely megőrzi a térbeli felbontást. Ezt követi a szegmentálási eredmények utómunkálata egy grafikus valószínűségi modell (conditional random field) alkalmazásával, amely eltávolítja a kis zajokat a szegmentációból, és javítja a szegmentált kép minőségét. A „grafikus valószínűségi modell” mögött egy szokásos Gauss-szűrő rejtőzik, amelyet öt pont körüli közelítéssel alakítottak ki.
- Próbáltam megérteni a felépítését (Single-Shot Refinement Neurális Hálózat az Objektum Detekcióhoz), de alig értettem meg valamit.
- Azt is megnéztem, hogyan működik a figyelmi technológia (attention): , , . Az architektúra „figyelem” sajátossága a figyelem kiemelt régióinak automatikus meghatározása a képen (RoI, Rérdeklődési ) között. Ezután használ egy operátort a jogosultságok hozzáadására vagy eltávolítására az aktuális módból, vagy abszolút jogokat állít be.f Iegiók) egy Attention Unit nevű neurális háló segítségével. A kiemelt figyelmi régiók hasonlítanak a korlátozott régiókra (bounding boxes), de ellentétben azokkal nem rögzítettek a képen, és elmosódott határvonalakkal rendelkezhetnek. Ezután a kiemelt figyelmi régiókból jellemzők (fichák) kerülnek kiemelésre, amelyeket visszaeső neurális hálózatokhoz „táplálnak”, olyan architektúrákkal, mint . A visszaeső neurális hálózatok képesek elemezni a jellemzők közötti kapcsolatokat a sorozatban. A visszaeső neurális hálózatokat kezdetben más nyelvekre történő szövegek fordítására alkalmazták, most pedig a és .
A fenti architektúrák tanulmányozása során rájöttem, hogy semmit nem értek.. Nem arról van szó, hogy a neurális hálómnak problémái vannak a figyelem mechanizmusával. Az összes architektúra létrehozása egy óriási hackathonra hasonlít, ahol a szerzők a hackekben versenyeznek. A hack (hack) egy nehéz programozási probléma gyors megoldása. Tehát ezek között az architektúrák között nincs látható és érthető logikai kapcsolat. Ami összeköti őket, az a legjobb hackek gyűjteménye, amelyeket egymástól kölcsönöznek, plusz az összes felhasználó számára közös (visszaterjedés, backpropagation). Nincs ! Nem világos, hogy mit kell változtatni és hogyan optimalizálni a meglévő eredményeket.
Azoknak a hackeknek a logikai összefüggésének hiánya miatt rendkívül nehéz őket megjegyezni és a gyakorlatban alkalmazni. Ezek fragmentált ismeretek. Legjobb esetben néhány érdekes és váratlan pillanat megmarad, de a megértett és meg nem értett többsége már néhány nap után eltűnik az emlékezetből. Jó lenne, ha legalább az architektúra neve eszébe jutna egy hét elteltével. Pedig a cikkek olvasására és a bemutató videók megtekintésére órákat, sőt napokat költöttek!
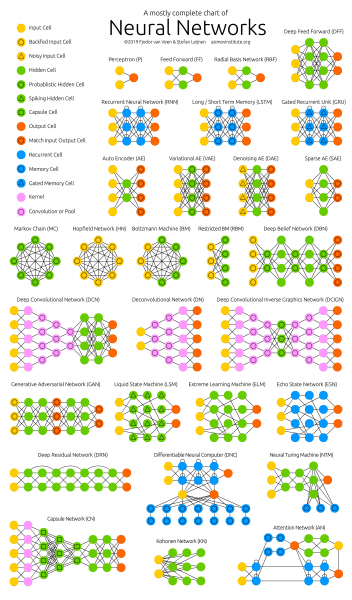
2. ábra –
Személyes véleményem szerint a tudományos cikkek szerzői mindent megtesznek annak érdekében, hogy még ezek a fragmentált ismeretek is érthetetlenek maradjanak az olvasó számára. De a gerund formák tíz soros mondatokban, amelyek képletei a „pókhálóból” származnak – ez egy másik cikk témája (probléma ).
Ezért vált szükségessé a neurális hálózatokkal kapcsolatos információk rendszerezése és ezáltal a megértés és emlékezés minőségének növelése. Ezért az egyes mesterséges neurális hálózatok technológiáinak és architektúráinak elemzésének fő témájává vált a következő kérdés: tudni, hová halad ez az egész, nem pedig egy konkrét neurális hálózat felépítése külön-külön.
Hová halad ez az egész. Főbb eredmények:
- Az elmúlt két évben a gépi tanulás területén a startupok száma . Lehetséges oka: „a neurális hálózatok már nem újdonság.”
- Mindenki létrehozhat egy működő neurális hálózatot egy egyszerű feladat megoldására. Ehhez egy készen álló modellt vesz a „modellek állatkertjéből” (model zoo) és megtréneli a neurális hálózat utolsó rétegét () a készen álló adatokon keresztül vagy ingyenes .
- A nagy neurális hálózat gyártók elkezdtek létrehozni „modellek állatkertjeit” (model zoo). Ezek segítségével gyorsan létezik kereskedelmi alkalmazás: a TensorFlow-hoz, a PyTorch-hoz, a Caffe2-höz, a Chainer-hez és .
- Valós időben működő neurális hálózatok (real-time) mobil eszközökön. 10-50 képkocka másodpercenként. Neurális hálózatok alkalmazása telefonokban (TF Lite), böngészőkben (TF.js) és
- háztartási eszközökben internet Idolgok). Különösen a telefonokban, amelyek már „hardveres” szinten is támogatják a neurális hálózatokat (neuroaccelerátorok). ) között. Ezután használ egy operátort a jogosultságok hozzáadására vagy eltávolítására az aktuális módból, vagy abszolút jogokat állít be.f Tkülönösen azokban a telefonokban, amelyek már támogatják a mesterséges intelligenciát "hardver" szinten (idegprocesszorok).
- «Minden eszköz, ruhadarab és esetleg még az étel is rendelkezni fog IP-v6 címmel és kommunikálni fog egymással» – .
- A gépi tanulással kapcsolatos publikációk száma kezdte (kétévenkénti megduplázódás) 2015 óta. Nyilvánvalóan szükség van cikk-elemző neurális hálózatokra.
- A következő technológiák népszerűsége növekszik:
- PyTorch – a népszerűség gyorsan növekszik, és úgy tűnik, hogy már megelőzi a TensorFlow-t.
- Automatikus hiperparaméter-keresés AutoML – a népszerűség fokozatosan növekszik.
- A pontosság fokozatos csökkenése és a számítási sebesség növekedése: , algoritmusok , imprecíz (megközelítő) számítások, kvantálás (amikor a neurális hálózat súlyait egész számokba konvertálják és kvantálják), neurális gyorsítók.
- Fordítás és .
- Módszer kidolgozása , már valós időben.
- A DL-ben a lényeg a sok adat, de azokat összegyűjteni és címkézni nem könnyű. Ezért fejlődik az automatizált címkézés () neurális hálózatok számára neurális hálózatok segítségével.
- A neurális hálózatokkal a Számítástechnika hirtelen kísérleti tudománnyá vált és megjelent .
- Az IT-pénz és a neurális hálózatok népszerűsége egyszerre jelent meg, amikor a számítások piaci értékké váltak. A gazdaság az aranyvalutából arany-valuta-számítástechnikatáplálékká válik. Nézd meg a cikkemet a és az IT-pénz megjelenésének okáról.
Fokozatosan megjelenik egy új (Gépi Tanulás & Mély Tanulás), amely a programot mint a betanított neurális hálózati modellek összességét képzeli el.
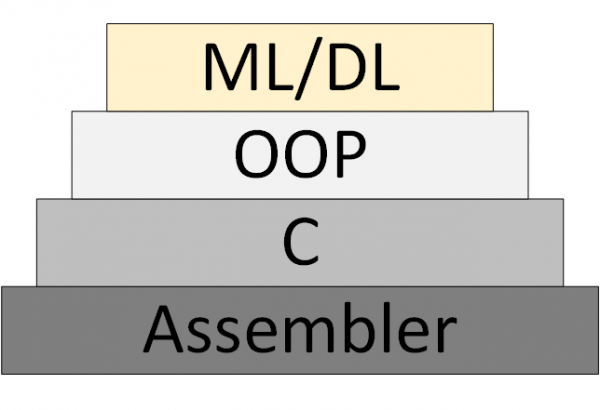
3. ábra – ML/DL mint új programozási metodológia
Azonban nem jelent meg a «neurális hálózatok elmélete», amely keretében lehetne rendszerszemléletben gondolkodni és dolgozni. Ami most elméletként van említve, az valójában kísérleti, heurisztikus algoritmusok.
Hivatkozások az én és más forrásokhoz:
- Adat Tudomány hírlevelének feliratkozás. Főként képfeldolgozásról. Aki szeretne kapni, küldjön e-mailt (foobar167<gaff-gaff>gmail<dot>com). A cikkek és videók linkjeit a gyűjtés során küldöm.
- Átfogó , amelyeket elvégeztem és amelyeket meg szeretnék tanulni.
- , amelyekkel érdemes elkezdeni a neurális hálózatok tanulmányozását. Plusz egy brosúra .
- , ahol mindenki talál valami érdekeset magának.
- Nagyon hasznosnak bizonyultak tudományos cikkek elemzésével foglalkozó videócsatornák a Data Science területén. Találjatok rájuk, iratkozzatok fel és adjátok át a linkeket a kollégáitoknak, és nekem is. Példák:
- vagy lépésről lépésre útmutatókkal és nyílt forráskódú projektekkel.
Köszönöm a figyelmet!
Forrás: habr.com
