

Röviden:
- A gépi tanulás a mintázatok kereséséről szól az adatokban. De a mesterséges intelligencia „elfogult” lehet — vagyis téves mintákat találhat. Például a bőrkárosodások fényképes észlelésekor a rendszer különös figyelmet fordíthat a rendelőben készült felvételekre. A gépi tanulás nem tudja megérteni: algoritmusai csupán mintákat azonosítanak a számokban, és ha az adatok nem reprezentatívak, akkor az eredmény is ilyen lesz. Nehéz lehet észrevenni az ilyen hibákat a gépi tanulás saját mechanikája miatt.
- A legnyilvánvalóbb és legijesztőbb problémás terület az emberek sokszínűsége. Számos ok van rá, hogy az emberekről készült adatok már az adatgyűjtés szakaszában elveszítsék az objektivitásukat. De nem érdemes azt gondolni, hogy ez kizárólag az embereket érinti: hasonló nehézségek merülnek fel a raktárban lévő víz vagy a meghibásodott gázturbinák észlelésének megkísérlésekor is. Egyes rendszerek előítéletekkel bírhatnak a bőrszín tekintetében, míg mások a Siemens érzékelőivel kapcsolatban lesznek elfogultak.
- Az ilyen problémák nem újkeletűek a gépi tanulásban, és nem csupán rá jellemzőek. Hibás feltételezések keletkezhetnek bármilyen összetett struktúrában, és mindig nehéz megérteni, miért született egy adott döntés. Ezzel átfogóan kell küzdeni: eszközöket és folyamatokat kell létrehozni az ellenőrzéshez — és képezni a felhasználókat, hogy ne kövessék vakon az MI javaslatait. A gépi tanulás valóban sok dolgot jobban csinál, mint mi — de a kutyák például sokkal hatékonyabbak a drogok észlelésében, ami nem indokolja őket mint tanúk bevonását és az ő vallomásuk alapján ítélet meghozatalát. Ráadásul a kutyák sokkal intelligensebbek, mint bármely gépi tanulási rendszer.
A gépi tanulás ma az egyik legfontosabb alapvető technológiai trend. Ez az egyik fő mód, ahogyan a technológia megváltoztatja a világot a következő évtizedben. Ezeknek a változásoknak egyes aspektusai aggasztóak. Például a gépi tanulás lehetséges hatása a munkaerőpiacra, vagy etikai szempontból aggályos célok (például autoriter rendszerek általi) felhasználása. Létezik egy másik probléma is, amelynek ez a bejegyzés is szentel: a mesterséges intelligencia elfogultsága.
Ez nem egy egyszerű történet.
A Google mesterséges intelligenciája képes megtalálni a macskákat. Ez a 2012-es hír akkoriban valami különleges volt.
Mi az az „AI elfogultság”?
A „nyers adatok” egyszerre oxymoron és rossz ötlet; az adatokat jól és gondosan kell előkészíteni. —Jeffrey Boker
2013-ig valahol a rendszer létrehozásához, amely mondjuk, felismeri a macskákat a fényképeken, logikai lépéseket kellett leírni. Meg kellett határoznod a képen a sarkokat, felismerned a szemeket, analizálnod a textúrákat szőr megléte szempontjából, megszámolnod a lábakat stb. Aztán össze kellett gyűjtened az összes komponenst — és rá kellett jönnöd, hogy ez igazából nem működik. Körülbelül úgy, mint egy mechanikus ló — elméletileg létrehozható, de gyakorlatilag túl nehéz leírni. A végén ott van akár száz (vagy akár több ezer) kézzel írt szabály. És egyetlen működő modell sem.
A gépi tanulással a „kézi” szabályok használatát abbahagytuk, hogy felismerjük ezt vagy azt az objektumot. Ehelyett ezer példányt veszünk az X-ből, ezer példányt az Y-ból, és rábízzuk a számítógépre a modell felépítését, statisztikai elemzés alapján. Ezután megadunk ennek a modellnek egy adatmintát, és az egy bizonyos pontossággal megállapítja, hogy az illik-e valamelyik adathalmazhoz. A gépi tanulás adatok alapján generál modellt, nem pedig emberi írás alapján. Az eredmények lenyűgözőek, különösen a képfelismerés és mintázat-elemzés terén, és éppen ezért az egész technológiai ipar most a gépi tanulásra (ML) vált.
De nem minden olyan egyszerű. A valóságban az ezer X vagy Y példád A-t, B-t, J-t, L-t, O-t, R-t és még L-t is tartalmazhat. Ezek egyenlőtlenül elosztottak lehetnek, és némelyikük annyira gyakori, hogy a rendszer többet foglalkozik velük, mint az olyan objektumokkal, amelyek téged érdekelnek.
Mit jelent ez a gyakorlatban? Az egyik kedvenc példám az, amikor az képfelismerő rendszerek . Világos, miért: a „birka” példák túlnyomó része réteken készült, ahol élnek, és ezeken a felvételeken a fű sokkal nagyobb teret foglal el, mint a kis fehér bolyhos állatok, és a rendszerek a füvet tartják a legfontosabbnak.
Komolyabb példák is vannak. A közelmúltban egy a bőrrák észleléséről fényképeken. Kiderült, hogy a bőrgyógyászok gyakran fényképezik a vonalzót a bőrrák megnyilvánulásaival együtt, hogy rögzítsék a formációk méretét. Az egészséges bőr fényképein nincs vonalzó. Az AI rendszer számára ezek a vonalzók (pontosabban azok a pixelek, amelyeket „vonalzóként” azonosítunk) az összes példa között az egyik különbséget jelentett, és néha fontosabbak voltak, mint a bőrön lévő apró kiütések. Így a bőrrák azonosítására kifejlesztett rendszer néha a vonalzókat ismerte fel a bőrrák helyett.
A kulcsfontosságú dolog itt az, hogy a rendszernek nincs szemantikai megértése arról, amit lát. Mi egy pixelfolyamra nézünk és bárányt, bőrt vagy vonalzót látunk, a rendszer csupán numerikus sorozatot érzékel. Nem lát háromdimenziós teret, nem észleli sem a tárgyakat, sem a textúrákat, sem a bárányokat. Csak mintákat lát az adatokban.
A hasonló problémák diagnosztizálásának nehézsége abban rejlik, hogy a neurális hálózat (a gépi tanulási rendszer által generált modell) ezer számos csomópontból áll. Nincs egyszerű mód arra, hogy betekintsünk a modellbe és lássuk, hogyan hoz döntéseket. Egy ilyen lehetőség létezése azt jelentené, hogy a folyamat elég egyszerű ahhoz, hogy minden szabályt kézzel leírjunk, anélkül, hogy gépi tanulást alkalmaznánk. Az emberek aggódnak, hogy a gépi tanulás egyfajta „fekete doboz” lett. (Később elmagyarázom, miért ez a hasonlat egy kicsit túlzás.)
Ez, általában véve, a mesterséges intelligencia vagy a gépi tanulás elfogultságának problémája: a rendszer, amely a minták megtalálására összpontosít az adatokban, helytelen mintákat is felfedezhet, és ezt talán nem is veszi észre. Ez a technológia alapvető jellemzője, és mindenkinek nyilvánvaló, aki tudományos körökben és nagy technológiai cégeknél dolgozik. De a következményei bonyolultak, és a lehetséges megoldásaink ezekre a következményekre is.
Először beszéljünk a következményekről.
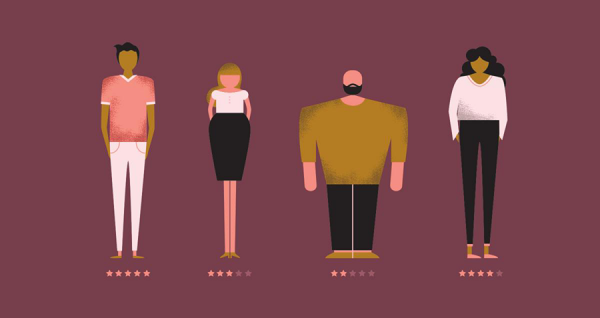
Az AI implicit módon döntéseket hozhat különböző emberi kategóriák mellett, anélkül, hogy észrevennénk azt, sok észrevétlen jel alapján.
Az AI elfogultságának forgatókönyvei
A legnyilvánvalóbb és legfélelmetesebb dolog az, hogy ez a probléma megnyilvánulhat, amikor az emberi sokféleségről van szó. Nemrég , hogy az Amazon megpróbált egy gépi tanuláson alapuló rendszert létrehozni a munkára jelentkező jelöltek előszűrésére. Mivel az Amazon munkatársai között több férfi van, a „sikeres felvétel” példái is inkább férfiakat képviseltek, és a rendszer által javasolt önéletrajzok között is több férfi szerepelt. Az Amazon észrevette ezt, és nem indította el a rendszert.
Ennek a példának a legfontosabb része az, hogy a rendszer állítólag a férfi jelölteknek kedvezett, annak ellenére, hogy a nem volt feltüntetve az önéletrajzokban. A rendszer más mintákat is észlelt a „sikeres felvétel” példáiban: például a nők különleges szavakat használhatnak a teljesítményeik leírására, vagy különleges hobbijaik lehetnek. Természetesen a rendszer nem tudta, mi az a „jégkorong”, kik az „emberek”, vagy mi a „siker”, csupán statisztikai elemzést végzett a szövegen. De a minták, amelyeket észlelt, valószínűleg emberi észlelés mellett is elkerülnék a figyelmet, és némelyiket (például, hogy a különböző nemű emberek másként írják le a sikert) valószínűleg nehéz észrevennünk, még ha figyelmet fordítunk is rájuk.
A helyzet még rosszabb. A gépi tanulási rendszer, amely nagyon jól észleli a bőrrákot világos bőrön, rosszabbul működhet sötét bőrön, vagy fordítva. Ez nem feltétlenül a részrehajlás miatt van, hanem mert valószínű, hogy külön modellt kell építened a különböző bőrszínhez, más jellemzők kiválasztásával. A gépi tanulási rendszerek nem helyettesíthetők még olyan szűk területen sem, mint a képfelismerés. Be kell állítanod a rendszert, néha egyszerűen próbálkozások útján, hogy jól kiemelje az érdekes adataidban rejlő sajátosságokat, amíg el nem éred a kívánt pontosságot. De lehet, hogy nem veszed észre, hogy a rendszer 98% pontosságú egy csoport esetében, miközben csupán 91%-os (bár pontosabb, mint az emberi elemzés) egy másik esetében.
Eddig főként az emberek és jellemzőik példáit használtam. E körül forog a vita a probléma kapcsán. De fontos megérteni, hogy az emberek iránti részrehajlás csak egy része a problémának. A gépi tanulást rengeteg dologra használjuk, és a mintavételi hiba releváns lesz mindezeknél. Másrészről, ha emberekkel dolgozol, az adatok részrehajlása nem feltétlenül rájuk vonatkozik.
Ahhoz, hogy ezt megértsük, térjünk vissza a bőrrák példájához, és nézzük meg három hipotetikus rendszerszintű hibalehetőséget.
- Egyenetlen emberi eloszlás: a bőrtónusok eltérő mennyiségű fényképezése, ami hamis pozitív vagy hamis negatív eredményekhez vezethet a pigmentációval kapcsolatban.
- A rendszer által tanulmányozott adatok gyakran előforduló és egyenetlenül eloszló jellemzőt tartalmaznak, amely nem kapcsolódik az emberekhez, és nem rendelkezik diagnosztikai értékkel: vonalzó a bőrrák megjelenéséről készült fényképeken, vagy fű a juhok fényképein. Ilyen esetben az eredmények eltérőek lesznek, ha a rendszer olyan képpontokat talál, amelyeket az emberi szem "vonalzóként" azonosít.
- Az adatok egy külső jellemzőt tartalmaznak, amelyet az ember, még ha keresi is, nem észlelhet.
Mit jelent ez? A priori tudjuk, hogy az adatok különböző csoportokat különféleképpen képviselhetnek, és legalábbis tervezhetjük, hogy keresünk hasonló kivételeket. Más szavakkal, számos társadalmi okunk van arra, hogy feltételezzük, a csoportokra vonatkozó adataink már tartalmaznak bizonyos előítéletet. Ha megnézzük a vonalzós fotót, látni fogjuk ezt a vonalzót – egyszerűen figyelmen kívül hagytuk előtte, tudván, hogy nem számít, és elfelejtve, hogy a rendszernek semmit sem tud.
De mi van, ha az összes egészségtelen bőrről készült fénykép az irodában készült, ahol izzólámpákat használnak, míg az egészségeseket fluoreszcens fényben? Mi van akkor, ha az egészséges bőr fényképezése után, az egészségtelen fényképezése előtt frissítetted a telefonod operációs rendszerét, és az Apple vagy a Google kissé megváltoztatta a zajcsökkentési algoritmusát? Ezt az ember nem fogja észlelni, bármennyire is keresi ezeket a tulajdonságokat. De a gépi rendszer azonnal észreveszi és használja ezt. Ő semmit sem tud.
Miközben a hamis korrelációkról beszéltünk, előfordulhat, hogy az adatok pontosak, és az eredmények helyesek, de etikai, jogi vagy menedzsment okokból nem akarjuk őket használni. Egyes joghatóságokban például nem lehet a nőket kedvezményekkel ellátni a biztosításban, annak ellenére, hogy a nők valószínűleg biztonságosabban vezetnek. Könnyen elképzelhetjük azt a rendszert, amely a történelmi adatok elemzésekor alacsonyabb kockázati együtthatót rendel a női nevekhez. Rendben, távolítsuk el a neveket a mintából. De emlékezzünk az Amazon példájára: a rendszer más tényezők alapján képes meghatározni a nemet (még ha nem is érti, hogy mi az a nem, és mi az a gépjármű), és belátja ezt, amíg a szabályozó nem vizsgálja meg a javasolt tarifákat utólag, és meg nem bünteti önt.
Végül gyakran felmerül, hogy ezeket a rendszereket csak olyan projektekhez fogjuk használni, amelyek emberekkel és társadalmi interakciókkal kapcsolatosak. Ez nem igaz. Ha gázturbinákat gyárt, valószínűleg gépi tanulást szeretne alkalmazni a tucatnyi vagy akár több száz szenzortól származó telemetriára a termékén (audio-, videó-, hőmérsékleti és bármilyen egyéb szenzor is generál adatokat, amelyeket nagyon könnyen felhasználhat gépi tanulási modell létrehozására). Elméletileg azt mondhatná: „Itt vannak az adatok ezer meghibásodott turbínáról, amelyeket a meghibásodásuk előtt gyűjtöttek össze, és itt vannak az ezer turbináról, amelyek nem hibásodtak meg. Építsenek modellt, hogy megmondják, mi a különbség közöttük.” Most képzelje el, hogy a Siemens szenzorai a rossz turbínák 75%-án találhatóak, míg a jó turbínák 12%-án (nincs kapcsolat a meghibásodásokkal). A rendszer olyan modellt épít, amely a Siemens szenzorokkal rendelkező turbínákat keresi. Ups!

Kép — Moritz Hardt, UC Berkeley
AI előítéletek kezelése
Mit tegyünk ezzel? Három irányból közelíthetjük meg a kérdést:
- A metodológiai szigor a rendszer tanításához szükséges adatok gyűjtése és menedzselése terén.
- Technikai eszközök a modell viselkedésének elemzésére és diagnosztizálására.
- Képzés, oktatás és óvatosság a gépi tanulás termékekbe való bevezetésekor.
Molière „Burzsoáz emberek“ című könyvében van egy vicc: egy férfinek elmondták, hogy az irodalom prózára és költészetre oszlik, és ő csodálkozva fedezi fel, hogy egész életében prózában beszélt, anélkül hogy tudott volna róla. Valószínűleg a statisztikusok is így érzik magukat manapság: anélkül, hogy észrevennék, pályafutásukat a mesterséges intelligenciának és a mintavételi hibának szentelték. Keresni a mintavételi hibát és emiatt aggódni – ez nem új probléma, egyszerűen rendszerszinten kell megközelítenünk a megoldását. Ahogy már említettem, bizonyos esetekben valóban egyszerűbb ez a probléma, ha az emberekkel kapcsolatos adatproblémákat tanulmányozzuk. Előfeltevésünk, hogy lehetnek előítéleteink különböző embercsoportokkal szemben, de az előítélet a Siemens érzékelőkkel kapcsolatban nehezen elképzelhető számunkra.
Ami új ebben, az természetesen az, hogy az emberek már nem foglalkoznak közvetlenül a statisztikai elemzéssel. Ezt gépek végzik, amelyek nagy, összetett modelleket hoznak létre, amelyek nehezen érthetőek. Az átláthatóság kérdése a torzítottság problémájának egyik alapkérdése. Félelemmel tölt el minket, hogy a rendszer nemcsak torzított, hanem hogy nincs lehetőség a torzítottság felderítésére, és hogy a gépi tanulás ezáltal különbözik más automatizálási formáktól, amelyek, mint feltételezhető, tiszta logikai lépésekből állnak, amelyeket ellenőrizni lehet.
Itt két probléma van. Talán mégis képesek vagyunk valamiféle auditot végezni a gépi tanulási rendszereken. És bármilyen más rendszer auditálása valójában nem könnyebb.
Először is, a gépi tanulás területének modern kutatása egyik iránya a módszer keresése, hogyan lehet a gépi tanulási rendszerek fontos funkcióit azonosítani. A gépi tanulás (jelenlegi állapotában) teljesen új tudományág, amely gyorsan változik, ezért nem érdemes azt gondolni, hogy a ma lehetetlen dolgok nem válhatnak hamarosan valósággá. A projekt – ennek érdekes példája.
Másrészt az a gondolat, hogy ellenőrizni és megérteni lehet a döntéshozatali folyamatokat a létező rendszerekben vagy szervezetekben, elméletben jó, de a gyakorlatban nem annyira. Nagyon nehéz megérteni, hogyan hoznak döntéseket egy nagy szervezetben. Még ha van is egy formális döntéshozatali folyamat, az nem tükrözi azt, hogy az emberek valójában hogyan lépnek interakcióba, és maguk sem mindig rendelkeznek logikus, rendszerelvű megközelítéssel a döntéseik meghozatalához. Ahogy egy kollégám mondta, , az emberek is fekete dobozok.
Végy ezer embert több átfedő vállalatban és intézetben, és a probléma még bonyolultabbá válik. Utólag tudjuk, hogy a Space Shuttle-nek a visszatéréskor darabokra kellett volna esnie, és az NASA-n belül egyes emberek tudták, hogy lehet, hogy valami rossz történik, de a rendszer egészében ezt nem tudta. Az NASA éppen most ment át egy hasonló auditon, miután elveszítette az előző űrsiklót, és mégis ismét elveszítette egy nagyon hasonló ok miatt. Könnyű azt állítani, hogy a szervezetek és az emberek egyértelmű logikai szabályokat követnek, amelyeket ellenőrizni, megérteni és megváltoztatni lehet — de a tapasztalat ennek az ellenkezőjét bizonyítja. Ez a „».
Gyakran összehasonlítom a gépi tanulást az adatbázisokkal, különösen a relációs adatbázisokkal — egy új alapvető technológiával, amely megváltoztatta az informatika lehetőségeit és a körülötte lévő világot, amely mindenütt részévé vált, amit folyamatosan használunk, anélkül, hogy észrevennénk. A database also has its problems, and they are of a similar nature: the system may be built on incorrect assumptions or poor data, but this will be difficult to notice, and people using the system will do what it tells them without questioning it. There are plenty of old jokes about tax workers who once incorrectly recorded your name, and convincing them to correct the mistake is much more difficult than actually changing the name. This can be thought of in various ways, but it is unclear what the best perspective is: whether as a technical issue in SQL, as an error in an Oracle release, or as a failure of bureaucratic institutions? How difficult is it to find the error in the process that led to the system lacking features such as correcting typos? Could this have been recognized before people started complaining?
This problem is even more easily illustrated by stories when drivers end up in rivers due to outdated data in their navigator. Okay, maps should be constantly updated. But how much is TomTom to blame for your car being swept away into the sea?
I say this to point out that yes — machine learning bias will create problems. But these problems will be similar to those we've faced in the past, and they can be noticed and addressed (or not) about as well as we have been able to in the past. Therefore, the scenario in which AI bias causes harm is unlikely to happen with leading researchers working in a large organization. Most likely, some insignificant tech contractor or software vendor will write something hastily, using open-source components, libraries, and tools that they do not fully understand. And an unsuspecting client will be fooled by the phrase 'artificial intelligence' in the product description and, without asking additional questions, will distribute it to their low-paid workers, instructing them to do what the AI says. This is exactly what happened with databases. This is not an artificial intelligence problem, nor is it a software issue. It is a human factor.
Zárás
Machine learning can do everything you can teach a dog — but you can never be sure what exactly you taught that dog.
Gyakran úgy érzem, hogy az „artificial intelligence” kifejezés csak megnehezíti az ilyen beszélgetéseket. Ez a kifejezés hamis benyomást kelt arról, hogy valójában mi létrehoztuk ezt az intelligenciát. Hogy HAL9000 vagy Skynet felé haladunk — valami, ami valóban érti.. De nem. Ezek csak gépek, és sokkal helyesebb őket összehasonlítani például egy mosógéppel. Sokkal jobban végzi a mosást, mint az ember, de ha edényeket tesz bele ruhák helyett, azokat… kimoshatja. Az edények tiszták lesznek. De nem az lesz, amire számítottál, és ez nem azért fog megtörténni, mert a rendszernek valamilyen előítélete lenne az edényekkel kapcsolatban. A mosógép nem tudja, mi az edény, mi pedig a ruha — ez csak egy példa az automatizálásra, ami lényegében nem különbözik attól, ahogy a folyamatokat korábban automatizálták.
Bármiről legyen szó, legyen az gépek, repülőgépek vagy adatbázisok — ezek a rendszerek egyszerre nagyon erősek és nagyon korlátozottak lesznek. Teljesen attól f függenek, hogy az emberek hogyan használják ezeket a rendszereket, milyen szándékaik vannak, legyenek azok jók vagy rosszak, és mennyire értik a működésüket.
Ezért azt mondani, hogy „a mesterséges intelligencia matematikai alapú, tehát nem lehetnek előítéletei”, teljesen téves. De éppoly téves azt állítani, hogy a gépi tanulás „szubjektív természete”. A gépi tanulás mintákat talál az adatokban, és hogy milyen mintákat talál, az az adatokatól függ, amelyek pedig tőlünk függenek. Akárcsak az, amit velük csinálunk. A gépi tanulás valóban sok dolgot sokkal jobban csinál, mint mi - a kutyák például sokkal hatékonyabbak az drogok felfedezésében, ami nem ok arra, hogy őket tanúként bevonjuk és ítéletet hozzunk a vallomásuk alapján. A kutyák, hogy így mondjam, sokkal intelligensebbek minden gépi tanulási rendszerhez képest.
Fordítás: .
Szerkesztés: .
Közösség: .
Forrás: habr.com
