

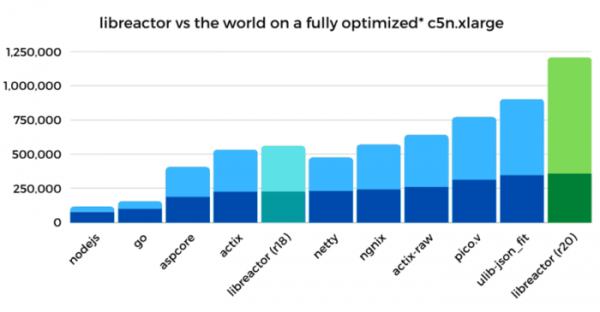
Megjelent egy részletes útmutató a Linux-környezet teljesítményoptimalizálásához, amely a HTTP-kérések maximális feldolgozási teljesítményének elérésére összpontosít. Az ajánlott módszerek 436%-os teljesítménynövekedést eredményeztek a libreactor alapú JSON-kezelő esetében az Amazon EC2 (4 vCPU) környezetében, ahol az Amazon Linux 2 4.14-es kernel normál beállításai mellett 224 ezer API-kérés másodpercenként emelkedett 1,2 millió kérésre másodpercenként az optimalizálás után, és a kérésfeldolgozási késések 79%-kal csökkentek. Az ajánlott módszerek nem specifikusak a libreactor számára, és más HTTP-szerverek, például nginx, Actix, Netty és Node.js használata során is működnek (a libreactort használták a tesztek során, mivel az alapú megoldás a legjobb teljesítményt mutatta).
Fő optimalizálások:
- A libreactor kód optimalizálása. Az alap a Techempower készlet R18-as változata volt, amelyet a használt CPU-magok számának korlátozását célzó kód eltávolításával javítottak (ez 25-27%-os teljesítménynövelést tett lehetővé), GCC-ben való fordítással «-O3» opcióval (5-10% növekedés) és «-march-native» (5-10%), a read/write hívások lecserélésével recv/send hívásokra (5-10%) és a pthreads használatából adódó költségek csökkentésével (2-3%). Az optimalizálás eredményeként 55%-os teljesítménynövekedést és 224k req/s-ről 347k req/s-re emelkedett a kapacitás.
- A spekulatív végrehajtási utasításokkal kapcsolatos sebezhetőségek védelme kikapcsolása. A kernel indítási paraméterek „nospectre_v1 nospectre_v2 pti=off mds=off tsx_async_abort=off” használatával 28%-os teljesítménynövekedést értek el, míg a kapacitás 347k req/s-ről 446k req/s-re nőtt. Külön-külön a „nospectre_v1” (Spectre v1 + SWAPGS védelem) paraméter 1-2%-os, a „nospectre_v2” (Spectre v2 védelem) 15-20%-os, a „pti=off” (Spectre v3/Meltdown) 6%-os, a „mds=off tsx_async_abort=off” (MDS/Zombieload és TSX Asynchronous Abort) 6%-os növekedést biztosított. A L1TF/Foreshadow támadások védelme (l1tf=flush), iTLB multihit, Speculative Store Bypass és SRBDS beállításait változatlanul hagyták, mivel nem befolyásolták a teljesítményt, mivel nem kereszteződtek a tesztelt konfigurációval (például specifikus volt KVM, a beágyazott virtualizáció és más CPU-modellek).
- Audit mechanizmusok letiltása és a rendszerhívások blokkolásának letiltása az «auditctl -a never,task» parancs segítségével, valamint a «—security-opt seccomp=unconfined» opció megadásával a docker konténerek indításakor. Az összesített teljesítménynövekedés 11% volt, míg a throughput a 446k req/s-ről 495k req/s-ra nőtt.
- Az iptables/netfilter letiltása a hozzájuk kapcsolódó kernel modulok eltávolításával. A tűzfal lekapcsolásának ötletét, amelyet a specifikus szervermegoldás nem használt, a profilozási eredmények indokolták, mivel a nf_hook_slow funkció végrehajtására 18% időt fordítottak. Megjegyzendő, hogy a nftables hatékonyabban működik, mint az iptables, de az Amazon Linuxban továbbra is az iptables használatos. Az iptables letiltása után a teljesítménynövekedés 22% volt, a throughput pedig 495k req/s-ről 603k req/s-ra nőtt.
- A processzor-készletek közötti migráció csökkentése a CPU-cache hatékonyabb kihasználása érdekében. Az optimalizálás a libreactor folyamatok CPU-hoz való hozzárendelése (CPU Pinning) és a hálózati kernelkezelők rögzítése (Receive Side Scaling) szintjén valósult meg. Például letiltották az irqbalance-t, és a sorok explicit CPU-hoz rendelését állították be a /proc/irq/$IRQ/smp_affinity_list fájlban. A libreactor folyamat és a bejövő csomagok hálózati sorának kezelésére egyedi BPF-kezelőt használtak, amely a SO_ATTACH_REUSEPORT_CBPF jelző beállításával lett csatlakoztatva a socket létrehozásakor. A kimenő csomagok sorának CPU-hoz való rendelésének érdekében a /sys/class/net/eth0/queues/tx-<n>/xps_cpus beállításait módosították. Az összesített teljesítménynövekedés 38% volt, a throughput pedig 603k req/s-ről 834k req/s-ra nőtt.
- Az megszakításkezelés optimalizálása és a polling használata. Az adaptive-rx mód aktiválása az ENA illesztőprogramban és a sysctl net.core.busy_read manipulálása 28%-os teljesítménynövekedést eredményezett (a throughput 834k req/s-ről 1.06M req/s-ra nőtt, a késések pedig 361μs-ről 292μs-ra csökkentek).
- A hálózati verem fölösleges blokkolásához vezető rendszerszolgáltatások letiltása. A dhclient letiltása és a IP address kézi beállítás 6%-os teljesítménynövekedést eredményezett, a throughput pedig 1.06M req/s-ről 1.12M req/s-ra nőtt. A dhclient teljesítményre gyakorolt hatásának oka a raw-socket használatával végzett forgalomelemzés.
- Spin Lock elleni küzdelem. A hálózati verem 'noqueue' módba való átkapcsolása a sysctl 'net.core.default_qdisc=noqueue' és a 'tc qdisc replace dev eth0 root mq' parancs segítségével 2%-os teljesítménynövekedést eredményezett, a kapacitás pedig 1,12M req/s-ről 1,15M req/s-re emelkedett.
- A végső apró optimalizálások, mint a GRO (Generic Receive Offload) letiltása a 'ethtool -K eth0 gro off' paranccsal, és a kubikus vezérlési algoritmus Reno-ra való cseréje a sysctl 'net.ipv4.tcp_congestion_control=reno' használatával. A teljesítménynövekedés összesen 4% volt. A kapacitás 1,15M req/s-ről 1,2M req/s-re emelkedett.
A már végrehajtott optimalizációkon kívül a cikk olyan módszereket is tárgyal, amelyek nem hozták meg a várt teljesítménynövekedést. Például nem voltak hatékonyak:
- A libreactor külön indítása nem különbözött a konténerben való indítástól teljesítmény szempontjából. Nem volt hatással a writev send-re cserélése, a maxevents növelése az epoll_wait-ban, a GCC verziókkal és flag-ekkel való kísérletezés (a hatás csak a '-O3' és '-march-native' flag-ek esetén volt észlelhető).
- A Linux kernel 4.19-es és 5.4-es verzióra való frissítése, az SCHED_FIFO és SCHED_RR ütemezők használata, a sysctl kernel.sched_min_granularity_ns, kernel.sched_wakeup_granularity_ns, transparent_hugepages=never, skew_tick=1 és clocksource=tsc manipulálása nem hatott a teljesítményre.
- Az ENA meghajtóban az Offload (szegmentálás, scatter-gather, rx/tx checksum) módok bekapcsolása, a '-O3' flag-gel való fordítás és az ena.rx_queue_size és ena.force_large_llq_header paraméterek alkalmazása nem befolyásolta a teljesítményt.
- A hálózati veremben végrehajtott változások nem vezettek teljesítménynövekedéshez:
- IPv6 letiltása: ipv6.disable=1
- VLAN letiltása: modprobe -rv 8021q
- A csomagforrás-ellenőrzés letiltása
- net.ipv4.conf.all.rp_filter=0
- net.ipv4.conf.eth0.rp_filter=0
- net.ipv4.conf.all.accept_local=1 (negatív hatás)
- net.ipv4.tcp_sack=0
- net.ipv4.tcp_dsack=0
- net.ipv4.tcp_mem/tcp_wmem/tcp_rmem
- net.core.netdev_budget
- net.core.dev_weight
- net.core.netdev_max_backlog
- net.ipv4.tcp_slow_start_after_idle=0
- net.ipv4.tcp_moderate_rcvbuf=0
- net.ipv4.tcp_timestamps=0
- net.ipv4.tcp_low_latency=1
- SO_PRIORITY
- TCP_NODELAY
Forrás: opennet.ru
