

Az OpenAI projektje, amely nyílt hozzáférésű mesterséges intelligencia projektek fejlesztésével foglalkozik, közzétette a Whisper hangfelismerő rendszerhez kapcsolódó munkáit. Azt állítják, hogy az angol nyelvű beszéd esetében a rendszer megbízhatósági és pontossági szintje közel áll ahhoz, amit az emberi beszéd felismerése nyújt. A referencia megvalósítás kódja a PyTorch keretrendszer alapján nyitott, és már elérhető előképzett modellek is rendelkezésre állnak. A kód MIT licenc alatt érhető el.
A modell képzéséhez 680 000 órányi beszédadatot használtak fel, amelyeket több gyűjteményből gyűjtöttek össze, különböző nyelveket és témákat lefedve. Az oktatáshoz felhasznált beszédadatok körülbelül 1/3-a olyan nyelvekhez tartozik, amelyek eltérnek az angoltól. A javasolt rendszer helyesen kezeli az olyan helyzeteket, mint a kiejtés akcentussal, háttérzajok jelenléte és technikai zsARGON használata. A beszéd szöveggé való átírása mellett a rendszer képes a beszédet tetszőleges nyelvről angolra fordítani és azonosítani a beszéd megjelenését a hangfolyamban.
A modellek két formátumban készültek: angol nyelvű modell és egy többnyelvű modell, amely támogatja a orosz, ukrán és belorusz nyelveket is. Minden egyes forma 5 változatra oszlik, amelyek méretükben és a modell által lefedett paraméterek számában eltérnek. Minél nagyobb a méret, annál pontosabb és magasabb minőségű a felismerés, de annál nagyobb videomemória-követelmény is szükséges, és alacsonyabb teljesítményszintet jelent. Például a legkisebb változat 39 millió paramétert tartalmaz és 1 GB videomemóriát igényel, míg a legnagyobb 1550 millió paramétert foglal magában és 10 GB videomemóriát igényel. A legkisebb változat 32-szer gyorsabb a legnagyobb változatnál.
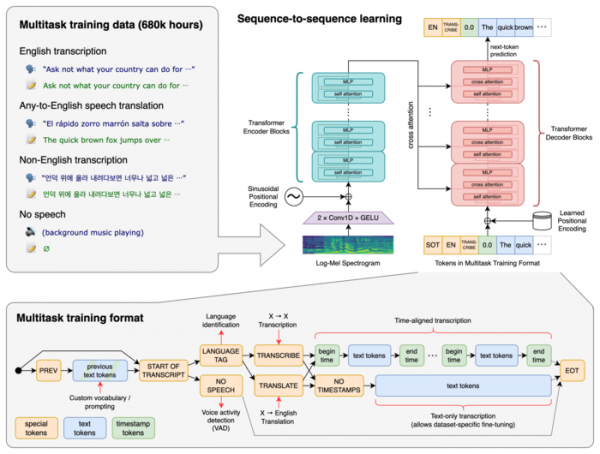
A rendszer a "Transformer" neurális hálózat architektúráját használja, amely kölcsönhatásban álló kódolóból és dekódolóból áll. A hang 30 másodperces szakaszokra van bontva, amelyeket log-Mel spektrogrammá alakítanak, és elküldenek a kódolónak. A kódoló munkájának eredménye a dekódolóhoz kerül, amely előre jelzi a szöveges reprezentációt, vegyítve speciális tokenekkel, amelyek lehetővé teszik, hogy egyetlen közös modellben megoldhatók legyenek olyan feladatok, mint a nyelv meghatározása, a frázisok kiejtésének időbeli összefüggéseinek figyelembe vétele, a beszéd átírása különböző nyelveken, és angol nyelvre történő fordítás.
Forrás: opennet.ru
