

A kutatási projekt keretein belül megkezdődött a munka a GCC-hez való párhuzamos fordítási lehetőség hozzáadásán, amely lehetővé teszi a fordítási folyamat több párhuzamosan futó szálra való felosztását. Jelenleg a gyorsabb fordítás érdekében többrekeztett rendszereken az make utility szintjén külön fordítófolyamatokat indítanak, ahol mindegyik egy külön fájl kódjának fordítását végzi. Az új projekt a fordító szintjén biztosítja a párhuzamosítást, ami potenciálisan növelheti a hatékonyságot a többrekeztett rendszereken.
A teszteléshez egy külön párhuzamosító ág GCC-ben, ahol a szálak számának meghatározására egy új paramétert, a "—param=num-threads=N"-t javasoltak. A kezdeti fázisban a külön szálakba kiemelt közötti optimalizációk, amelyeket ciklikusan minden egyes funkcióra alkalmaznak, és jól párhuzamosíthatók. Az olyan GIMPLE műveletek kerültek külön szálakba, amelyek a hardvertől független optimalizációkra vonatkoznak, értékelve az egyes funkciók közötti kölcsönhatásokat.
A következő fázisban a közötti RTL-optimalizációk párhuzamosítása is tervbe van véve, figyelembe véve a hardverplatform sajátosságait. Ezt követően fontos, hogy a mélyebb eljárásalapú optimalizálások (IPA) párhuzamosítása is megvalósításra kerüljön a funkción belüli kódon, függetlenül a felhívás sajátosságaitól. A korlátot jelenleg a szemétgyűjtő képezi, amelyhez egy globális zárolás lett hozzáadva, amely letiltja a szemétgyűjtési műveleteket a párhuzamos módú működés ideje alatt (a jövőben a szemétgyűjtőt a GCC párhuzamos végrehajtásához fogják alkalmazni).
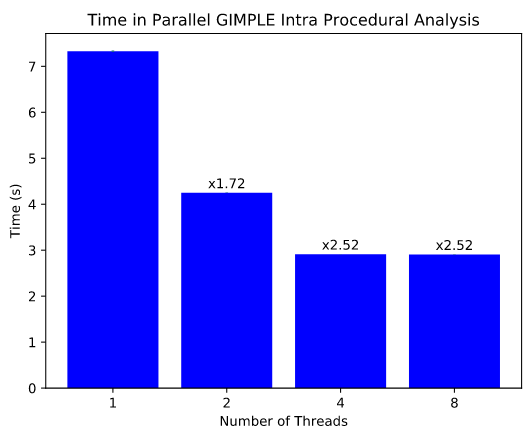
A teljesítményváltozások értékelésére egy tesztkészletet készítettek, amely a gimple-match.c fájl összeszerelését végzi, több mint 100 ezer kódsorral és 1700 funkcióval. Az Intel Core i5-8250U CPU-val rendelkező rendszeren, amely 4 fizikai és 8 virtuális (Hyperthreading) maggal rendelkezik, a tesztek azt mutatták, hogy az Intra Procedural GIMPLE optimalizálások végrehajtási ideje 7 másodpercről 4 másodpercre csökkent 2 szál indítása esetén, és 4 szál indítása esetén 3 másodpercig terjedt, ezzel a vizsgált összeszerelési szakasz sebessége 1,72 és 2,52-szeres növekedést mutatott, a megfelelően. A tesztek arra is rámutattak, hogy a virtuális magok használata Hyperthreading alatt nem eredményez teljesítménynövekedést.
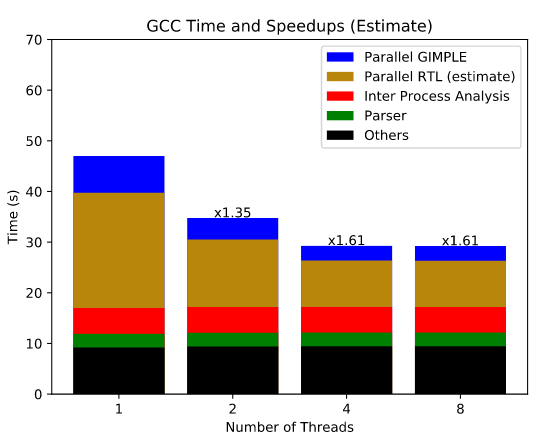
Az összeszerelés teljes ideje körülbelül 10%-kal csökkent, de a RTL-optimalizációk párhuzamosítása várhatóan még érzékelhetőbb eredményekhez vezet, mivel ez a szakasz a fordítás során lényegesen több időt vesz igénybe. A párhuzamosítás után körülbelül 1,61-szeres csökkenés várható az összeszerelés teljes idejében. Ezt követően további 5-10%-kal csökkenthető lesz az összeszerelés ideje az IPA optimalizációk párhuzamosításával.
Forrás: opennet.ru
